关键词搜索量回答的是"有多少人用这组词搜索",它没有回答"这个人在做决定之前还会问什么"。AI 搜索把后者变成决定性变量:当用户在 ChatGPT、Perplexity、Gemini 或 Google AI Mode 里提出一个带约束条件的问题时,引擎会自己生成多条子查询去检索,再把检索到的段落拼成一个带引用的答案。决定你能否被引用的,不再只是有没有排上某个词,而是页面里有没有能单独被抽出来、正好回答某条子查询的段落。
所以更准确的说法是:搜索量仍是有用的需求规模信号,但它是起点指标,不是终点指标。关键词研究要新增三件事——这条需求背后的完整问题链、每个问题对应的检索形态、以及页面是否具备可被抽取的答案块。
为什么只看搜索量会漏掉真实的购买意图
传统流程是"主关键词 → 相关词 → 内容",它假设每次搜索都是独立、词形固定的需求。用户行为已经改变:一条真实提问常常同时包含预算、场景、兼容性和使用方式,例如"一万五以内、能剪视频、续航好、方便出差的笔记本"。这些条件在 AI 搜索里会被拆成不同分支分别检索。
以 B2B 采购为例,"best CRM software" 背后通常是一串连续追问:小型企业适合哪一个?支持邮件自动化吗?能和 Shopify 打通吗?月费最低的是哪个?这四问的检索价值可能高于原始词本身,但月搜索量往往接近零——很少有人把完整问句打进搜索框,可他们会这样问 AI。
由此出现两个漏洞。第一,低搜索量不等于低商业价值。第二,搜索量对答案形态没有任何提示:它不会告诉你比较类需求需要一张表、流程类需求需要编号步骤、定义类需求需要一段能独立成立的三五十字解释。而恰恰是这些形态,决定内容能否被检索到。
什么是 Query Fan-Out(查询扇出)
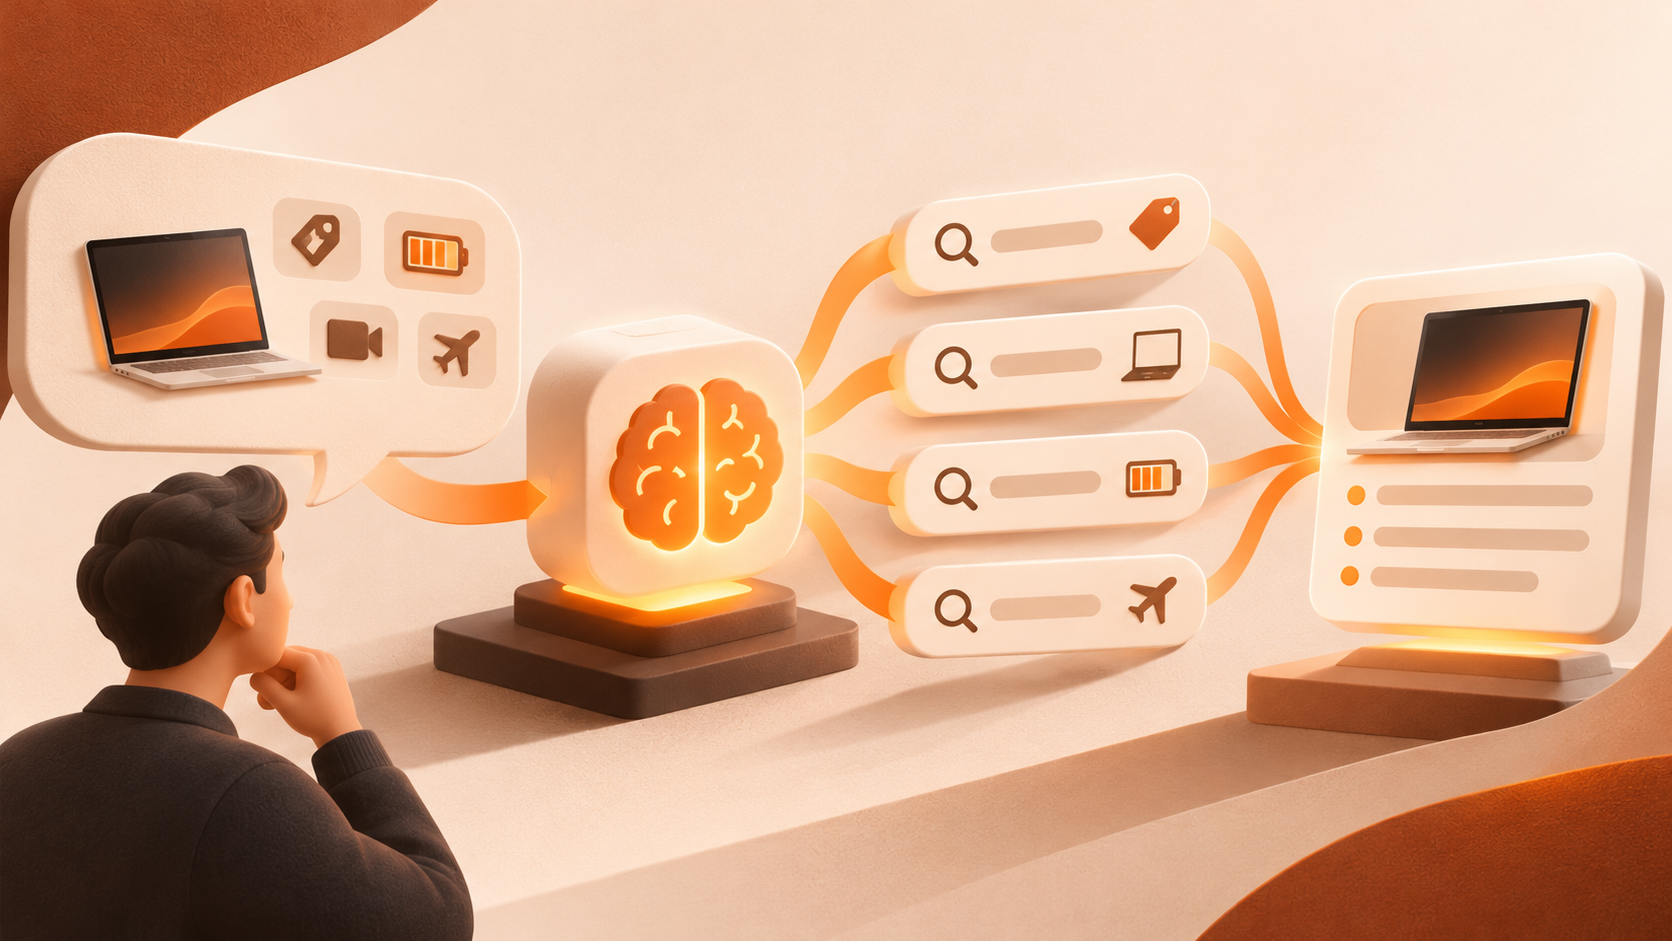
Query Fan-Out 指 AI 搜索引擎把一条提问拆成若干条由模型自己生成的子查询,并行检索、为返回段落打分,再合成一个带引用的答案。Google 在 AI 功能文档中说明,AI Mode 与 AI Overviews 这类体验可能使用该技术,从而呈现比常规结果页"更广、更多样的一组有用链接"(Google Search Central)。
工程上通常分五步:识别意图与复杂度、生成子查询、过滤高度重复的子查询、并行检索、合成答案并附引用。第三步最容易被忽略:系统偏好覆盖度而不是重复,两个内容近似的页面一般不会同时进入检索。
规模上,公开观测大致是:AI Mode 单次提问约产生 8–12 条并行子查询(实测常见 3–8 条);ChatGPT 平均每次联网搜索 4.7 条子查询;"上百次搜索"只适用于 Deep Search 这类多轮管线,上限约 20 轮。更关键的是子查询的形态——反向分析显示其平均长达 70–80 个词,复杂度约为传统三四个词关键词的 17–26 倍(MaximusLabs)。引擎不是拿你的关键词去搜,而是拿一段带上下文和使用场景的完整描述去搜。
扇出也不是无条件发生。相关专利把是否生成子查询与输入长度、查询频次、结果质量、token 数量、服务器负载绑定。短导航型或简单事实型提问,常只执行一次接近原始提问的检索;长比较型、评估型提问才会展开最大的分支树。预算因此应优先压在复杂的商业问题上。
搜索意图从"一个词"变成"一条问题链"
导航、信息、商业调查、交易这四类意图依然成立,但在 AI 搜索里,一条主意图会延伸出多层子意图。以 "How do I choose the best SEO tool for my business?" 为例,主意图是选工具,子意图却包括:我需要哪类工具?预算多少?哪些功能是关键?要不要技术 SEO 能力?新手和代理机构分别适合什么?
这里要区分两个常被混用的概念:关键词聚类把相似的词按意图、语义和 SERP 重叠度归组,解决内容怎么组织;Query Fan-Out 描述一个问题如何裂变成多条检索路径,包括用户从未明说的主题,解决检索怎么发生(SEO for Today)。前者是编辑方法,后者是工程机制,不能互相替代。
表:八类子查询及其需要的内容形态
对扇出分支归类后,一次提问通常会产生八类子查询,每类需要的段落形态不同。这张表可以直接当内容自查清单:
| 子查询类型 | 示例 | 需要的内容形态 |
|---|---|---|
| 精确匹配 | best CRM software | 直接给出选项的答案块 |
| 语义变体 | top CRM platforms | 换用买方另一种说法重述同一答案 |
| 导航型 | 某厂商定价页 | 可抓取、结构清晰的产品或定价页 |
| 比较型 | A vs B for small business | 带明确属性的表格行 |
| 定义型 | what is pipeline attribution | 可独立成立的三五十字短定义 |
| 流程型 | how to migrate CRM data | 编号步骤,一步一个动作 |
| 榜单型 | CRM tools for agencies | 带筛选条件的可扫读列表 |
| 场景型 | CRM for a 3-person team | 点名团队规模与使用场景的限定句 |
纯散文页面通常只覆盖其中两三类:没有表格,比较分支就无内容可抽;没有编号步骤,流程分支就落空;从没写过团队规模,场景分支就匹配不上。格式在这里不是排版偏好,而是可检索性本身。
从一个关键词扩展到完整问题链:五步操作法
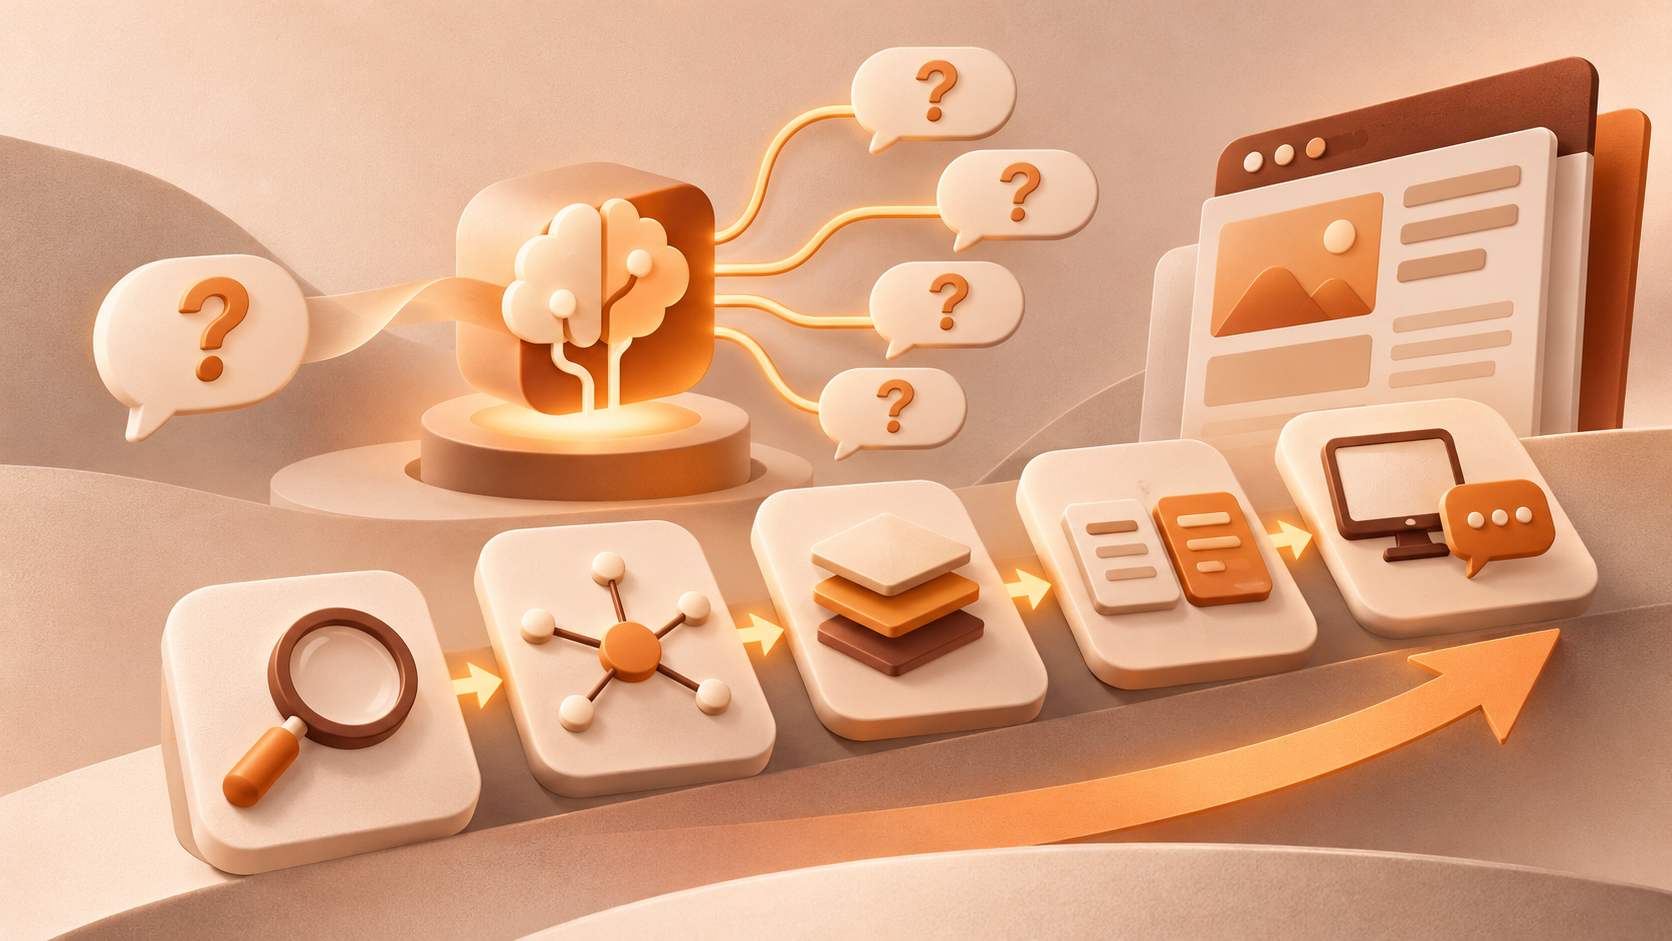
第一步,列种子提示词而不是关键词。收集 10–20 条理想客户在预约演示前真的会打出来的问题,越口语越好。
第二步,把每条种子放进 Perplexity 跑一遍。它的界面会显示实际执行的检索,是目前少数可以观察扇出行为的地方。
第三步,逐条记录它带出的 5–8 个相关问题,保持原话,不要改写成关键词。
第四步,用 AlsoAsked 这类问答工具交叉核对同一组种子,补上被漏掉的分支。
第五步,把存活的子问题映射成已有页面上的 H2 与 H3。原则是"一个问题簇一个页面",而不是"一个子查询一个页面":为每条子查询单独建薄页面会稀释权威度,也会触及 Google 对规模化内容滥用的政策边界(MaximusLabs)。
需要明确,真实分支树是会话化、带个性化的,外部无法完整复刻。问题链是重建出来的近似值,适合做覆盖度规划,不适合当作精确数据对外汇报。
几分钟搭建展示站并增长获客
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
内容集群:把问题链变成三层结构
落地时可以分三层:支柱页回答"这个决策该怎么做的完整框架";子页承接有独立搜索需求的子问题,例如某类方案对比、某个行业的价格结构;FAQ 块承接枝节问题,例如兼容性、退款、最低配置。
判断一个子问题要不要单独成页,用三个检查:它在真实对话里会被单独提问吗?它的回答任务是否支柱页无法承担而又不跑题?你能用一句话说清它和同级页面不重叠的地方吗?三问都通过,才建新页。
同时要意识到底部漏斗的优先级差异。购买型提问的扇出通常集中在价格、方案、免费额度、退款政策和竞品对比上,比较页与定价页因此比定义页更容易进入购买路径;定义型问题往往被引擎自己回答掉,赢得它更多只是获得一次提及。
FAQ 与产品页应该如何分工
两者承担不同检索任务,混在一起会让两边都变差。产品页的目标是把"是否适合我"说清楚:谁适用、包含什么能力、边界在哪、价格结构如何、怎么开始。它应该显式写出团队规模、使用场景、集成项和限制条件,因为这些正是场景型子查询用来匹配的限定信息。
FAQ 的目标是消除决策摩擦,回答那些不进主干、但用户一定会问的枝节问题。每条答案要能脱离上下文独立成立:把代词换成实体名,先给结论再补条件,长度控制在几十字。
页面内部的结构顺序也是检索决策。在引用模式观测中,约 44% 的引用份额集中在前 30% 的正文,之后逐步递减(MaximusLabs)。所以最商业化的答案应出现在页面前三分之一,而不是留到最后。
搜索引擎与对话式搜索能同时覆盖吗
多数情况下可以,重叠比想象中大。几个主要入口的偏好并不冲突:AI Mode 看重子主题覆盖与段落清晰度;ChatGPT 看重自包含的问答块与专业信号;Perplexity 看重时效与来源透明;Claude 的研究模式看重深度与方法。它们的交集是答案前置、来源可见、语言平实、正文有真实深度。
一个方向性变化值得注意:在公开观测中,AI Overview 引用对前 10 名自然结果的依赖从约 76% 降到约 38%,另有相当比例引用来自排名 100 名之外的位置(MaximusLabs)。它的含义不是"排名无用",而是"排名不再是引用的唯一门槛"——段落能否被抽取、能否直接回答问题,权重明显上升。
基础功依然要做:技术可抓取性、内容结构、内部链接与结构化数据,仍是进入 AI 搜索体验的前提(Google Search Central)。
企业现在应该做什么:六项检查清单
| 优先级 | 动作 | 完成标准 |
|---|---|---|
| 1 | 用 10–20 条真实客户提问替换关键词清单 | 每条都是完整口语问句 |
| 2 | 在 Perplexity 里跑一遍并记录后续问题 | 每条种子至少记录 5 个分支 |
| 3 | 给核心商业页做八类子查询覆盖自查 | 八类中至少覆盖六类 |
| 4 | 在每个 H2 下补一个独立答案块 | 代词换成实体名,先结论后条件 |
| 5 | 把最商业化的区块前移到前三分之一 | 首屏之后一屏内出现 |
| 6 | 为每个问题簇指定唯一归属页 | 没有两个页面回答同一问题 |
同时保留一部分搜索量判断:它仍是估算需求规模、排定优先级、判断季节性的低成本信号。真正要放弃的是"搜索量高就写、低就不写"这条单线规则。
we0 如何承接这条链路
问题链要变成内容资产,最终得落在网站上:面结构、FAQ 块、比较表、结构化数据、多语言版本和后续更新节奏。we0.ai 提供的路径是把建站与内容增长放在同一个工作台:用自然语言描述需求,由多 Agent 协作生成可运行页面,在可视化画布上调整后部署到自有域名,再用 CMS 后台持续维护内容,并在站点侧处理 SEO 与 GEO 相关设置(we0.ai)。
对需要快速验证问题簇的团队来说,这种一体化的价值不在于"生成得多快",而在于从一句需求到页面发布、再到按问题链检查覆盖度,中间不必在三四个工具之间来回搬运内容与文案。
FAQ
Q:关键词搜索量还需要看吗?
需要,但用于判断需求规模与优先级,而不是选题的唯一依据。搜索量无法反映子查询分支、答案形态和意图层级,这三项要靠问题链研究补齐。
Q:Query Fan-Out 和关键词聚类是一回事吗?
不是。关键词聚类按意图和语义把相似的词归组,用于组织内容;查询扇出是引擎把一次提问拆成多条子查询并行检索的机制,用来解释检索行为。
Q:怎么判断自己的页面能不能被引用?
从可抽取性入手:每个小节是否有可独立成立的答案块、是否点名了实体与适用场景、是否有表格或步骤、来源是否可见。这些都能人工核对,不必依赖第三方分数。
Q:小团队没有预算做完整研究怎么办?
先做最小闭环:选 10 条真实客户提问,跑一遍对话式检索并记录分支,把核心商业页补齐表格、步骤和答案块,按季度复跑并标注日期,用来区分结果变化来自内容调整还是引擎更新。
Related Tools
- Google Search Central 的 AI 功能文档:确认官方口径与基础要求。
- Perplexity:界面可见检索过程,适合观察扇出行为。
- AlsoAsked:按关键词取问题簇,补全被漏掉的分支。
- we0.ai:从建站到内容运营与 SEO/GEO 设置的一体化工作台。
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
搜索量没有失效,它只是从"选题依据"退回到"需求规模参考"的位置。关键词研究的新增工作,是把一个词扩展成一条完整问题链,为每个问题准备可被抽取的答案形态,再用问题簇而不是单词来分配页面。这样做既服务传统搜索结果,也服务会自己改写查询的对话式搜索。判断标准也随之改变:不是这个词有多少搜索量,而是当用户连续追问到第四、第五个问题时,你的站点还能不能成为被引用的那一个答案。