For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
Длительные сессии программирования накапливают не только сообщения чата. Агенту также требуется место для исходных файлов, вывода команд, ош...
Длительные сессии программирования накапливают не только сообщения чата. Агенту также требуется место для исходных файлов, вывода команд, ошибок тестирования и решений, принятых ранее в рамках задачи. Когда этот рабочий контекст заполняется, агенту приходится сжимать его перед продолжением работы.
В материале китайского новостного AI-издания Xinzhiyuan, перепубликованном на BAAI Hub, говорится, что контекст по умолчанию GPT-6.1 Sol в Codex и ChatGPT Work был увеличен с 272K до 500K токенов. В материале сообщение приписывается Thibault Sottiaux из OpenAI и утверждается, что изменение отменяет отдельную надбавку за длинный контекст при использовании по подписке. Это более конкретное утверждение, чем предположение в исходном заголовке о том, что обновление просто является «бесплатным».
Официальная документация OpenAI подтверждает доступность GPT-6.1 Sol и объясняет, как учитывается использование. Точное изменение до 500K и заявление об отмене надбавки ниже по-прежнему приводятся со ссылкой на указанный материал и скриншот объявления; проверенные официальные страницы документации не указывали это новое значение по умолчанию независимо.
Переход с 272 000 до 500 000 токенов добавляет примерно 84% ёмкости. Источник округляет это значение примерно до 80%. На скриншоте объявления также указано максимальное контекстное окно в один миллион токенов и сказано, что пользователи могут переопределить значение по умолчанию.
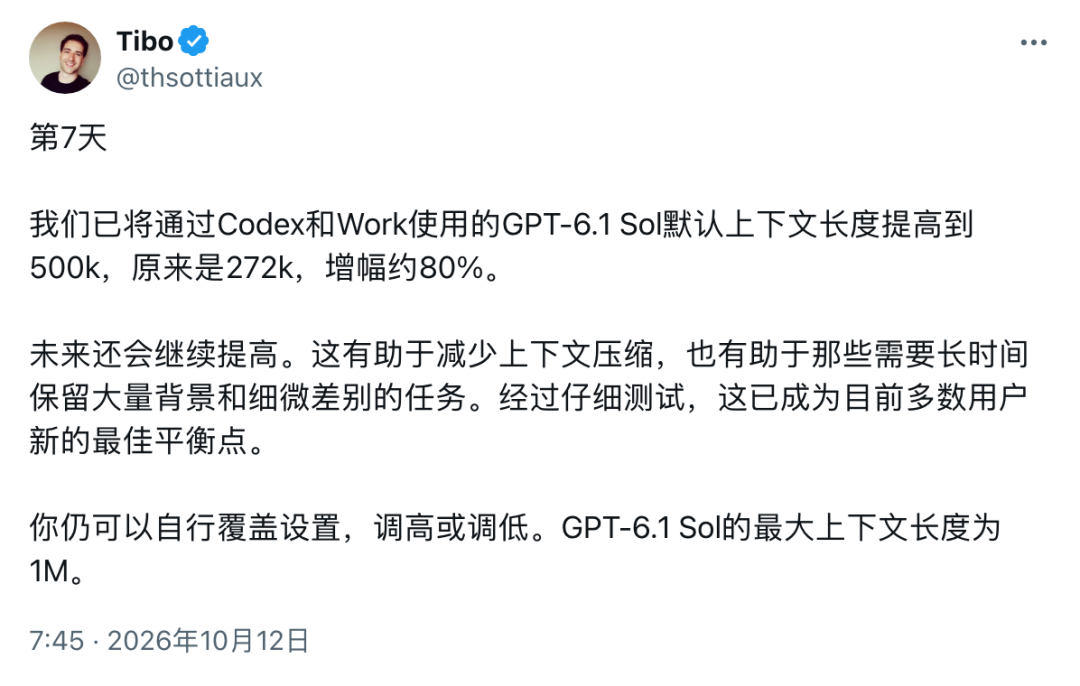
Источник: китайскоязычный скриншот объявления Thibault Sottiaux, воспроизведённый Xinzhiyuan на BAAI Hub; английское описание носит редакционный характер.
Практическое преимущество заключается в возможности сохранять больше истории задачи до сжатия. При изменении репозитория это может включать исходное требование совместимости, уже изученные файлы, неудачные подходы и последние результаты тестов.
Большее окно не гарантирует, что агент запомнит каждое требование или внесёт правильные изменения. Оно меняет объём информации, который может оставаться в его активном контексте, тогда как качество решений всё равно требует проверки.
Сжатие заменяет часть накопленной истории более коротким представлением. Это позволяет агенту продолжать работу, не сохраняя полностью каждую предыдущую строку вывода инструментов.
Компромисс состоит в том, что сжатая история может потерять полезные детали. Задача по программированию может выглядеть завершённой, но не учитывать более раннее требование, например сохранение старого формата ответа API. Сохранение большего объёма релевантного контекста может сократить частоту таких переходов, хотя и не отменяет необходимость регрессионных тестов.
В справочнике конфигурации OpenAI задокументированы model_context_window и model_auto_compact_token_limit. Это разные настройки: одна описывает доступный модели контекст, а другая определяет, когда запускается автоматическое сжатие. Наличие этих настроек не означает, что каждая модель или учётная запись поддерживает одинаковые значения.
Источник различает надбавку за длинный контекст и обычное потребление по подписке. Задача всё равно может расходовать доступный лимит, даже если дополнительный множитель специально за длинный контекст не применяется.
Официальная документация по ценам OpenAI подтверждает это более широкое различие. В ней сказано, что использование зависит от выбора модели, контекста, рассуждений, инструментов, поиска и кеширования. Длинные задачи, сохраняющие больше информации, могут расходовать значительно больше лимита, чем короткие сфокусированные запросы.
| Понятие | Что оно описывает |
|---|---|
| Ёмкость контекста | Какой объём информации модель может удерживать в рамках запроса или сессии |
| Использование по подписке | Как задача расходует включённый лимит или кредиты |
| Кешированный ввод | Ранее обработанный ввод, который может повторно использоваться по другой ставке |
| Цены API | Отдельные расходы при аутентификации и оплате через ключ API |
Короткий последующий запрос, например «продолжай», может привести к ещё одному существенному запросу к модели. Агенту могут понадобиться предыдущие файлы, требования и результаты работы инструментов, чтобы решить, что делать дальше. Кешированный ввод может обрабатываться дешевле, но это не обязательно означает отсутствие учёта.
Источник также описывает предыдущее увеличение до 372K, которое затем было отменено из-за более высокого, чем ожидалось, потребления по подписке. Этот факт полезен для понимания объявления, но его не следует считать текущим правилом биллинга или обещанием относительно стоимости какой-либо отдельной задачи.
Источник сравнивает заявленное новое значение по умолчанию с конфигурациями Claude Code на миллион токенов. Полезное сравнение требует большего, чем самое большое число в карточке модели: значения по умолчанию, пороги сжатия, доступ в учётной записи, цены и программная среда агента могут различаться.
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
Конкретные лимиты моделей Claude и порог сжатия, приведённые в источнике, для этой статьи независимо не проверялись по документации Anthropic. Поэтому их не следует воспринимать как актуальную рекомендацию по конфигурации.
В повседневной работе проверяйте одновременно три аспекта:
Официальное руководство OpenAI по моделям также указывает, что доступность зависит от тарифа, клиента, этапа развёртывания и настроек рабочего пространства. Объявление об увеличении ёмкости не предоставляет доступ к модели, которая в иных условиях недоступна.
GPT-6.1 Sol — это модель OpenAI, задокументированная для сложной работы с кодом, приложениями и документами. Официальное руководство описывает её как модель с производительностью, близкой к Astra, при более низкой стоимости; доступность зависит от тарифа пользователя и клиента.
Это означает, что в данной конфигурации модель может работать с контекстом размером примерно 500 000 токенов. Токены включают не только последнее сообщение пользователя, поэтому значение могут иметь также файлы, история задачи, вывод инструментов и ответы.
Источник сообщает об отсутствии отдельной надбавки за длинный контекст при использовании по подписке, что отличается от неограниченного доступа. Задача всё равно расходует применимый лимит, а доступ к GPT-6.1 Sol зависит от тарифа и этапа развёртывания.
Оно может отложить сжатие, предоставляя больше доступного пространства. Достаточно длинная сессия всё равно может достичь своего лимита, а настроенный порог сжатия также влияет на момент, когда происходит конденсация.
Нет. OpenAI прямо указывает, что цены токенов API отделены от использования по подписке и не должны применяться для оценки количества включённых задач.
Не только потому, что более крупное значение упоминается в отчёте. Проверьте поддерживаемую модель и конфигурацию, затем сравните качество выполнения, задержку и использование на репрезентативной задаче, прежде чем менять обычную настройку.
Заявленное значение по умолчанию в 500K даёт GPT-6.1 Sol больше места для файлов, требований и рабочей истории в Codex и Work. Его наиболее очевидное потенциальное преимущество — меньше прерываний из-за сжатия в ходе длительной задачи.
Большая ёмкость контекста полезна, но она не отменяет лимиты подписки, расходы API или необходимость проверять конечный результат.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



