For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
MetaによるMuse Wonderの発表で、よく似た名前を持つ2つのモデルが競争の場に加わりました。そのため、最初に確認すべき実務的な問いは明確です。検討しているのはMuse Wonderですか、それともMuse Wonder Fullですか。
MetaによるMuse Wonderの発表で、よく似た名前を持つ2つのモデルが競争の場に加わりました。そのため、最初に確認すべき実務的な問いは明確です。検討しているのはMuse Wonderですか、それともMuse Wonder Fullですか。
Artificial Analysisは、最大推論努力設定におけるIntelligence Index v4.3のスコアとして、Wonderを52、Wonder Fullを56と報告しています。BAAI Hubで再掲載された中国語の記事は、FullがGemini 4 Argonの報告済み53ポイントを上回った点に焦点を当てています。これは特定のモデル構成間におけるベンチマーク比較であり、どちらのWonderバリアントもすべての実務タスクで勝つことを証明するものではありません。
Metaの公式発表によると、Muse WonderはMeta Model APIおよびMuse Codeを通じて利用できます。Muse Wonder FullはMuse Codeの購読者向けに提供されています。Metaは、Wonderが将来的にMuseアシスタントの体験を支え、まずは購読者から提供を開始すると述べています。
| モデル | Intelligence Index v4.3、最大努力設定 | Metaが説明したローンチ時のアクセス |
|---|---|---|
| Muse Wonder | 52 | Meta Model APIおよびMuse Code |
| Muse Wonder Full | 56 | Muse Codeのサブスクリプション |
公開された結果を再現しようとする場合、こうした違いは重要です。API経由でWonderにアクセスすることと、コーディング製品を通じてFullを評価することは同じではありません。
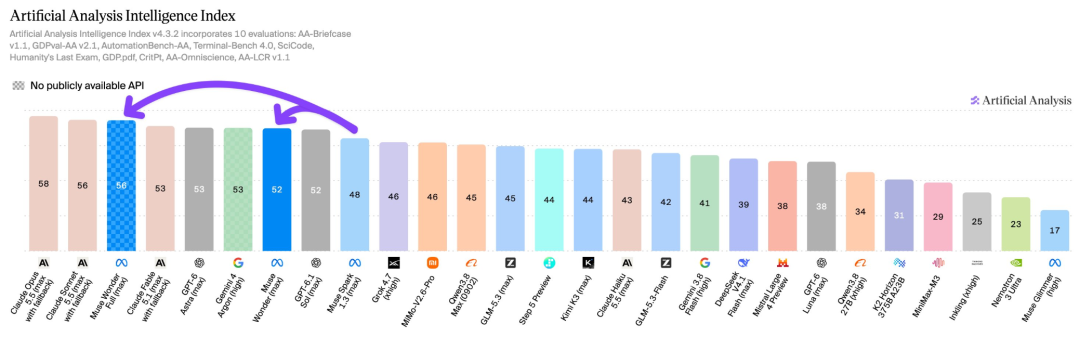
図表:Artificial Analysis。BAAI Hub上のQbitAIレポートで再掲・注釈されています。これは情報源の公開時点における比較を反映しています。
Artificial Analysisは、両バリアントについて100万トークンのコンテキストウィンドウも報告しています。同社のローンチ分析では、Wonder APIの価格として、入力トークン100万あたり4ドル、キャッシュ済み入力トークン100万あたり0.20ドル、出力トークン100万あたり20ドルが示されています。Fullはサブスクリプション製品を通じて提供されるため、その分析ではトークン単価が提示されていません。
BAAIの記事は、報道時点でGemini 4 Argonのアクセスがより限定的であったことを強調しています。提供状況は急速に変わり得るため、この歴史的な対比を、いずれかのプロバイダーの現在のアクセス規則に関する保証として解釈すべきではありません。
MetaはWonderを、パーソナルエージェントおよびプロフェッショナルエージェントのためのモデルファミリーとして提示しています。同社の発表では、異なる2つの反復的な能力に固有の名称を付けています。
Active Memoryは、会話をまたいで重要な情報を保持し、新たなタスクに関連する詳細を取り出すことに関わります。パーソナルアシスタントであれば、ユーザーが毎回繰り返す必要がないよう、すでに確立された好みを活用することが該当します。
Active Focusは、最初の試行が失敗した場合でも、目標に向けて取り組み続けることに関わります。Metaは、代替アプローチの試行、新しい情報への適応、必要に応じた確認の要請、重要な行動前のチェックを含むものとして説明しています。
コーディングには、これら両方の振る舞いが必要です。エージェントは、複数回の編集、テスト失敗、修正を経る間も、当初の制約を維持する必要があるかもしれません。Metaによると、Wonderモデルは、長時間にわたる作業を必要とする多様なタスクで訓練されており、Muse Sparkで使われたスケーリング手法を基盤としています。
情報源は、強力なソフトウェアエンジニアリングのベンチマークと、3Dゲームのデモに対するさまざまな反応を対比しています。どちらもモデルによるコード作成を必要とする場合でも、これらは異なるワークロードです。
DeepSWE 1.1は既存ソフトウェア上での作業をテストする一方、ProgramBenchはゼロからプログラムを構築することに関わります。Metaのローンチ資料にある比較表では、ProgramBenchでWonder Fullが59.0、Claude Opus 5.5が70.5と報告されています。そのため、あるモデルが特定の種類のエンジニアリングタスクで優位でも、別の種類では後れを取る可能性があります。
元のレポートでは、UnityデモにおいてOpusを好んだ開発者と、Wonder Fullの実行が成功したと報告した別の開発者についても説明されています。これらは、プロンプト、環境、成功基準がそれぞれ異なる個別の観察です。その評価が一致しないことは、エピソードを平均して普遍的な順位にするのではなく、タスク設定を確認すべき理由になります。
長時間実行されるソフトウェアテストについては、さらに重要な留保があります。Metaのモデルカードによると、SWE-Marathonの比較では、CodexおよびClaude Codeを含む競合ベンダーのコーディングエージェントを使用しています。これはエンドツーエンドの製品比較として結果を関連性あるものにしますが、すべてのモデルが同じエージェントハーネスを使用する統制比較ではありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
これにより、見出しとなるベンチマークに実務的な対応指標が加わります。印象に残るゲームデモを作れないモデルでも、保守タスクには役立つ場合があります。また、高いインデックススコアは、壊れた出力を容認する理由にはなりません。
MetaのMuse Wonderモデルファミリーにおけるフルバリアントです。Metaのローンチ発表では、FullはMuse Codeの購読者向けに提供され、通常のWonderバリアントはAPIアクセスも利用できるとされています。
情報源にあるローンチ時点のIntelligence Index比較では、Wonder Fullが56、Gemini 4 Argonが53とされています。これは、表示された特定のインデックスおよび構成についての記述であり、あらゆるタスクや評価にわたる結果ではありません。
Metaの発表は、2つのアクセス経路を区別しています。WonderはAPIおよびMuse Code向け、FullはMuse Codeの購読者向けとして記載されています。
Artificial Analysisのローンチ時の報道では、入力トークン100万あたり4ドル、キャッシュ済み入力トークン100万あたり0.20ドル、出力トークン100万あたり20ドルとされています。これらは公開時点の報告価格であるため、導入前にプロバイダーの請求条件を確認してください。
Active Memoryは、過去の会話から有用な情報を取り出すことに関わります。Active Focusは、タスクが障害に直面した際に別のアプローチを試すことを含む、持続的な実行に関わります。
それらは、その特定のタスクおよび設定における弱点を示します。より広範なコーディング性能には、リポジトリの保守、デバッグ、ツール利用、長いワークフローを通じた要件充足も含まれます。
Wonder Fullの高いローンチ時スコアは、要求の厳しいエージェント業務における関連性の高い選択肢であることを示しています。通常のWonderモデルはスコアとアクセス経路が異なるため、性能に関する主張には必ずバリアント名を伴わせる必要があります。
ベンチマークの順位は試行候補の選定に使い、その後、完了させる必要がある実際の業務で正確なモデルを比較してください。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



