For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/nvidia-rtx-spark-laptop-debuts-at.md.
NVIDIAのRTX Sparkスーパーチップが、カンファレンスでの発表から実際の消費者向けラップトップへと進化しました。上海で開催されたBilibili Worldにおいて、NVIDIAはRTX Spark搭載のLenovo Yoga Pro 15を公開デモンストレーションし、...
NVIDIAのRTX Sparkスーパーチップが、カンファレンスでの発表から実際に使用可能なコンシューマー向けラップトップへと進化しました。
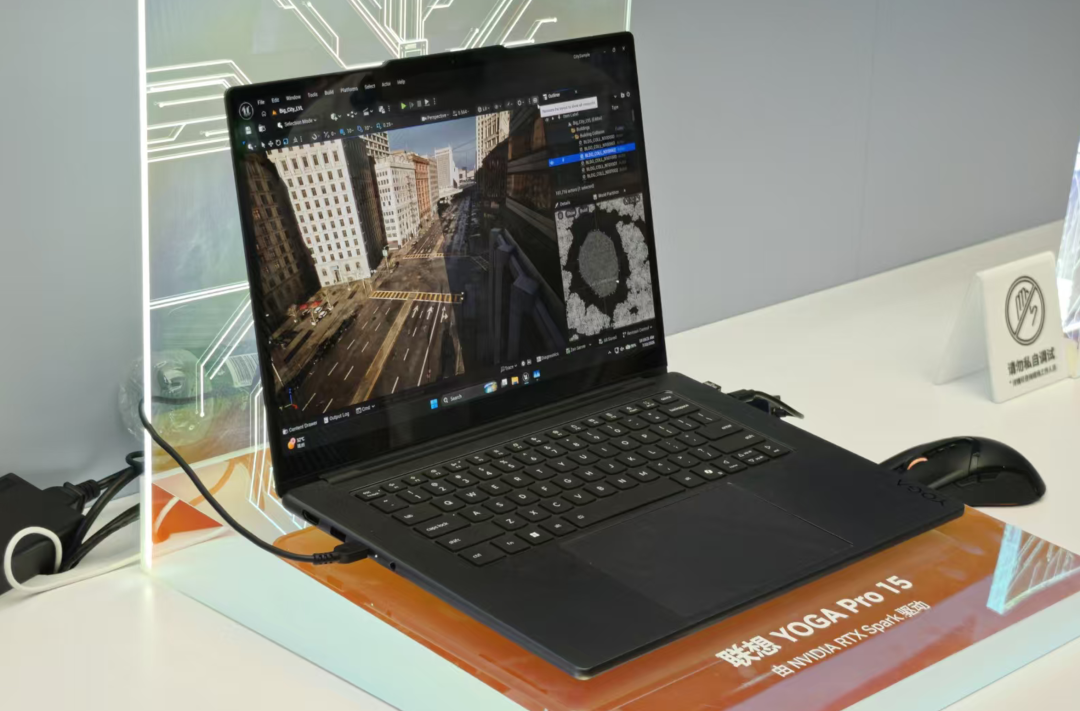
上海で開催されたBilibili Worldにおいて、NVIDIAはRTX Sparkを搭載したLenovo Yoga Pro 15の公開デモを行い、要求の厳しいローカルAI、クリエイティブ、ゲーミングの各ワークロードを実行しました。このプラットフォームは、Blackwell RTX GPUと20コアのGrace CPUをNVIDIAのNVLink-C2Cインターコネクトで接続し、両プロセッサで共有される最大128GBのユニファイドメモリを備えています。
この設計は、新しいカテゴリのWindows PCを目指したものです。すなわち、パーソナルAIエージェントをローカルで実行し、大規模なクリエイティブプロジェクトを処理し、さらに最新のRTXゲーミング機能を提供できる、薄型ラップトップまたはコンパクトデスクトップです。
NVIDIAはまた、開発者向けのLinuxベースのデスクトップAIスーパーコンピュータであるDGX Sparkもデモンストレーションしました。両システムは同様のGrace Blackwell基盤を共有していますが、ソフトウェア、ネットワーキング、ターゲットユーザー、およびモデル開発における役割が異なります。
用語注記: ソースではCPUとGPUが「溶接されている」と説明されていますが、実際に溶接されているわけではありません。NVIDIAは2つのダイを高帯域幅のNVLink-C2Cチップ間インターコネクトで接続しています。
RTX Sparkは、従来は異なるタイプのコンピュータを必要としていた3つのワークロードを中心に構築されています。
従来のゲーミングラップトップは、ディスクリートGPUのパフォーマンスを重視します。AI開発マシンは、メモリ容量とソフトウェアツールを優先します。モバイルワークステーションはプロフェッショナルアプリケーションに焦点を当てており、多くの場合、重量とバッテリー駆動時間を犠牲にしています。
RTX Sparkは、緊密に統合された1つのプロセッサパッケージと大容量のユニファイドメモリプールを使用することで、これら3つすべてを組み合わせようと試みています。
| コンポーネント | RTX Spark 仕様 |
|---|---|
| GPU | Blackwell RTX GPU |
| CUDAコア | 最大6,144 |
| CPU | 最大20コア NVIDIA Grace CPU |
| CPUアーキテクチャ | Arm |
| インターコネクト | NVIDIA NVLink-C2C |
| AIパフォーマンス | FP4で最大1ペタFLOPS |
| ユニファイドメモリ | 最大128GB |
| ターゲットシステム | 薄型Windowsラップトップおよびコンパクトデスクトップ |
| 主要ワークロード | ローカルエージェント、AI開発、クリエイション、ゲーミング |
MediaTekはNVIDIAと協力してカスタムGrace CPUの設計に取り組み、電力効率、接続性、CPU実装におけるArmシステムの専門知識を提供しました。
個別GPUを搭載した従来のノートPCでは、CPUとGPUは通常、それぞれ別々のメモリプールを維持している。データは、PCI Expressなどの相互接続を介してシステムRAMとGPUメモリ間を移動する必要がある。
このアプローチは通常のゲームや生産性タスクには適しているが、非常に大規模なAIモデルやクリエイティブなデータ・セットに対しては限界を生み出す:
それに対し、RTX SparkはCPUとGPUに最大128GBの統合メモリという共有プールへのアクセスを提供する。NVLink-C2Cは、Grace CPUとBlackwell GPU間の高帯域幅接続を提供する。
実際の利点は、すべてのワークロードでデータコピーがなくなることではない。ソフトウェアは依然としてデータを正しく管理する必要がある。むしろ、利点は、アプリケーションが小さく孤立したGPUメモリプールに依存することなく、はるかに大きなコヒーレントメモリ空間を扱えるようになることである。
ローカルのLLM、3Dシーン、ビデオタイムライン、エージェントコンテキストにとって、メモリ容量は生の計算能力と同じくらい重要な場合がある。
NVIDIAは、RTX Sparkシステムが最大1200億パラメータの大規模言語モデルを実行でき、最大100万トークンのコンテキスト長でエージェントワークフローをサポートできると述べている。
これは、すべての120Bモデルがフル精度または同じ速度で動作することを意味するわけではない。実際の実行可能性は、以下に依存する:
これらの条件を考慮しても、128GBの共有メモリを備えたポータブルコンピュータは、ローカルでテストできるものを変える。
大規模なドキュメント、コードベース、会話履歴、検索結果を、小さなクラウドリクエストに分割する代わりに、マシン上に保持できる。ローカル実行はネットワークレイテンシを削減し、機密情報をユーザーの管理下に置くことも可能にする。
NVIDIAの公式RTX Spark資料には、以下の主要なローカル機能が記載されている:
これらはプラットフォームの最大公約数的な主張である。
ローカルで動作するAIエージェントは、ファイルの読み取り、アプリケーションの起動、コマンドの実行、ウェブ検索、リクエスト送信、データの修正を行う可能性がある。
こうしたアクセス権限はセキュリティ上の問題を生み出す。高性能なモデルであっても、ユーザーのコンピュータに対する無制限な制御を自動的に与えられるべきではない。
NVIDIAとMicrosoftは、新しいWindowsセキュリティプリミティブとNVIDIA OpenShellによってこの問題に取り組んでいる。
OpenShellは以下の機能を提供するように設計されている:
ユーザーまたは管理者は、エージェントが実行できる操作を定義できる。リクエストはプライバシー要件に従ってルーティングすることも可能で、例えば機密情報はローカルモデルで処理し、無害化されたタスクはクラウドモデルに送信するといった使い分けができる。
NVIDIAによれば、OpenClawとNous ResearchのHermesは、OpenShellとMicrosoftのエージェントセキュリティプリミティブをWindowsアプリケーションに統合する予定である。
これによりハイブリッドモデルが実現する:
セキュリティレイヤーは極めて重要である。ローカルAIがプライバシーを向上させるのは、エージェントのランタイム、ファイル権限、ネットワーク動作、モデルルーティングが同時に制御される場合に限られる。
128GBユニファイドメモリ設計は、一般的なノートPCのGPUでは扱いきれない大規模プロジェクトに取り組むクリエイター向けでもある。
Bilibili Worldのブースで、NVIDIAは詳細な3Dマンハッタン環境を含むUnreal Engine 5のプロジェクトをデモンストレーションした。プロジェクトファイルは90GBを超えると報告されている。

情報源によれば、ユーザーはノートPCが電源に接続されている場合とバッテリー駆動の場合の両方で、シーン内をスムーズに移動できたという。
NVIDIAはRTX Sparkを90GB以上の3Dプロジェクト向けに公式に位置づけているが、実際のエディタの応答性はシーンの複雑さ、アセットストリーミング、ストレージ速度、冷却性能、アプリケーションの最適化、ノートPCの電源設定に依存する。
RTX SparkのBlackwellメディアエンジンは、4:2:2エンコードとデコードのハードウェアサポートを備えている。NVIDIAによれば、このプラットフォームは12K 4:2:2の動画ワークフローを処理可能だという。
Adobeは、PhotoshopとPremiereの一部を再構築し、RTX Sparkの統合メモリ、TensorRTアクセラレーション、GPUコンポジット、メディアパイプラインを活用できるようにしています。
期待される利点は以下の通りです。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
AdobeのRTX Spark最適化は、ハードウェアと同時に展開される予定であり、パフォーマンスはアプリケーションのサポートにも部分的に依存します。
RTX Sparkは、ほとんどのWindowsゲーミングPCで使用されているx86アーキテクチャではなく、Armをベースとしています。
これにより、明らかな互換性の問題が生じます。既存のPCゲームやアンチチートシステムは正しく動作するのでしょうか?
NVIDIAの回答は、ネイティブArmリリース、Windows互換性の向上、主要パブリッシャーからのサポートを組み合わせたものです。
RTX Sparkを公開サポートしている企業は以下の通りです。
Bilibili Worldでは、NVIDIAはRTX Sparkラップトップ上で、NetEaseのArmネイティブ版『NARAKA: BLADEPOINT』をデモンストレーションしました。
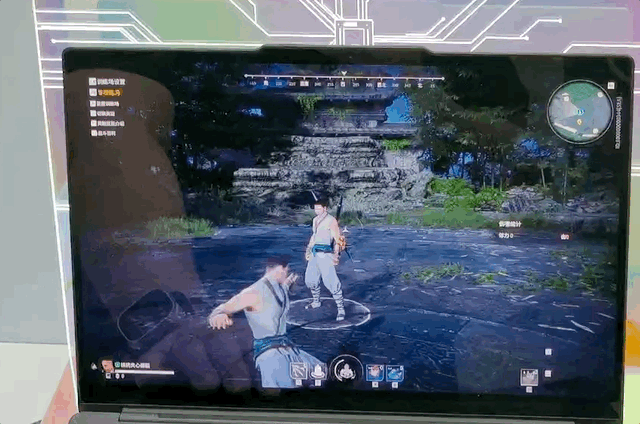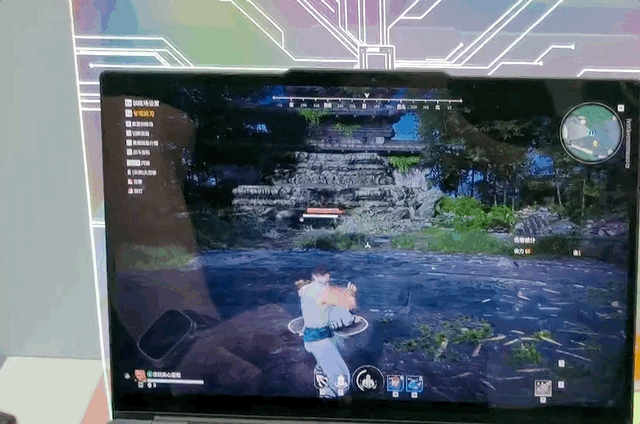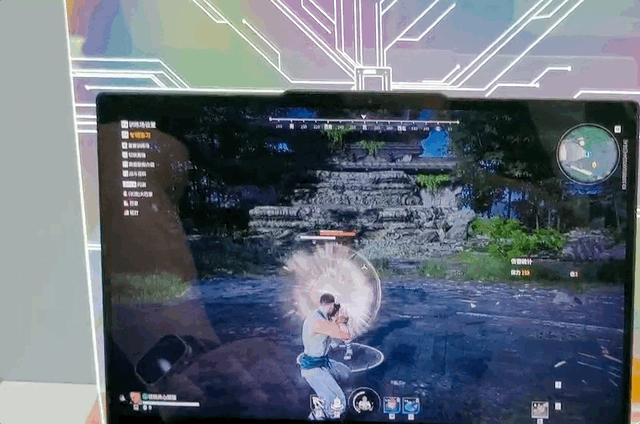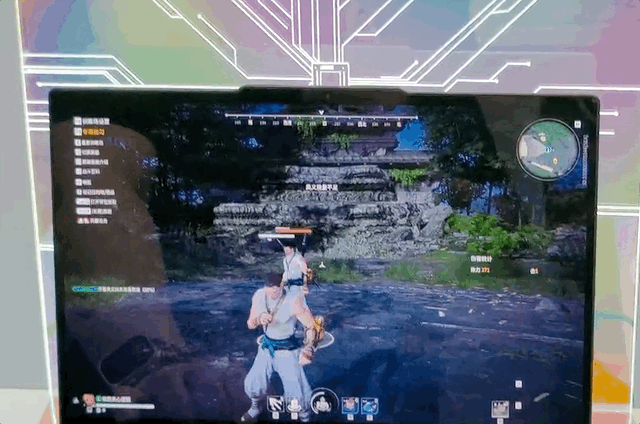
このデモでは、高視覚設定、レイトレーシング、DLSSマルチフレーム生成、その他のRTX機能が使用され、スムーズなゲームプレイが維持されたと報告されています。
NVIDIAのより広範なプラットフォーム目標は、1440pで100フレーム/秒以上のAAAゲーミングです。結果は、ゲーム、ラップトップの冷却、電力制限、ディスプレイ解像度、DLSSモード、フレーム生成、およびタイトルがネイティブかトランスレートかによって大きく異なります。
RTX Sparkは、標準的な最新RTXテクノロジースタックをサポートしています。
長期的なゲーム体験は、開発者がネイティブArmビルドをどれだけ迅速にリリースするか、そしてWindowsがレガシーx86ゲームをどれだけうまく処理できるかに依存します。
RTX Sparkは主にコンシューマーおよびプロシューマー向けプラットフォームです。DGX Sparkは開発システムとして設計されています。
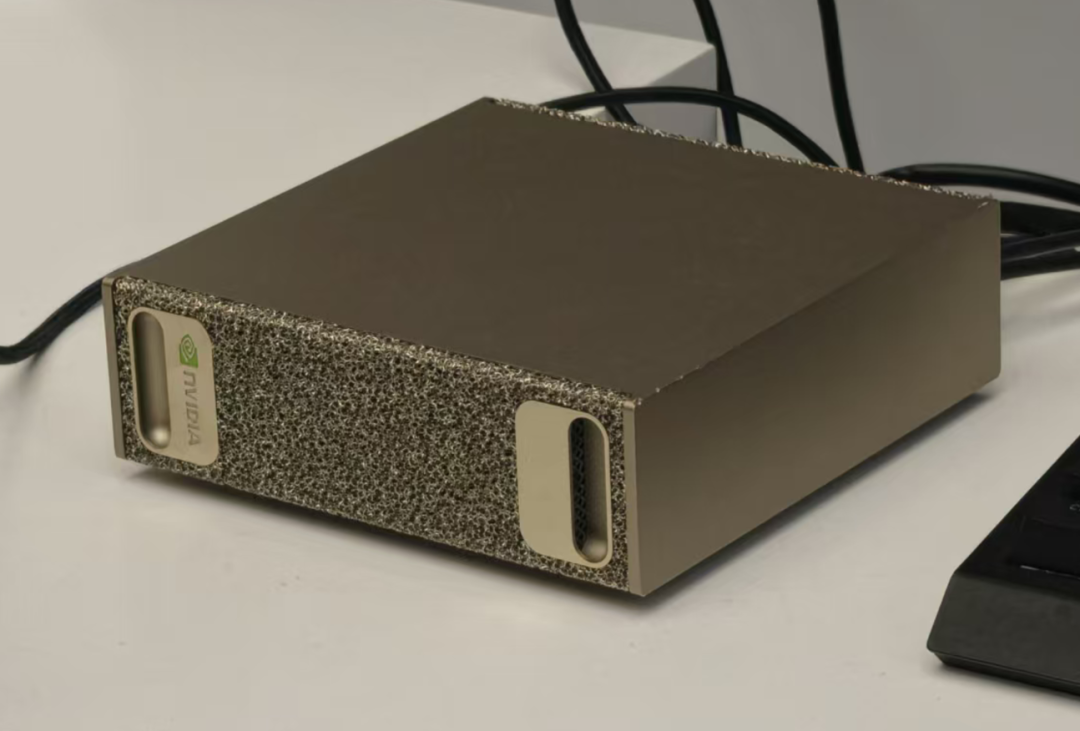
DGX Sparkは、NVIDIA GB10 Grace Blackwell Superchipを搭載し、20コアArm CPU、最大1ペタFLOPSのFP4 AIパフォーマンス、128GBの一貫性のある統合システムメモリを備えています。
NVIDIAのAIソフトウェアスタックが同梱されています。
DGX OS(LinuxベースのAI開発向けプラットフォーム)を搭載。
| ワークロード | DGX Sparkの対応能力 |
|---|---|
| ローカル推論 | 最大200Bパラメータのモデル |
| ファインチューニング | 最大70Bパラメータのモデル |
| デュアルシステム推論 | 最大405Bパラメータのモデル |
| AIパフォーマンス | 最大1ペタFLOPS(FP4) |
| メモリ | 128GB統合システムメモリ |
| ネットワーキング | ConnectX-7、最大200Gbps |
| 動作プラットフォーム | DGX OS / Linux |
| 主なターゲット | AI開発者、研究者、データサイエンティスト |
2台のDGX SparkシステムをConnectXネットワーキングで接続し、より大規模なモデルに対応可能。これはコンシューマ向けRTX Sparkプラットフォームとの重要な違いである。
開発者はNVIDIA DGX Cloudやデータセンター基盤にワークロードを移行する前に、ローカルでモデルのプロトタイプ作成、ファインチューニング、検証、実行ができる。
両システムはアーキテクチャとメモリ容量で共通点があるものの、互換性はない。
| カテゴリ | RTX Spark | DGX Spark |
|---|---|---|
| 主なフォームファクタ | 薄型ノートPC、コンパクトPC | コンパクトデスクトップAIスーパーコンピュータ |
| オペレーティングシステム | Windows | DGX OS / Linux |
| ターゲットユーザー | 一般消費者、クリエイター、ゲーマー、エージェントユーザー | 開発者、研究者、データサイエンティスト |
| AIモデルのターゲット | NVIDIAの主要ワークフローで最大120Bのローカルモデル | 最大200Bの推論 |
| ファインチューニング | 開発・プロトタイプ重視、設定に依存 | 最大70Bまでのファインチューニングを正式サポート |
| ゲーミング | フルRTXゲーミング対応 | ゲーミングシステムとしては非想定 |
| クリエイティブアプリ | Adobe、3D、メディア、Windows向けクリエイティブワークフロー | AI開発向けソフトウェアスタック |
| スケールアウトネットワーキング | コンシューマシステムはConnectXスケールアウト非対応 | ConnectX-7で2台をリンク可能 |
| エージェントセキュリティ | WindowsのセキュリティプリミティブとOpenShell | OpenShell、Agent Toolkit、NemoClaw |
| ポータビリティ | ノートPCおよび小型デスクトップオプション | デスクトップシステム |
最もシンプルな違い:
DGX SparkはNVIDIA AIソフトウェアエコシステムを搭載し、自律エージェント開発のローカルプラットフォームとして位置づけられている。
NVIDIA Agent Toolkitは、エージェントシステムをツール、データソース、モデル、可観測性コンポーネントに接続するのに役立つ。
OpenShellは分離、ポリシー施行、推論制御を提供。NemoClawはこの基盤上に構築され、常時稼働エージェントのより安全な展開を容易にする。
この役割分担は有用:
NemoClawはOpenClaw、Hermes、LangChain Deep Agents、ローカルオープンモデル、クラウド最先端モデル、または推論と併用可能。
ルーター。
Bilibili Worldのデモンストレーションで、NVIDIAはDGX Spark上で35B Qwenマルチモーダルモデルを用いたパーソナルエージェントを実行しました。
プレゼンターは簡略化した「5層AIケーキ」の図を紙に描き、カメラに提示しました。エージェントはそのスケッチを解釈し、数秒以内に完全なローカルウェブページを生成しました。
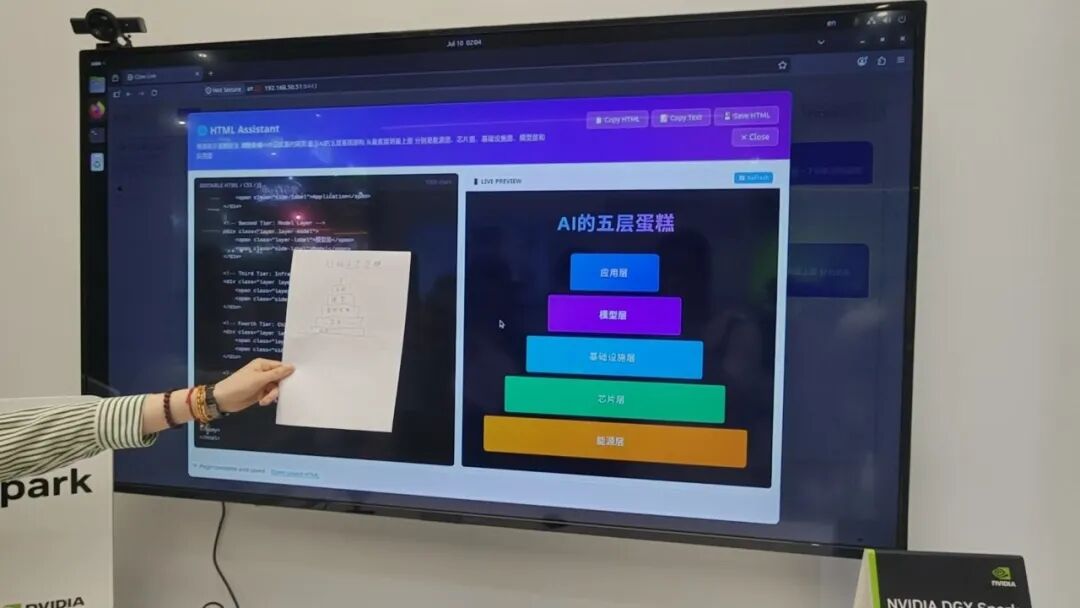
その後、結果は追跡指示によって改善することができました。
このデモンストレーションは、複数の機能を組み合わせています:
モデルとエージェントがローカルで実行されていたため、デモ中はトークン単位のクラウド課金に依存しませんでした。
しかし、ローカル実行が無料というわけではありません。ハードウェアの取得、電力、メンテナンス、ストレージ、エンジニアリング時間は依然として実際のコストです。これにより、コストモデルが従量制のリモート推論から、所有するローカルキャパシティへと変化します。
NVIDIAはNemoClawをDGX Sparkおよび同社の広範なローカルAIラインアップに適合させました。
NemoClawは、OpenShellサンドボックス内で常時稼働のエージェントを実行するためのオープンソースリファレンススタックです。これにより以下が追加されます:
DGX Sparkユーザーにとっての主な魅力は、機密データをクラウドサービスにアップロードする必要性を減らしながら、エージェントをローカルで長時間稼働させ続けられることです。
現在の公式インストールオプションには、OpenClaw、Hermes、LangChain Deep Agentsが含まれます。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



