For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh-HK/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
一項最新評估顯示,透過 Codex 執行的 GPT-6 Astra,在 50 道理論物理問題中有 49 道給出了正確的最終答案。這個 98% 的成績來自 TheoPhysEval 的工具啟用「現實」軌道,推算模型 API 平均每道問題的成本低於 3 美元。
一項最新評估顯示,透過 Codex 執行的 GPT-6 Astra,在 50 道理論物理問題中有 49 道給出了正確的最終答案。這個 98% 的成績來自 TheoPhysEval 的工具啟用「現實」軌道,推算模型 API 平均每道問題的成本低於 3 美元。
這項結果引人注目,但其適用範圍十分重要。作者明確排除了重大未解問題,並將這組題目描述為能夠套用既有技術的具體研究計算。這並不能證明 AI 已解決 98% 的物理問題,也不能證明 AI 能夠獨立選擇並完成一項重大研究計畫。
TheoPhysEval 集結了包括 ICTS、TIFR、德克薩斯大學奧斯汀分校、東京大學、哈佛大學、賓夕法尼亞大學、杜克大學和 Google DeepMind 等機構的貢獻者。它涵蓋 11 個主題下的 50 道未公開問題,範圍從經典物理和電子結構,到全息術與宇宙學。
作者估計,相關專業的專家通常可以在一天左右或更短時間內解決一道問題。相鄰領域的專家可能需要長得多的時間。這是對難度的估計,而不是一項受控的限時人類與代理比較試驗。
部分問題調整了近期計算的參數,因此模型必須重建並改編相關方法。研究人員並未因代理能夠解決某道題目,就將其從測試中刪除。他們也承認,部分貢獻者使用了 AI 輔助,因此「未公開」並不代表資料外洩的可能性為零。
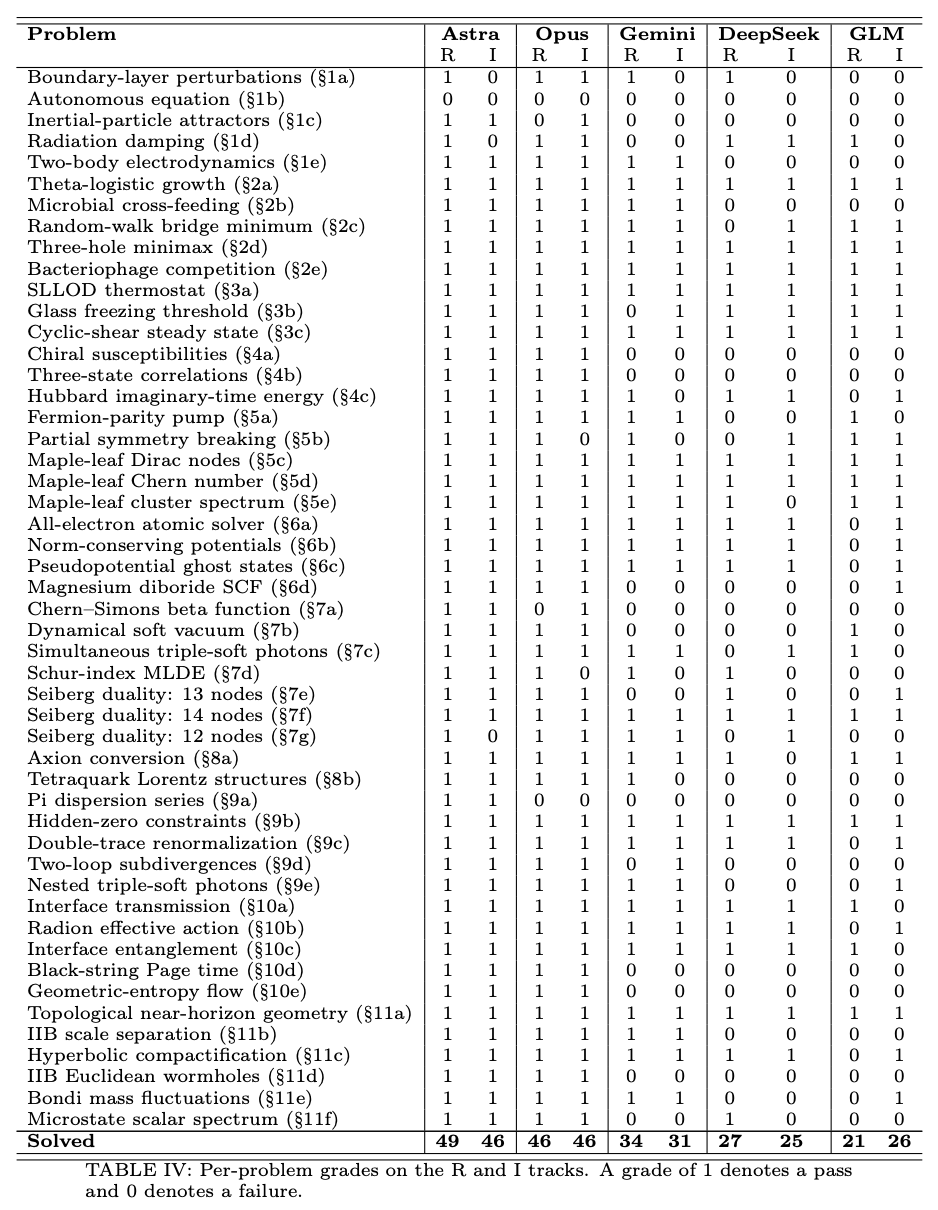
在審查期間,團隊最初將 Astra 的幾個答案判定為錯誤。研究人員向題目貢獻者諮詢後,發現參考解答中存在細微錯誤;修正後的參考解答與 Astra 的輸出一致。BAAI 報告描述了最初 88% 的評估結果,而論文公布的結果為 98%。
| 代理與執行框架 | 現實軌道 | 隔離軌道 |
|---|---|---|
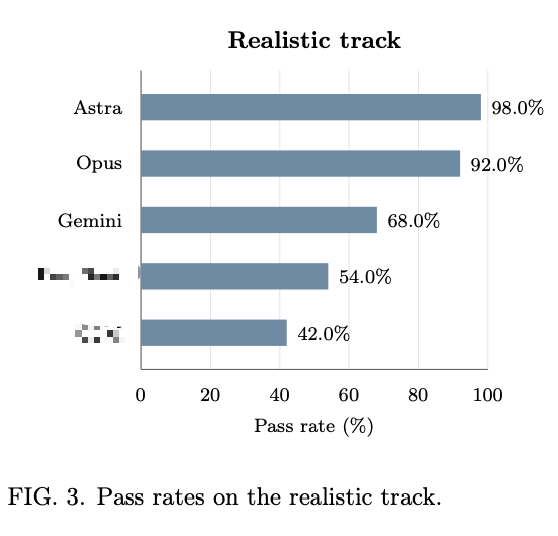
| 使用 Codex 的 GPT-6 Astra | 49/50,98% | 46/50,92% |
| 使用 Claude Code CLI 的 Opus 5.5 | 46/50,92% | 46/50,92% |
| 使用 Antigravity 的 Gemini 3.8 Flash | 34/50,68% | 31/50,62% |
| 使用 Codex 的 DeepSeek-V4.1-Flash | 27/50,54% | 25/50,50% |
| 使用 Claude Code CLI 的 GLM 5.3 | 21/50,42% | 26/50,52% |
以上為預印本所報告的結果。這些數據比較的是完整的模型與執行框架配置,而不是獨立的模型權重。
完整測試套件在每個代理的每個軌道上各執行一次。因此,在解讀相差幾道題目的結果時,抽樣變異、提示詞歧義和執行框架選擇都十分重要。
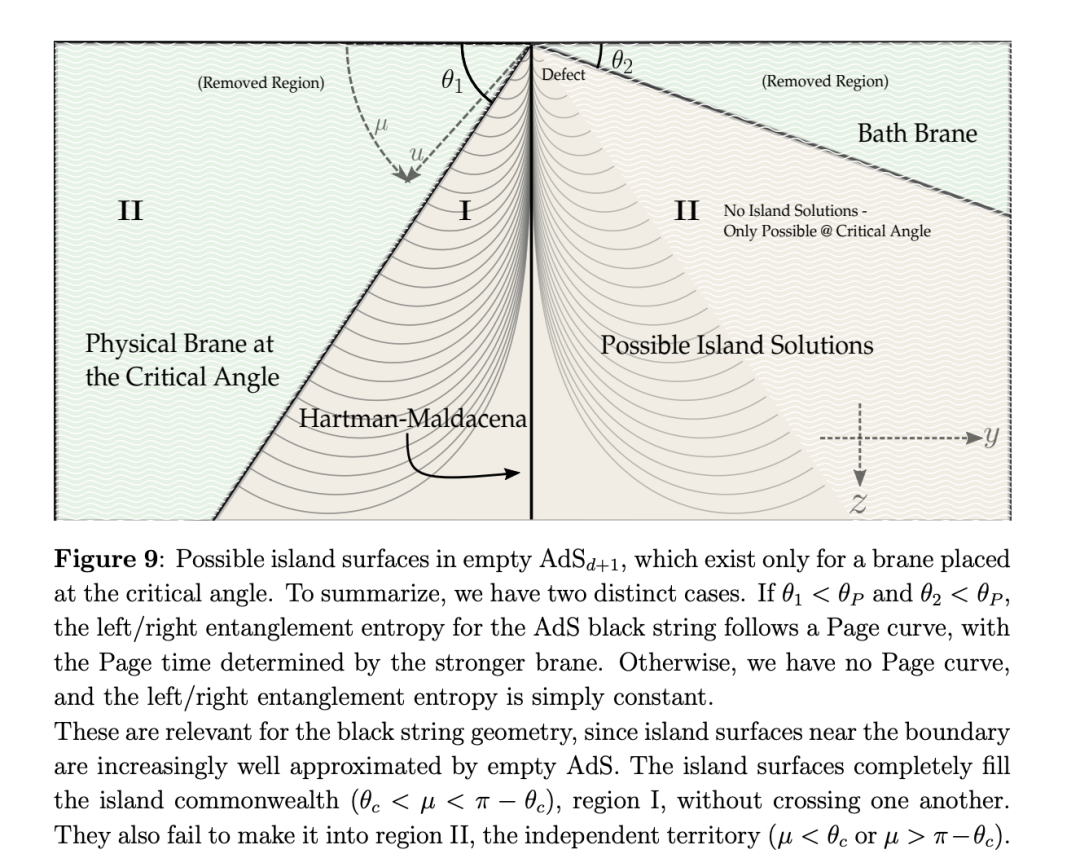
這道全息術問題要求透過比較帶有兩個膜的 AdS4 黑弦幾何中的極小曲面面積,求出 Page 時間。論文給出的預期路徑如下:
d = 3。這是一項結合文獻解讀、維度改編與數值工作的任務。若直接沿用五維公式而不進行修改,可能會得到錯誤結果。
另一項任務要求針對硼和鎂進行自洽原子計算。指定的設定採用局部密度近似、Dirac-Slater 交換和 VWN5 關聯參數化。
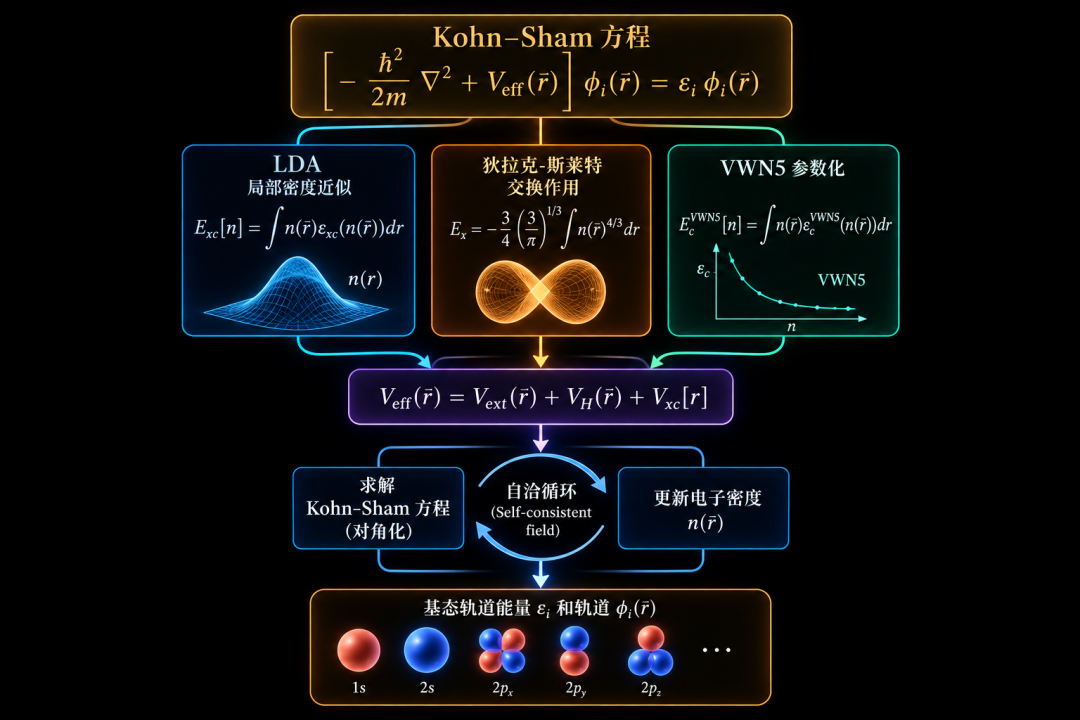
題目引用了收斂至微哈特里精度的 NIST 數據,但要求相關數值的誤差在 1e-4 哈特里 以內。參考數據的精度與驗收容差是不同的量;這項結果不應被宣傳為證明能夠普遍達到微哈特里級的一致性。
這道問題研究軸子如何在沒有外部電場的介電介質中,透過電子散射轉換為光子。評估設定了具體的數值參數,並要求計算兩種軸子質量下的速率。
這項設定使單位、耦合假設和介質響應變得十分重要。它測試的是明確條件下的計算能力,而不是關於暗物質本質的新發現。
報告還特別介紹了三維 Chern-Simons 物質理論中的 β 函數計算。其他問題涉及邊界層微擾、費米子相、高維圈圖計算、超對稱箭圖理論,以及緊緻化超重力蟲洞。
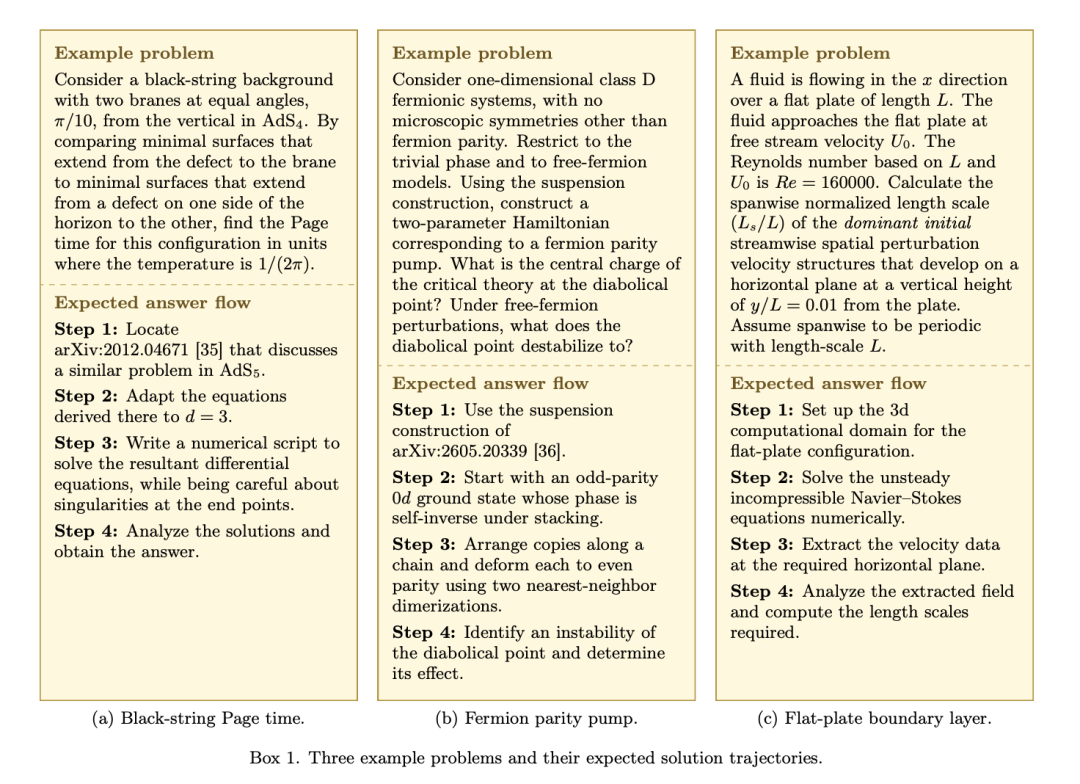
這種廣度十分重要:單一人類研究者很少會專精於所有這些方法。但這仍不代表這組題目能夠成為理論物理的完整調查。
研究人員使用 Harbor 來控制代理的執行環境。兩種軌道都允許使用本地工具,包括執行程式碼。現實軌道還允許存取網路;隔離軌道則會停用網際網路存取,但模型供應商通訊除外。
為了簡化符號答案的評分,許多提示詞會提供數值,並要求給出數值形式的最終結果。這可以減少等價表達式之間的歧義,也讓猜測答案變得更加困難。

輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
然而,與最終數字相符並不能證明每個中間步驟都正確。論文承認,部分問題中的慣例未充分明確,而且有一道逆問題很難轉換為數值形式。評分依據是最終答案,而不是對每一個推導進行正式驗證。
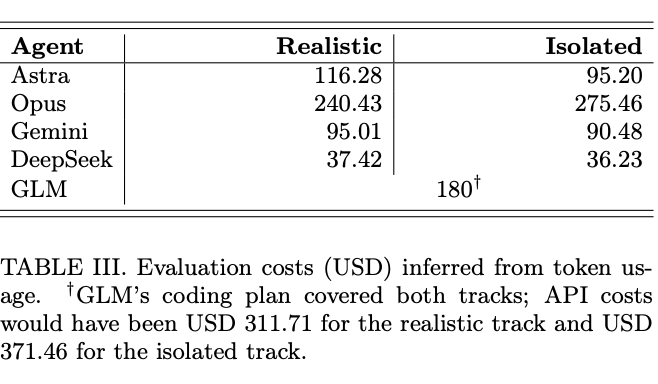
| 代理 | 現實軌道推算 API 成本 | 隔離軌道推算 API 成本 |
|---|---|---|
| Astra | 116.28 美元 | 95.20 美元 |
| Opus | 240.43 美元 | 275.46 美元 |
| Gemini | 95.01 美元 | 90.48 美元 |
| DeepSeek | 37.42 美元 | 36.23 美元 |
| GLM | 按 API 費率計算為 311.71 美元 | 按 API 費率計算為 371.46 美元 |
GLM 實際上是在涵蓋兩個軌道的 180 美元編碼方案下執行。按 API 等值計算的數字並不是這些執行所實際支付的金額。
Astra 在現實軌道的總成本除以 50 後,每道問題約為 2.33 美元。這是按照評估所採用費率計算出的推算 token 費用,並不包括執行研究組織、取得專業知識或驗證科學工作的總成本。
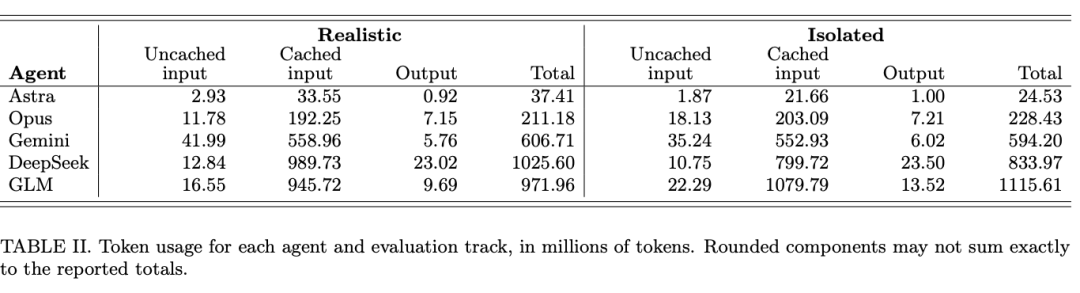
評估沒有設定一般性的 token 預算,但設定了任務逾時時間:通常為 8 小時,涉及相關電子結構任務時則提供更長的時限。較低的平均 token 成本,不應與保證較低的延遲混為一談。
來源接著引用了一篇涉及麻省理工學院 Neil Thompson、Gabriel Manso 和 Claudio Mayrink Verdun 的研究報導。Superpower Daily 引用 WIRED 的報導稱,在特定理論問題上的成功率,已從 2024 年中最佳系統約 2%,上升至 2026 年中約 35%。
這組數字相當於 17.5 倍的比率,以及 33 個百分點的增幅。它涉及另一組涵蓋機率、統計、經濟理論和多個物理領域的題目,並使用一系列後續的 OpenAI 系統進行測試,且不允許存取網際網路。
這些百分比不應與 TheoPhysEval 的得分合併解讀。兩者在任務、模型陣容、評分方式和範圍上都不同。受審查的第二手報告還指出,在該項比較中,實驗和基於模擬的工作被排除在外。
TheoPhysEval 中有一道逆問題擊敗了所有接受測試的代理。它要求根據給定的軌跡,找出一個相容的自主微分方程。論文討論了資訊不對稱,以及如何靈活解讀這項設定;但它並未證明普遍不存在「物理直覺」。
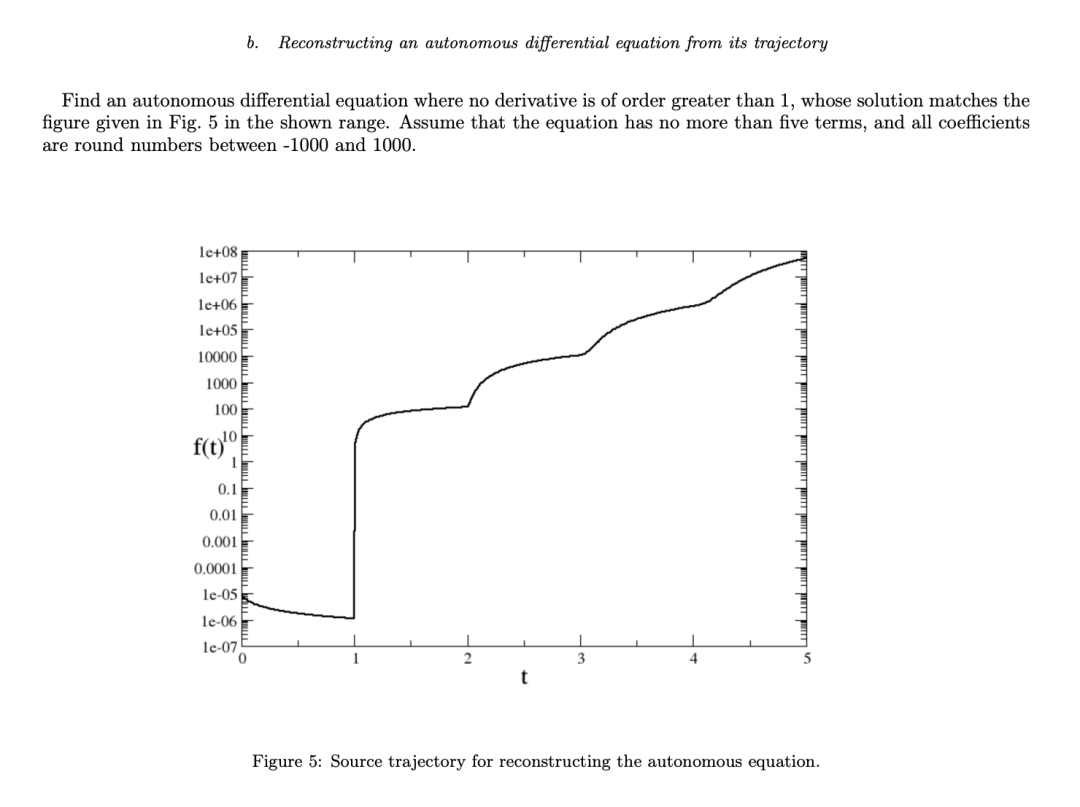
作者區分了具體計算、建立理論、選擇重要問題,以及在方法失敗時調整方向。他們的結論支持在專家指導下使用代理,同時也提出了早期職涯研究人員應如何學習計算技能的問題。
即使代理能夠以低廉成本取得最終答案,訓練練習仍可能具有價值。此時,練習的目的應是學習和理解,而不是將答案本身視為研究貢獻。
這是一組包含 50 道未公開、可驗證的研究級理論物理問題的題集。作者設計它是為了評估使用標準代理工具進行自主計算的能力,而不是評估重大未解問題的發現能力。
在現實軌道中,它在 50 道問題裡給出了 49 道獲接受的最終答案。這項得分適用於受評估的模型、Codex 執行框架和環境,並不適用於所有物理問題。
不是。它們仍然可以執行本地計算工具。關鍵限制是網際網路存取,而不是程式碼執行。
論文報告指出,幾個最初被拒絕的答案與修正後的專家參考解答一致。這支持我們仔細檢查參考資料,而不是假設模型或人類答案必然正確。
不是。未公開答案可以減少一種資料污染來源,但部分貢獻者使用了 AI 輔助。作者明確承認無法排除資料外洩。
作者在 Hugging Face 上提供了資料集和評估資源的連結。重現測試時應保留模型版本、執行框架設定、測試軌道、數值慣例和評分規則,同時考慮不同執行結果之間的變異。
TheoPhysEval 報告顯示,AI 在一組明確定義、具備可驗證性的進階計算中取得了出色表現。它的兩種軌道說明,有效的物理代理工作可以結合已學得的知識、文獻存取能力和可執行的計算。
這項結果也暴露了參考解答錯誤、評分歧義,以及僅評估最終答案的局限性。強大的計算表現支持由專家主導的研究,但不能證明 AI 已自主掌握科學發現。
從一句話開始,幾分鐘內拿到完整網站。



