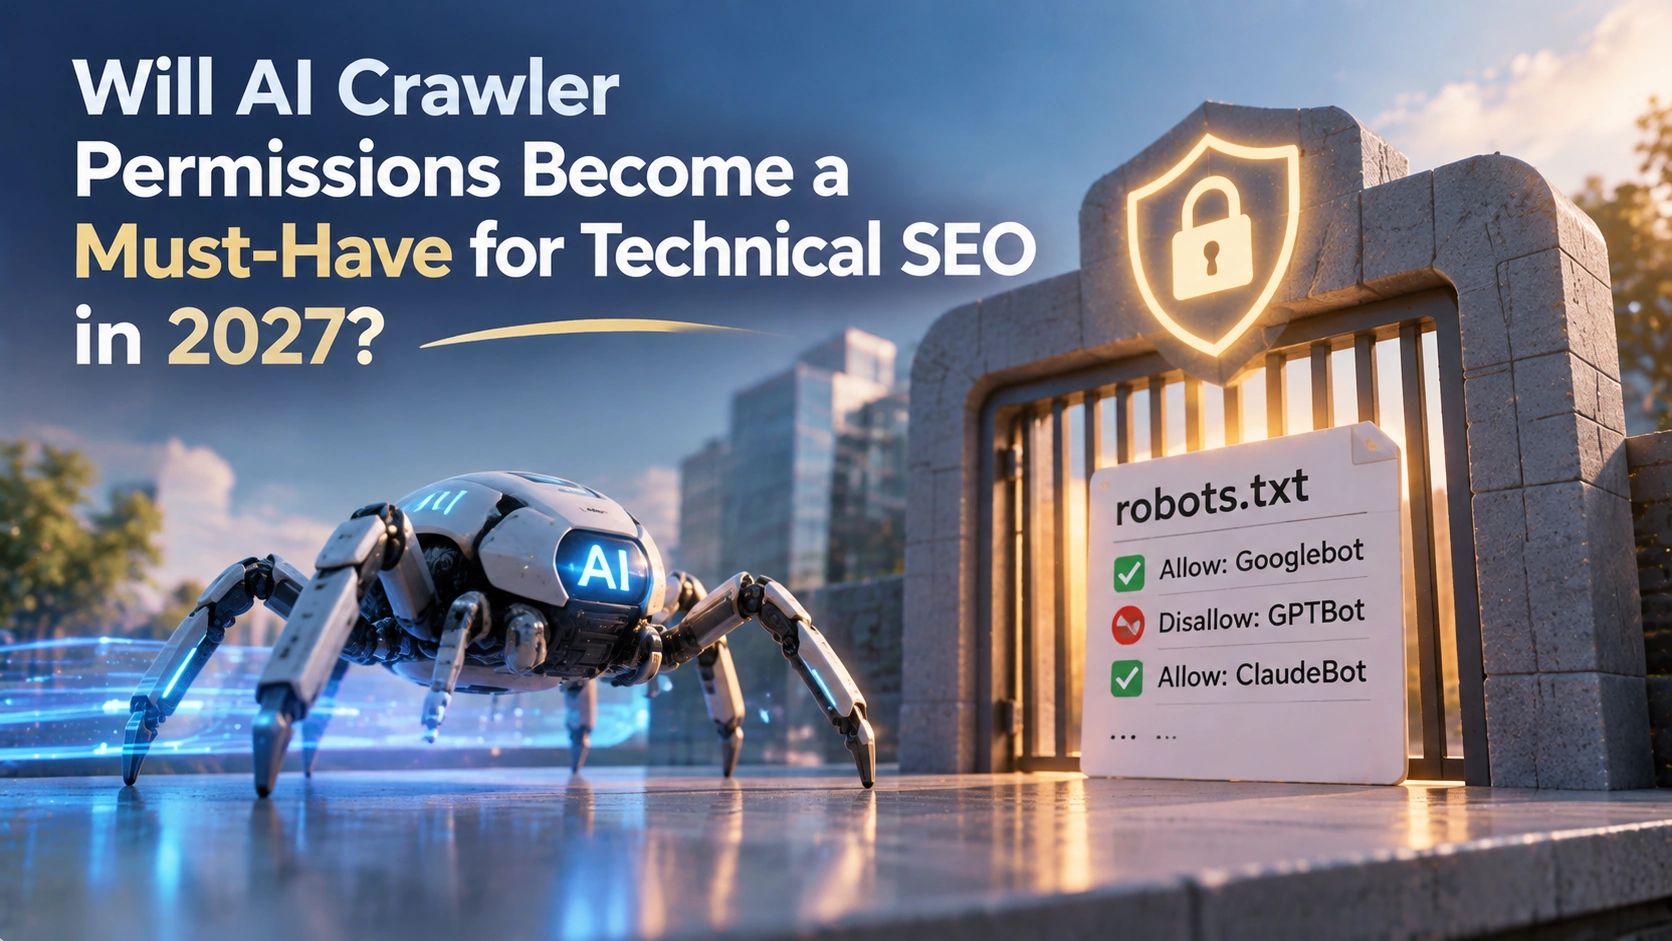
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
Futura señal compartida de preferencias de entrenamiento (Google planea admitirla a principios de 2027)
User-agent: __usage_ai-training
Disallow: /
Hay que prestar especial atención: el `Disallow` de `Google-Extended` no hará que la página desaparezca de los resultados de la Búsqueda de Google. La documentación oficial indica que no afecta a que el sitio se incluya en los resultados de la Búsqueda de Google ni se utiliza como factor de medición de ranking en la Búsqueda de Google. A la inversa, una prohibición total bajo `User-agent: *` afectará también a Googlebot; este tipo de «bloqueo por conveniencia» es el autodaño más habitual en SEO técnico.
## Por qué AI Training y AI Grounding deben analizarse por separado
Este es el grupo de conceptos que más fácilmente se escribe mal en 2027.
**AI Training (entrenamiento)** se refiere a si el contenido de la página se utiliza para entrenar versiones futuras del modelo; afecta a los parámetros del modelo. **AI Grounding (fundamentación)** se refiere a si el modelo utiliza en tiempo real el contenido de la página recuperado como base fáctica al responder; afecta a si tu información puede aparecer en una respuesta concreta. Lo primero tiene que ver con el uso no remunerado de los activos de contenido; lo segundo, con si puedes aparecer en las respuestas de IA. Las consecuencias comerciales son completamente distintas.
Según la explicación oficial de Google sobre `Google-Extended`, este token gestiona si el contenido que Google rastrea de los sitios web puede utilizarse para entrenar versiones futuras de los modelos Gemini, que dan soporte a la aplicación Gemini y a Gemini en Vertex AI; también se utiliza para proporcionar al modelo, en la aplicación Gemini, contenido del índice de Búsqueda de Google con el fin de mejorar la veracidad y la relevancia, así como para el grounding cuando se usa Google Search en Vertex AI. Es decir, en esta implementación de Google, el permiso de entrenamiento y el permiso de fundamentación quedan cubiertos por el mismo token. Los operadores que quieran «prohibir el entrenamiento y conservar las citas» necesitan confirmar con cada plataforma si ofrece esa capacidad de separación; no pueden asumir que todas las plataformas ya la han separado.
## ¿Bloquear el entrenamiento afectará también a las citas en búsquedas de IA?

Hay que responder según el escenario; no se puede resumir con una sola frase.
**Dentro de la Búsqueda de Google, no.** Las funciones de IA se construyen sobre el índice de búsqueda; bloquear el entrenamiento no hará que la página pierda oportunidades de indexación. Este es el resultado directo del diseño separado de `Google-Extended` y `Googlebot`.
**En escenarios de asistentes de IA externos, a menudo sí.** Estos sistemas utilizan sus propios rastreadores; cada plataforma tiene reglas distintas sobre si ejecutan JavaScript, si respetan robots.txt o si priorizan el rastreo de páginas con estructura clara. Bloquear el entrenamiento suele equivaler a bloquear el rastreo, y si se bloquea el rastreo se pierde la posibilidad de ser citado. En la entrevista de Moz hay un recordatorio práctico: para el contenido que se quiere que la IA vea, la información clave debe aparecer directamente en el HTML original; a la inversa, el renderizado con JavaScript también puede usarse como mecanismo de protección para dificultar la lectura masiva de activos que no se desea que se extraigan. Es una disyuntiva, no un interruptor gratuito.
**En el plano de la monitorización, es fácil quedarse a ciegas.** El verdadero riesgo es no poder ver el efecto después de bloquear. Si en los logs no hay siquiera el registro correspondiente, no se puede determinar si el impacto es «nadie vino a rastrear» o «rastrearon pero no citaron».
## ¿En qué se diferencian las reglas de control de Google y las de otras plataformas?
Según los materiales públicos verificables, las diferencias se concentran en tres puntos: granularidad de control, forma de denominación y ritmo de entrada en vigor.
| Dimensión | Google | Otras plataformas (según la documentación oficial de cada una) |
| --- | --- | --- |
| Lugar de expresión | Token de user agent en robots.txt + señal compartida de preferencias prevista | Campos de preferencia definidos en su propia documentación; la denominación y la ubicación no son uniformes |
| Control de entrenamiento | Token de producto independiente `Google-Extended` | La mayoría se expresa mediante una declaración de preferencia separada, con campos diferentes |
| Relación con la indexación en búsqueda | La documentación oficial indica claramente que no afecta a la indexación ni al ranking | Hay que confirmarlo con cada proveedor; no se puede extrapolar entre plataformas |
| Ritmo de entrada en vigor | La señal compartida de entrenamiento está prevista para principios de 2027 | En fase de implementación gradual |
| ¿Ya está plenamente implementado? | La señal compartida sigue en desarrollo | No puede considerarse completado |
El mismo robots.txt no significa lo mismo en distintas plataformas; la extrapolación entre plataformas es el error factual más común.
## Los límites de cinco métodos de control de permisos
| Método | Ámbito de impacto | Afecta a la indexación de Google | Afecta a la IA de terceros | Reversibilidad |
| --- | --- | --- | --- | --- |
| Token `Google-Extended` | Usos de entrenamiento y fundamentación de Google | No afecta | No afecta | Alta; basta con cambiar el archivo |
| Token `Googlebot` | Búsqueda de Google e Imágenes, Vídeos, Noticias, etc. | Afecta directamente | No afecta | Alta |
| `X-Robots-Tag` / meta robots | Control de rastreo e indexación a nivel de página | Afecta directamente | Depende de la plataforma | Media; hay que esperar a un nuevo rastreo |
| Contenido clave renderizado en el cliente | Visibilidad del contenido | Normalmente se puede renderizar | A menudo provoca invisibilidad | Media; requiere cambios de arquitectura |
| WAF / bloqueo por IP | Bloqueo a nivel de solicitud | Puede bloquear también a Google | Eficaz pero agresivo | Baja; fácil de causar daños colaterales |
La lista de decisión puede simplificarse en tres preguntas: ¿este contenido debe usarse para entrenamiento? ¿Debe ser citado? ¿Si surge un problema, se puede revertir en diez minutos? Si alguna pregunta no tiene respuesta, no se debería tocar la configuración.
## Cinco pasos de implementación para los operadores de sitios web
**Primer paso: inventariar antes de actuar.** Usa los logs para confirmar qué user agents están accediendo realmente. Un punto de partida suficiente es contar solicitudes por UA:
```bash
awk -F'"' '{print $6}' access.log \
| sort | uniq -c | sort -rn | head -30
Primero revisa la lista y luego define la estrategia; no añadas una prohibición a un UA por impresión.
Segundo paso: definir capas de política. Distingue al menos tres tipos de páginas: páginas de marketing que deben ser rastreadas y citadas por buscadores e IA, contenido sensible solo para lectura humana, y materiales que pueden ser públicos pero que no se desea que se usen para entrenamiento. Los tres tipos de páginas no deberían compartir la misma regla.
Tercer paso: escribir la configuración y anotar la intención. En robots.txt, usa comentarios para explicar la razón de negocio de cada bloque de reglas, de cara a futuras entregas y auditorías.
Cuarto paso: validar. Usa la herramienta de prueba de robots.txt de la plataforma para comprobar el resultado de análisis del UA objetivo y, al mismo tiempo, vuelve a leer los logs para confirmar los cambios en el rastreo.
Quinto paso: establecer un ritmo de revisión. La señal compartida de preferencias de entrenamiento sigue en desarrollo; se recomienda revisar cada trimestre en lugar de configurar una vez y no volver a tocarlo durante mucho tiempo.
Errores comunes y limitaciones
Tratar robots.txt como una barrera legal. Expresa una intención, no ofrece fuerza coercitiva; la protección real debe combinar segmentación de contenido, control de acceso y cláusulas contractuales.
Creer que bloquear el entrenamiento equivale a que el contenido sea invisible. En el lado de la Búsqueda de Google no se cumple; en el lado de asistentes externos, a menudo sí. Las conclusiones son opuestas.
Gestionar solo el entrenamiento y no la fundamentación. Si una plataforma vincula entrenamiento y grounding en el mismo token, bloquear el entrenamiento también debilita las oportunidades de ser citado.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Tomar la gestión de permisos como un interruptor de tráfico. Decide «quién puede leer y qué puede hacer después de leer», pero no promete ranking, tráfico ni resultados de conversión.
Ignorar las diferencias de renderizado. Si el contenido solo existe en JavaScript, equivale a guardar silencio ante un tipo de rastreador; este tipo de problema excede el alcance de la configuración de permisos y requiere cambios conjuntos en frontend y arquitectura.
El trabajo diario del SEO técnico está pasando de «hacer que los motores de búsqueda entiendan» a «explicar claramente quién puede leer y qué puede hacer después de leer». Si la estructura de páginas, la información estructurada y la actualización de contenido del sitio ya son caóticas, la configuración de permisos solo registrará ese caos. Avanzar la creación del sitio y la operación de contenido dentro de un mismo sistema suele ahorrar más costes que añadir reglas a posteriori; por ejemplo, we0, al generar el sitio, integra la optimización SEO y GEO, el backend CMS y el despliegue de dominio en una misma cadena, de modo que la estructura de páginas, los bloques de información citable y el flujo de publicación se conforman juntos, y la estrategia de permisos posterior es más fácil de aplicar a tipos de página concretos.
FAQ
¿Hay que completar la gestión de permisos de rastreadores de IA antes de 2027?
No es necesario cambiar la configuración de inmediato, pero se recomienda definir el inventario y la estrategia antes de 2027. La señal compartida de preferencias de entrenamiento sigue en desarrollo y Google planea admitirla a principios de 2027; los equipos que aclaren de antemano la segmentación de páginas solo tendrán que cambiar unas pocas líneas de configuración cuando el campo entre en vigor.
Si prohíbo Google-Extended en robots.txt, ¿desaparecerá el sitio de la Búsqueda de Google?
No. Según la documentación oficial de Google, Google-Extended no afecta a que el sitio se incluya en los resultados de la Búsqueda de Google ni se utiliza como factor de ranking. Lo que afecta a la indexación en búsqueda son las reglas relacionadas con Googlebot.
¿AI Training y AI Grounding son lo mismo?
No. El entrenamiento determina si el contenido entra en los parámetros de futuros modelos; grounding determina si el modelo utiliza tu contenido en tiempo real como base para responder. Algunas implementaciones cubren ambos con el mismo token, por lo que hay que confirmarlo con cada proveedor.
Los rastreadores de IA no ejecutan JavaScript, ¿qué impacto tiene en la configuración de permisos?
Mucho. Si la información clave solo existe en el resultado renderizado en el cliente, por muy precisa que sea la configuración de permisos, la otra parte no podrá leer el contenido. O pones la información central en el HTML original, o aceptas que este tipo de rastreadores no la vean.
¿Cómo saber si la configuración realmente ha surtido efecto?
Tres cosas: validar con las herramientas oficiales de prueba el resultado de análisis para el user agent objetivo, releer los logs de acceso para confirmar si cambió el rastreo, y fijar un conjunto de preguntas reales para comprobar periódicamente si en las respuestas de IA siguen apareciendo tu marca y la fuente.
Herramientas relacionadas
- Google Search Console (diagnóstico de indexación y rastreo)
- Herramienta de prueba de robots.txt (validación del resultado de análisis para el user agent objetivo)
- Análisis de logs de acceso del servidor (recuento de la distribución de rastreo por UA)
- we0 (espacio de trabajo de creación de sitios y crecimiento con IA, que cubre optimización SEO y GEO, backend CMS y despliegue de dominio)
Enlaces relacionados
- Lista de rastreadores comunes de Google (documentación oficial)
- Ofrecer a los sitios web opciones compartidas de control del entrenamiento de IA (blog del Centro de Búsqueda de Google)
- Stop Calling It SEO: 12 estrategias para dominar la búsqueda con IA en 2026 (Moz)
- Práctica de implementación de la optimización para motores generativos (GEO) (Comunidad de desarrolladores de Tencent Cloud)
- Sitio web oficial de We0
Resumen
La gestión de permisos de rastreadores de IA en 2027 probablemente se convertirá en un entregable habitual del SEO técnico, pero el núcleo no es «bloquear la IA», sino expresar por separado tres tipos de uso —rastreo para búsqueda, entrenamiento de modelos y contenido de fundamentación (grounding)— y dejar registros auditables. Hay tres razones: las preferencias de entrenamiento avanzan hacia señales legibles por máquina compartidas, que Google planea admitir a principios de 2027; el objeto de control ha pasado de un único Googlebot a tokens de producto independientes; y las citas de IA siguen teniendo como requisito previo la capacidad de rastreo. En la ejecución, inventariar primero los logs, definir después políticas por capas de página, anotar la intención con comentarios, validar el resultado del análisis y establecer un ritmo de revisión trimestral es más eficaz que un bloqueo puntual. Los límites también son claros: robots.txt es una convención, no una imposición; Google-Extended no afecta a la indexación ni al ranking en la Búsqueda de Google; y en algunas implementaciones el permiso de entrenamiento y el permiso de fundamentación aún no están separados. Dejar claras estas diferencias evita que la gestión de permisos se convierta en una operación errónea irreversible.