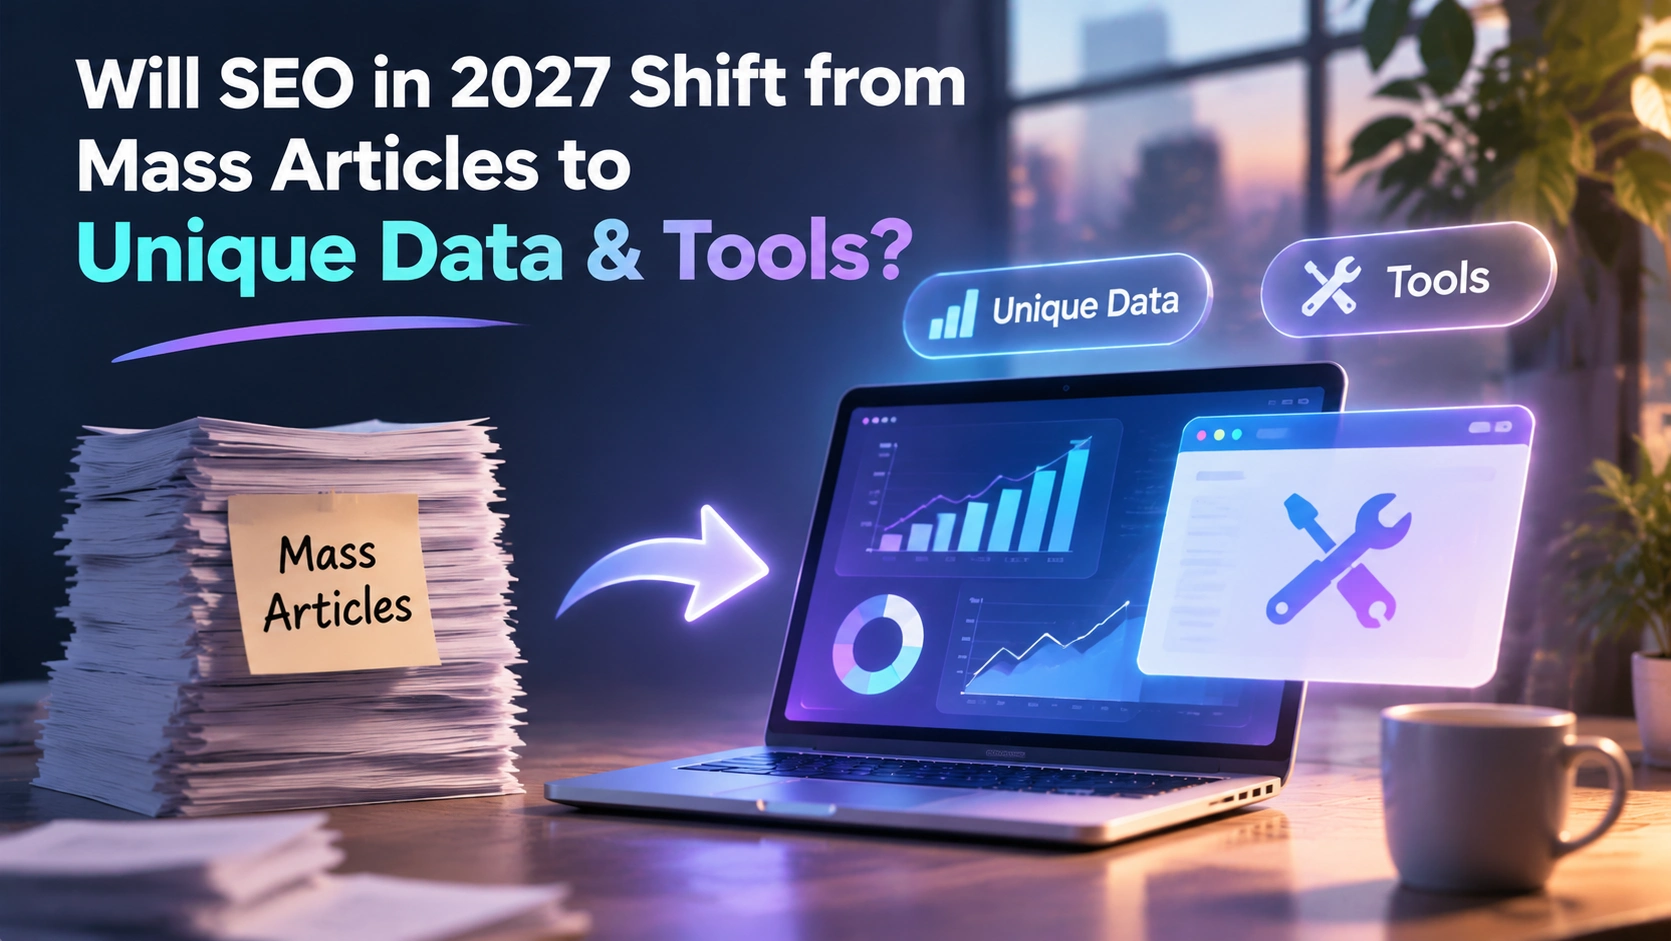
Si condensamos el cambio de 2027 en una frase: el rendimiento marginal de tráfico de las páginas producidas en masa seguirá bajando; las páginas que aportan información independiente y ayudan al usuario a completar una tarea ganarán valor relativo.
Es una predicción sectorial, no una regla ya publicada por los buscadores. La conclusión se apoya en tres tipos de materiales públicos: la definición de la política de spam sobre «generación a gran escala sin valor para el usuario», el énfasis de la guía sobre contenido generado con IA en si el contenido resulta útil, y el fenómeno observable de que las respuestas generativas suelen incluir enlaces de cita.
La forma real del giro no es «dejar de actualizar el blog», sino una reorganización de la mezcla de contenidos. Los artículos explicativos pasarán de ser la principal fuente de tráfico a ocupar la base: siguen siendo necesarios, pero difícilmente sostendrán por sí solos el crecimiento de un sitio de contenidos. Los datos exclusivos, las herramientas interactivas, las páginas de bases de datos consultables y los casos reales serán el campo de batalla de la diferenciación.
Qué ocurre en la estructura de la oferta cuando la IA lleva el coste de producción a casi cero
La IA cambia primero la estructura de costes. Cuando un artículo genérico con estructura completa y frases fluidas puede producirse a coste casi nulo, la oferta de páginas para una misma intención de búsqueda se infla rápidamente, mientras la atención total de los usuarios no cambia.
El resultado no es que «el contenido de IA sea penalizado», sino que «las páginas sin incremento de información independiente pierden ventaja comparativa». Lo que realmente se diluye son tres tipos de páginas:
- variantes de plantilla que solo cambian el nombre de la ciudad, del sector o el año;
- «pseudoinvestigaciones» que reordenan informes públicos y solo añaden un párrafo de interpretación;
- textos largos que no dan una respuesta en la primera pantalla y obligan al usuario a leer todo para juzgar si son relevantes.
En la época en que solo había diez enlaces azules, estos tres tipos de páginas aún podían captar migajas mediante la cola larga. Pero hoy, cuando las respuestas se extraen directamente y las páginas deben ser citadas como evidencia, su situación ha empeorado claramente.
La política ya ha trazado la línea roja: «escala + ausencia de valor añadido»
En el plano político hay dos hechos que deben distinguirse.
Primero, la Política de spam de la Búsqueda de Google incluye en el abuso de contenido a escala (scaled content abuse) las páginas «generadas a gran escala para manipular el posicionamiento en buscadores y que no aportan valor añadido al usuario», y aclara que la determinación de este comportamiento no depende de si el contenido se creó de forma automática o manual. La clave es que «escala» y «ausencia de valor añadido» se cumplan al mismo tiempo, no que «se haya usado IA».
Segundo, la Guía de Google sobre contenido generado con IA permite que los sitios usen medios automáticos para ayudar a producir contenido, siempre que este sea útil para el usuario, tenga credibilidad y haya una persona responsable de la calidad. La misma guía del sitio sobre contenido útil, fiable y centrado en el usuario también pone el foco de juicio en información verificable como «quién lo escribió, cómo se hizo y por qué merece confianza».
Vistas en conjunto, el punto de riesgo de publicar artículos en masa no está en la herramienta, sino en la sustituibilidad: un lote de páginas cubre decenas de palabras clave similares, el usuario no puede tomar una decisión tras leer cualquiera de ellas y tanto los buscadores como los usuarios carecen de razones para tratarlas de forma diferenciada.
Tres señales de predicción y un límite que debe respetarse

Primera, el criterio político ya es claro. Las páginas automatizadas a gran escala y de bajo valor están en la zona de incumplimiento; este límite no depende de conjeturas sectoriales.
Segunda, el centro de la documentación oficial es la «utilidad». La Guía de inicio de SEO de Google habla de ayudar a los buscadores a entender el contenido y a los usuarios a encontrar y juzgar si merece la pena visitarlo; el glosario de MDN Web Docs recoge SEO como término web básico. Ninguna de las dos establece una condición técnica como «debe haber datos originales», pero ambas sitúan en el centro si el usuario se beneficia.
Tercera, la ruta de consumo de contenido está cambiando. Cada vez más usuarios obtienen primero un resumen con citas en un asistente de IA y después deciden qué página abrir. Las páginas que pueden citarse como evidencia suelen tener un criterio concreto, una muestra concreta y una ventana temporal concreta.
También hay que dejar claro el límite: los datos exclusivos, la investigación original y las herramientas interactivas no son actualmente factores de posicionamiento publicados por Google. Decir que son «factores de posicionamiento confirmados oficialmente» es incorrecto. La formulación más prudente es que, en un entorno de mayor homogeneización de páginas, estos formatos tienen más probabilidades de obtener señales reales de usuarios y citas externas, y por tanto de aventajar en la competencia.
Comparación de capacidades de cinco formatos de contenido
| Formato de contenido | Valor central | Intención de búsqueda principal que cubre | Coste de reutilización y mantenimiento | Recomendación de indexación |
|---|---|---|---|---|
| Artículo genérico generado por IA | Explicar conceptos básicos y cubrir preguntas de cola larga | Preguntas introductorias de «qué es» y «cómo se hace» | Bajo, pero muy fácil de cubrir por contenido homogéneo | Fusionar páginas similares y conservar solo unas pocas con diferencias reales |
| Artículo de investigación original | Aportar datos independientes y conclusiones citables | «Cuánto», «cómo evoluciona la tendencia», «comparación sectorial» | Alto; requiere explicación metodológica y actualización periódica | Indexar prioritariamente, con página de metodología y explicación de datos |
| Herramienta interactiva | Ayudar al usuario a completar una tarea o obtener un resultado de cálculo en el momento | «Calcular», «comprobar», «generar», «evaluar» | Medio-alto; requiere mantener lógica y resultados | Indexar prioritariamente y asegurar que la página de resultados sea rastreable |
| Página tipo base de datos | Ofrecer información estructurada consultable y filtrable | «Lista», «precio», «modelo», «región» | Medio; depende de la frecuencia de actualización de la fuente | Indexar solo si cumple condiciones de unicidad; reducir el resto |
| Caso real | Aportar experiencia real, proceso y límites de los resultados | «Efecto», «cómo implementarlo», «merece la pena» | Medio; depende de la acumulación de proyectos reales | Indexar, destacando sujeto, tiempo y condiciones limitantes |
La columna que más se pasa por alto en la tabla es «coste de reutilización y mantenimiento». Los artículos en masa tienen bajo coste, pero el precio es que su valor de reutilización también es bajo; la investigación y las herramientas exigen una inversión inicial alta, pero un conjunto de datos puede sostener múltiples interpretaciones, versiones multilingües y citas durante mucho tiempo.
Qué cuenta como «datos exclusivos que otros no pueden crear a corto plazo»
«Exclusivo» no equivale a «lo he contado yo mismo», sino a que otros difícilmente pueden reproducirlo en poco tiempo. Los datos que suelen generar diferenciación provienen de cuatro tipos de fuentes:
- Acumulación propia del negocio: comportamiento agregado anónimo dentro del producto, ciclos de cierre de ventas, causas frecuentes de fracaso, distribución de uso de funcionalidades.
- Procesos de clientes y proyectos: ciclos de lanzamiento, comparaciones antes y después de una renovación, cambios en la estructura de tráfico de pago y orgánico.
- Paneles sectoriales de recogida continua: capturas periódicas de ofertas de empleo, páginas de precios, documentación pública y textos normativos.
- Cuestionarios o entrevistas propias: investigación primaria con tamaño de muestra, método de reclutamiento y tasa de respuesta explícitos.
Para que los datos puedan citarse, además deben cumplir cuatro elementos a la vez: definición del criterio (cómo se calculan numerador y denominador), alcance de la muestra (quién entra y quién queda fuera), ventana temporal (periodo de recogida y frecuencia de actualización) y explicación del método (cómo se limpia y cómo se tratan los valores atípicos). Si falta cualquiera de ellos, ni el lector ni el asistente de IA podrán juzgar si la cifra es fiable, y el valor diferencial se verá reducido.
También conviene recordar el contraejemplo: reordenar cifras de informes públicos y añadir una interpretación propia no constituye datos exclusivos. Este tipo de contenido puede atraer clics a corto plazo, pero no crea una barrera de citación.
Por qué los calculadores, las herramientas de test y las páginas interactivas resisten mejor la sustitución
Un resumen puede repetir una explicación, pero no puede completar un cálculo por el usuario. Cuando alguien busca «cuánto cuesta este tipo de proyecto» o «si mi sitio cumple cierta condición», lo que realmente quiere es un resultado, no una descripción. Las páginas de herramientas tienen por tanto dos características naturales: la acción del usuario ocurre en la página y la página misma forma parte de la respuesta.
Para llevar esta ventaja al rendimiento en búsqueda hay que resolver tres cosas.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
- Hacer que la página se pueda rastrear primero. El texto explicativo central, el significado de los campos de entrada y la explicación de resultados deben entregarse preferiblemente mediante renderizado en servidor o prerenderizado, evitando que todo el contenido se genere solo después de un clic. La rastreabilidad es un requisito previo de las páginas interactivas.
- Añadir datos estructurados a la página de la herramienta. Por ejemplo, para una herramienta de evaluación gratuita se puede usar el tipo
SoftwareApplicationpara marcar nombre, categoría y precio:
{
  "@context": "https://schema.org",
  "@type": "SoftwareApplication",
  "name": "Herramienta de autodiagnóstico de indexabilidad del contenido del sitio web",
  "applicationCategory": "BusinessApplication",
  "operatingSystem": "Web",
  "offers": { "@type": "Offer", "price": "0", "priceCurrency": "CNY" }
}
- Hacer que los resultados se puedan compartir y citar. Solo cuando los parámetros pueden reproducirse mediante un enlace y el resultado tiene una explicación de cálculo clara, las páginas externas y las respuestas de IA lo tomarán como referencia.
Cómo organizar los casos empresariales y la investigación original
El problema de los casos suele no estar en la cantidad, sino en la estructura. Un caso que merece confianza debe explicar al menos cinco cosas: contexto y restricciones del proyecto, acciones concretas adoptadas (no limitarse a escribir «se optimizó la estrategia de contenidos»), cambios observables, duración de la observación y situaciones en las que no aplica. Si solo se escribe el «efecto» como conclusión, al lector le resulta más difícil juzgar si es relevante para su caso.
La investigación original encaja mejor en una estructura de tres capas: la primera es una página de resumen de conclusiones, con uno o dos párrafos que expliquen los hallazgos más importantes y el tamaño de la muestra; la segunda es una página de metodología, que detalle fuentes de datos, reglas de limpieza, tratamiento de valores faltantes y limitaciones; la tercera es un apéndice de conjunto de datos o gráficos, para facilitar que otros citen cifras concretas. El contenido de investigación también debe mantener un registro de cambios, indicando versión de datos y motivo de revisión; de lo contrario, seis meses después las cifras se contradirán y la credibilidad se perderá rápidamente.
Cuatro acciones para que las páginas de herramientas y las de tutoriales se apoyen mutuamente
Las herramientas resuelven el «hacer»; los artículos resuelven el «por qué» y el «cómo». Ambos son puertas de entrada de tráfico y respaldo de confianza.
- Usar los artículos para anticipar la necesidad. En el tutorial, explicar en qué casos se necesita la herramienta, qué parámetros introducir y cómo interpretar los resultados; colocar el enlace a la herramienta en contextos de acción como «empezar a calcular» o «empezar a comprobar», no insertarlo al azar en un párrafo.
- Usar la herramienta como evidencia del artículo. Si las conclusiones de un artículo pueden verificarse con una pequeña herramienta reproducible, la permanencia y el retorno del lector serán más naturales, y aumentará la probabilidad de que páginas externas citen la misma página.
- Unificar terminología y estructura. El mismo indicador debe usar exactamente el mismo nombre y definición en la página de la herramienta, en la del tutorial y en la del caso, para evitar que el usuario vea criterios distintos en páginas diferentes.
- Establecer una actualización coordinada. Cuando cambie la lógica de la herramienta, revisar al mismo tiempo los valores de ejemplo de los tutoriales y casos relacionados, e indicar versión o fecha de actualización para reducir contradicciones entre páginas.
Cómo juzgar si una página programática merece ser indexada
La generación programática no es ilegal por sí misma; lo que incumple es «gran escala + ausencia de valor añadido». Antes de publicar, revisar cada punto de esta lista; si alguno es claramente negativo, considerar fusionar o establecer noindex:
- Información única: ¿tiene esta página datos, inventario, parámetros o conclusiones exclusivos de esa combinación? Si solo cambia el grupo de palabras del título, la respuesta es no.
- Capacidad de respuesta: si el usuario llega con una pregunta concreta, ¿la primera pantalla ofrece una respuesta o un siguiente paso claro?
- Veracidad: ¿las cifras, nombres y fechas de la página existen realmente y pueden rastrearse hasta la fuente de datos?
- Escala de combinaciones: ¿este lote de páginas es la cáscara de una misma plantilla o cada combinación tiene diferencias sustanciales? Las combinaciones sin diferencias deben reducirse drásticamente.
- Mantenibilidad: cuando se actualicen los datos, ¿las páginas se sincronizarán automáticamente o habrá que corregirlas una a una manualmente?
- Valor de entrada: ¿la página tiene enlaces internos y una ubicación de navegación clara, o solo puede descubrirse por casualidad mediante el sitemap?
- Presupuesto de rastreo: ¿las páginas de bajo valor están desplazando recursos de rastreo de páginas importantes?
La acción posterior al cribado es más importante que el cribado en sí: fusionar las páginas que no cumplen en una página resumen más completa, aplicar noindex a las variantes puramente paramétricas manteniendo su accesibilidad y reservar los recursos de rastreo liberados para las páginas de herramientas y de investigación.
Cómo priorizar ahora en la empresa
Si se quiere ajustar la combinación de contenidos a partir de este mes, se puede avanzar en tres pasos, sin necesidad de reescribir todo el sitio de una vez:
- Inventariar lo existente: clasificar las páginas actuales según la tabla anterior y señalar las que solo existen como variantes de plantilla; este paso suele permitir limpiar la mayor cantidad de producción de bajo valor.
- Elegir un punto de entrada entregable, una herramienta o un conjunto de datos: partir del eslabón del negocio que mejor se conoce, por ejemplo estimación de presupuestos, comparación de configuraciones o autocomprobación de cumplimiento; primero calcular bien un problema y después ampliar.
- Construir el entorno de soporte: las páginas de herramientas, metodología y casos necesitan una base de sitio estable, un CMS mantenible y una configuración básica de SEO/GEO. Espacios de trabajo de IA como We0, que cubren desde la creación del sitio hasta la captación de clientes, pueden generar la estructura de páginas con lenguaje natural y, mediante un lienzo visual, la colaboración de múltiples agentes, el backend CMS y el despliegue de dominio, integrar las páginas de herramientas y de contenido en un mismo sitio para operarlas de forma unificada, reduciendo la desconexión habitual de «la herramienta está terminada pero nadie la mantiene».
Preguntas frecuentes
¿Seguirá funcionando publicar artículos en masa en 2027?
Sigue funcionando, pero su ámbito de aplicación se reducirá. Los artículos que cubren preguntas reales de cola larga, tienen información precisa y se mantienen de forma continua siguen siendo útiles; las variantes de plantilla que solo cambian el nombre de la ciudad o el año tendrán cada vez menos valor, porque tanto para los usuarios como para los buscadores son intercambiables entre sí.
¿Los datos exclusivos son un factor de posicionamiento publicado por Google?
No. En la documentación oficial pública actual no existe una condición técnica como «puntos extra por datos originales». La interpretación más razonable es que los datos exclusivos hacen que una página sea más difícil de sustituir por contenido similar y más fácil de citar por páginas externas y respuestas de IA, pero no deben presentarse como un mecanismo de posicionamiento confirmado oficialmente.
¿Qué deben hacer los equipos pequeños y medianos que no tienen datos propios?
Empezar por los datos más disponibles: los ciclos de lanzamiento de proyectos propios, la distribución de preguntas frecuentes de clientes y los registros comparativos antes y después de una renovación pueden organizarse en pequeñas investigaciones estructuradas. No hace falta que sean de gran escala, pero el criterio, la muestra y la ventana temporal deben estar claramente escritos. En la dirección de herramientas ocurre lo mismo: una herramienta pequeña que calcula bien reglas sectoriales generales suele dar resultados antes que perseguir grandes datos.
¿Las páginas de herramientas interactivas podrían no ser rastreadas por depender de JavaScript?
Existe ese riesgo, pero puede evitarse. Si la explicación central de la herramienta, el significado de los parámetros y la interpretación de resultados se publican en un formato rastreable, y se añaden datos estructurados adecuados a la herramienta, los buscadores pueden entender el tema de la página. El verdadero problema es encerrar el contenido detrás de la interacción y dejar la página inicial casi vacía.
¿Hay que separar la página de la herramienta y el artículo tutorial?
Se recomienda separarlos. La página de la herramienta asume «completar la tarea»; su contenido debe ser breve, directo y permitir empezar de inmediato. La página del tutorial asume «juzgar y explicar»; puede escribirse de forma más completa. Que ambas se enlacen entre sí y compartan el mismo conjunto de definiciones terminológicas facilita que se entiendan y se citen, más que comprimir dos intenciones en una página excesivamente larga.
Herramientas relacionadas
- We0: espacio de trabajo de IA para creación de sitios web y captación de clientes orientado a sitios de presentación; admite describir necesidades en lenguaje natural, generación de páginas con colaboración de múltiples agentes, ajuste en lienzo visual, despliegue de dominio, backend CMS y optimización SEO/GEO. Es adecuado como base de sitio para páginas de herramientas, casos y páginas de aterrizaje de investigación.
Enlaces relacionados
- Política de spam de la Búsqueda de Google: definición oficial de infracciones como el abuso de contenido a escala.
- Guía de Google sobre contenido generado con IA: requisitos y criterios oficiales al producir contenido con ayuda de IA.
- Google: crear contenido útil, fiable y centrado en el usuario: dimensiones de autoevaluación para juzgar si el contenido merece confianza.
- Guía de inicio de SEO de Google: conocimientos básicos de optimización para buscadores y puntos clave de rastreo e indexación.
- MDN Web Docs: SEO: definición terminológica y explicación básica de SEO.
Resumen
El cambio del SEO en 2027 probablemente se manifestará más como una migración de la estructura de contenidos que como una reducción a cero de la cantidad. La ventaja de coste de los artículos en masa sigue existiendo, pero su ventaja diferencial está desapareciendo; en un entorno de oferta inflada, resultados de búsqueda que dan respuestas directamente y respuestas de IA que incluyen citas, las páginas que aportan datos independientes, ayudan al usuario a completar tareas y explican con claridad experiencias reales tienen más probabilidades de ser confiables y citadas. El límite que debe respetarse en el plano político es claro: las páginas generadas a gran escala y sin valor añadido están en la zona de incumplimiento, mientras que los datos originales y las herramientas interactivas no son factores de posicionamiento confirmados oficialmente. La ruta viable consiste en empezar con datos reales a pequeña escala, conectar las páginas de herramientas y las de tutoriales, controlar con una lista de verificación el alcance de indexación de las páginas programáticas y concentrar los recursos de rastreo en unas pocas páginas con valor único real.