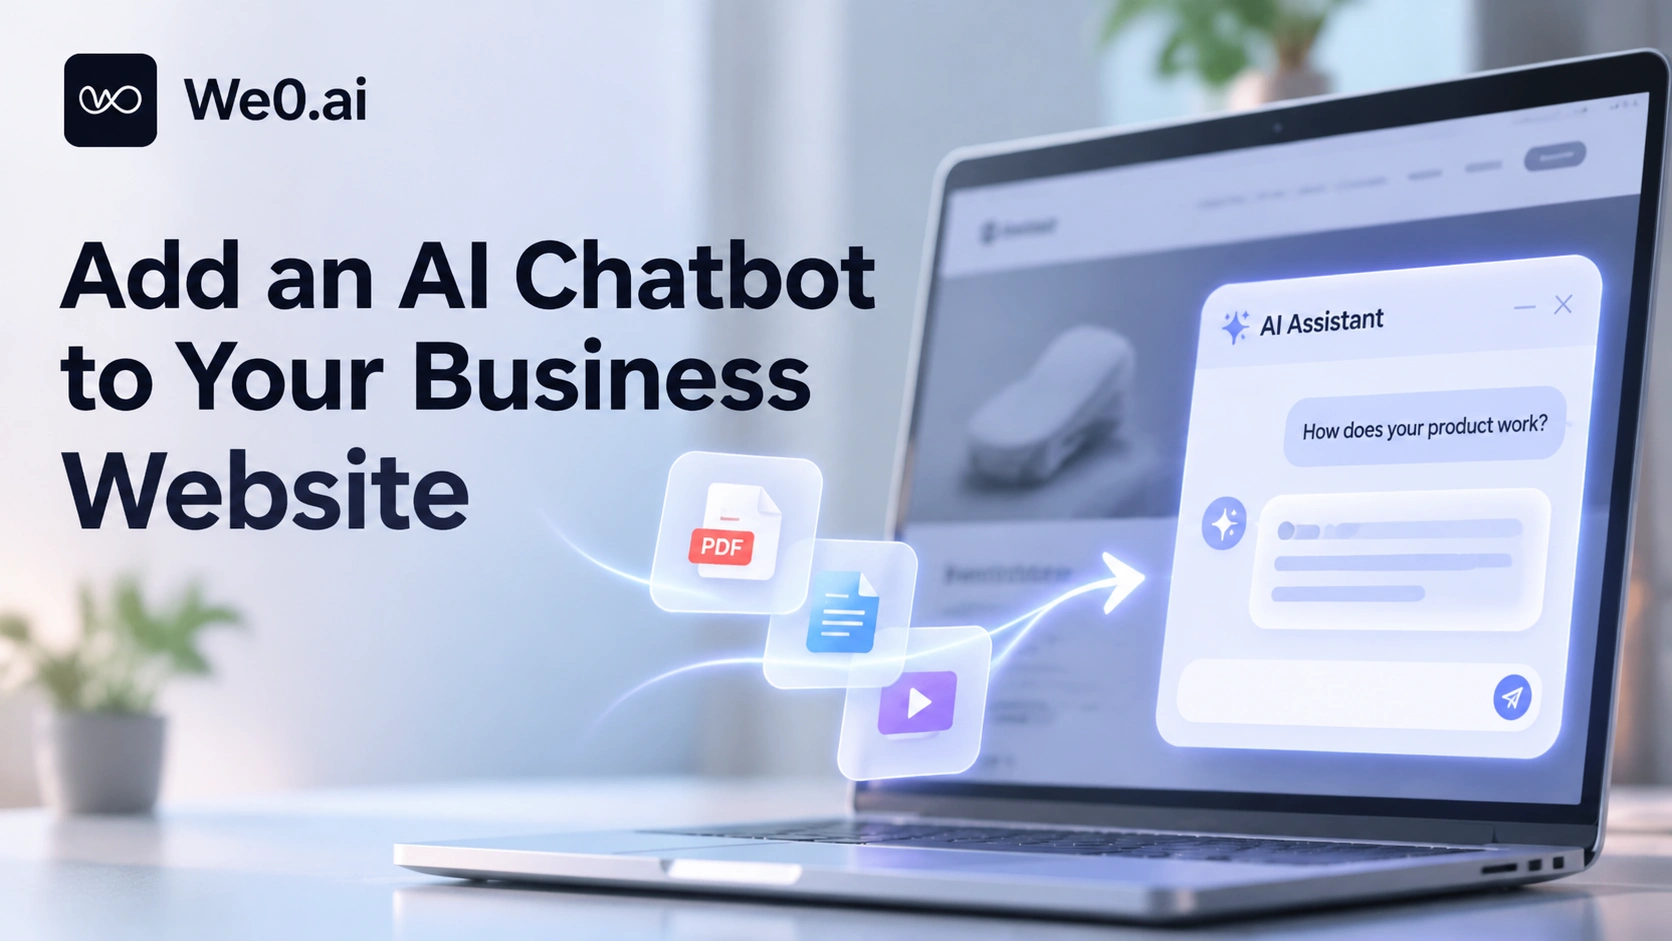
Una página de FAQ común funciona con la lógica de «la persona busca la respuesta»: el usuario decide qué entrada abrir, lee el párrafo completo y luego lo compara con su propia situación. Sin embargo, las preguntas que realmente recibe una empresa suelen ser combinaciones del tipo «¿esta versión nuestra admite despliegue privado? Los datos no pueden salir de la intranet», mientras que en la FAQ solo existe una entrada «admite despliegue privado», y tras leerla el usuario sigue sin tenerlo claro.
La diferencia del servicio con IA es que la respuesta se organiza en el momento según la pregunta. Toma el contenido del sitio web, la documentación del producto y la lista de FAQ como base de conocimiento; cuando el usuario pregunta, primero recupera el material relevante y luego un modelo de lenguaje grande lo organiza en un párrafo que responde directamente (documentación de AI 客服 de Alibaba Cloud). Para escenarios de alta frecuencia y repetición como consultas preventa, guías de funciones e información del sitio web, esta diferencia determina si el usuario sigue leyendo o cierra la página y se va a preguntar a la competencia.
Por lo tanto, lo que hay que entregar no es una ventana de chat, sino un activo de conocimiento que pueda recuperarse y sea suficientemente preciso. El estilo de la ventana es el último paso; los dos primeros determinan si realmente sirve.
El esqueleto técnico para que el servicio con IA «entienda su propio producto»: RAG
Para que un chatbot responda basándose en los materiales propios de la empresa, el enfoque predominante es la generación aumentada por recuperación (RAG). Su núcleo no es hacer que el modelo «memorice» tu producto, sino que antes de cada respuesta busque en la base de conocimiento los fragmentos relevantes y luego escriba la respuesta basándose en esos fragmentos. La documentación de RAG Studio de Cloudera describe este tipo de sistemas así: el chatbot accede a la base de conocimiento, recupera el contenido relacionado con la pregunta del usuario y luego genera una respuesta ajustada a esa pregunta (descripción de casos de uso de RAG Studio).
Una cadena mínima viable consta de cinco pasos:
- Segmentación: dividir manuales, cláusulas y páginas de producto en bloques recuperables;
- Indexación: crear un índice vectorial o de palabras clave para cada bloque;
- Recuperación: cuando el usuario pregunta, recuperar los bloques más relevantes;
- Generación: entregar el contenido recuperado junto con la pregunta del usuario al modelo para que organice la respuesta;
- Citación: indicar la fuente junto a la respuesta para que el usuario pueda hacer clic y verificarla.
El paso 5 suele pasarse por alto, pero resuelve dos problemas a la vez: la confianza del usuario y la posibilidad de rastrear después «de qué documento salió esta frase». Cuando los materiales se actualizan, el modelo no necesita reentrenarse; basta con modificar la base de conocimiento, y por eso RAG es más adecuado que el ajuste fino cuando los materiales de producto se iteran con frecuencia.
Paso uno: inventariar las fuentes de conocimiento y distinguir qué contenido debe entrar en la base de conocimiento
Antes de integrar, hay que clasificar los materiales. No todo el contenido es apto para meterse directamente, ni todo el contenido debe mostrarse públicamente.
| Fuente de conocimiento | Contenido que puede alojar | A qué prestar atención al integrar |
|---|---|---|
| Páginas del sitio web | Presentación del producto, páginas de funciones, página de precios, artículos del centro de ayuda | Se pueden rastrear automáticamente, pero hay que asegurarse de que la página en línea sea la versión más reciente |
| Documentos PDF / Word | Manuales de producto, fichas técnicas, descripción de interfaces, términos de servicio | Los escaneos deben pasar primero por reconocimiento de texto, de lo contrario no se recuperan |
| Preguntas y respuestas estándar (FAQ) | Políticas, plazos, devoluciones, facturación, procesos de posventa | Máxima prioridad de coincidencia, respuestas más controlables |
| Materiales internos | Reglas de cotización, SOP de ventas, manuales de resolución de incidencias | Implican permisos; no deben mezclarse con el conocimiento público en el mismo ámbito de búsqueda |
Un error común es subir todos los materiales sin distinción, y el resultado es que el modelo recupera tres fichas técnicas de distintas épocas y las respuestas se contradicen. Hacer primero la deduplicación y la convergencia de versiones es mucho más eficaz que ajustar los prompts.
Paso dos: crear la base de conocimiento y hacerla recuperable
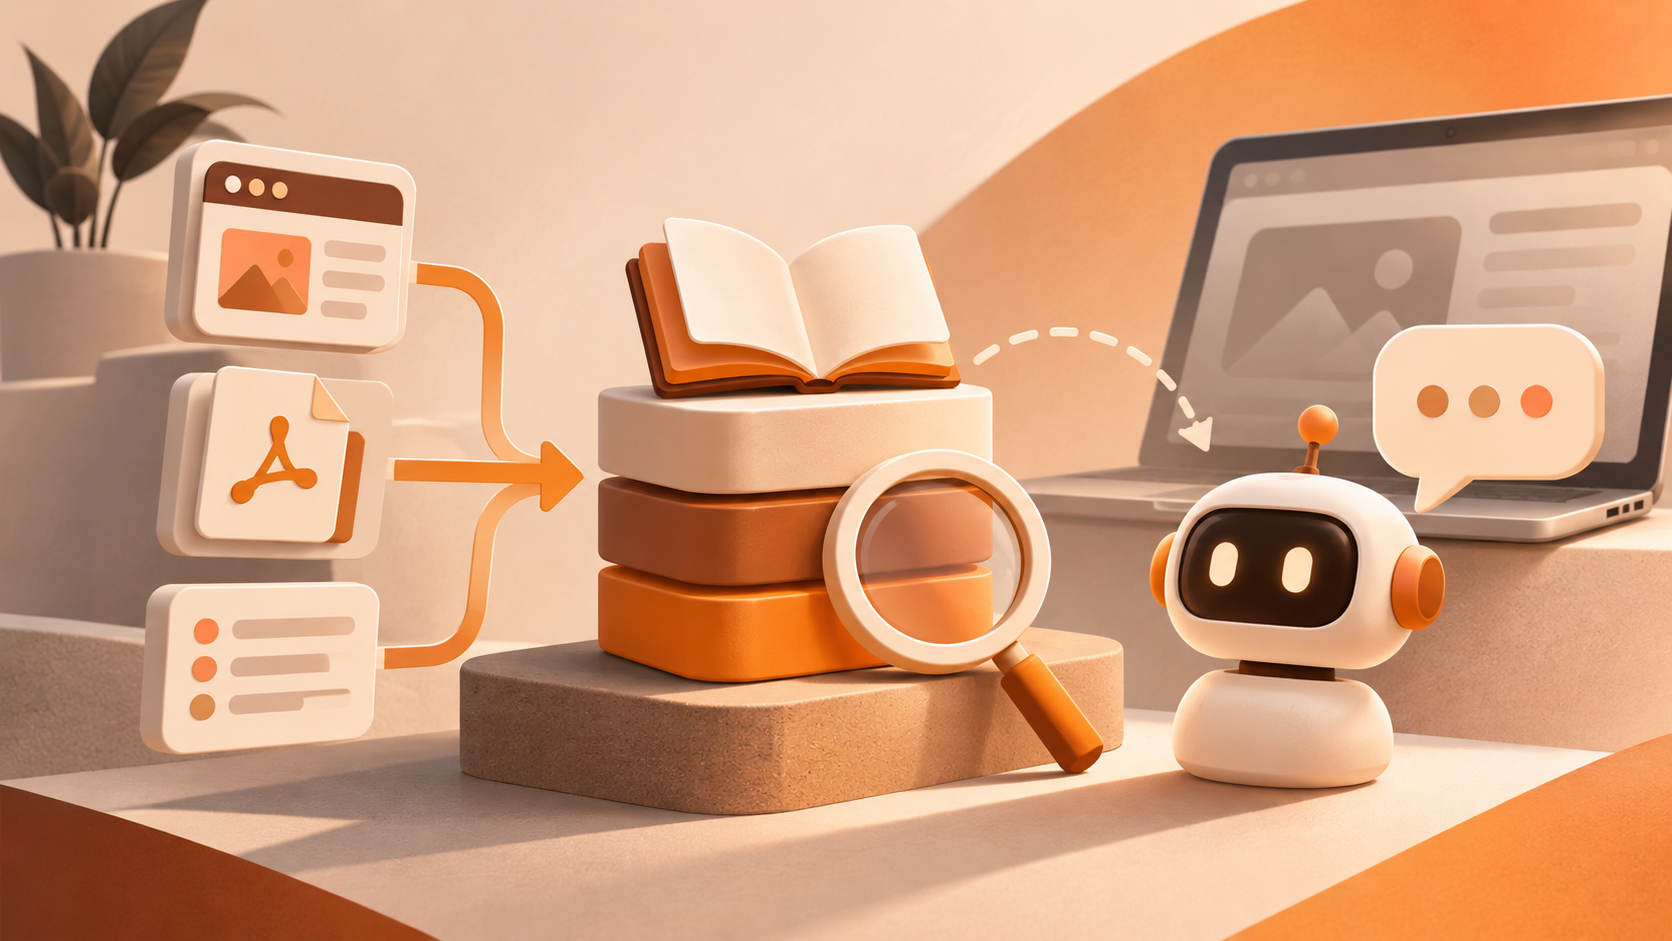
La construcción de la base de conocimiento suele adoptar tres formas: importación desde el sitio web, carga de archivos y registro de FAQ. Tomando como ejemplo la implementación de AI 客服 de Alibaba Cloud, tras activar el servicio el sistema analiza automáticamente el contenido público del sitio web como base de conocimiento inicial, y el tiempo de rastreo depende del volumen de contenido del sitio; la carga de archivos admite seis formatos: pdf, doc, docx, txt, markdown y excel; la FAQ se utiliza para registrar pares estándar de pregunta y respuesta, y cuando la pregunta del usuario coincide con varias fuentes de conocimiento a la vez, el sistema prioriza la respuesta estándar de la FAQ (documentación de AI 客服 de Alibaba Cloud).
En el plano de la ejecución, hay varias acciones que conviene fijar como proceso:
- Tras completar la importación del sitio web, revisar la lista de páginas rastreadas y eliminar las páginas de campañas caducadas y los borradores;
- Al actualizar el contenido, pulsar manualmente una vez el re-rastreo o activar la sincronización automática programada, para evitar que la base de conocimiento se quede estancada en la versión de hace tres meses;
- Redactar como FAQ los diez grupos de preguntas que más fácilmente se responden mal, y cubrir con respuestas estándar el margen de improvisación del modelo;
- Dejar un responsable para cada entrada de conocimiento; de lo contrario, medio año después nadie se atreverá a borrar el documento antiguo.
Paso tres: colocar la ventana de atención al cliente en el sitio web
Una vez que la base de conocimiento funciona, toca la configuración periférica. Campos como el color de la ventana, el nombre del servicio, la descripción del servicio y las preguntas de apertura parecen decorativos, pero en realidad afectan la calidad del primer turno de conversación: si la descripción del servicio delimita claramente sus capacidades, el usuario no preguntará cosas fuera de alcance como «escríbeme un contrato»; las preguntas de apertura ofrecen accesos de alta frecuencia y reducen notablemente el coste de duda del usuario ante su primera frase (documentación de AI 客服 de Alibaba Cloud).
Hay otra configuración que se suele pasar por alto: los datos de contacto. Cuando la IA no puede resolver el problema del usuario, la interfaz debe ofrecer teléfono, correo electrónico u otro canal alternativo; de lo contrario, tras toparse con un «no lo sé», el usuario se marcha de verdad.
Si el sitio web ya tiene un sistema de inicio de sesión, separar el conocimiento público del visible tras el inicio de sesión constituye dos ámbitos de conocimiento independientes. Para facilitar esta estratificación, el sitio subyacente debería contar con capacidades de cuenta; por ejemplo, las capacidades de sitio web de we0 incluyen un sistema de cuentas básico con verificación por correo electrónico e inicio de sesión con Google y GitHub, además de un back office CMS para la gestión de usuarios y el mantenimiento de contenido (descripción general de funciones de we0); este tipo de base ahorra el coste de montar por cuenta propia el inicio de sesión y el mantenimiento de contenido.
Cómo evitar que la IA invente información de producto inexistente
Este es el riesgo más real durante la integración: el cliente pregunta «¿admiten inicio de sesión único SAML?» y el modelo, para que la conversación continúe, probablemente dé un «sí, lo admitimos» que suena razonable.
Para reducir este tipo de errores hay que apoyarse en restricciones, no en la esperanza. Los medios disponibles, ordenados por relación coste-beneficio:
- Delimitar el ámbito de respuesta: exigir explícitamente al modelo que responda solo basándose en los fragmentos recuperados; si la recuperación está vacía, indicar directamente que la base de conocimiento no contiene ese punto.
- Ofrecer un mensaje de reserva: cuando no hay coincidencia, no quedarse en el vacío, sino sugerir al usuario que reformule la pregunta o pase a un agente humano, y mantener un botón de valoración para recoger comentarios negativos.
- Prioridad de la FAQ: redactar como preguntas y respuestas estándar los puntos que no pueden fallar, como parámetros, precios y cumplimiento normativo, para que prevalezcan sobre la formulación libre del modelo.
- Forzar la citación de fuentes: adjuntar el enlace de origen a la respuesta, para que el usuario pueda verificarla y tú puedas revisarla después.
- Muestreo previo al lanzamiento: crear un conjunto de pruebas con las preguntas históricas de los tickets reales de atención al cliente y comparar respuesta por respuesta con la documentación; no valides con preguntas del tipo «hola» o «¿dónde está su empresa?».
Una instrucción de sistema utilizable sería más o menos así:
Eres el servicio de atención al cliente de producto de este sitio web. Responde únicamente utilizando los fragmentos recuperados que aparecen a continuación.
Si los fragmentos no contienen la respuesta, responde directamente «La base de conocimiento no dispone de información al respecto» e indica al usuario que consulte los datos de contacto.
No especules sobre funciones, precios, versiones ni compromisos que no aparezcan en los fragmentos.
Al final de la respuesta, enumera en forma de lista los títulos de las páginas de origen.
¿Se puede recomendar productos según la pregunta del usuario?
Sí, pero la recomendación debe basarse en condiciones que existan realmente en los materiales. Una práctica viable es degradar la «recomendación» a «filtrado por condiciones»: extraer del relato del usuario elementos como el escenario, la escala y el modo de despliegue, mapearlos a las diferencias de versión o a la segmentación de planes que la documentación indica explícitamente, y ofrecer la página de producto correspondiente. Así, cada frase de la recomendación es rastreable; por el contrario, dejar que el modelo improvise «la solución más adecuada para ti» equivale a permitirle que haga en tu nombre compromisos comerciales sin confirmar.
El lado de los datos también ayuda. Los paneles de datos de algunos sistemas de atención al cliente agrupan las preguntas por categorías, siendo la recomendación de productos una de ellas, y además contabilizan el número de sesiones, el número de usuarios, el número de preguntas respondidas y la tasa de resolución (número de preguntas respondidas ÷ total de preguntas × 100 %) (documentación de AI 客服 de Alibaba Cloud). Si la tasa de resolución de las preguntas de recomendación es baja de forma sostenida, normalmente no es que el modelo no sirva, sino que a la página de producto le faltan los datos necesarios para decidir: dimensiones de comparación, rangos de precio, escenarios aplicables y no aplicables.
Cómo derivar los casos complejos a un agente humano
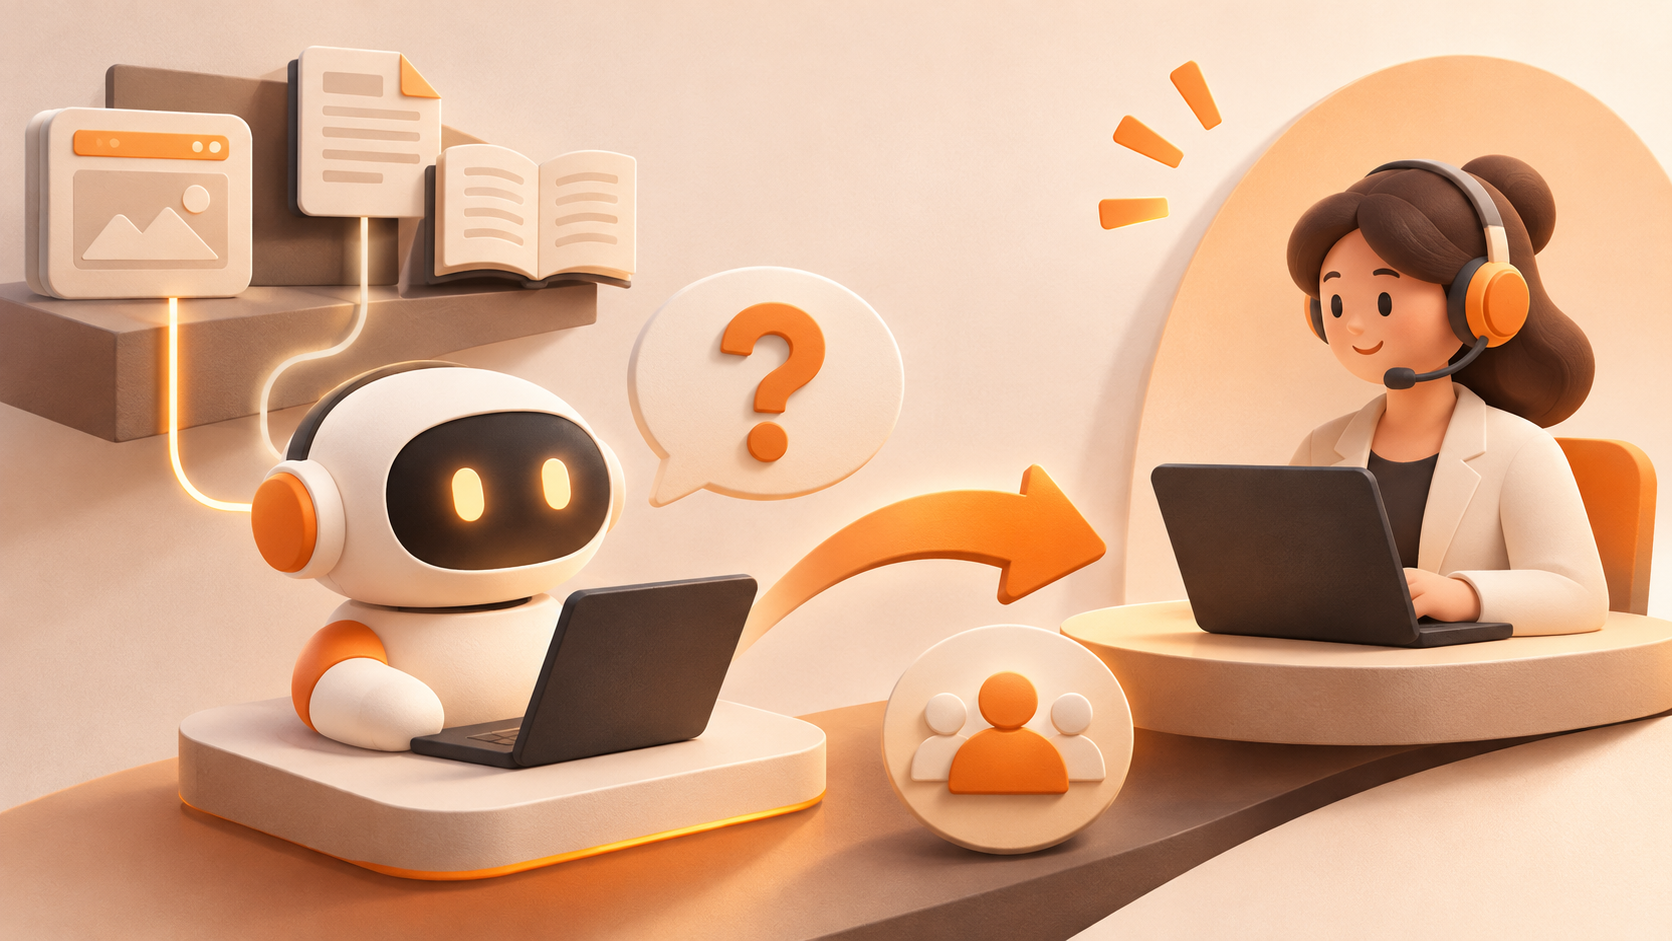
El valor del servicio con IA no es bloquear a las personas, sino absorber las preguntas simples y entregar las complejas con su contexto. Conviene redactar como lista las condiciones que activan la derivación a un humano, para evitar el «depende»:
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
- El tema coincide con palabras clave de alto valor o alto riesgo: cotizaciones, cláusulas contractuales, desarrollo a medida, incidencias y seguridad de datos, reclamaciones;
- Dos turnos consecutivos sin resolver, o el usuario solicita expresamente un agente humano;
- El tono del usuario es claramente negativo y aparecen muestras explícitas de insatisfacción;
- La coincidencia en la base de conocimiento está vacía y la pregunta implica asuntos que requieren consultar el back office, como cuentas o pedidos.
Al transferir, hay que pasar al agente humano el resumen de la conversación, las fuentes recuperadas y la página en la que se encuentra el usuario, para que el cliente no tenga que repetirlo todo desde el principio. Este paso no es técnicamente difícil, pero es el eslabón donde la diferencia de experiencia es mayor: muchas empresas implementan un servicio con IA pero convierten la derivación a humano en un «por favor, vuelva a describir su problema».
Registrar las conversaciones y convertirlas en base para actualizar la base de conocimiento
Las conversaciones de atención al cliente son la investigación de necesidades más barata. El sistema suele conservar el historial de sesiones, que incluye la pregunta del usuario, la respuesta de la IA y la fuente de conocimiento en la que se basó esa respuesta, y permite filtrar por estado (por ejemplo, respondida o parcialmente respondida) (documentación de AI 客服 de Alibaba Cloud). Dedicar veinte minutos a la semana a revisar estos datos permite obtener tres tipos de señales:
- Preguntas que se repiten y se responden mal: faltan entradas en la base de conocimiento; añadir FAQ;
- Preguntas respondidas de forma vaga: la documentación está escrita de forma abstracta; hay que añadir parámetros concretos o ejemplos;
- Preguntas que el cliente plantea por iniciativa propia y para las que no estabas preparado: señales de demanda preventa que merecen trasladarse a producto y marketing.
Algunos sistemas ofrecen un acceso de «optimización de preguntas» que convierte con un clic las preguntas no resueltas en nuevas entradas de FAQ; solo hay que añadir la respuesta estándar. Si se incorpora al proceso de la reunión semanal, la base de conocimiento crece por sí sola.
Después del lanzamiento: ritmo de actualización de la base de conocimiento y responsables
Que un servicio con IA empiece a responder mal tres meses después del lanzamiento se debe casi siempre a que nadie gestiona la base de conocimiento. Conviene mantenerla con un ritmo fijo:
- Semanalmente: revisar la lista de preguntas no resueltas y añadir de 3 a 5 FAQ;
- Mensualmente: verificar la coherencia entre la página de precios, la página de planes y la documentación, y retirar el contenido de campañas caducadas;
- En cada lanzamiento: actualizar el mismo día la documentación de funciones y el registro de cambios, para que la IA no se convierta en portavoz de la versión antigua;
- Trimestralmente: muestrear 30 conversaciones reales, volver a ejecutar el conjunto de pruebas y registrar la evolución de la tasa de resolución.
El responsable no tiene por qué ser el supervisor de atención al cliente, pero debe ser una persona, no «el equipo». La gestión compartida entre varias personas equivale a que nadie se responsabilice.
Ejemplo de cadena completa para una empresa SaaS
Supongamos que una empresa SaaS de paneles de datos acaba de lanzar su nuevo sitio web; el producto tiene tres modalidades: versión gratuita, versión de equipo y despliegue privado, y la documentación está dispersa entre el centro de ayuda y manuales en PDF.
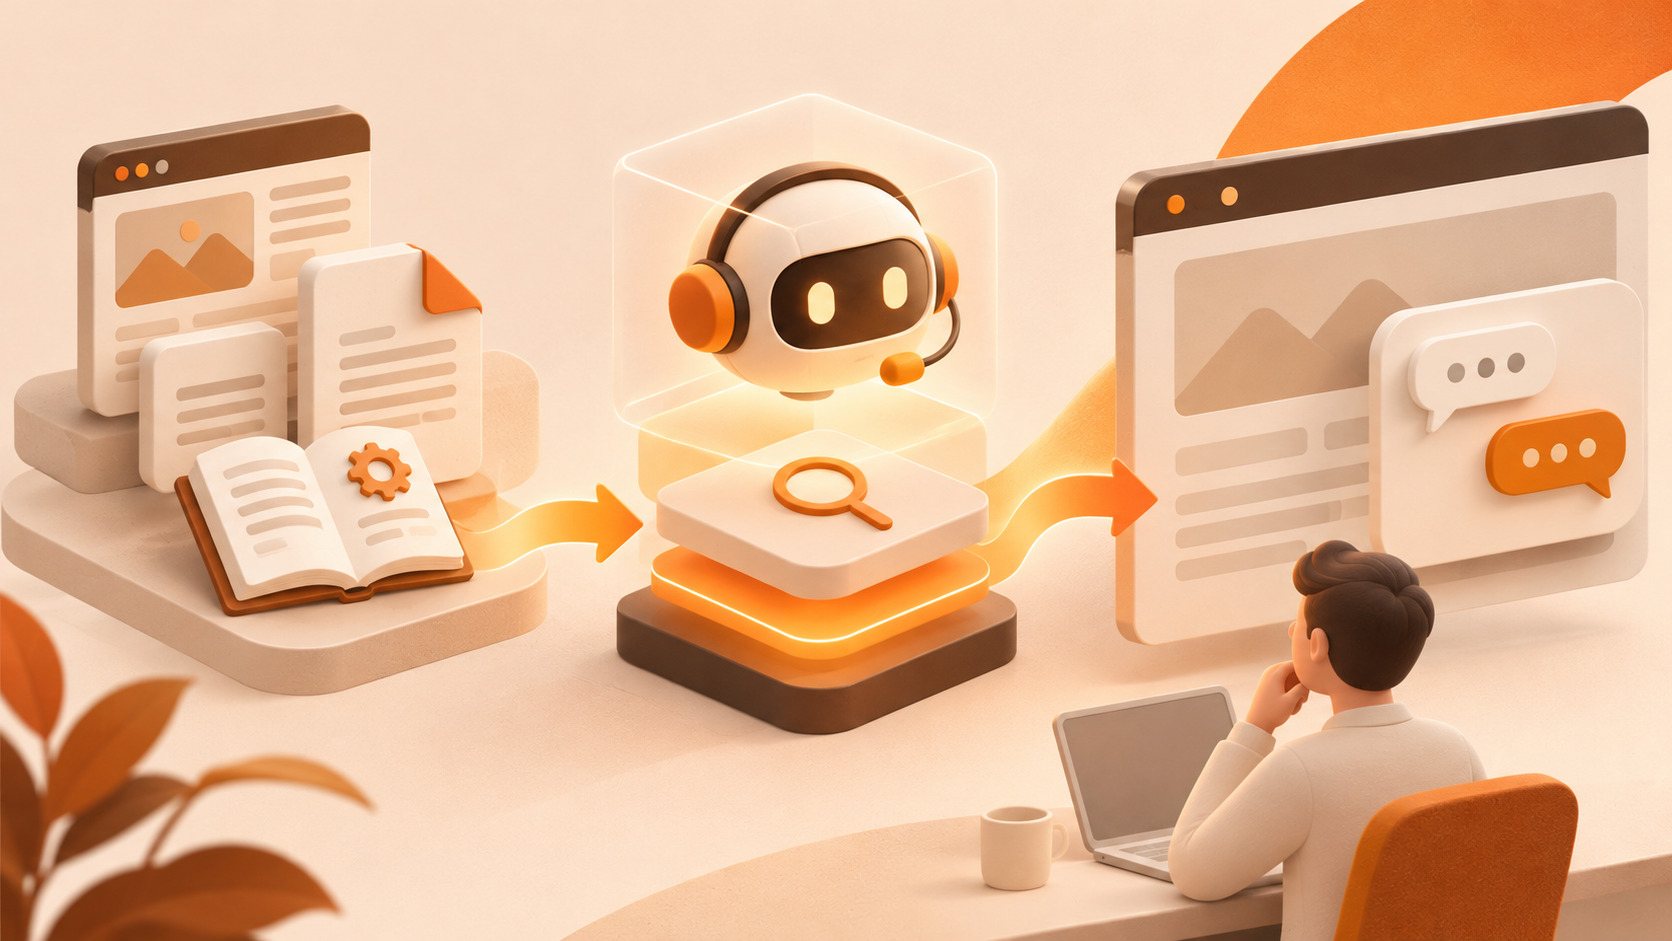
- El usuario pregunta: un visitante escribe en la ventana de la esquina inferior derecha de la página de precios: «Somos un equipo de análisis de 80 personas, los datos no pueden salir de la intranet, ¿cómo cobran?»
- Recuperación: el sistema recupera el contenido relevante del centro de ayuda, la descripción del despliegue privado y el manual de precios en PDF.
- Organización de la respuesta: primero responde si la modalidad de despliegue cumple con «los datos no salen de la intranet», luego explica las dimensiones de cálculo del plan privado, con un tono contenido y sin comprometer importes concretos.
- Ofrecer páginas relacionadas: adjunta la página de descripción del despliegue privado y el acceso para contactar con ventas.
- Derivación a humano cuando no se puede resolver: el usuario pregunta por las cláusulas del contrato y el ciclo de implementación, coincide con palabras clave de alto riesgo y se deriva directamente a un agente humano adjuntando el resumen de la conversación.
- Sedimentación: esta pregunta entra en la lista de no resueltas y el equipo de operaciones añade una FAQ sobre «cómo se calcula el precio del despliegue privado».
En toda la cadena, la IA no «adivina»; cada paso se puede rastrear hasta un documento.
Qué puede asumir we0 en esta cadena y qué hay que construir por cuenta propia
Si el sitio web de la empresa todavía está en fase de construcción, planificar juntas las capacidades de atención al cliente resulta más cómodo. we0 se posiciona como un conjunto de capacidades de sitio web orientadas a la entrega formal; su lista oficial de capacidades incluye la integración de capacidades de IA (generación de texto, imagen, vídeo y audio, adecuadas para ampliarse a productos conversacionales), CMS y back office de gestión, sistema de autenticación, organización multilingüe y publicación en línea, y entre sus escenarios de aplicación menciona explícitamente aplicaciones de atención al cliente inteligente y de base de conocimiento (descripción general de funciones de we0).
Hay que dejar claro el límite: estas son capacidades base de creación de sitios web e integración de IA, no equivalen a un servicio de atención al cliente con base de conocimiento listo para usar. La segmentación e indexación de documentos, la estrategia de recuperación, el filtrado del conocimiento según los permisos del usuario, la transferencia a agentes humanos y la integración con tickets suelen requerir desarrollo propio sobre su capacidad de generación de código full-stack, o la integración de sistemas externos de RAG y de atención al cliente. Al evaluar, conviene tratar «poder generar un sitio web» y «poder operar un servicio de atención al cliente con base de conocimiento» como dos cosas distintas, para evitar descubrir a mitad de camino que falta medio eslabón.
Cumplimiento y límites de contenido: qué materiales no se pueden rastrear
Cuanto más amplias sean las fuentes de conocimiento, más atención hay que prestar a cómo entra el contenido. Importa únicamente contenido propio público y rastreable, y materiales debidamente autorizados; no obtengas contenido de terceros eludiendo muros de pago, restricciones de inicio de sesión o mecanismos anti-scraping. Un dictamen de un abogado general del Tribunal de Justicia de la Unión Europea ofrece una referencia en este sentido: cuando un chatbot recupera y reutiliza en tiempo real contenido de medios periodísticos en sus respuestas, puede constituir una vulneración de los derechos del editor si el contenido se obtuvo ilícitamente o si la formulación de la respuesta puede sustituir prácticamente el texto original; en cambio, el riesgo es notablemente menor cuando se hace un resumen fáctico con palabras propias y se enlaza al texto original (análisis del caso).
Para el servicio de atención al cliente de un sitio web corporativo, el principio se traduce de forma sencilla: en la base de conocimiento se colocan materiales propios y contenido autorizado, las respuestas se basan en resúmenes y fuentes, y no se reproduce literalmente el contenido de terceros.
Preguntas frecuentes
¿Puede el servicio con IA leer directamente PDF y Word?
Sí. Tomando como ejemplo las plataformas habituales de creación de sitios web y atención al cliente, la carga de archivos admite formatos como pdf, doc, docx, txt, markdown y excel; tras la carga se produce un proceso de análisis y, una vez completado correctamente, el contenido pasa a formar parte de la recuperación (documentación de AI 客服 de Alibaba Cloud). Los PDF escaneados deben convertirse previamente en texto recuperable.
Los precios de la base de conocimiento cambian con frecuencia, ¿cómo garantizar respuestas correctas?
La información de cambio frecuente, como precios y planes, debe convertirse por separado en respuestas estándar de FAQ y asignarse una revisión mensual; no disperses los precios en varios PDF, porque el modelo recuperará versiones distintas.
¿El servicio con IA filtrará materiales internos a los clientes?
Depende de cómo se delimite el ámbito del conocimiento. El conocimiento público y los materiales internos deben estar en conjuntos de conocimiento distintos, y los materiales internos solo deben abrirse a determinados roles con sesión iniciada, en lugar de confiar en un prompt que pida al modelo «no decirlo».
¿Conviene adjuntar enlaces de origen en las respuestas?
Se recomienda adjuntarlos. Aumentan la credibilidad y te permiten confirmar en la revisión sobre qué versión de la documentación se basa la respuesta.
¿Cuánto se tarda en lanzarlo?
El tiempo se dedica principalmente a organizar los materiales y al muestreo del conjunto de pruebas, no a la integración técnica. Es más realista lanzar primero una versión con un 70 % de cobertura y añadir FAQ semanalmente que buscar una cobertura total de una vez.
Herramientas relacionadas
- Base de conocimiento y consola de atención al cliente: gestiona la importación desde el sitio web, la carga de archivos, la FAQ y la optimización de preguntas
- CMS y back office de contenido: mantiene las versiones del centro de ayuda, la documentación de producto y la página de precios
- Herramientas de analítica del sitio: observar los clics y la ruta de conversión del acceso al chat
- Sistema de tickets / IM: recibe las conversaciones derivadas de la IA y los resúmenes de conversación
- Servicios de RAG y recuperación vectorial: para usar al construir la capa de recuperación propia
Enlaces relacionados
- documentación de AI 客服 de Alibaba Cloud
- descripción de casos de uso de RAG Studio de Cloudera
- descripción general de funciones de we0
- análisis del caso sobre chatbots de IA y derechos de autor de prensa
Resumen
Integrar un servicio de atención al cliente con IA en el sitio web de una empresa: el verdadero trabajo de ingeniería no está en la ventana de chat, sino en la base de conocimiento. Primero hay que inventariar los materiales de producto en tres categorías (páginas web, documentos y FAQ) y converger las versiones; luego construir con RAG la cadena «recuperación—generación—citación»; y colocar la ventana no es más que el último paso. Después del lanzamiento, el riesgo de invención se contiene delimitando el ámbito de respuesta, dando prioridad a la FAQ, forzando la citación de fuentes y muestreando el conjunto de pruebas; los casos complejos se protegen con la lista de derivación a humano, y la lista semanal de no resueltas permite que la base de conocimiento siga creciendo. Si estas tareas se convierten en un ritmo fijo con responsables, el servicio con IA reducirá de verdad las consultas repetidas, en lugar de expresar con más fluidez respuestas incorrectas.