curl -sL https://www.example.com/ | grep -o '[^'
curl -sL https://www.example.com/ | head -c 1200
Si la respuesta solo contiene `
` y un montón de etiquetas script, sin nombres de empresa, productos ni párrafos legibles, eso es exactamente el cascarón vacío que recibe el rastreador en su primera visita. La documentación de Google sobre SEO para JavaScript explica la relación entre rastreo y renderizado: el contenido de los scripts no es totalmente invisible, pero el renderizado requiere una cola de rastreo y recursos adicionales; cuanto más dependen el contenido y los enlaces de los scripts, mayor es la incertidumbre de que se lean correctamente (ver [Fundamentos de SEO para JavaScript de Google](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)).
**Cómo corregirlo**: haz que el contenido clave esté en el HTML inicial —renderizado del lado del servidor, generación estática o, como mínimo, salida de títulos, texto principal y enlaces internos como etiquetas reales. El criterio es simple: con JavaScript desactivado en el navegador, la página debe seguir siendo legible.
## Revisión 2: ¿Están bien escritos el Title y la Meta Description?

Lo que más suele faltar en las páginas generadas por IA son los metadatos, porque son completamente invisibles en lo visual. Tres errores frecuentes:
- **El mismo Title en todo el sitio**: la variable de plantilla no se reemplazó y todas las páginas son “Inicio | Tal Tecnología”.
- **Description vacía**: Google tiene que extraer el texto principal por su cuenta, y el resumen suele quedar sin información útil.
- **Title demasiado largo**: en títulos en chino, superar unos 30 caracteres puede truncarse en móvil y cortar el argumento de venta.
```html
Creación de sitios corporativos: proceso completo desde los requisitos hasta la publicación | Nombre de marca
Autoevaluación: toma 5 páginas clave (inicio, producto, precios, casos, blog) y confirma que cada Title es distinto e incluye la palabra temática de esa página; que la Description es una frase completa y no una acumulación de palabras clave.
Revisión 3: ¿Son realmente utilizables sitemap.xml y robots.txt?
Estos dos archivos son la puerta de entrada de los rastreadores al sitio y también los dos que más se pasan por alto en la creación de sitios con IA, porque no existen en la interfaz.
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
Verifica tres cosas: el dominio del sitemap debe ser el dominio oficial, no el de previsualización; las rutas bloqueadas con Disallow no deben aparecer al mismo tiempo en el sitemap; la línea Sitemap: debe ser una dirección absoluta.
También hay que entender los límites de robots.txt. En su guía de indexación, Google recuerda que robots.txt controla el rastreo, no es un método fiable para impedir la indexación: una URL bloqueada por robots.txt aún puede aparecer en los resultados de búsqueda debido a enlaces externos; cuando se necesita que una página no entre en el índice de forma explícita, debe usarse noindex (etiqueta meta robots o cabecera de respuesta X-Robots-Tag). En una actualización de documentación de octubre de 2026, Google también añadió una sección sobre “indexar solo contenido orientado a búsqueda”, y recomienda establecer por defecto como no indexadas las páginas generadas que solo se usan para compartir, colaborar o producir resultados de herramientas, además de monitorear anomalías de indexación con los informes de indexación de páginas y de rendimiento de búsqueda de Search Console (para más detalle, ver Interpretación de la actualización de la guía de indexación de Google).
Revisión 4: ¿El canonical apunta a esta página?
rel=canonical le dice al motor de búsqueda “cuál es la versión principal dentro de este grupo de URLs similares”. En la generación con IA aparecen tres errores:
- Todas las páginas apuntan a la página de inicio, lo que equivale a decirle a Google que cada página es una copia de la de inicio.
- Apunta al dominio de previsualización o de pruebas, y la página oficial queda tratada como copia.
- Las direcciones con parámetros y las direcciones limpias se apuntan entre sí, y las señales se contradicen.
-
La forma correcta es: usar una dirección absoluta, https y exactamente igual a la URL final que quieres que se indexe (con o sin barra final debe ser uniforme en todo el sitio); en sitios multilingües, cada versión de idioma debe apuntar a sí misma y establecer la correspondencia con hreflang, en lugar de canonicalizar todas hacia la versión en inglés.
Revisión 5: ¿Los datos estructurados contienen información incorrecta?

La IA es muy buena “completando” datos estructurados y también muy buena inventando sin querer: valoraciones que no existen, rangos de precio que no hay, años de fundación ficticios. Todo esto viola el requisito básico de los datos estructurados: los datos deben coincidir con el contenido visible de la página.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Nombre de marca",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
El principio es mejor poco que de más: escribe solo los campos que se ven en la página; elimina cualquier fecha de fundación, valoración o estado de inventario que no sea seguro; antes de publicar, pásalo por una herramienta de prueba de datos estructurados y confirma que no hay errores de análisis.
Revisión 6: ¿Los formularios, ventanas modales e interacciones bloquean a los rastreadores?
Los formularios en sí no afectan la indexación; el problema es que a menudo “sustituyen” el texto principal: la página entera solo tiene un formulario de captación de leads, el contenido está bloqueado tras el inicio de sesión, o en la primera pantalla aparece una ventana modal a pantalla completa que exige aceptar cookies primero. Para un rastreador, esas páginas carecen de texto que permita coincidir con la intención de búsqueda.
Además, la creación de sitios con IA suele generar muchas páginas “de usar y tirar”: páginas de éxito tras enviar un formulario, páginas de resultados de cotización, enlaces para compartir. Si estas páginas se indexan, diluyen la calidad del sitio. Según la recomendación de Google, es más seguro establecerlas por defecto como noindex (interpretación de la guía de indexación); las páginas de aterrizaje realmente orientadas a búsqueda deben conservar el texto HTML completo y visible, en lugar de depender de un clic para desplegarse.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Revisión 7: la próxima vez que modifiques la página con IA, ¿se revertirán las configuraciones SEO?
Este es el riesgo más subestimado de la creación de sitios con IA: las páginas se generan de forma continua; el Title, canonical y las reglas de robots que corregiste manualmente hoy pueden ser sobrescritos mañana por una regeneración del tipo “ayúdame a cambiar los colores y, de paso, optimiza los textos”.
La solución viable es imponer restricciones de proceso, no confiar en la memoria:
- Centraliza las configuraciones relacionadas con SEO en plantillas o en la configuración global, para reducir la escritura manual página por página.
- Después de cada regeneración, ejecuta la lista de verificación, cubriendo al menos inicio, página de producto y página de precios.
- Vigila el crecimiento anómalo del número de URLs: los cambios de plantilla o el lanzamiento de nuevas funciones suelen generar URLs en lote; Google recomienda monitorear al mismo tiempo los cambios en la creación de contenido y en el volumen de indexación del lado de la plataforma (igual que antes).
- Antes de publicar, haz una “comparación de configuración” fija: compara Title, canonical, robots y sitemap con la versión publicada anteriormente.
Revisión 8: ¿Por qué vale la pena invertir en esto?
El SEO técnico no es un tema de nicho. Según datos de Mordor Intelligence, el mercado de servicios de SEO técnico fue de 1573 millones de dólares en 2025 y se espera que crezca de 1689 millones en 2026 a 2837 millones en 2031, con una tasa compuesta anual de aproximadamente 10,93 % entre 2026 y 2031; la categoría de SEO técnico representó el 32,41 % en 2025, precisamente porque el renderizado, la estructura del sitio, las redirecciones, los datos estructurados y el rendimiento de página determinan directamente si el contenido puede descubrirse y recuperarse a gran escala; el informe también señala que Google sigue incluyendo Core Web Vitals en la evaluación de búsqueda (datos en Informe de mercado de Technical SEO Services). En otras palabras, publicar la página es solo el comienzo; que pueda rastrearse, entenderse y citarse es la entrada al mundo de la búsqueda y de la búsqueda con IA.
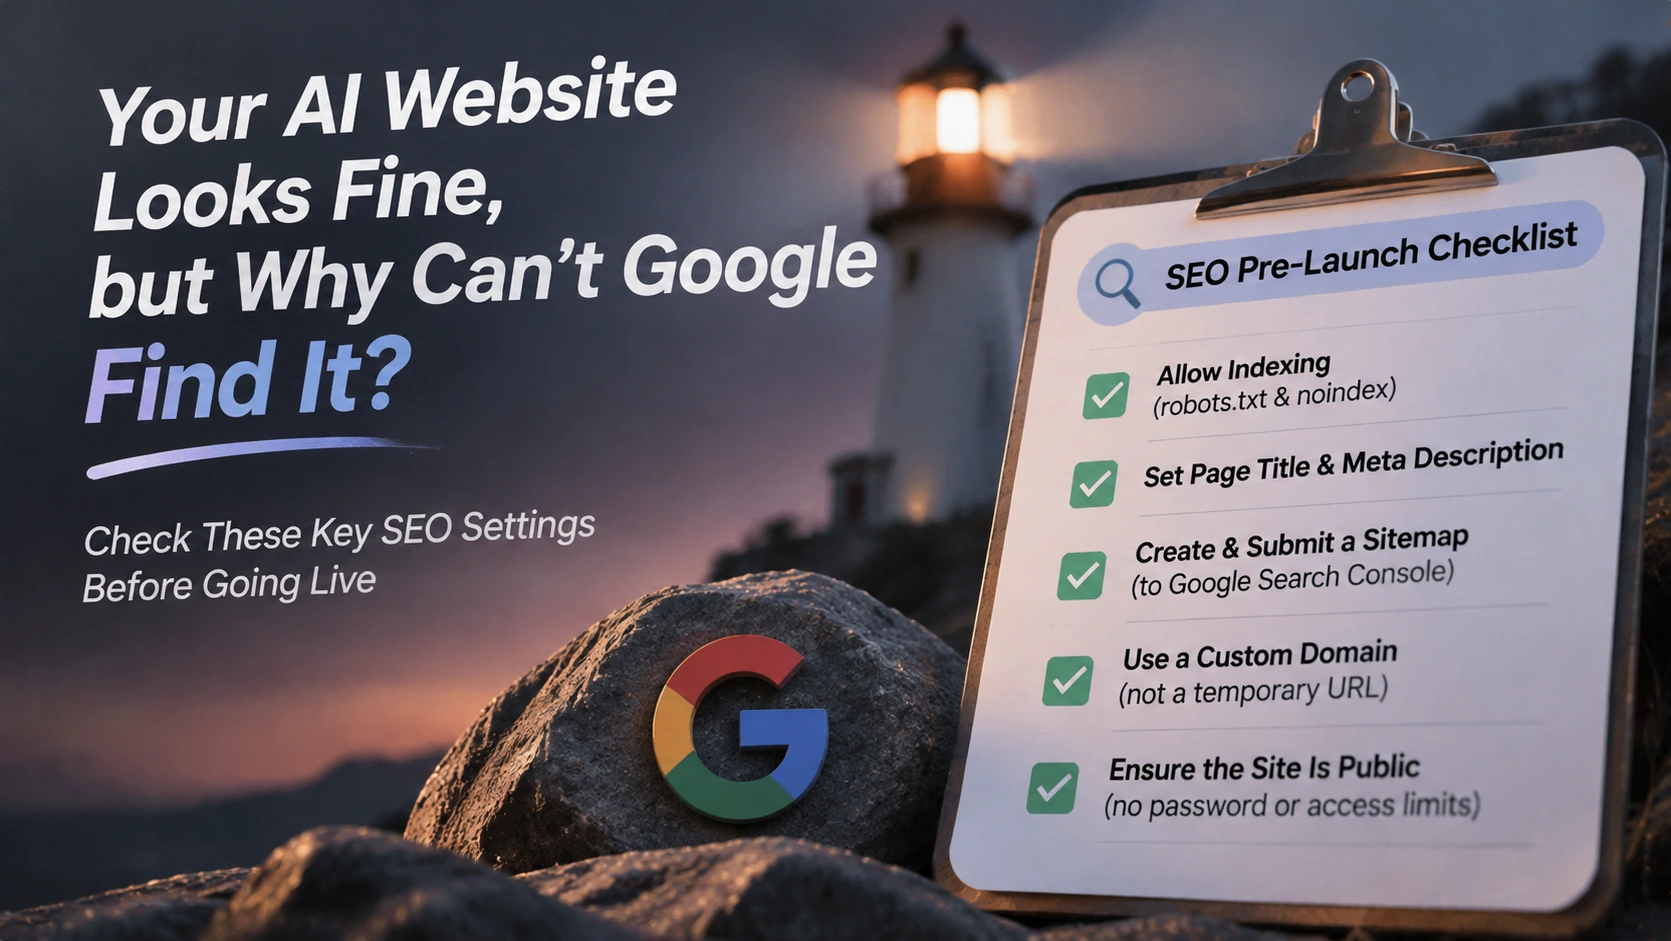
Lista de verificación SEO de 10 puntos antes de publicar un sitio creado con IA
| # | Punto de verificación | Criterio de aprobación |
|---|---|---|
| 1 | HTML inicial | Con JS desactivado, todavía se ven el título y el texto principal |
| 2 | Estado HTTP | Las páginas principales devuelven 200; las direcciones antiguas redirigen con 301 a las nuevas |
| 3 | Title | Único por página, contiene la palabra temática y tiene una longitud controlada |
| 4 | Meta Description | Independiente por página y es una frase completa |
| 5 | robots.txt | Solo bloquea rutas de administración y previsualización; el Sitemap usa una dirección absoluta |
| 6 | sitemap.xml | Solo contiene el dominio oficial y páginas indexables |
| 7 | canonical | Apunta a la URL oficial de la propia página; la regla de barra final es uniforme en todo el sitio |
| 8 | noindex | El sitio de previsualización, las páginas de resultados y las páginas para compartir no se indexan por defecto |
| 9 | Datos estructurados | Solo se escriben campos visibles en la página y no hay errores de análisis |
| 10 | Interacciones y formularios | El texto principal no queda ocupado por ventanas modales, muros de inicio de sesión o formularios |
El valor de esta tabla no está en “trucos avanzados”, sino en que se puede repetir: ejecútala antes de cada publicación; en diez minutos se evitan la mayoría de los casos de “está hecho pero no se encuentra”.
Qué deberían hacer las empresas ahora
Si estás creando un sitio con herramientas de IA, puedes cambiar el orden: primero genera la estructura y el contenido, luego añade metadatos y reglas de indexación, y por último haz una verificación previa a la publicación de forma unificada. Plataformas de creación de sitios con IA como We0 ya integran la generación de páginas, el CMS de backend, el despliegue de dominios y la configuración de SEO/GEO en la misma cadena (puedes consultar el sitio web de We0); la velocidad de generación no cambia una premisa: los motores de búsqueda solo reconocen lo que realmente se emite en el HTML, así que la prueba real después de publicar sigue siendo imprescindible.
Se recomiendan tres acciones concretas: primero usa curl para ver el HTML inicial; después confirma el estado de rastreo e indexación en Search Console; por último, convierte los 10 puntos anteriores en un paso fijo antes de publicar y documéntalo en el proceso de lanzamiento del equipo.
Preguntas frecuentes
P: ¿Los sitios generados por IA incumplen por naturaleza los requisitos SEO?
No. La generación con IA es solo la forma de producir; el problema es que el proceso de generación se centra por defecto en “si la página se ve bien” y no comprueba “qué lee el motor de búsqueda”. Siempre que el HTML inicial contenga el texto principal y los metadatos y las reglas de indexación sean correctos, no hay una diferencia esencial en el rendimiento de búsqueda entre un sitio creado con IA y uno hecho a mano.
P: Si una página no aparece en Google, ¿significa que fue penalizada?
En la mayoría de los casos ni siquiera se ha llegado a la “penalización”, sino que aún no se ha rastreado o indexado. Primero revisa el estado de indexación; después, si robots.txt o noindex la están bloqueando; solo entonces pasa a la calidad del contenido y la competencia.
P: ¿Enviar solo el sitemap garantiza la indexación?
No. El sitemap es una pista para el descubrimiento, no una promesa de indexación; puede hacer que los rastreadores sepan más rápido qué páginas tienes, pero que una página se indexe depende del acceso de rastreo, la calidad del contenido y las reglas de indexación.
P: ¿Google no puede leer de ninguna manera una página renderizada con JavaScript?
No necesariamente, pero la incertidumbre es mayor. El renderizado requiere recursos adicionales y, cuanto más depende la página de los scripts, menor es la probabilidad de que el texto y los enlaces de la primera pantalla se lean correctamente. Poner el contenido principal en el HTML inicial es el seguro de menor coste.
P: ¿Cuánto tiempo se tarda en ver resultados?
No hay un calendario único para la indexación y el ranking; depende de la frecuencia de rastreo, el tamaño del sitio y la competencia. Lo que sí es seguro es que un error de configuración seguirá activo hasta que lo descubras y lo corrijas.
Herramientas relacionadas
- Google Search Console: consultar el informe de indexación de páginas y el rendimiento de búsqueda
- Documentación de SEO para JavaScript de Google: confirmar las reglas reales de renderizado y rastreo
curl/ herramientas de desarrollo del navegador: verificar el HTML inicial y la legibilidad con JS desactivado- Herramienta de prueba de datos estructurados: validar si el JSON-LD se puede analizar
Enlaces relacionados
- Fundamentos de SEO para JavaScript de Google
- Interpretación de la actualización de la guía de indexación de Google: páginas compartibles y contenido generado
- Informe de tamaño y tendencias del mercado de Technical SEO Services
- Sitio web de We0
Resumen
La creación de sitios con IA acelera la publicación, pero no cambia cómo funcionan los motores de búsqueda: leen HTML, cabeceras de respuesta y estructura de enlaces, no la maqueta que ves en pantalla. Antes de publicar, revisa estos siete puntos —HTML inicial, Title y Description, robots.txt y sitemap, canonical, noindex, datos estructurados, formularios e interacciones— y luego conviértelos en un proceso. Así, “el sitio está listo pero no tiene tráfico” deja de ser algo normal y pasa a ser un problema diagnosticable.