For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/anthropic-s-2021-roadmap-coding-agents-to-438c8006.md.
Una breve hoja de ruta de investigación de Anthropic de julio de 2021 describe un asistente que podría conversar con personas mientras crea,...
Una breve hoja de ruta de investigación de Anthropic de julio de 2021 describe un asistente que podría conversar con personas mientras crea, edita y explica software. Leída hoy, permite reconocer preguntas que todavía dan forma a los agentes de programación: cómo explorar un repositorio, utilizar herramientas, aprender de la retroalimentación y actuar de forma segura en un entorno real.
El documento escaneado enlazado públicamente resulta interesante por esas conexiones, no porque demuestre que una versión terminada de Claude Code existía cinco años antes. Registra objetivos de investigación y desacuerdos. Ese es un tipo de evidencia distinto de un producto lanzado, un experimento concluido o una declaración sobre la arquitectura actual de los modelos.
El objetivo a largo plazo del documento es una AGI segura y beneficiosa. Su prueba de concepto propuesta es un asistente general que pueda trabajar con un usuario en software mediante lenguaje natural.
Las tareas descritas van más allá de completar los siguientes caracteres de código. Incluyen responder preguntas, escribir funciones, localizar errores, diseñar API y hablar sobre estilo y buenas prácticas. El estado final ambicioso es la amplitud de un colega de ingeniería de software.
La redacción también reconoce que el equipo no esperaba alcanzar ese objetivo de inmediato. Presenta una dirección para la investigación, por lo que el documento no debería describirse retrospectivamente como un plan de lanzamiento de Claude Code en 2021 en el que todas las funciones actuales ya estuvieran definidas.
La documentación actual de Claude Code permite comparar la aspiración general con un producto real. La continuidad temática es clara; el documento por sí solo no establece un historial ininterrumpido de implementación para cada función.
Los comentarios revelan una tensión práctica entre construir algo útil de inmediato y demostrar una capacidad más general.
Tom Brown propone la exploración de repositorios como un punto de partida valioso. Nelson Elhage ofrece un ejemplo concreto: encontrar definiciones de tipos en un proyecto. Son necesidades habituales de los desarrolladores, especialmente al incorporarse a una base de código desconocida.
Andy Jones contrapone ese enfoque con una demostración que enfatiza la depuración con printf y el uso del editor. La búsqueda en repositorios podría ser una sólida primera función para un asistente de programación, mientras que esas otras acciones podrían aportar una demostración más convincente de que un modelo puede utilizar herramientas.
La respuesta de Dario Amodei prioriza la demostración de uso de herramientas a corto plazo y al programador altamente capaz a largo plazo. Ese intercambio resulta útil porque muestra que la secuenciación era una elección explícita. Un hito temprano de investigación puede ser valioso aunque todavía no sea el producto completo más útil.
La sección de preentrenamiento aboga por modelos sólidos de lenguaje y código, conjuntos de datos orientados al código y evaluaciones que conecten las capacidades con el ajuste fino posterior. También analiza la ciencia de entrenar modelos de tamaño arbitrariamente grande, incluidos los de 1T y superiores.
Ese es un objetivo de investigación declarado. No constituye una revelación de que algún modelo Claude actual tenga un billón de parámetros, ni prueba que el equipo ya hubiera entrenado un modelo de ese tamaño en 2021.
La misma sección considera contextos muy grandes o una forma equivalente de incorporar una memoria y experiencia sustanciales. Esto deja abiertos varios mecanismos posibles, en lugar de prescribir un diseño concreto de ventana de contexto actual.
| Elemento de la hoja de ruta | Lo que respalda | Lo que no establece |
|---|---|---|
| Un asistente general de software | La colaboración en software era un objetivo temprano de investigación. | Una versión terminada de Claude Code en 2021. |
| Modelos de 1T parámetros y superiores | La escala muy grande formaba parte de la agenda de investigación. | El número de parámetros de una versión actual de Claude. |
| Contextos grandes o memoria equivalente | El equipo consideraba experiencia y memoria ampliadas. | Una arquitectura fija o el límite exacto de tokens actual. |
| Uso de herramientas mediante búsqueda, depuración y edición | La agenda incluía actuar en entornos de software. | Operación autónoma fiable e irrestricta. |
La sección sobre retroalimentación humana y alineación incluye el estudio de cómo los juicios de los modelos se corresponden con los juicios humanos sobre el comportamiento y la calidad de las muestras. Menciona explícitamente la autoevaluación y conecta la cuestión con el sesgo, la equidad y las consecuencias sociales.
Esta es una formulación temprana significativa de emplear las propias evaluaciones de un modelo como objeto de investigación. No demuestra que dichos juicios sean automáticamente fiables ni que un modelo pueda certificar con seguridad su propia salida.
El documento también menciona el cómputo en tiempo de prueba en una discusión sobre el entrenamiento de GAN o discriminadores y las leyes de escalamiento. Muestra que el equipo pensaba en la computación más allá del preentrenamiento. No debería equipararse sin matices a todas las técnicas posteriores de modelos de razonamiento ni considerarse una prueba de que ya se había especificado un sistema moderno de escalamiento en tiempo de inferencia.
La distinción fortalece la comparación histórica. El documento expone preguntas de investigación relacionadas sin exigir al lector que suponga que un vocabulario similar implica métodos idénticos a lo largo de cinco años.
Uno de los comentarios más directamente relevantes pregunta cómo desplegar de forma segura herramientas que no están aisladas en un entorno sandbox. Amodei aclara la preocupación específica: herramientas que ejecutan código en el momento del despliegue.
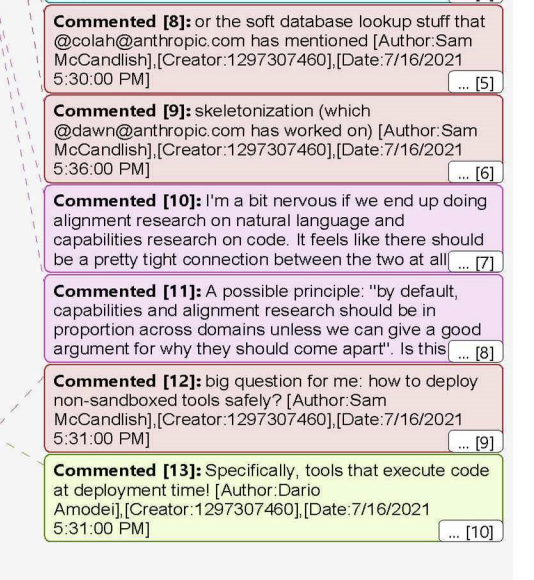
Fuente: el documento escaneado de la hoja de ruta de julio de 2021, reproducido por QbitAI en BAAI Hub. Los comentarios correspondientes son visibles en el PDF enlazado, incluidas sus páginas de comentarios ampliados.
Esta preocupación sigue siendo comprensible en un contexto de agentes. Un sistema que puede ejecutar comandos o editar archivos puede modificar su entorno, por lo que el comportamiento seguro no puede juzgarse únicamente por la cortesía o plausibilidad de su respuesta final.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La documentación actual del sandbox de Claude Code describe restricciones de sistema de archivos y red para la herramienta Bash aislada, junto con límites a la protección que proporciona. Es una referencia de implementación actual, no evidencia de que todos esos mecanismos ya estuvieran definidos en la hoja de ruta.
El comentario histórico identifica claramente el problema: el acceso a una herramienta útil también crea un límite que debe diseñarse, probarse y mantenerse.
Amanda Askell plantea una preocupación distinta en los comentarios. Si las capacidades avanzan principalmente en código mientras los experimentos de alineación se mantienen centrados en el lenguaje natural, las pruebas de alineación pueden resultar menos útiles para las capacidades que realmente se están desarrollando.
Propone mantener en proporción la investigación de capacidades y alineación en distintos dominios, salvo que exista una buena razón para separarlas. El punto es operativo: evaluar una interacción fácil de estudiar puede dejar una brecha si el sistema desplegado actúa cada vez más en otro tipo de entorno.
La sección de impacto social de la hoja de ruta incluye de manera similar evaluar modelos, ayudar a terceros a evaluar sistemas y ampliar el conjunto de investigadores externos que pueden experimentar con ellos. Estos son objetivos de investigación, no una garantía de que los programas de acceso o evaluaciones posteriores satisfagan todos los principios propuestos.
En conjunto, el material vuelve más específica la discusión sobre seguridad que una declaración de misión general. Conecta la retroalimentación del entrenamiento, el dominio de la evaluación, las herramientas ejecutables y la evaluación externa.
El documento respalda una conclusión histórica limitada pero útil: varios temas asociados con los agentes de programación modernos ya estaban conectados en la planificación temprana de investigación de Anthropic. La asistencia de software, el uso de herramientas, la retroalimentación, la escala, la memoria y la seguridad aparecen en la misma agenda.
No demuestra que la hoja de ruta causara cada éxito posterior, que el producto final fuera inevitable ni que otros laboratorios carecieran de ideas similares. Esas afirmaciones requerirían evidencia histórica y comparaciones adicionales más allá de este documento.
Para un desarrollador, las preguntas más útiles siguen siendo concretas. ¿Qué partes de una tarea puede realizar el modelo? ¿Qué herramientas puede utilizar? ¿Cómo se detectan los errores? ¿Y qué evita que una acción incorrecta afecte al entorno más amplio? La hoja de ruta es valiosa, en parte, porque esas preguntas siguen siendo reconocibles.
Es el documento escaneado enlazado públicamente titulado Concise Research Roadmap, atribuido a Jared Kaplan y marcado como actualizado por última vez en julio de 2021. La copia de seis páginas incluye el texto de investigación y comentarios ampliados, pero aquí no se autenticó de forma independiente su procedencia como divulgación judicial.
No. Describe una dirección de investigación para un asistente general de software. Un objetivo parecido a un producto posterior es diferente de la evidencia de que el producto ya se hubiera creado o lanzado.
No. Su referencia a modelos de 1T y superiores es un objetivo de investigación. No establece la arquitectura ni el número de parámetros de ningún modelo Claude actual.
La hoja de ruta propone estudiar la relación entre los juicios humanos y los del modelo sobre el comportamiento y la calidad de la salida. También conecta este tema con el sesgo, la equidad y las consecuencias sociales, en lugar de asumir que los juicios del modelo son suficientes por sí solos.
La expresión aparece en el contexto de alineación, discriminadores e investigación sobre escalamiento. Muestra interés por la computación en el momento de la evaluación, pero no especifica todos los métodos utilizados por los modelos de razonamiento posteriores.
Las herramientas que ejecutan código pueden realizar cambios en un entorno real, por lo que evaluar únicamente la respuesta final deja fuera parte del riesgo. El sandboxing, los controles de permisos y las pruebas adecuadas al dominio abordan distintos aspectos de ese problema y aún requieren una implementación cuidadosa.
La hoja de ruta de julio de 2021 vincula la ambición de un colega de software con la investigación sobre herramientas, modelos grandes, memoria y retroalimentación. Sus comentarios también identifican problemas de seguridad relacionados con herramientas ejecutables y pruebas de alineación que se quedan atrás respecto al desarrollo de capacidades.
Documenta una agenda temprana de investigación con temas modernos reconocibles, no un producto terminado en 2021 ni una especificación de los modelos Claude actuales.
Empieza con una sola frase y obtén un sitio completo en minutos.
