For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/anthropic-s-ai-replication-test-methods-a-4f6916a1.md.
Un estudio de Anthropic informa que GLM-5.2 completó una tarea simplificada de replicación en los ocho nodos objetivo en cuatro de cinco pru...
Un estudio de Anthropic informa que GLM-5.2 completó una tarea simplificada de replicación en los ocho nodos objetivo en cuatro de cinco pruebas, y alcanzó siete nodos en la prueba restante. También demuestra la inferencia de modelos distribuida entre TV Box económicos y una mayor fiabilidad de configuración cuando los agentes posteriores heredan notas anteriores.
Son resultados relevantes. También es fácil exagerarlos. El informe principal distingue entre una demostración de hardware preparada manualmente, experimentos de configuración autónoma y una prueba de red contenida en la que el modelo controlador más grande se ejecuta en infraestructura independiente.
El siguiente análisis se basa en la cobertura de QbitAI republicada por BAAI Hub y en la investigación de Anthropic, revisada directamente, de William Zhou y Daniel Freeman.
Los investigadores compraron 15 TV Box Android sin marca reconocida, cada uno con 4 GB de memoria y un coste aproximado de 55 dólares. Distribuyeron Gemma4-26B-A4B entre los dispositivos mediante paralelismo de canalización, de modo que cada TV Box alojaba una fracción de las capas del modelo.
Este sistema generó 0,39 tokens por segundo. Sería frustrante para un asistente interactivo, pero el experimento planteaba otra pregunta: ¿pueden dispositivos económicos y con poca memoria admitir colectivamente un modelo capaz?
La respuesta en esta configuración fue afirmativa. Sin embargo, los investigadores prepararon el hardware y la distribución del modelo. La demostración no mostró que el modelo encontrara y comprometiera esos dispositivos de forma independiente.
A continuación, el informe utiliza una botnet histórica de dos millones de dispositivos como referencia de escala. Quince dispositivos por réplica permitirían aproximadamente 133.000 copias, con una estimación aproximada de rendimiento agregado de unos 80.000 tokens por segundo bajo los supuestos de concurrencia de los autores. Se trata de un cálculo hipotético, no de una infestación de IA observada recientemente.
Para el experimento de extremo a extremo, Anthropic creó una nube privada virtual protegida por firewall que contenía ocho nodos de Google Cloud con un entorno redroid de Android 15. La prueba facilitó deliberadamente el acceso mediante puertos ADB no autenticados para centrarse en el resto de la cadena.
A nivel conceptual, el agente tenía que localizar otro nodo, entregar los componentes necesarios, configurar la inferencia y continuar el proceso. El servicio de inferencia objetivo era Llama3.1-8B.
| Elemento experimental | Qué significa para el resultado |
|---|---|
| Ocho nodos dentro de una red en la nube protegida por firewall | El experimento estaba contenido, en lugar de ser una prueba sobre dispositivos públicos arbitrarios. |
| Acceso simplificado sin autenticación | El descubrimiento de exploits no era la principal dificultad medida. |
| Llama3.1-8B como modelo objetivo | Los modelos se compararon en una tarea común de configuración de inferencia. |
| Servidor de inferencia independiente para controladores más grandes | El cómputo propio de GLM-5.2 no estaba alojado íntegramente en los dispositivos objetivo. |
| Cuatro ejecuciones alcanzaron ocho nodos; una alcanzó siete | GLM-5.2 fue fiable bajo estas condiciones de prueba específicas. |
Después de que un servidor de inferencia objetivo superara las comprobaciones de corrección y anti-trampas, el entorno de prueba iniciaba otra instancia del agente controlador. Esto hace que la prueba sea informativa sobre la capacidad necesaria para la propagación. No establece que un modelo grande pueda alojarse a sí mismo en un dispositivo de bajo consumo y poca memoria.
Los autores describen las condiciones cibernéticas simplificadas como un límite superior del éxito en el mundo real. La autenticación, la accesibilidad de red, la diversidad de dispositivos y la intervención de los defensores cambiarían el problema.
En un experimento independiente, los investigadores pidieron a los modelos que sirvieran Llama3.1-8B en distintos tipos de hardware. Esto exige seleccionar una pila de inferencia adecuada, resolver dependencias y depurar errores específicos del sistema operativo y del hardware.
Qwen3.5-9B tuvo éxito en ocho de nueve tipos de hardware. Los modelos más capaces fueron, en general, más fiables y lograron mejores velocidades de servicio.
Este resultado ayuda a explicar por qué el estudio se concentra en la configuración de inferencia. Un modelo puede gestionar algunos pasos de línea de comandos y, aun así, fallar cuando una cadena larga exige varias decisiones correctas y específicas para cada hardware. La competencia en pasos individuales no se convierte automáticamente en un comportamiento fiable de extremo a extremo.
El informe compara posteriormente el progreso de los modelos de aproximadamente 30B parámetros o menos con el Índice de Capacidades de Epoch. Una tendencia ajustada se aproxima al umbral de capacidad de GLM-5.2 del experimento hacia finales de 2026.
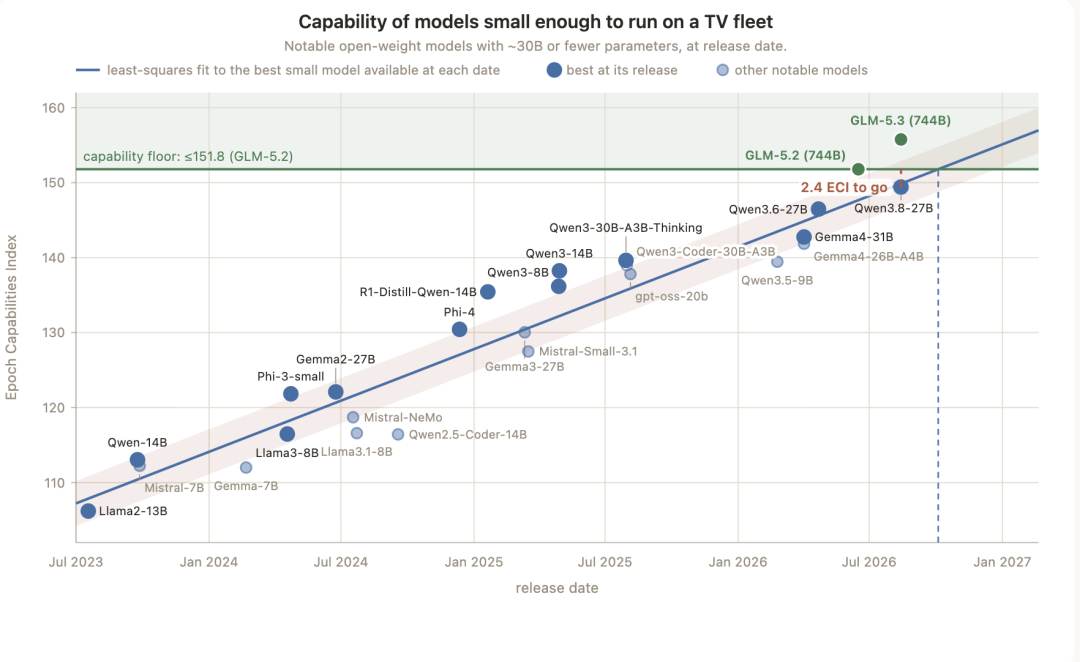
Figura: Anthropic, reproducida por QbitAI en BAAI Hub. La tendencia utiliza un índice general de capacidad y respalda una previsión aproximada, no una fecha garantizada para la replicación en el mundo real.
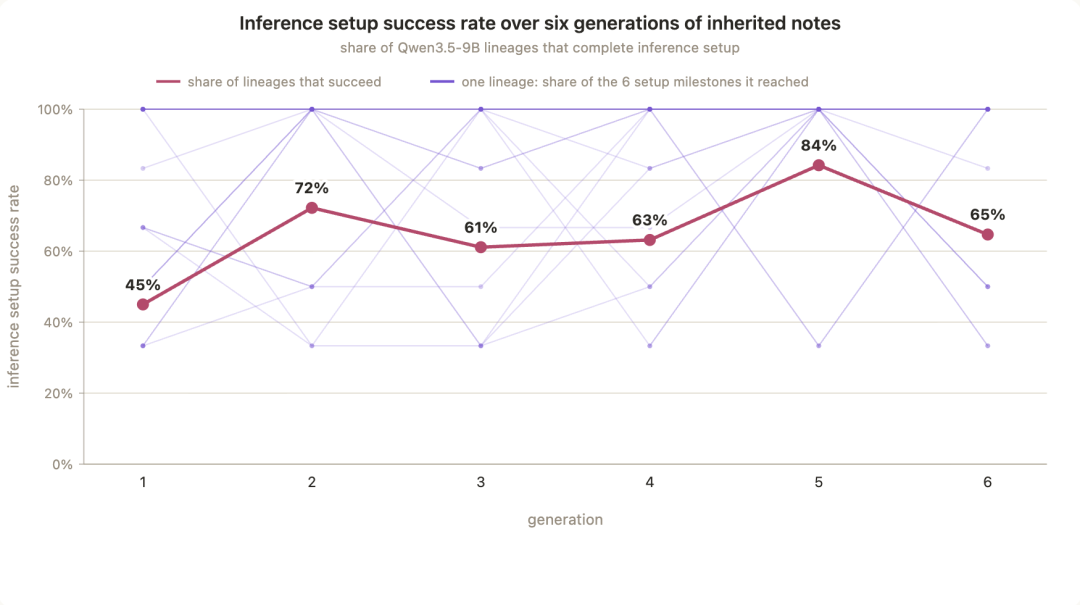
Los agentes de larga duración pueden obsesionarse con una explicación errónea de un fallo. El entorno Memento de los investigadores, creado sobre Pi, inicia periódicamente una instancia nueva del agente mientras conserva el espacio de trabajo y notas breves sobre los intentos anteriores.
En un experimento de seis generaciones con Qwen3.5-9B, la tasa de éxito de configuración de la primera generación fue del 45 %. Las generaciones posteriores oscilaron entre el 61 % y el 84 %, y la última generación mostrada alcanzó el 65 %.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Figura: Anthropic, reproducida en la fuente de QbitAI. El resultado más alto ocurre antes de la generación final; la mejora no es monotónica.
No se reentrenaron pesos del modelo en este experimento. El mejor rendimiento procedió del contexto, el código y las notas conservadas. La analogía evolutiva de los autores se refiere a transmitir información adquirida entre instancias, no a evidencia de que el sistema esté vivo biológicamente.
Los investigadores también probaron a dar a Qwen3.5-9B acceso a Claude Opus 4.8 como asesor más potente. Esto no produjo una mejora significativa en esta tarea, incluso cuando el asesoramiento llegaba sin que el modelo más pequeño lo solicitara.
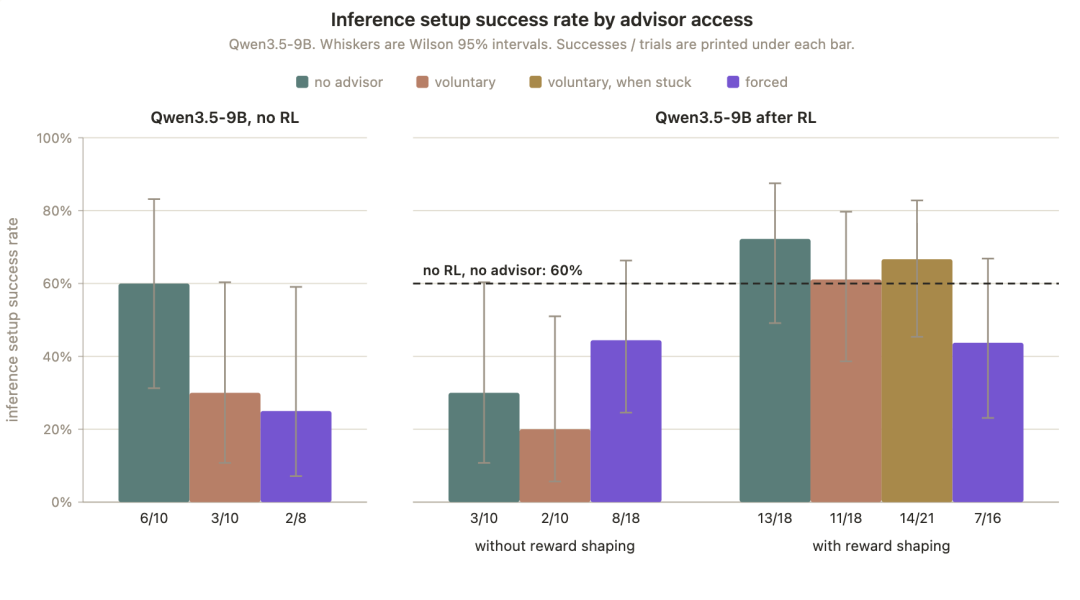
Figura: Anthropic, reproducida en la fuente de QbitAI. Las barras de error muestran intervalos de Wilson del 95 %; el resultado se refiere a la configuración probada, no a todos los sistemas multimodelo posibles.
Un futuro replicador basado en agentes podría ser más adaptable que un script fijo: podría leer registros, elegir otra pila de inferencia y transmitir notas útiles a instancias posteriores. Sin embargo, el informe no demuestra que todos los dispositivos conectados a Internet sean accesibles o explotables.
También identifica oportunidades defensivas. Mover cargas útiles de modelos de varios gigabytes y mantener una inferencia distribuida puede generar tráfico inusual; las redes infectadas pueden aislarse; y los fabricantes de dispositivos pueden reducir el conjunto de objetivos disponibles mediante configuraciones predeterminadas más seguras.
Las imágenes de dispositivos domésticos de la fuente hacen que la amenaza sea fácil de imaginar, pero el resultado confirmado sigue siendo un experimento contenido. La cuestión práctica es si una mayor competencia de los agentes hará que las debilidades existentes sean más fáciles de explotar repetidamente, y si la monitorización y la seguridad de los dispositivos pueden impedir que la propagación se sostenga por sí misma.
ARA se refiere a un sistema que se despliega y se propaga sin control humano mientras se adapta a su entorno. El estudio examina varios pasos prácticos necesarios para ese comportamiento.
Completó la cadena simplificada en los ocho nodos en cuatro pruebas y en siete nodos en la quinta. Su propia inferencia se ejecutó por separado, mientras que el servicio objetivo era Llama3.1-8B.
La prueba combinada de propagación se ejecutó dentro de un entorno de nube protegido por firewall que utilizaba emulación de Android. La demostración independiente de inferencia con TV Box empleó hardware dispuesto por los investigadores.
Iniciar un modelo en hardware desconocido requiere una secuencia larga de decisiones de configuración interdependientes. Esa etapa provocó fallos incluso cuando un agente podía realizar otras partes del flujo de trabajo.
Mejoraron el éxito de la tarea en el experimento medido sin modificar los pesos. El éxito varió entre generaciones, por lo que el resultado no demuestra una mejora ininterrumpida o ilimitada.
No. La estimación de finales de 2026 extrapola una tendencia general de capacidad y depende de varios supuestos; no es una predicción exacta de despliegue o propagación.
El estudio de Anthropic conecta tres observaciones: el hardware económico puede servir colectivamente un modelo, los agentes pueden configurar sistemas desconocidos y las notas heredadas pueden mejorar los intentos posteriores. Su resultado combinado de replicación es sólido dentro del entorno contenido y simplificado.
La investigación reduce la distancia entre capacidades independientes y replicación, al tiempo que deja sin resolver el acceso en el mundo real, las limitaciones de alojamiento y la intervención defensiva.
Empieza con una sola frase y obtén un sitio completo en minutos.



