For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/azure-maia-300-microsoft-s-2027-multi-gig-1e316d9a.md.
Microsoft está llevando su programa de infraestructura de IA personalizada a una fase de despliegue mucho más amplia.
Microsoft está llevando su programa de infraestructura de IA personalizada a una fase de despliegue mucho más amplia.
El 12 de octubre de 2026, la compañía afirmó que planea escalar la familia Azure Maia a despliegues multigigavatio a partir de 2027, y que Maia se convertirá en el sistema de inferencia principal para los productos y servicios de Microsoft.
El anuncio conecta dos generaciones de hardware de IA diseñado por Microsoft.
Maia 200 ya está en producción y atiende cargas de trabajo de Microsoft. Maia 300, el siguiente sistema, tiene previsto comenzar su despliegue en producción en 2027 y está diseñado específicamente para razonamiento de contexto largo, conversaciones sensibles a la latencia y cargas de trabajo sostenidas de agentes de múltiples pasos.
El argumento central de Microsoft es que la eficiencia de inferencia ya no puede mejorarse observando únicamente el chip.
La empresa está codiseñando:
como un único sistema.
Este enfoque de nivel de sistema es el que Microsoft pretende escalar al rango de múltiples gigavatios.
Antes de analizar Maia 300, el anuncio de Microsoft comienza con la generación actual.
Maia 200 ya no es únicamente una plataforma de desarrollo.
Microsoft afirma que ahora atiende cargas de trabajo de producción, incluido Microsoft Copilot, y que también respalda al equipo Microsoft AI mientras desarrolla modelos de próxima generación.
La compañía indica que se espera que GitHub Copilot y Microsoft Foundry le sigan antes de finales de 2026.
En estas cargas de trabajo, Maia 200 puede ejecutar:
Esto es importante porque Microsoft no presenta Maia como silicio para una única familia de modelos propietaria.
La arquitectura está diseñada para admitir una cartera heterogénea de modelos dentro de Azure y de los propios servicios de Microsoft.
Microsoft opera productos de IA a una escala enorme.
Esto proporciona a sus equipos de infraestructura visibilidad directa sobre dónde los modelos desplegados consumen tiempo, ancho de banda de memoria, capacidad de red y energía.
En lugar de diseñar primero un acelerador de propósito general y decidir después cómo deben utilizarlo las aplicaciones, Microsoft afirma que sus grupos de hardware y software colaboran con años de antelación.
El objetivo es anticipar futuros requisitos de los modelos y traducirlos en decisiones de hardware como:
Ese ciclo de retroalimentación ya está definiendo la próxima generación.
Microsoft afirma que Maia 200 se está desplegando en:
Para capacidades de IA integradas en productos como Microsoft Teams, Copilot y Cowork, Microsoft informa que Maia 200 puede ofrecer hasta 1,7 veces más tokens por vatio que lo que describe como infraestructura GPU líder.
Esta es una comparación comunicada por Microsoft, no un benchmark publicado de forma independiente en sistemas de terceros estandarizados.
La formulación importa.
Es evidencia de la experiencia interna de Microsoft en producción, pero no debe interpretarse como una ventaja universal de 1,7 veces para cada modelo, prompt, tamaño de lote, objetivo de latencia o despliegue de GPU.
Microsoft afirma que la experiencia de producción con Maia 200 influyó directamente en el diseño de Maia 300.
El sistema más reciente está pensado para admitir una gama más amplia de cargas de trabajo, entre ellas:
La restricción común entre estas cargas de trabajo es la inferencia.
Exigen que los modelos mantengan la capacidad de respuesta mientras procesan contextos más largos, conservan más estado y ejecutan más pasos.
Microsoft describe Maia 300 como la tercera generación de su programa Azure Maia.
El diseño prioriza la inferencia.
Esto significa que Microsoft está optimizando para las cargas de trabajo que espera que dominen los sistemas de IA desplegados, en lugar de centrarse únicamente en el rendimiento de entrenamiento.
Estas cargas de trabajo incluyen:
La métrica objetivo ya no es solamente el rendimiento bruto en FLOPS.
Es cuántos tokens útiles puede entregar un centro de datos dentro de restricciones fijas de:
Microsoft afirma que se espera que Maia 300 ofrezca un 40 % más de tokens por megavatio que los sistemas líderes basados en GPU.
Esta cifra es una expectativa de Microsoft para la eficiencia de despliegue a nivel de sistema, no un benchmark público e independiente con una metodología completa de pruebas entre proveedores.
En un rack completo de 96 aceleradores, Microsoft también afirma que Maia 300 puede ofrecer hasta 7 veces el rendimiento de tokens a escala de rack de Maia 200.
Estas dos cifras miden comparaciones diferentes:
| Afirmación | Comparación |
|---|---|
| 40 % más de tokens por megavatio | Maia 300 frente a sistemas líderes basados en GPU |
| Hasta 7 veces el rendimiento de tokens a escala de rack | Rack completo de Maia 300 con 96 aceleradores frente a Maia 200 |
No deben considerarse intercambiables.
Una de las ideas principales detrás de Maia 300 es que el movimiento de datos se ha convertido en un cuello de botella importante.
Los sistemas de inferencia modernos trasladan repetidamente:
entre unidades de cómputo, memoria y enlaces de red.
Cada movimiento consume latencia y energía.
La respuesta de Microsoft es una evolución de la arquitectura de flujo de datos con acceso local definido por software, o SDLA, introducida con Maia 200.
El software controla dónde se colocan los datos y cuándo se desplazan entre:
Maia 300 amplía esta idea mediante un diseño multichiplet.
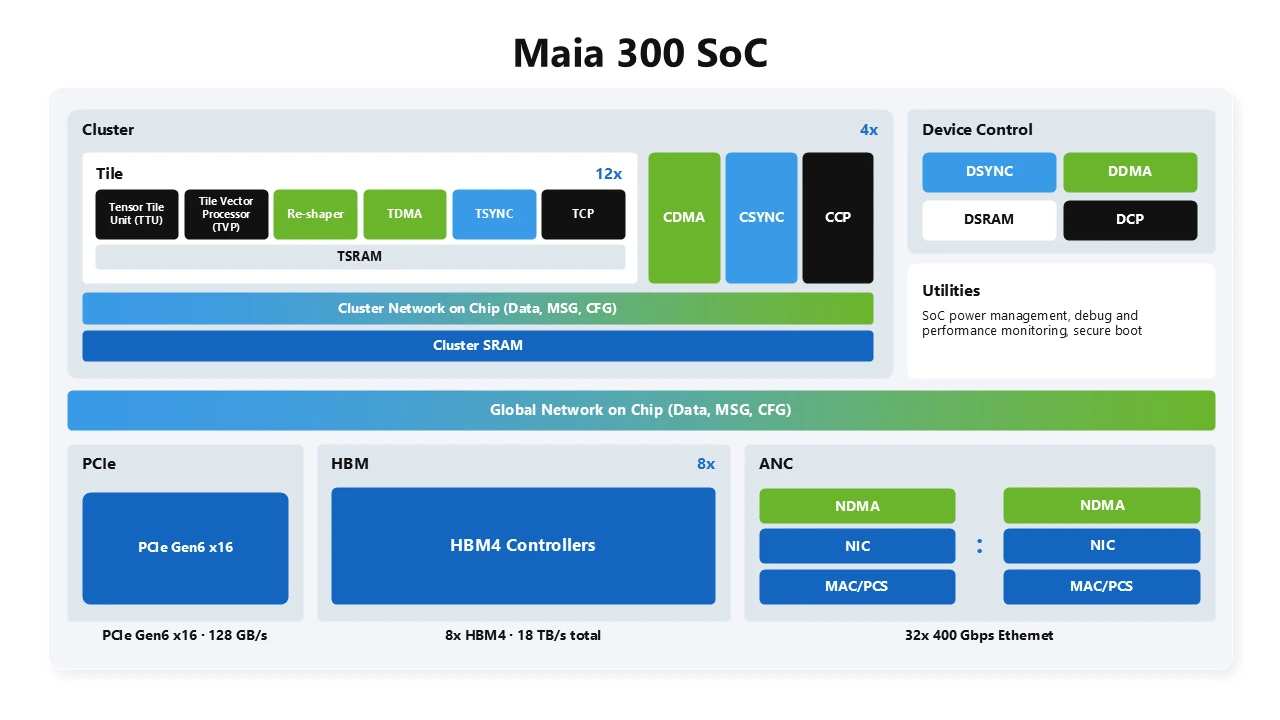
Maia 300 pasa de una organización de memoria más uniforme hacia una arquitectura de memoria no uniforme, consciente de la localidad, entre chiplets.
El propósito es sencillo:
Mantener los datos más cerca del cómputo que los utiliza
→ mover menos bytes
→ reducir la latencia y la energía
→ mejorar la utilización
La arquitectura otorga al software una responsabilidad más directa para controlar la localidad.
Esto es especialmente importante para la inferencia de contexto largo y con alta carga de decodificación, donde el movimiento del estado del modelo y de la caché KV puede dominar la carga de trabajo.
La memoria es una de las mayores mejoras de Maia 300.
Cada acelerador utiliza ocho pilas HBM4 que proporcionan:
Microsoft afirma que esto ofrece aproximadamente:
El sistema también utiliza SRAM en el chip como memoria temporal administrada por software.
Esto puede reducir la presión sobre la HBM al mantener los datos reutilizados con frecuencia más cerca del cómputo.
Para la inferencia, esto importa porque muchas cargas de trabajo están limitadas por la rapidez con la que el estado puede entregarse a los motores de cómputo, y no por la capacidad aritmética máxima de esos motores.
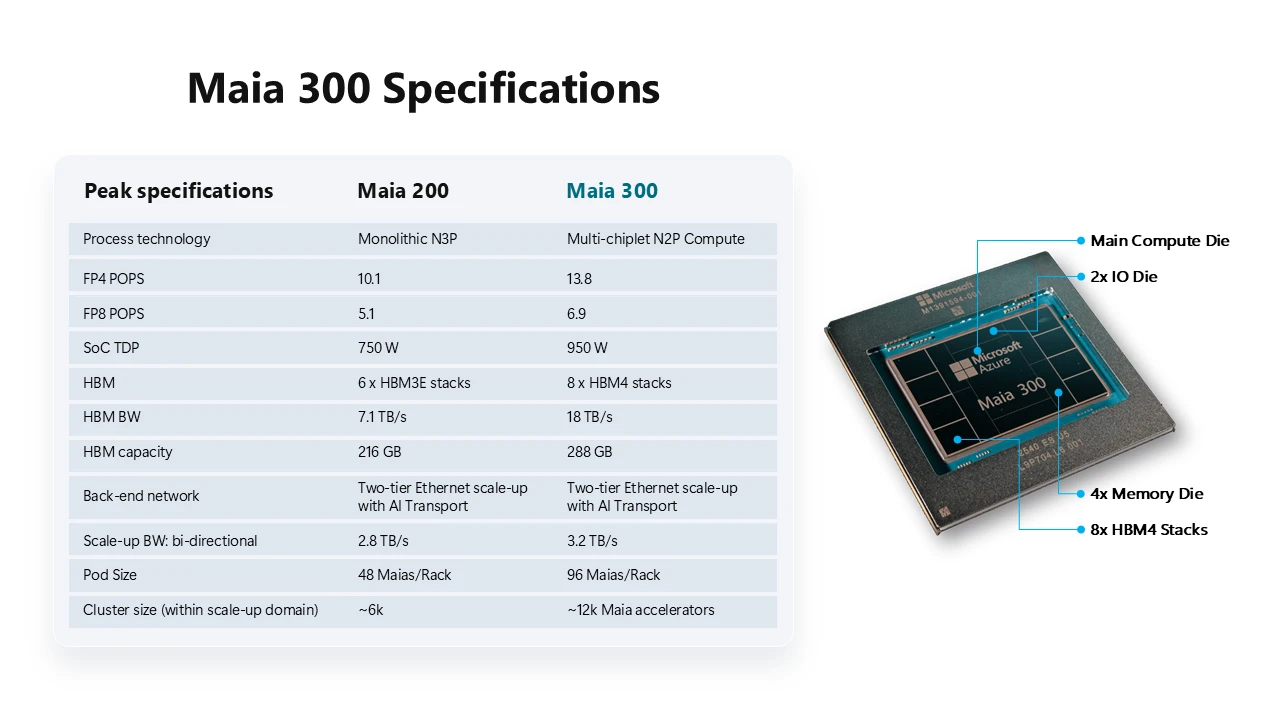
Maia 300 no es un único chip monolítico en el mismo sentido que Maia 200.
Microsoft está separando las funciones principales entre chiplets.
La arquitectura incluye funciones diferenciadas para:
Los chiplets de cómputo se fabrican con el proceso N2P de TSMC.
El razonamiento es económico además de técnico.
La tecnología de proceso más avanzada puede concentrarse donde proporciona el mayor beneficio de rendimiento por vatio, mientras que otras funciones pueden utilizar diseños optimizados para ancho de banda, conectividad o coste.
La publicación de arquitectura técnica de Microsoft afirma que el cambio contribuye a:
con respecto a Maia 200.
Maia 300 también amplía la compatibilidad con inferencia de menor precisión.
Microsoft destaca la compatibilidad mejorada con MXFP4 y formatos de almacenamiento inferiores a 3 bits en su material de arquitectura técnica.
La menor precisión puede reducir:
El beneficio no consiste simplemente en usar números más pequeños.
Si el modelo puede mantener la calidad requerida con menor precisión, la infraestructura puede admitir:
Microsoft también afirma que el motor vectorial añade optimizaciones a nivel de instrucción para kernels de inferencia como softmax y conversión de datos de baja precisión.
A gran escala, los aceleradores solo son útiles si pueden comunicarse eficientemente.
Maia 300 extiende su modelo de flujo de datos a la propia red.
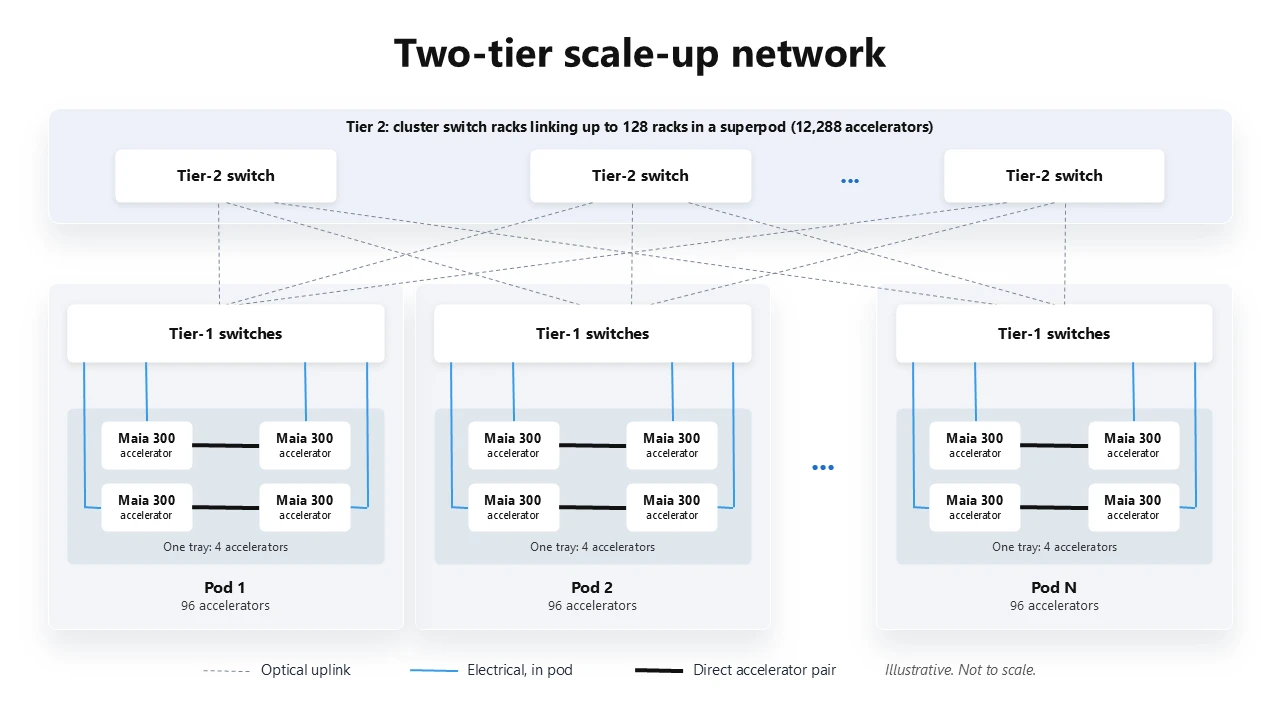
Microsoft utiliza transporte de IA personalizado sobre infraestructura basada en Ethernet y una topología de escalamiento vertical de dos niveles.
Un único rack de Maia 300 contiene:
96 aceleradores
Después, varios racks pueden conectarse en un superpod.
La arquitectura técnica de Microsoft describe un superpod máximo de:
128 racks
12.288 aceleradores Maia 300
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Dentro de un rack, enlaces directos conectan pares de aceleradores, mientras que rutas eléctricas conmutadas conectan el pod completo de 96 aceleradores.
Microsoft afirma que mantener el escalamiento vertical dentro del rack en formato eléctrico ayuda a reducir el consumo y el coste.
Un segundo nivel de red utiliza conectividad óptica para abarcar varios racks.
Esto permite que hasta 128 racks participen en el mismo dominio de escalamiento vertical.
El objetivo declarado de Microsoft es evitar exponer semánticas de comunicación separadas para cada límite físico.
El mismo modelo general de comunicación abarca:
Esto ofrece a los planificadores y al software mayor flexibilidad para colocar cargas de trabajo con paralelismo de tensores, canalización y expertos.
El rack de Maia 300 es una parte importante del diseño del sistema.
Cada rack contiene:
La comparación de arquitectura de Microsoft redondea la capacidad HBM total a 27,7 TB en su gráfico de rack.
La diferencia es simplemente el redondeo de 96 × 288 GB.
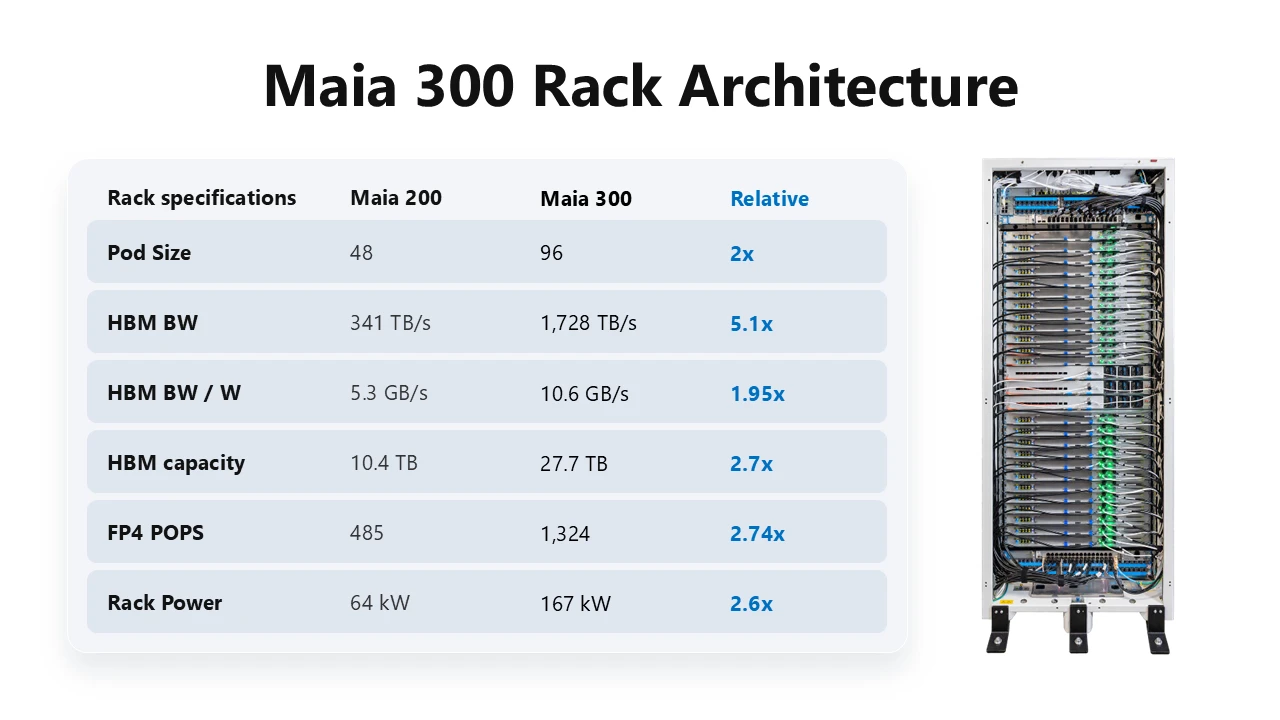
La densidad de aceleradores duplica la de Maia 200.
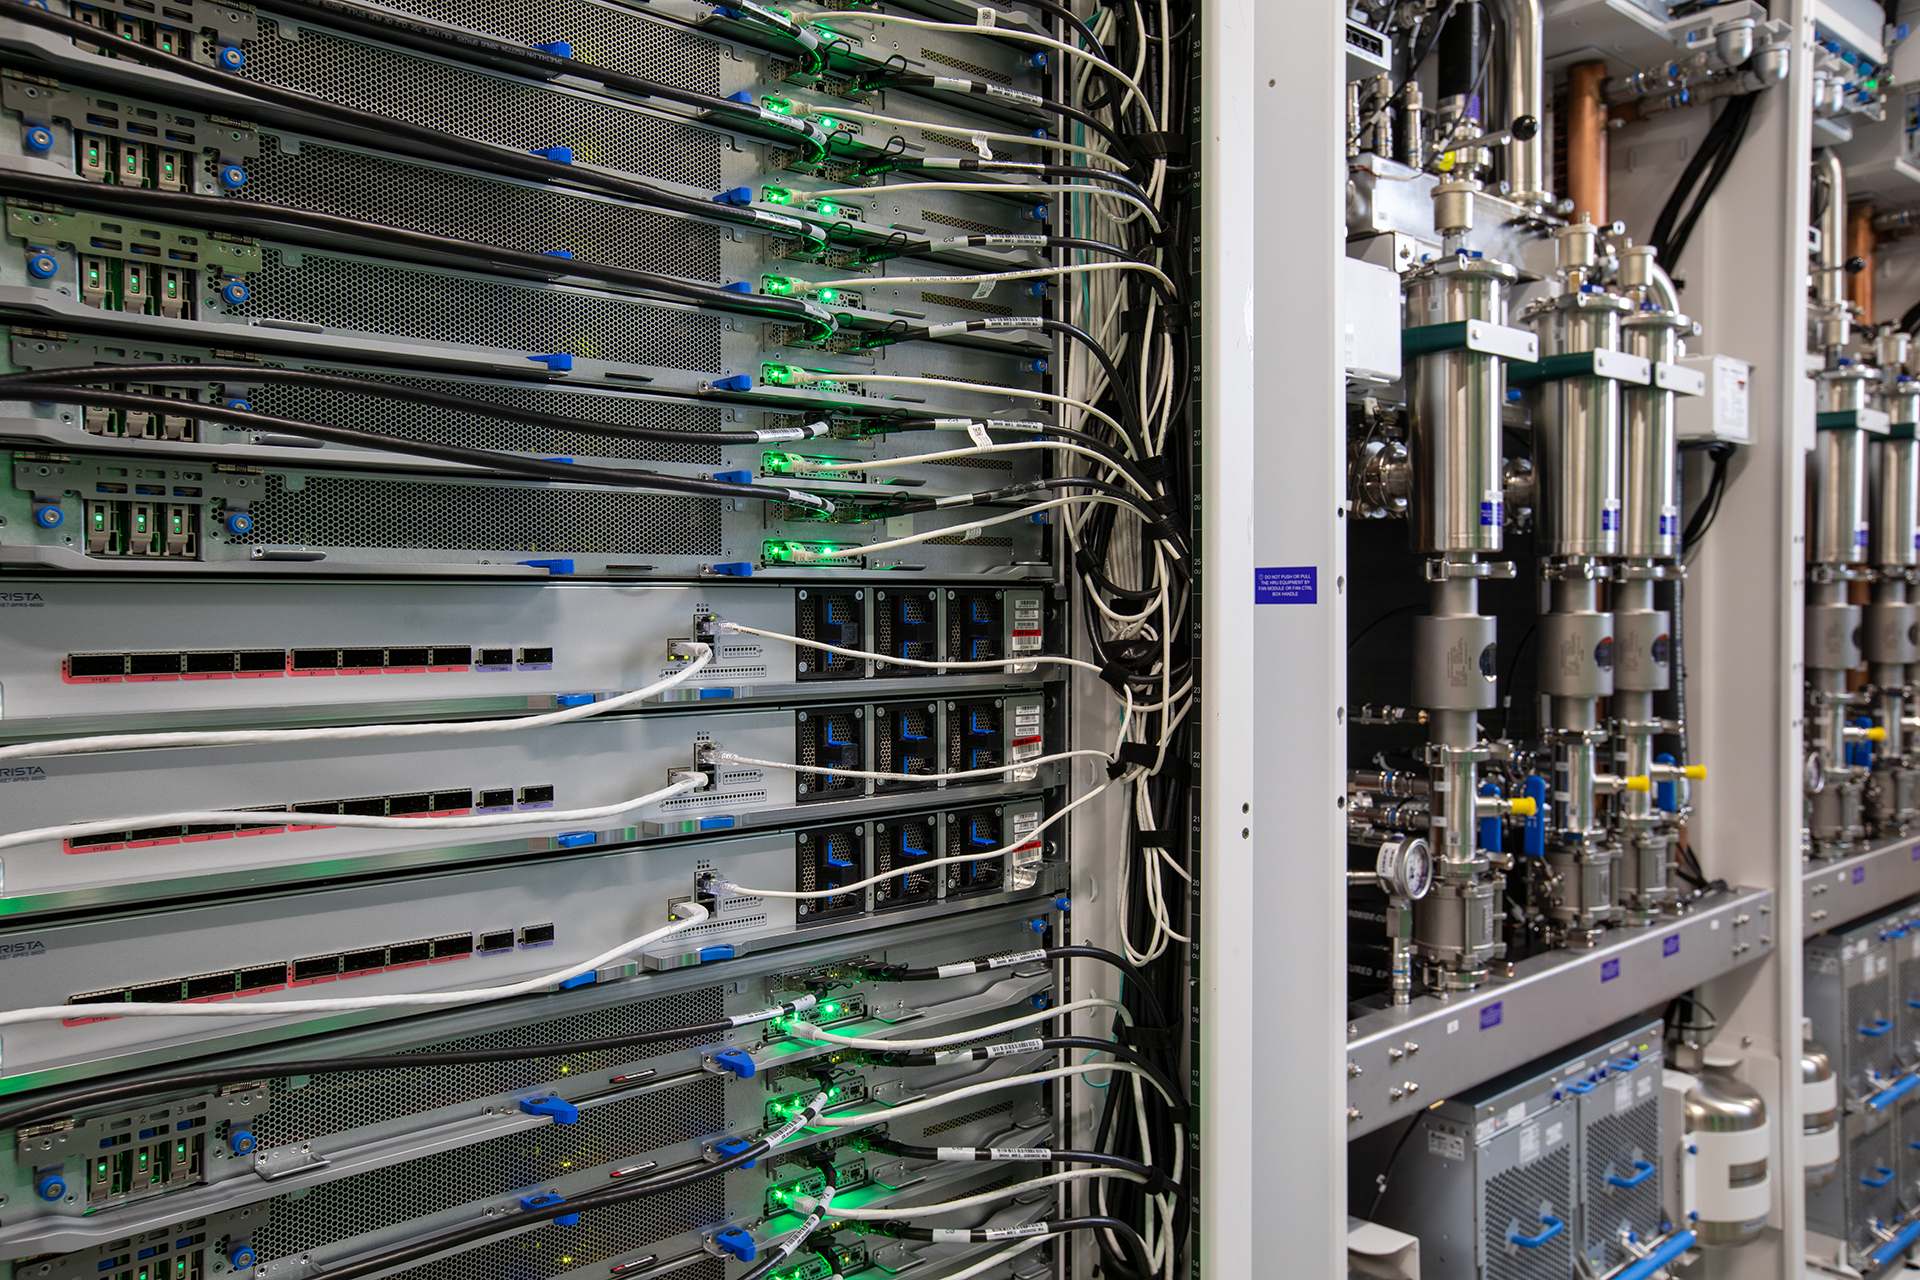
Microsoft integra cómputo host, memoria, almacenamiento, refrigeración y aceleradores en cada bandeja, en lugar de requerir bandejas de host separadas.
Esto libera espacio en el rack y permite gestionar la energía y la temperatura como un solo sistema.
Un rack de IA de 167 kW genera un desafío considerable de gestión térmica.
Microsoft afirma que la refrigeración líquida elimina más del 80 % de la carga térmica del rack de componentes como:
La refrigeración por aire se mantiene para componentes como memoria, almacenamiento y otros sistemas de soporte.
El rack puede conectarse directamente al agua de la instalación cuando existe esa infraestructura.
También puede utilizar una unidad de intercambiador de calor en instalaciones que, por lo demás, se refrigeran por aire.
Esta flexibilidad es importante para la escala de despliegue.
Microsoft no puede ampliar Maia únicamente en centros de datos construidos en torno a una configuración exacta de refrigeración.
La siguiente tabla consolida las especificaciones publicadas por Microsoft para Maia 300 y su comparación con Maia 200.
| Especificación | Maia 200 | Maia 300 |
|---|---|---|
| Proceso / enfoque de encapsulado | N3P monolítico | Multichiplet, cómputo N2P |
| Pico FP4 | 10,1 POPS | 13,8 POPS |
| Pico FP8 | 5,1 POPS | 6,9 POPS |
| TDP del SoC | 750 W | 950 W |
| HBM | 6 × HBM3E | 8 × HBM4 |
| Capacidad HBM por acelerador | 216 GB | 288 GB |
| Ancho de banda HBM por acelerador | 7,1 TB/s | 18 TB/s |
| Ancho de banda bidireccional de escalamiento vertical | 2,8 TB/s | 3,2 TB/s |
| Aceleradores por rack | 48 | 96 |
| Capacidad HBM aproximada por rack | 10,4 TB | 27,7 TB |
| Potencia del rack | 64 kW | 167 kW |
| Dominio máximo publicado de escalamiento vertical | ~6.000 aceleradores | ~12.000 aceleradores |
Estas son especificaciones máximas y de sistema publicadas por Microsoft.
No son garantías a nivel de aplicación.
El rendimiento real depende del modelo, la precisión, el tamaño de lote, el objetivo de latencia, la estrategia de paralelismo, la pila de software y la combinación de cargas de trabajo.
La cifra principal es el plan de Microsoft de llevar Azure Maia a despliegues multigigavatio a partir de 2027.
Es una afirmación sobre la escala de infraestructura.
Microsoft no ha revelado una cifra total exacta de gigavatios, un calendario de despliegue por despliegue ni un número de aceleradores asociado a esa declaración.
Tampoco debe interpretarse como que un único centro de datos de Maia 300 consumirá necesariamente múltiples gigavatios.
Un programa a escala de gigavatios puede abarcar:
El anuncio de la compañía se centra deliberadamente en la estrategia de sistema, en lugar de un plan de construcción instalación por instalación.
La infraestructura de IA está cada vez más condicionada por la cantidad de cómputo útil que puede caber dentro de la energía disponible.
Un centro de datos no puede añadir aceleradores de forma indefinida si no puede proporcionar también:
Por eso Microsoft hace hincapié en los tokens por megavatio.
La métrica conecta la producción del servicio de modelos con el recurso escaso que determina cada vez más la expansión de los centros de datos.
Un chip que es más rápido, pero consume proporcionalmente más energía, puede no resolver el problema real de despliegue.
El objetivo es generar más producción de IA útil dentro del mismo límite de infraestructura.
El anuncio de Microsoft va más allá de afirmar que Maia 300 será otra opción de acelerador.
La compañía dice que la familia Maia se convertirá en su sistema de inferencia principal para los productos y servicios de Microsoft a medida que aumente el despliegue.
Esto hace que Maia sea estratégicamente importante en toda la pila de Microsoft.
La compañía menciona o hace referencia a cargas de trabajo que incluyen:
Esto no significa que Microsoft esté abandonando las GPU u otros aceleradores.
Microsoft describe explícitamente su infraestructura más amplia como heterogénea y diversa en modelos.
El programa Maia proporciona a Microsoft otra opción de infraestructura que puede optimizar estrechamente para sus propios patrones de servicio.
La sección final del anuncio de Microsoft sitúa a Maia dentro de lo que la compañía denomina Frontier Transformation.
La idea es que la infraestructura de IA no debe optimizarse como capas aisladas.
Microsoft quiere conectar:
Silicio
→ sistemas
→ centros de datos
→ servicio de modelos
→ agentes
→ aplicaciones
Como Microsoft opera todas esas capas, puede utilizar la retroalimentación de producción de las aplicaciones para influir en el hardware futuro.
Lo contrario también es cierto.
Las nuevas capacidades de hardware pueden determinar lo que futuros modelos y agentes pueden hacer económicamente a escala.
Ese es el propósito estratégico de Maia.
La compañía no intenta demostrar que un chip sustituirá a todos los aceleradores.
Está construyendo una plataforma de inferencia diseñada verticalmente de forma conjunta que puede coexistir con otro hardware en Azure.
Las especificaciones publicadas de Maia 300 son significativas, pero la mayor parte del sistema clave sigue en fase previa a producción.
El despliegue en producción comienza en 2027.
Varias cuestiones serán importantes cuando el sistema alcance cargas de trabajo reales.
Microsoft espera un 40 % más de tokens por megavatio que los sistemas líderes basados en GPU.
La pregunta útil será cómo se mantiene esto en diferentes modelos y objetivos de latencia.
El silicio personalizado solo tiene éxito cuando el compilador, los kernels, la observabilidad, las herramientas de despliegue y la compatibilidad de modelos son lo bastante maduros para los equipos de producción.
Microsoft quiere que Maia admita familias de modelos de OpenAI, MAI y código abierto.
La eficiencia de producción entre arquitecturas heterogéneas será una prueba importante.
El dominio de escalamiento vertical de 12.288 aceleradores es arquitectónicamente significativo.
La utilización en el mundo real, la recuperación ante fallos, la planificación y la comunicación entre racks determinarán qué parte de esa escala teórica se traduce en capacidad útil.
El rendimiento por vatio es solo una parte del coste total.
Los operadores de centros de datos también se preocupan por:
La ventaja de Microsoft, si la estrategia funciona, procederá de optimizar todo el sistema y no una única cifra de benchmark.
Azure Maia 300 es el sistema de inferencia de IA personalizado de tercera generación de Microsoft. Combina un acelerador multichiplet, memoria HBM4, flujo de datos definido por software, redes de escalamiento vertical personalizadas basadas en Ethernet y una arquitectura de rack con 96 aceleradores diseñada para la inferencia de IA a escala de nube.
Microsoft afirma que el despliegue en producción comenzará en 2027. La compañía también planea comenzar a escalar la familia Maia a despliegues multigigavatio en 2027.
Significa que Microsoft planea infraestructura Maia a una escala de energía agregada medida en múltiples gigavatios. Microsoft no ha publicado un total exacto, número de aceleradores ni una afirmación de que un único centro de datos consumirá múltiples gigavatios; por tanto, esos detalles no deben inferirse únicamente del titular.
Cada acelerador Maia 300 tiene ocho pilas HBM4 con 288 GB de capacidad y 18 TB/s de ancho de banda HBM máximo. Un rack de 96 aceleradores contiene aproximadamente entre 27,6 y 27,7 TB de HBM agregada.
Microsoft especifica un límite de potencia de 167 kW para un rack Maia 300 completo de 96 aceleradores. El SoC del acelerador tiene un TDP de 950 W.
Microsoft espera que Maia 300 ofrezca un 40 % más de tokens por megavatio que los sistemas líderes basados en GPU, pero no ha publicado una metodología completa e independiente de benchmark entre proveedores para esa afirmación. Por tanto, el resultado debe tratarse como una expectativa de rendimiento de Microsoft a nivel de sistema y no como una conclusión universal de benchmark.
Microsoft afirma que Maia se convertirá en su sistema de inferencia principal para los productos y servicios de Microsoft, pero también describe Azure como una plataforma abierta y heterogénea con elección de modelos y silicio. Maia forma parte de esa combinación de infraestructura más amplia, y no es evidencia de que Azure vaya a utilizar únicamente silicio de Microsoft.
Microsoft afirma que Maia 200 ya atiende Microsoft Copilot y respalda el desarrollo de modelos de próxima generación del equipo MAI. Se espera que GitHub Copilot y Microsoft Foundry le sigan antes de finales de 2026.
Microsoft está convirtiendo Azure Maia de un programa de aceleradores personalizados en una plataforma de inferencia a gran escala. Maia 200 ya ejecuta cargas de trabajo de producción, mientras que Maia 300 tiene previsto comenzar su despliegue en 2027 y está diseñado en torno a inferencia de contexto largo, con alta carga de decodificación y basada en agentes.
Los cambios más importantes son de nivel de sistema: 288 GB de HBM4 por acelerador, 18 TB/s de ancho de banda de memoria, un diseño N2P multichiplet, 96 aceleradores por rack de 167 kW, una estructura de escalamiento vertical que alcanza 12.288 aceleradores y refrigeración líquida que elimina más del 80 % del calor del rack.
El objetivo de Microsoft es escalar la familia Maia a despliegues multigigavatio y convertirla en el sistema de inferencia principal detrás de sus propios productos y servicios, manteniendo al mismo tiempo la heterogeneidad de Azure.
La historia de Maia 300 trata menos de que un chip sustituya a otro y más de que Microsoft diseñe toda la ruta, desde el silicio hasta el centro de datos y el agente, en torno a la economía de la inferencia de IA.
Empieza con una sola frase y obtén un sitio completo en minutos.



