Nombre: Despliegue-Entorno de producción. Descripción: Verificar y desplegar la aplicación en el entorno de producción. --- 1. Leer checklis...
checklist.md.scripts/verify-release.sh.
El mecanismo importante es la **divulgación progresiva**.

Claude verá una breve descripción que le ayudará a decidir si una habilidad es relevante. El cuerpo completo de la habilidad y los archivos de respaldo solo se cargan cuando se necesita ese flujo de trabajo.

Mukta lo compara con una estantería.

Una persona no necesita memorizar cada libro antes de comenzar una conversación. Solo necesita saber qué libro podría contener información relevante y sacarlo en el momento adecuado.

Las habilidades ayudan a resolver el problema del "archivo de contexto en constante crecimiento":

- Los hechos estables y de alto nivel pueden permanecer en `CLAUDE.md`.
- Los flujos de trabajo detallados pueden trasladarse a habilidades.
- Los materiales de respaldo pueden mantenerse fuera del contexto activo hasta que se necesiten.

La documentación oficial de habilidades de Anthropic sugiere crear habilidades cuando un equipo repite las mismas instrucciones, listas de verificación o procesos de varios pasos en las conversaciones, o cuando una sección de `CLAUDE.md` ha evolucionado hacia un proceso en lugar de un hecho conciso.

### Las habilidades aún requieren gestión humana

Las habilidades son reutilizables, pero aún alguien debe decidir:

- Qué flujos de trabajo merecen una habilidad
- Cómo debe estructurarse el proceso
- Qué archivos deben incluirse
- Cuándo una habilidad queda obsoleta
- Quién tiene permiso para editarla

Los agentes pueden ayudar a redactar y mantener habilidades, pero el sistema aún depende parcialmente de la gestión humana.

Esto lleva a un cuarto enfoque.

## Cuarta generación: tratar el sistema de archivos como memoria

Mukta describe la memoria basada en el sistema de archivos como el patrón que Anthropic prefiere actualmente en muchos sistemas de memoria de agentes.

La justificación es muy pragmática.

Los agentes ya son buenos en:

- Listar archivos
- Buscar nombres de archivo
- Ejecutar `grep`
- Leer Markdown
- Navegar directorios
- Editar texto
- Comparar versiones

En lugar de inventar una interfaz de memoria altamente especializada, los equipos pueden organizar la memoria como archivos y proporcionar a los agentes herramientas normales del sistema de archivos.

Una posible estructura es la siguiente:

```Plaintext
memory/
├── organization/
│   ├── principles.md
│   ├── terminology.md
│   └── security-policy.md
├── teams/
│   ├── engineering/
│   │   ├── architecture.md
│   │   └── release-process.md
│   └── support/
│       ├── escalation-rules.md
│       └── response-style.md
├── projects/
│   └── billing-redesign/
│       ├── decisions.md
│       ├── known-issues.md
│       └── current-status.md
└── agents/
    └── agent-104/
        └── scratchpad.md
Esta estructura admite diferentes niveles de memoria:
También incorpora la divulgación progresiva.
El agente puede buscar en el directorio y cargar solo los archivos relevantes para la tarea actual.
La interfaz de estilo sistema de archivos no requiere que cada memoria empresarial exista como archivos no administrados en una computadora portátil.
La implementación subyacente aún puede utilizar:
El punto clave es que el agente obtiene una abstracción simple y navegable.
En la sesión de preguntas y respuestas, un miembro del público preguntó si esto equivalía a reinventar la base de datos.
Mukta reconoció que esta arquitectura regresa a principios familiares de la ingeniería de software. Una vez que los equipos identifican qué comportamientos deberían ser deterministas, pueden trasladarlos a un marco de control en lugar de dejar que el modelo improvise cada vez.
Una carpeta llena de archivos Markdown puede funcionar para un solo usuario.
Pero cuando miles de agentes pueden actualizar la memoria organizacional compartida, se vuelve peligroso.
Mukta destacó cuatro principios de producción:
Cada actualización de memoria debe tener un historial.
Los metadatos útiles incluyen:
Las entradas de memoria sin trazabilidad de origen son difíciles de confiar.
Supongamos que un agente añade:
- Las implementaciones de producción del viernes no requieren aprobación.
Sin origen, revisor e historial de revisiones, otro agente podría tratar esa afirmación como autoritativa.
El control de versiones admite:
Un sistema de memoria versionado debería poder responder fácilmente:
¿Qué interacción dio origen a esta regla?
Dos agentes podrían leer la misma memoria a las 10:00.
El agente A escribe una actualización a las 10:02.
El agente B, sin conocer ese cambio, escribe su propia versión a las 10:03 y elimina accidentalmente la actualización del agente A.
Mukta describió un patrón de concurrencia basado en hashes:
El agente lee la memoria y registra el hash A
        ↓
El agente redacta una actualización
        ↓
El agente vuelve a leer la memoria y registra el hash B
        ↓
Si hash A == hash B:
    Enviar la actualización
Si no:
    Recargar, rebasar y reintentar
Esto es control de concurrencia optimista.
El modelo puede decidir qué cambio proponer, pero el marco de control debe evitar de manera determinista que escrituras obsoletas reemplacen versiones más recientes.
No todos los agentes deberían poder editar cada memoria.
Un modelo de permisos razonable podría ser:
| Alcance de la memoria | Acceso típico |
|---|---|
| Principios organizacionales | Solo lectura para la mayoría de agentes; escritura solo mediante proceso de revisión |
| Política de seguridad | Solo lectura para agentes relevantes; escritura restringida con control humano |
| Procesos del equipo | Solo lectura para el equipo; escritura por mantenedores designados |
| Decisiones del proyecto | Solo lectura para agentes del proyecto; ediciones propuestas requieren aprobación |
| Área de borrador del agente | Lectura y escritura para un solo agente |
| Preferencias del usuario | Acceso de agentes con alcance de usuario |
| Contexto sensible del cliente | Acceso estricto basado en roles |
Un agente no debería poder convertir una observación incierta en una regla organizacional.
Los límites de permisos también deben aplicarse a la Consolidación. Las tareas de integración solo pueden recibir registros de conversación y memorias para las que su identidad esté autorizada.
La memoria puede convertirse en uno de los activos de IA más valiosos de una organización.
Contiene:
Mukta cree que los equipos deberían evitar diseñar ese activo para que funcione únicamente dentro de un solo producto.
Un sistema de memoria portátil debería tener:
La portabilidad permite que el mismo contexto cuidadosamente curado respalde:
Incluso las herramientas de memoria bien diseñadas tienen dos limitaciones estructurales.
El agente debe completar la tarea y organizar la memoria al mismo tiempo.
Escribir memoria consume recursos que de otro modo podrían usarse para el objetivo actual.
El agente podría:
Durante una tarea, el agente solo ve su contexto activo.
No puede recorrer todos los registros de conversación pasados.
No puede decidir qué momentos fueron los más fundamentales.
La integración se convierte en un momento separado y estructurado.
Esto lleva a la Consolidación, que examinaremos a continuación.
Restricción 2: El agente solo ve una sesión
Un agente puede notar que un comando falló una vez.
No puede ver que el mismo comando también falló en otras 300 sesiones.
Un agente de soporte puede ver que un cliente está confundido acerca de una política.
No puede ver que la misma confusión aparece repetidamente en toda la región.
Un mecanismo de aprendizaje a nivel de sistema requiere un proceso con visibilidad más amplia.
Ese proceso es lo que Anthropic llama "Soñar" (Dreaming).
Soñar es un proceso asíncrono que revisa el historial de los agentes después de que el trabajo normal se ha completado.
En las notas de la versión actual de la API de Anthropic, la función de "Soñar" para los agentes alojados de Claude se describe como una vista previa de investigación.
Una sesión de "soñar" lee:
Luego crea un almacenamiento de memoria de salida reorganizado, en el que se puede:
Esto no es un reentrenamiento del modelo.
Los pesos del modelo subyacente no cambian.
La mejora proviene de alterar el contexto persistente para que las sesiones futuras puedan recuperar ese contenido.
Mukta usó una escuela para explicar la diferencia entre la memoria normal y "soñar".
Imagina:
Un maestro puede ayudar a un estudiante a corregir un error.
El director académico puede notar que todos los estudiantes de geografía cometen el mismo error en el mismo punto, porque el plan de estudios no incluye ese contenido en absoluto.
La corrección a nivel de sistema no consiste en corregir cada examen individualmente.
Se trata de actualizar el plan de estudios.
Terminología del agente:
Esto permite que el sistema aprenda de patrones que un solo agente no puede percibir.
Un pipeline simplificado del procesamiento de sueños se ve así:
Diagrama de flujo TD
    A[Almacenamiento de memoria existente] --> D[Orquestador de sueños]
    B[Registros de sesiones] --> D
    C[Llamadas a herramientas y metadatos] --> D
    D --> E1[Agente de revisión 1]
    D --> E2[Agente de revisión 2]
    D --> E3[Agente de revisión 3]
    E1 --> F[Aggregador de patrones]
    E2 --> F
    E3 --> F
    F --> G[Cambios de memoria propuestos]
    G --> H{Aprobación humana}
    H -->|Aceptada| I[Almacenamiento de memoria actualizado]
    H -->|Rechazada| J[Conservar memoria existente]
El proceso de revisión puede examinar no solo los mensajes de usuarios y asistentes.
La evidencia útil incluye:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El agente de sueños luego busca patrones como:
Mukta mencionó que el diseño de Anthropic puede incluir ejemplos de registros de sesiones relevantes y estadísticas que muestren la frecuencia con la que ocurre el patrón.
Esta evidencia ayuda a los humanos a juzgar si el cambio de memoria propuesto es razonable.
El procesamiento de sueños tiene acceso amplio y puede afectar el comportamiento futuro de todo el clúster de agentes.
Esto hace que las actualizaciones automáticas y sin revisión sean riesgosas.
Un flujo de trabajo más seguro es:
Por ejemplo:
## Actualización de memoria propuesta

**Objetivo:** `teams/engineering/test-process.md`

**Problema observado:**
Los agentes usaron el comando de pruebas unitarias para ejecutar pruebas de integración en 18 de 63 sesiones relevantes.

**Evidencia:**
Sesiones `s-102`, `s-111`, `s-118`, `s-124`, ...

**Adición propuesta:**
- Usar `npm run test:integration` para todas las pruebas que requieran contenedores de base de datos.
- No usar `npm test` para archivos en `tests/integration/`.

**Confianza:** Alta

**Decisión humana:** Pendiente
Esto conserva la supervisión humana y al mismo tiempo permite que el clúster de agentes realice la mayor parte del análisis.
Soñar requiere llamadas adicionales al modelo.
A primera vista, esto parece un gasto innecesario.
Mukta sostiene que un almacenamiento de memoria más limpio reduce el costo total, porque es más probable que los futuros agentes hagan las cosas bien al primer intento.
El primer intento.
Una comparación económica útil es:
El costo de soñar
en comparación con
el costo de fallas repetidas, reintentos, retrabajo y contextos excesivamente largos
Los ahorros potenciales pueden provenir de:
Anthropic aún no ha publicado un punto de referencia general que indique cuánto puede ahorrar cada organización. El valor específico depende de:
"Soñar" es más probable que dé resultados cuando muchos agentes ejecutan trabajos relacionados y se enfrentan repetidamente a los mismos patrones.
Un equipo no necesita esperar una integración completa de plataforma para probar este concepto.
Una versión manual se puede ejecutar una vez por semana.
Solo recopila registros de conversaciones que los revisores tengan autorización para ver.
Organízalos por:
Incluye:
CLAUDE.mdEl prompt podría ser:
Revisa estos registros de sesiones autorizadas y los archivos de memoria actuales.

Identifica fallas recurrentes, correcciones repetidas de usuarios, instrucciones obsoletas,
procesos faltantes y entradas duplicadas.

Para cada modificación propuesta:
1. Indica el archivo objetivo.
2. Proporciona los ID de sesión de respaldo.
3.

Explica la frecuencia con la que aparece este patrón.
4. Redacta la modificación mínima viable.
5. No edites los archivos directamente.
Rechaza las siguientes modificaciones:
Utiliza control de versiones e incluye la evidencia de la fuente en el registro de confirmación o auditoría.
Realiza un seguimiento para ver si el mismo fallo se reduce en sesiones posteriores.
Sin medición, "soñar" se convierte en un trabajo de generación de documentos, no en un sistema de aprendizaje.
La memoria responde a la pregunta:
¿Qué debería recordar el agente de su trabajo anterior?
La ingeniería de estructuras de grafos responde a una pregunta diferente:
¿Qué partes de la tarea actual dependen realmente entre sí?
El artículo original de BAAI vincula el tema de la memoria con una guía de ingeniería de grafos que circula en la comunidad de desarrollo de IA.
El argumento central de esa guía es que muchos "flujos de trabajo" ya son esencialmente grafos—solo que mal diseñados.
Los flujos de trabajo escritos como listas tienden a convertirse artificialmente en procesos secuenciales:
Investigación
    ↓
Resumen
    ↓
Comparación
    ↓
Verificación de hechos
    ↓
Redacción
Algunos de estos pasos pueden depender realmente de la salida anterior.
Otros pueden estar esperando innecesariamente.
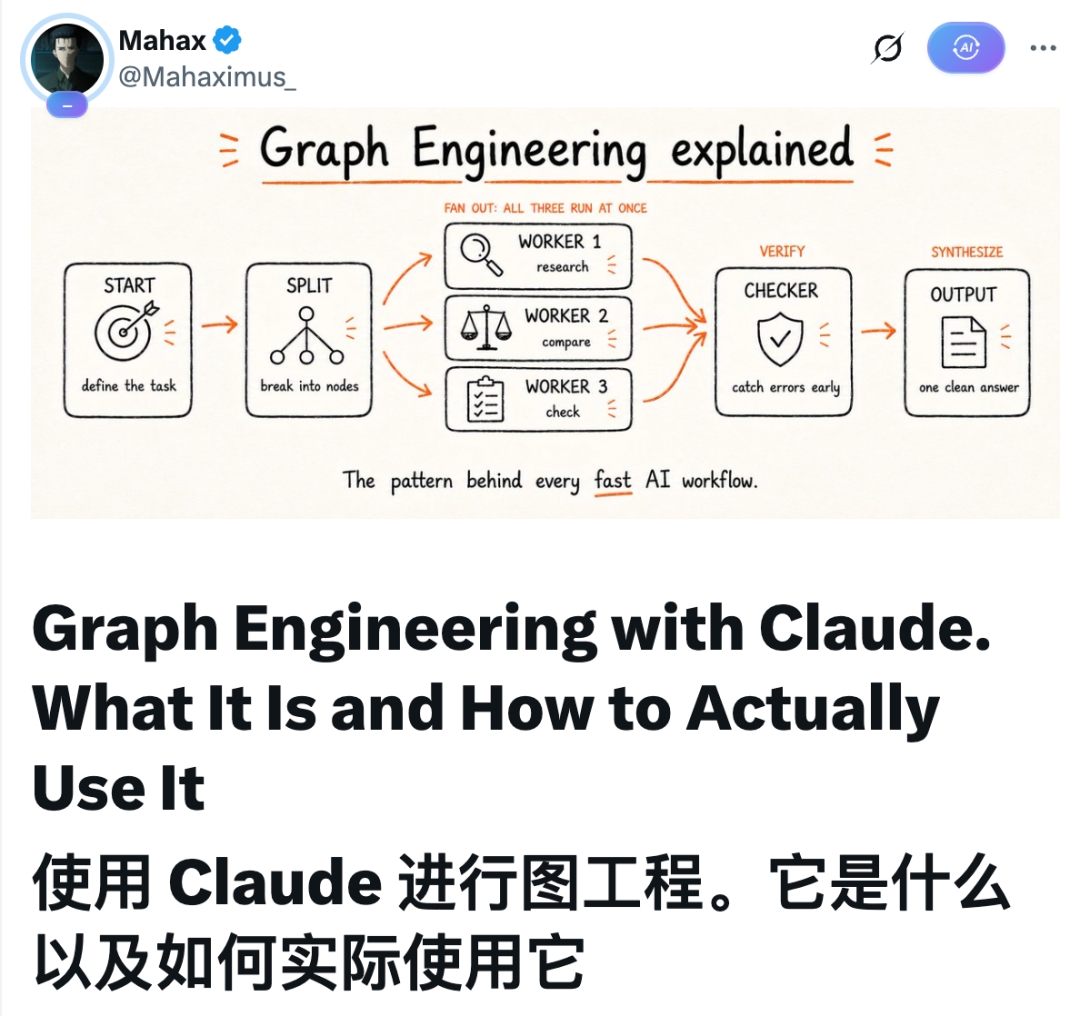
En un grafo de flujo de trabajo:
Por ejemplo:
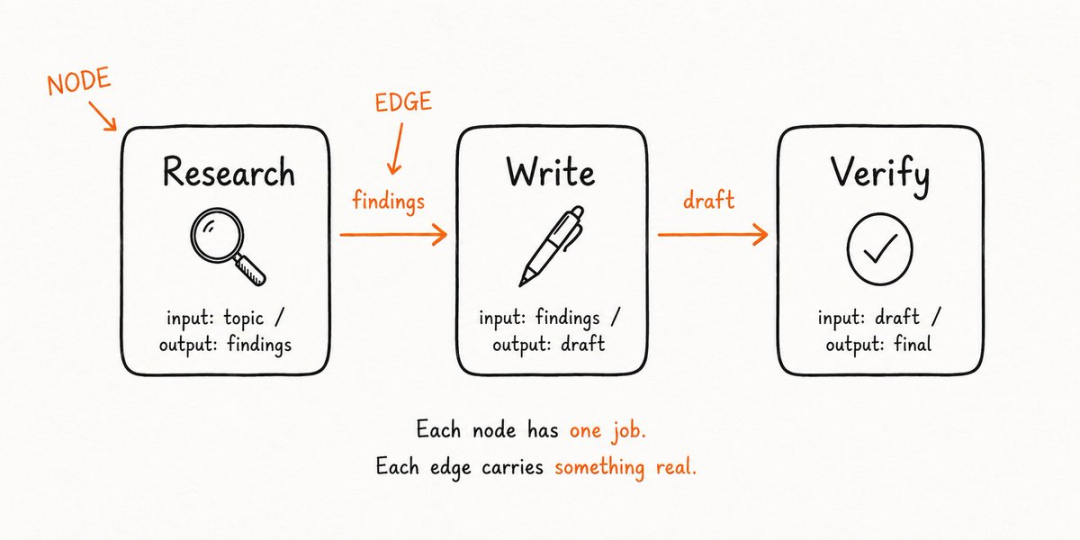
El nodo de investigación produce resultados de investigación.
El nodo de redacción consume esos resultados y produce un borrador.
El nodo de verificación consume el borrador y produce un resultado revisado.
Estas flechas son razonables porque cada nodo posterior necesita la salida del nodo anterior.
La guía comunitaria de grafos propone una prueba sencilla para cada flecha:
¿La siguiente tarea realmente necesita la salida de la tarea anterior?
Si la respuesta es no, entonces esa dependencia es falsa.
Considera el siguiente flujo de trabajo:
Investigar competidor A
    ↓
Investigar competidor B
    ↓
Investigar competidor C
    ↓
Redactar informe comparativo
Investigar al competidor B normalmente no necesita la salida de investigar al competidor A.
Investigar al competidor C normalmente no necesita la salida de investigar al competidor B.
Estas tareas pueden ejecutarse en paralelo:
flowchart TD
    A[Definir criterios de comparación] --> B1[Investigar competidor A]
    A --> B2[Investigar competidor B]
    A --> B3[Investigar competidor C]
    B1 --> C[Redactar informe comparativo]
    B2 --> C
    B3 --> C
Eliminar bordes falsos reduce el tiempo de espera.
Si las tres tareas de investigación toman 10, 12 y 15 minutos respectivamente:
El grafo no hace que ningún agente individual sea más rápido.
Lo que cambia es la programación.
Una vez eliminados los bordes falsos, aparece una forma común:
Esto se conoce comúnmente como diamante.
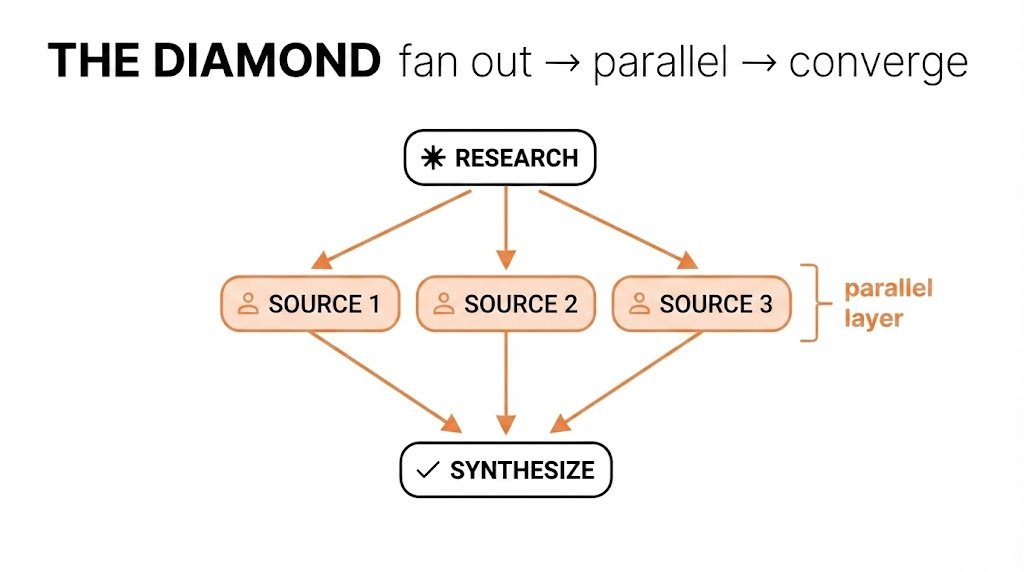
Un ejemplo de investigación podría verse así:
flowchart TD
    A[Pregunta de investigación] --> B1[Datos de mercado]
    A --> B2[Evidencia de clientes]
    A --> B3[Análisis de competidores]
    B1 --> C[Verificador]
    B2 --> C
    B3 --> C
    C --> D[Síntesis final]
El tiempo total está determinado principalmente por la rama más lenta, no por la suma de todas las ramas.
El paralelismo introduce un nuevo riesgo.
Un hilo de trabajo puede producir resultados débiles, desactualizados o sin respaldo.
Si el sistema combina todo sin verificación, una sola rama defectuosa puede contaminar la respuesta final.
Por lo tanto, la guía de grafos coloca un verificador antes de la síntesis.
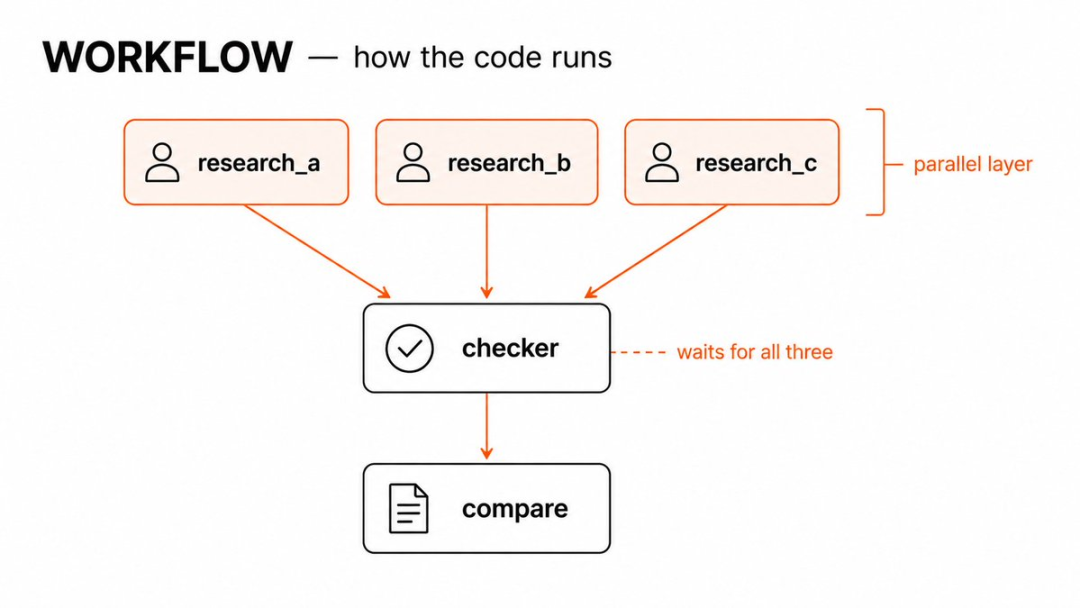
Un verificador puede preguntar:
¿El resultado cumple con el formato requerido?
Un verificador útil debe tener criterios de aceptación claros.
Por ejemplo:
Empieza con una sola frase y obtén un sitio completo en minutos.



