La competencia de modelos de vanguardia en China está entrando en la era de los billones de parámetros. El Qwen3.8-Max de Alibaba ya alcanza...
La competencia de modelos de vanguardia en China está entrando de lleno en la era de los billones de parámetros.
El Qwen3.8-Max de Alibaba ha alcanzado 2,4 billones de parámetros, mientras que el Kimi K3 de Moonshot AI ha elevado la escala divulgada públicamente a 2,8 billones de parámetros.
ByteDance podría estar preparando el próximo salto.
AIBase, citando un informe de LatePost, informó que ByteDance está discutiendo el entrenamiento de un modelo fundacional con más de 5 billones de parámetros el 7 de agosto de 2026. Según el informe, el proyecto se encuentra aún en una fase temprana y no hay garantía de que el modelo final llegue a publicarse.
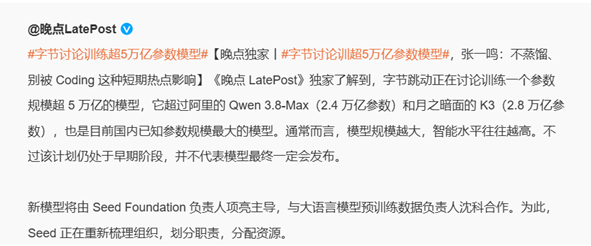
Solo por su escala, este proyecto se convertiría en uno de los proyectos de modelos de IA de mayor magnitud jamás reportados públicamente en China.
Sin embargo, ese mismo día hubo una actualización importante.
En la noche del 7 de agosto, Reuters, citando al Financial Times británico y a personas cercanas al asunto, informó que ByteDance está entrenando un modelo de hasta 10 billones de parámetros, y que el modelo ya ha entrado en la fase de preentrenamiento. ByteDance no había respondido públicamente a este informe en ese momento.
Estos dos informes no son necesariamente contradictorios. Un proyecto inicialmente discutido como de "más de 5 billones" podría terminar apuntando a una configuración mayor. Pero dado que ByteDance no ha revelado oficialmente la arquitectura del modelo ni el número de parámetros, todas las cifras en este artículo deben considerarse como planes reportados, no como especificaciones confirmadas del modelo.
El informe original de LatePost afirma que ByteDance está discutiendo un modelo con más de 5 billones de parámetros.
Esto lo situaría muy por encima de las escalas ya divulgadas por varios modelos de vanguardia chinos.
| Modelo | Parámetros totales reportados públicamente | Estado |
|---|---|---|
| Qwen3.8-Max | 2,4 billones | Publicado por Alibaba |
| Kimi K3 | 2,8 billones | Publicado por Moonshot AI |
| Modelo de ByteDance según informe | Más de 5 billones | Plan reportado |
| Dato posterior de FT/Reuters | Hasta 10 billones | Reportado, sin confirmación oficial |
Moonshot AI describió oficialmente al Kimi K3 como un modelo de mezcla de expertos con 2,8 billones de parámetros, con 104 mil millones de parámetros activados por token.
Reuters informó el 3 de agosto que el Qwen3.8-Max de Alibaba contiene 2,4 billones de parámetros totales.
Si ByteDance finalmente entrena e implementa un modelo de entre 5 y 10 billones de parámetros, esto representaría un aumento significativo en la escala total del modelo.
Pero eso no significa automáticamente que las capacidades del modelo sean dos o tres veces mayores.
Las fuentes de AIBase describen el modelo de 5 billones de parámetros como perteneciente a la misma categoría de magnitud que los sistemas de vanguardia líderes de Estados Unidos, como GPT-5.6 o los últimos modelos de gama alta de Anthropic.
Esta comparación requiere un importante matiz.
OpenAI y Anthropic no han divulgado públicamente el número exacto de parámetros de GPT-5.6, Claude Fable 5 o Claude Mythos 5.
Reuters planteó el mismo punto en su informe del 7 de agosto: la comparación directa de escala con los sistemas líderes de Estados Unidos es difícil porque esos laboratorios no publican el número de parámetros de sus modelos.
El número de parámetros es solo una dimensión para medir las capacidades de un modelo.
El rendimiento también depende de:
Esto es especialmente importante para los modelos de mezcla de expertos.
Un modelo MoE disperso puede contener billones de parámetros totales, pero solo activar un subconjunto muy pequeño de ellos por cada token.
Kimi K3 es un buen ejemplo.
Sus especificaciones oficiales indican:
Por lo tanto, el número total de pesos no es lo mismo que la cantidad de cómputo utilizado en cada paso de inferencia.
ByteDance no ha revelado públicamente si el modelo reportado utiliza una arquitectura dispersa similar, ni cuántos parámetros se activarían por token.
El informe original utiliza las GPU NVIDIA H100 como ejemplo para ilustrar la escala.
Sus estimaciones sugieren que entrenar un modelo de 5 billones de parámetros requeriría aproximadamente:
Ambos escenarios arrojan un tiempo total de aceleradores del mismo orden de magnitud:
| Escenario | Número de GPU | Duración | GPU-días aproximados |
|---|---|---|---|
| Clúster de larga duración | 100.000 | 347 días | 34,7 millones |
| Clúster masivo de corta duración | 1.000.000 | 35 días | 35 millones |
Estas cifras deben entenderse como estimaciones aproximadas de escenarios provenientes de fuentes, no como una fórmula de ingeniería universal.
Los requisitos reales de entrenamiento dependen en gran medida de:
Las especificaciones oficiales de NVIDIA para la H100 indican que la versión SXM tiene un TDP de hasta 700W y soporta entrenamiento de transformers a gran escala mediante el Transformer Engine de Hopper y la infraestructura NVLink.
A la escala de cientos de miles de aceleradores, solo el clúster de GPU alcanza una magnitud donde la energía, la red, la refrigeración y la capacidad del centro de datos se convierten en restricciones primordiales.
Las fuentes de AIBase señalan correctamente que ejecutar 1 millón de aceleradores de nivel H100 simultáneamente sería una configuración de infraestructura extrema.
Un proyecto más realista probablemente distribuiría el entrenamiento en un clúster más pequeño, aunque aún enorme.
Las fuentes sugieren un enfoque más cercano a:
Esto seguiría siendo uno de los clústeres de entrenamiento más grandes jamás construidos.
Uno de los proyectos de entrenamiento de modelos más ambiciosos en la historia de la humanidad.
Y el preentrenamiento es solo una fase.
Un modelo de vanguardia también requiere tiempo y cómputo para completar los siguientes pasos:
Por lo tanto, el artículo original de AIBase estima que todo el proceso tomaría al menos medio año, y que el tiempo total podría acercarse a un año antes de que un modelo maduro vea la luz.
El informe posterior del Financial Times (resumido por Reuters) afirma que el modelo ya ha entrado en la fase de preentrenamiento, señalando que esta fase suele durar aproximadamente de tres a seis meses, antes de pasar a las etapas de ajuste fino y publicación.
Ambas descripciones apuntan a la misma conclusión práctica: un proyecto de esta escala es un proyecto de infraestructura a largo plazo, no un modelo que aparece inmediatamente después de que el primer clúster de entrenamiento se ponga en línea.
El entrenamiento a esta escala no es solo un problema de investigación.
Es también un problema de infraestructura y capital.
ByteDance es una de las pocas empresas tecnológicas chinas con la capacidad financiera, el canal de distribución al consumidor, la infraestructura en la nube, la capacidad de centros de datos y el equipo de ingeniería de IA necesarios para intentar seriamente un proyecto de esta magnitud.
La organización oficial Seed de esta empresa ha cubierto los siguientes ámbitos:
El equipo de infraestructura de ByteDance describe explícitamente su trabajo como centrado en entrenamiento distribuido, sistemas de aprendizaje por refuerzo, inferencia de alto rendimiento y tecnologías de compilación orientadas a modelos fundacionales.
Sus materiales de contratación también mencionan explícitamente las siguientes tareas:
Estos son precisamente los problemas de ingeniería de sistemas que se vuelven críticos al entrenar modelos con billones de parámetros.
AIBase también citó estimaciones de terceros sobre la escala de cómputo de IA disponible en varios laboratorios de vanguardia.
Las cifras aproximadas mencionadas en el artículo son:
Estas cifras no deben considerarse datos de inventario auditados.
OpenAI y Anthropic no publican en tiempo real la cantidad total de aceleradores disponibles en sus propias instalaciones, socios de nube y capacidad reservada.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La cifra de aproximadamente 60,000 aceleradores para DeepSeek se originó inicialmente en una estimación de SemiAnalysis y desde entonces se ha citado ampliamente en varios informes. Estas estimaciones incluyen una combinación heterogénea de aceleradores como A100, H100, H800 y H20, no una flota de un solo tipo.
Más fiable que cualquier cifra de inventario exacta es el punto clave a gran escala:
El desarrollo de modelos de vanguardia depende cada vez más del acceso a potencia de cómputo de aceleradores a escala masiva, y a medida que los modelos siguen creciendo, la brecha entre las empresas con infraestructura a escala ultra grande y los laboratorios más pequeños puede volverse muy pronunciada.
Disparándose a billones de parámetros.
Usar cómputo equivalente a H100 facilita la comprensión de las discusiones sobre cómputo, pero ByteDance no necesariamente dependerá de un solo tipo de acelerador.
Las grandes empresas de IA pueden combinar:
Los aceleradores más nuevos pueden cambiar la cantidad física de GPU necesaria para completar la misma cantidad de cómputo de entrenamiento.
El software es igualmente importante.
Las mejoras en:
Pueden alterar significativamente la relación entre el tamaño total del modelo y el costo de entrenamiento.
Por lo tanto, "el modelo X requiere exactamente Y GPU" siempre debe considerarse como una hipótesis de escenario, no como una regla fija.
La fuente enmarca principalmente el plan como un intento de llevar el nivel de inteligencia de Doubao a la vanguardia global.
Esto probablemente sea solo parte de la motivación.
Un modelo fundacional más grande podría respaldar múltiples partes del ecosistema de IA de ByteDance.
Doubao es uno de los principales productos de IA orientados al consumidor de ByteDance en el mercado chino.
Un modelo base más fuerte puede mejorar:
Los modelos a escala ultra grande también proporcionarán a el equipo Seed una nueva plataforma de investigación para explorar:
ByteDance también puede comercializar las capacidades del modelo a través de servicios empresariales y de nube.
Por lo tanto, un modelo de vanguardia tiene valor potencial más allá de los chatbots orientados al consumidor.
La última pregunta en el artículo de AIBase es la más crítica.
¿Puede un modelo con un costo de entrenamiento extremadamente alto generar retornos proporcionales?
Los laboratorios de vanguardia no solo tienen que pagar por la ejecución final del entrenamiento.
El gasto total puede incluir:
Luego, el modelo debe crear valor mediante alguna combinación de:
La escala de parámetros solo tiene sentido económico si se traduce en capacidades útiles a un costo de inferencia aceptable.
Es por eso que la generación actual de modelos de vanguardia enfatiza cada vez más la eficiencia de escalado, no solo el número total de parámetros.
Por ejemplo, Kimi K3 tiene 2.8 billones de parámetros totales, pero solo activa 104 mil millones por token. Moonshot AI indica que su arquitectura ha mejorado en eficiencia de escalado en comparación con la generación anterior.
Por lo tanto, la competencia real no es:
¿Quién tiene más parámetros?
Sino más bien:
¿Quién puede transformar la mayor capacidad con los menores recursos?

¿Convertirse en la inteligencia más útil con costos de entrenamiento e inferencia sostenibles?
AIBase citó a LatePost informando que ByteDance está discutiendo un modelo de más de 5 billones de parámetros. Más tarde ese mismo día, Reuters citó al Financial Times informando que ByteDance ya está preentrenando un modelo que podría llegar hasta 10 billones de parámetros. ByteDance no ha confirmado públicamente las cifras exactas.
Las fuentes esperan que el modelo fortalezca el ecosistema de Doubao de ByteDance, pero ByteDance aún no ha anunciado oficialmente cómo se implementará el modelo mencionado en el informe. El modelo de vanguardia también podría respaldar API empresariales, agentes, investigación y otros productos de ByteDance.
No necesariamente. El número total de parámetros no determina directamente la calidad del modelo. La arquitectura, los parámetros activos, los datos de entrenamiento, el post-entrenamiento, el aprendizaje por refuerzo, el razonamiento en tiempo de inferencia y el uso de herramientas pueden ser igualmente importantes.
Moonshot AI anunció oficialmente que Kimi K3 tiene 2.8 billones de parámetros totales y 104 mil millones de parámetros activos. Utiliza una arquitectura de mezcla dispersa de expertos (MoE).
Según informes de Alibaba y Reuters, Qwen3.8-Max de Alibaba tiene 2.4 billones de parámetros totales. También se basa en un diseño de modelo disperso, no activa todos los parámetros para cada token.
La fuente proporciona un escenario aproximado, equivalente a unos 35 millones de GPU H100·día, por ejemplo, 100,000 H100 ejecutándose durante 347 días, o 1 millón de H100 ejecutándose durante unos 35 días. Los requisitos reales pueden variar considerablemente según la arquitectura, la precisión, la utilización, el número de tokens, el hardware y la eficiencia del entrenamiento.
OpenAI no ha divulgado públicamente el número de parámetros de GPT-5.6. Cualquier afirmación sobre el número de parámetros de GPT-5.6
Las comparaciones numéricas directas con un modelo determinado son...
Según informes, un modelo de ByteDance sigue siendo, por ahora, especulativo.
Hasta ahora no se ha anunciado una fecha oficial de lanzamiento. Reuters, basándose en un informe del Financial Times, indicó que el modelo se encuentra en fase de preentrenamiento, una etapa que podría llevar varios meses antes de que se pueda proceder al ajuste fino, la evaluación y el despliegue.
Según informes, ByteDance está preparando un modelo fundacional a escala masiva, mayor que cualquier modelo chino divulgado públicamente hasta la fecha. AIBase y LatePost inicialmente describieron el proyecto como de más de 5 billones de parámetros, mientras que informes posteriores de Reuters/Financial Times del mismo día indicaron que el modelo podría alcanzar los 10 billones de parámetros y encontrarse ya en fase de preentrenamiento.
Un proyecto de esta magnitud requerirá recursos computacionales enormes. Las fuentes citan, por ejemplo, que la computación H100 necesaria equivaldría aproximadamente a 35 millones de días de GPU, aunque los requisitos reales de entrenamiento dependen de la arquitectura, los parámetros activos, la generación del hardware, la utilización y la eficiencia del entrenamiento.
La cuestión más importante no es si ByteDance puede construir el modelo más grande. El número total de parámetros es una métrica incompleta de inteligencia, especialmente en sistemas de mezcla dispersa de expertos.
La verdadera prueba está en
si ByteDance puede convertir esa computación a escala de billones en un modelo que sea significativamente superior en rendimiento, lo bastante eficiente como para sostener el servicio, y con el valor suficiente para justificar la infraestructura que lo respalda.
Empieza con una sola frase y obtén un sitio completo en minutos.



