For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/claude-code-language-migration-workflow-anthropic.md.
Cambiar el lenguaje principal de una base de código madura y en producción solía ser el tipo de proyecto que los equipos posponían durante a...
Cambiar el lenguaje principal de una base de código de producción madura solía ser el tipo de proyecto que los equipos posponían durante años. Este trabajo es costoso, riesgoso y difícil de estimar. Una migración podía consumir varios trimestres de ingeniería, durante los cuales las dos implementaciones se distanciaban cada vez más, logrando al final solo una consistencia de comportamiento incompleta.
Un proyecto interno reciente de Anthropic demuestra que esta situación está empezando a cambiar.
En julio de 2026, Anthropic publicó un informe práctico detallando cómo sus desarrolladores utilizaron Claude Code, Claude Fable 5, Claude Opus 4.8 y un flujo de trabajo multiagente dinámico para migrar diez paquetes de código en aproximadamente un mes. Estos paquetes variaban desde decenas de miles hasta cientos de miles de líneas de código.
Dos casos destacaron especialmente:
La revelación importante no es que un modelo de IA pueda traducir archivos rápidamente, sino que un sistema de migración bien diseñado puede generar, revisar, probar, rechazar y regenerar código repetidamente con mínima intervención humana.
Anthropic resume su filosofía así: el trabajo principal del desarrollador no es corregir manualmente cada error generado, sino mejorar el proceso que produce esos errores.
Bun es un conjunto de herramientas integral para JavaScript y TypeScript que incluye un runtime, gestor de paquetes, bundler, ejecutor de pruebas y otras herramientas de desarrollo. Su implementación original dependía en gran medida de Zig e integraba una gran cantidad de código C y C++.
Jarred Sumner utilizó aproximadamente 50 flujos de trabajo dinámicos de Claude Code en 11 días para completar la migración a Rust. El pull request fusionado contenía más de un millón de líneas de código nuevo y miles de commits.
Antes de la fusión, el conjunto de pruebas de integración continua existente de Bun pasó en todas las plataformas compatibles. Anthropic informó posteriormente que aparecieron 19 regresiones después de la fusión, que fueron corregidas posteriormente.
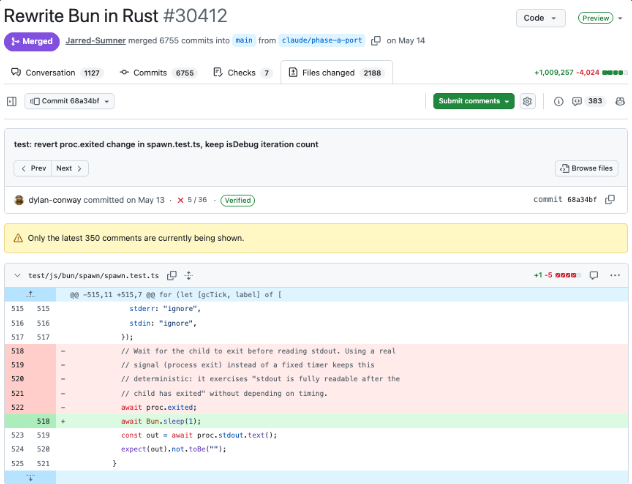
Esta migración no fue un rediseño desde cero. El objetivo era mantener la arquitectura y el comportamiento existentes de Bun mientras se reemplazaba el lenguaje de implementación. Esto redujo las variables simultáneas: el proyecto podía centrarse en la semántica del lenguaje, la propiedad, la seguridad de memoria y la compatibilidad, en lugar de reconstruir el producto desde cero.
El informe oficial de Bun explica por qué Rust resultaba atractivo. Muchos problemas recurrentes de estabilidad involucraban gestión del ciclo de vida, rutas de limpieza omitidas, uso después de liberación, condiciones de carrera y riesgos de doble liberación. En Rust seguro, muchos de estos problemas se convierten en errores en tiempo de compilación, en lugar de descubrirse mediante fallos en producción, fuzzing o revisión manual.
El proyecto de Mike Krieger siguió un camino diferente. Esta migración no conservó la estructura de archivos original tanto como fue posible, sino que implicó un rediseño arquitectónico más amplio.
El resultado fue la generación de aproximadamente 165,000 líneas de código TypeScript en un fin de semana. Según se informa, el proceso utilizó:
La razón de negocio era clara. Esta herramienta interna basada en Python se distribuía como un único binario, pero generarlo requería aproximadamente ocho minutos por plataforma, y unos 30 minutos para toda la matriz de lanzamiento.
Después de la migración, la compilación tomaba aproximadamente dos segundos, la velocidad de inicio mejoró seis veces y el equipo pudo eliminar una canalización de despliegue independiente.
La migración de lenguajes aún requiere una razón genuina de ingeniería o negocio. Una generación de código más rápida no justifica cada reescritura.
Los equipos suelen reconsiderar la elección del lenguaje cuando el entorno ha cambiado desde la creación del sistema. Los desencadenantes típicos incluyen:
La elección inicial de Zig para Bun tenía sentido: para un fundador que construía un runtime extremadamente amplio por su cuenta antes de la aparición de agentes de codificación contemporáneos, este lenguaje ofrecía control de bajo nivel que ayudó a Jarred Sumner a avanzar rápidamente.
Años después, Bun se ha convertido en una herramienta de producción ampliamente utilizada con una superficie de mantenimiento mucho mayor. El costo de los defectos recurrentes relacionados con la memoria aumentó, y Claude Code hizo que el trasplante mecánico fuera lo suficientemente viable como para probarlo.
Por lo tanto, la decisión no fue "Zig es malo y Rust es bueno", sino que la escala actual de Bun, las necesidades operativas y las herramientas disponibles han cambiado las compensaciones.
Las migraciones de lenguaje asistidas por IA aún pueden ser costosas.
Anthropic informa que el proyecto Bun consumió aproximadamente:
| Categoría de uso | Cantidad reportada |
|---|---|
| Tokens de entrada no cacheados | 5.9 mil millones |
| Tokens de salida | 690 millones |
| Equivalente estimado de precio de API | Aproximadamente $165,000 USD |
La parte principal de la migración de Python a TypeScript de Mike Krieger utilizó aproximadamente 27 millones de tokens.
Estas cifras son muy inferiores al costo de ingeniería de las migraciones tradicionales de varios años, pero no son insignificantes. Los equipos también deben considerar:
La reducción de costos hace que más proyectos sean financieramente viables, pero no elimina la necesidad de un caso de negocio.
Las migraciones grandes de lenguajes tienen múltiples características que las hacen especialmente adecuadas para trabajar con agentes de codificación colaborativos.
Las migraciones suelen involucrar cientos o miles de archivos, módulos, paquetes o bibliotecas que, una vez entendidas sus dependencias, pueden procesarse de forma independiente.
Los agentes pueden traducir unidades independientes en paralelo, en lugar de esperar un único flujo de implementación central. El desafío pasa de la velocidad de escritura a la orquestación, consistencia y verificación.
Muchas tareas de software comienzan con requisitos incompletos. Las migraciones de lenguaje tienen un punto de partida mucho más sólido: la implementación original.
El código fuente existente define flujos de control, estructuras de datos, casos límite, comportamiento de errores, API públicas y manejo específico de plataforma. Cuando las reglas de migración no son claras, los agentes pueden consultar la referencia original en cualquier momento.
Los agentes funcionan mejor cuando el éxito o fracaso se puede verificar mecánicamente.
Los compiladores, conjuntos de pruebas, scripts de consistencia, benchmarks o comparaciones deterministas de salidas proporcionan una única fuente de verdad para el flujo de trabajo. El sistema no necesita preguntar a un revisor si la nueva implementación "se ve correcta"; compara repetidamente el comportamiento con la implementación original para verificar consistencia.
Los errores de compilador, fallos, fallos de pruebas y diferencias de salida describen naturalmente el trabajo restante.
El sistema de migración no necesita que los humanos creen tickets uno por uno.
Cada elemento de verificación fallido se puede clasificar y asignar a un agente de corrección.
Cuando el mismo problema aparece en varios archivos, repararlos manualmente uno por uno no es la forma correcta de abordarlo.
Una mejor solución es actualizar la regla de migración que causa el error y luego regenerar únicamente las unidades afectadas. Esto convierte un defecto encontrado en una mejora permanente del proceso.
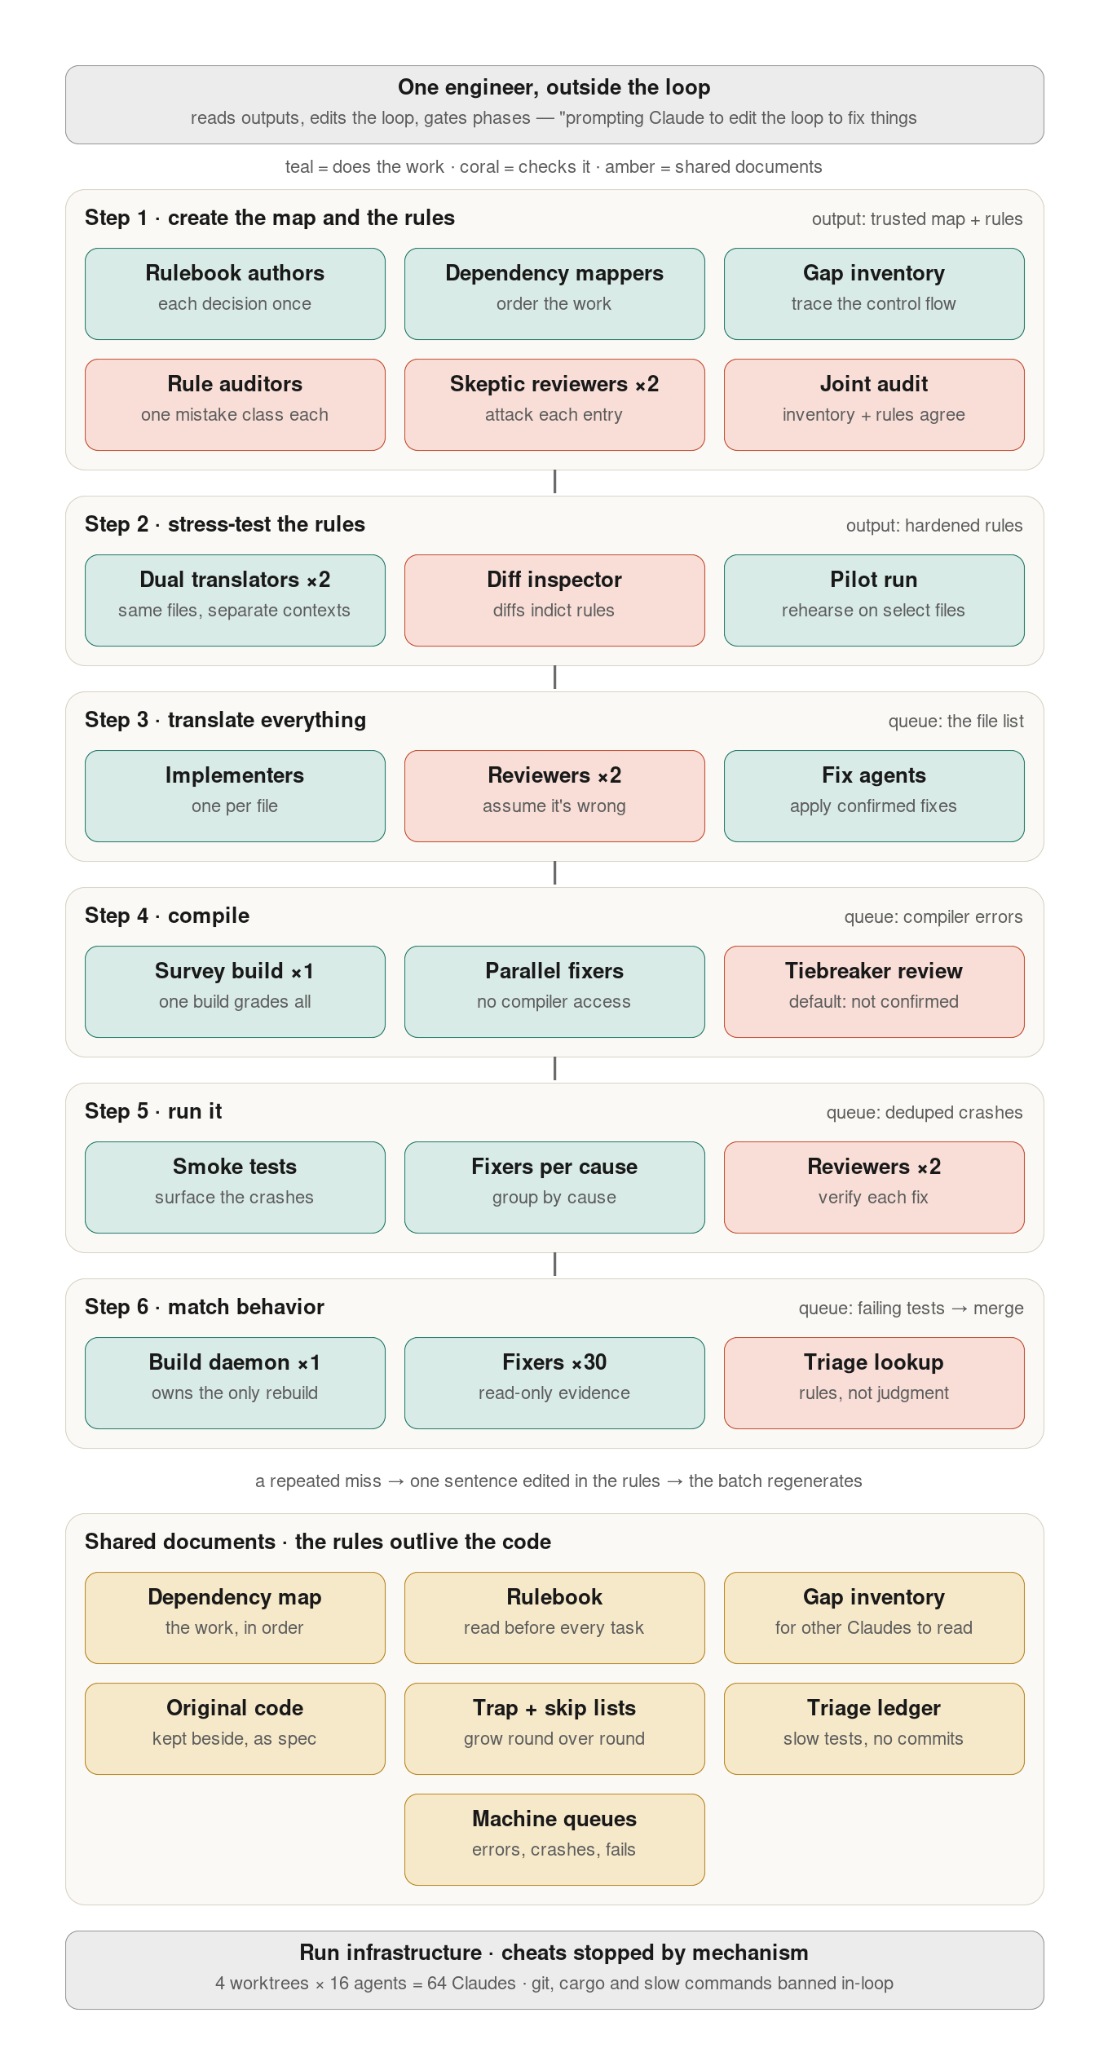
Antes de traducir el código de producción, es necesario crear un sistema de verificación que pueda evaluar la implementación nueva y la antigua en igualdad de condiciones.
Sin un juez confiable, el proyecto no tiene una definición creíble de finalización.
Los conjuntos de pruebas escritos en el lenguaje fuente pueden depender de funciones privadas, clases internas o detalles de implementación que no existen en el lenguaje destino. Estas pruebas no siempre se pueden migrar directamente.
Anthropic sugiere preparar el sistema de juez en tres fases.
Distinguir las pruebas que expresan comportamiento externo de aquellas que dependen de detalles de implementación internos.
Las pruebas externas suelen involucrar comportamiento de línea de comandos, API públicas, archivos, red, salida observable o escenarios completos de aplicación. Estos contenidos son más portables entre diferentes lenguajes.
Convertir las pruebas orientadas al comportamiento en aserciones que puedan ejecutarse en ambas versiones.
Utilizar revisores adversariales independientes para asegurar que las pruebas reescritas no sean más débiles que la versión original. Las pruebas que son más fáciles de pasar pueden ocultar problemas de compatibilidad.
Ejecutar el sistema de juicio en la implementación original y confirmar que pasa.
Luego, romper intencionalmente el programa y confirmar que el sistema de juicio falla. Si un sistema de verificación no puede detectar defectos conocidos, no está preparado para supervisar la migración.
Mike Krieger no comenzó desde cero para construir un conjunto de pruebas completamente portátil. Su equipo creó un marco de pruebas de consistencia que cubría siete escenarios reales y consideraba cualquier diferencia entre Python y TypeScript como un defecto.
El primer paso sienta las bases que utilizarán todos los agentes posteriores.
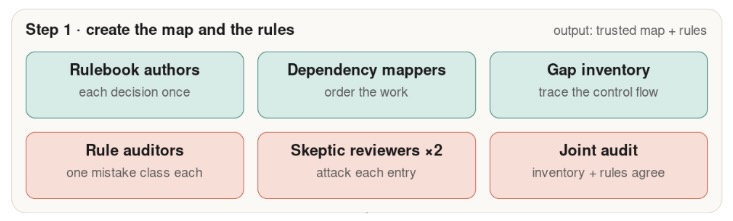
El libro de reglas describe cómo se debe mapear el lenguaje fuente al lenguaje destino.
Su forma depende de la estrategia de migración.
Para migraciones que preservan la estructura, el libro de reglas puede incluir:
Para rediseños, el libro de reglas se parece más a un documento de arquitectura. Define los límites de nuevos componentes, interfaces, contratos de datos y decisiones de diseño que los agentes de implementación deben seguir.
El orden es importante. El libro de reglas debe escribirse antes que el inventario de brechas, porque el inventario de brechas registra todo lo que las reglas predeterminadas no pueden manejar de manera segura.
El trabajo en paralelo solo es seguro cuando el flujo de trabajo comprende qué unidades dependen entre sí.
El mapa de dependencias ayuda a determinar:
Algunos lenguajes exponen información de dependencias a través de manifiestos de paquetes o metadatos de módulos. Los sistemas más antiguos en C, C++ y Python pueden requerir scripts de análisis deterministas para descubrir el gráfico de dependencias.
Claude Code puede ayudar a crear y ejecutar ese script, pero el gráfico generado debe obtenerse por medios mecánicos, no solo adivinando a partir de la salida del modelo.
El inventario de brechas captura las diferencias que no se pueden manejar mediante traducción directa.
Para una migración de Zig a Rust, las brechas importantes incluyen la propiedad y el ciclo de vida de la memoria. Zig permite que algunas responsabilidades de limpieza se comuniquen mediante convenciones o anotaciones, mientras que Rust requiere que las restricciones de propiedad se expresen en el sistema de tipos.
Para un trabajo de migración de Python a TypeScript, la definición de interfaces es una brecha importante. Python a menudo acepta objetos basándose en el comportamiento en tiempo de ejecución, mientras que TypeScript requiere contratos explícitos antes de que el código se compile de manera segura.
El inventario debe considerarse un artefacto que se actualiza dinámicamente. Durante el proceso de traducción, compilación y pruebas de consistencia, surgen continuamente nuevas brechas.
No apliques el nuevo libro de reglas de inmediato a miles de archivos.
Primero, realiza una migración pequeña y luego descarta deliberadamente los resultados.
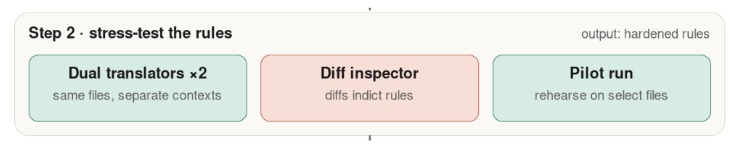
Para Bun, la prueba involucró una pequeña cantidad de archivos:
Antes de aplicarlo realmente a los 1,448 archivos de Zig, este trabajo expuso dos problemas graves.
Las migraciones que mantienen la estructura sin cambios hacen que esta comparación sea relativamente fácil, ya que las dos implementaciones del mismo archivo se pueden revisar en paralelo.
Para rediseños, las pruebas de estrés deben orientarse al documento de arquitectura. Los agentes adversariales pueden atacar sus suposiciones, y luego se realiza una ejecución de extremo a extremo desechable para exponer interfaces faltantes y órdenes poco realistas.
El objetivo es mejorar el libro de reglas, no acumular código de producción. Una vez que se capturan las debilidades, se descartan los archivos generados.
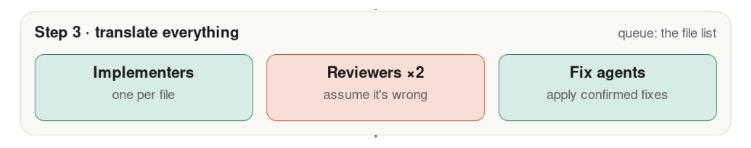
Una vez que las reglas han superado las pruebas de estrés, el trabajo de traducción puede expandirse a todo el repositorio.
com/cms-assets/image/2026/07/26354d74-9a83-4821-b425-a17b95bb4e0e-677c6dd7-8531-47f9-93ce-bf7d7df38679.jpeg)
Anthropic describe un ciclo repetitivo que involucra tres roles:
La implementación a menudo puede realizarse con modelos más pequeños y económicos. Los modelos más potentes deben reservarse para los revisores, los redactores de reglas, las decisiones arquitectónicas y las disputas que requieren un juicio más amplio.
Los scripts por lotes deben determinar qué está completo revisando el sistema de archivos u otro estado determinista.
Por ejemplo, un archivo fuente puede considerarse traducido cuando su archivo destino correspondiente existe en el directorio esperado y ha pasado las puertas de revisión requeridas.
Reconstruir la cola desde el disco hace que el proceso sea reanudable. Si un agente se detiene, la máquina se reinicia o un lote falla, el orquestador puede reconstruir el trabajo restante sin depender de la memoria volátil de la conversación.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Cuando el agente implementador no pueda completar una traducción con confianza, debe dejar una marca buscable, como por ejemplo:
TODO(port): Explicar por qué esta parte necesita manejo manual o procesamiento posterior
La forma específica de la marca puede variar, pero debe incluir el motivo. Esto crea una cola estructurada para las fases de compilación y reparación.
El agente implementador no debe revisarse a sí mismo.
Anthropic y Bun emplearon una revisión adversaria en ventanas de contexto independientes. El revisor recibe el código modificado y se le indica que asuma que la implementación contiene defectos.
Dos revisores pueden examinar el mismo lote de forma independiente. Si sus conclusiones entran en conflicto, un tercer agente puede resolver la disputa.
Esta separación reduce la tendencia del agente de escritura a defender sus propias elecciones y hace que la ejecución autónoma prolongada sea más fiable.
Cuando un revisor encuentra el mismo defecto repetidamente, se debe actualizar el manual de reglas y regenerar los lotes afectados.
Parchear manualmente cientos de archivos generados genera inconsistencias y permite que el modo de fallo original persista. Corregir las reglas de generación evita que el problema se reproduzca en lotes posteriores.
Las tres últimas fases comparten el mismo ciclo básico: generar fallos objetivos, clasificar, asignar un reparador, revisar la reparación y repetir.
La compilación convierte los errores a nivel de lenguaje en una cola determinista.
Que la compilación forme parte de cada ciclo de traducción depende del costo.
El compilador de TypeScript de Mike Krieger puede revisar una unidad en segundos, por lo que se ejecuta con frecuencia durante la implementación. La compilación de Rust de Bun toma más tiempo, por lo que Jarred Sumner mantiene Cargo fuera del bucle de traducción a nivel de archivo y compila lotes más grandes por separado.
Para compilaciones costosas, use un orquestador único o un daemon de compilación. El agente reparador escribe parches y solo permite que el daemon reconstruya. Esto evita que decenas de agentes inicien la misma operación costosa simultáneamente.
Los fallos del compilador a nivel de sistema merecen atención especial. Miles de errores similares pueden indicar una regla de dependencia faltante, una política incorrecta de límites de módulos o un mapeo de lenguajes problemático, no miles de fallos no relacionados.
Una vez que el código compila, ejecute las pruebas mínimas que revelen fallos graves y errores de tiempo de ejecución.
Los resultados de las pruebas de humo proporcionan otra fuente de verdad mecánica. Agrupe los fallos por causa raíz, en lugar de asignar un agente a cada mensaje de error sin análisis.
Las categorías útiles pueden incluir:
Los revisores adversarios deben examinar las soluciones de causa raíz propuestas, especialmente cuando un solo cambio afecta a múltiples archivos.
La última fase consiste en comparar el nuevo programa con el original.
Ejecute un conjunto de pruebas portátil o un marco de verificación de equivalencia en ambas implementaciones. Cualquier diferencia inexplicable debe considerarse un defecto de migración, a menos que el equipo la acepte intencionalmente como un cambio de producto.
El agente reparador puede examinar:
Para procesos de reconstrucción largos, use un daemon de compilación que procese parches en lotes, compile de una vez, solo vuelva a ejecutar las pruebas afectadas y devuelva los resultados a la cola.
Cuando el mismo patrón de fallo aparece en múltiples pruebas, las medidas correctivas deben trasladarse hacia arriba. Actualice el manual de reglas y regenere los archivos bajo la regla errónea.
La falta de un conjunto de pruebas no impide la migración.
Puede utilizar la aplicación original como implementación de referencia y construir un marco de verificación de equivalencia de comportamiento en torno a escenarios de usuario reales.
El flujo de trabajo de Mike Krieger ejecutaba siete escenarios tanto en la versión de Python como en la de TypeScript, comparaba los resultados y asignaba cada fallo a un bucle de reparación dedicado. Posteriormente, Claude diseñó pruebas integrales adicionales que se ejecutaron durante cuatro noches consecutivas.
Incluso si el equipo necesita construir un nuevo mecanismo de arbitraje alrededor del código original, el código original sigue siendo el único punto de referencia.
Anthropic advierte que no se debe tomar su flujo de trabajo como una plantilla universal. Cada código fuente tiene diferentes costos de compilación, semántica de lenguaje, calidad de pruebas, restricciones de plataforma y compensaciones aceptables.
Sin embargo, las siguientes prácticas se mantienen consistentes en múltiples proyectos.
Los fallos individuales pertenecen al ámbito del bucle de reparación.
El esfuerzo humano debe centrarse en los defectos recurrentes, las reglas faltantes, los límites de tareas poco razonables, los enlaces de verificación débiles y los cuellos de botella en el sistema de orquestación.
El revisor debe intentar activamente demostrar que el código tiene errores.
Esto no implica ser vago o pesimista. Las conclusiones de la revisión deben señalar defectos específicos, reglas violadas, suposiciones incorrectas o discrepancias de comportamiento.
Los compiladores, los casos de prueba, los scripts deterministas, los puntos de referencia y las diferencias de salida deben convertirse en criterios de aceptación de resultados.
Las opiniones de los modelos son valiosas para la investigación y la revisión, pero no deben reemplazar la verificación objetiva, siempre que esta sea posible.
El trabajo de traducción a gran escala suele ser repetitivo y puede ser manejado por modelos más pequeños.
Los modelos más potentes deben usarse para:
Esto reduce el costo de tokens sin eliminar el razonamiento fuerte de las decisiones de mayor riesgo.
El manual de reglas, el grafo de dependencias, la estrategia de verificación y las pruebas de estrés requieren la participación humana más cuidadosa.
Una vez que estos fundamentos son sólidos, el resto del trabajo masivo se convierte en un proceso de cola. Una base débil hace que cada etapa posterior sea más costosa.
El proceso de migración debe poder recuperarse de una interrupción sin necesidad de reconstruir el estado a través del historial de chat.
Almacene el progreso en archivos, commits, listas, bases de datos u otros artefactos deterministas. "Completado" debe tener un significado legible por máquina.
La compilación, las pruebas de integración, la creación de paquetes y los puntos de referencia completos pueden convertirse en cuellos de botella.
Ejecute estas operaciones a través de un servicio o daemon controlado para que los agentes paralelos no desperdicien recursos ni corrompan el estado compartido.
La versión en Rust de Bun ya está en producción, aunque los resultados aún presentan compensaciones de ingeniería.
Anthropic informa que aproximadamente el 4% del código Rust permanece en bloques unsafe, principalmente operaciones cortas con punteros en los límites con C y C++. Rust no eliminó todos los problemas de bajo nivel, pero los limitó más a áreas explícitas.
Las mejoras reportadas incluyen:
| Medida | Resultado |
|---|
| Uso de memoria en 2000 reconstrucciones | De 6745 MB a 609 MB |
| Tamaño del binario en Linux y Windows | Reducción del 19 % |
| Rendimiento en cargas de trabajo reales seleccionadas | Mejora del 2 %–5 % |
| Fugas de memoria detectables | Corregidas |
| Regresiones reportadas por Anthropic tras la fusión | 19, posteriormente corregidas |
Estos resultados importan más que el número bruto de líneas de código. Una migración exitosa no se mide por la velocidad con la que un agente genera código, sino por la compatibilidad, mantenibilidad, mejoras en ejecución y la capacidad de seguir desarrollando el producto después.
Antes de iniciar una migración masiva asistida por IA, responda las siguientes preguntas.
Si el sistema original cambia rápidamente, será difícil medir la consistencia. Considere congelar interfaces seleccionadas o priorizar la migración de módulos estables.
Defina las comprobaciones del compilador, pruebas, escenarios, puntos de referencia y comparaciones de salida que determinen la finalización.
Objetivos vagos como "que se comporte igual" no son suficientes.
La migración directa facilita la comparación y la paralelización. El rediseño puede generar una arquitectura superior, pero introduce más juicios y requiere revisiones de diseño más estrictas.
Evalúe los siguientes costos:
Diseñe el orquestador en torno al recurso compartido más costoso.
Defina los siguientes límites:
En el flujo de trabajo de Bun, los agentes interferían entre sí mediante comandos como git stash y git reset. Se actualizaron las reglas de orquestación para prohibir operaciones inseguras en el repositorio compartido y restringir a los agentes a confirmaciones controladas a nivel de archivo.
Las migraciones deben mantenerse descartables hasta que haya evidencia que respalde su fusión.
Use ramas aisladas, compilaciones reproducibles, puntos de control y un proceso claro para abandonar o regenerar el trabajo cuando las reglas fallen.
La migración de código asistida por IA utiliza agentes de codificación que, bajo un flujo de trabajo controlado, realizan la traducción, revisión, compilación, prueba y reparación del código base. El modelo no reemplaza la validación; el compilador, las pruebas, las comprobaciones de consistencia y las reglas definidas por humanos siguen siendo la autoridad.
Jarred Sumner completó la migración a Rust utilizando el flujo de trabajo dinámico de Claude Code. La solicitud de extracción de GitHub correspondiente se fusionó en mayo de 2026. La cuenta oficial de Bun indicó que el trabajo tomó aproximadamente 11 días, basándose en implementaciones en paralelo, revisión adversarial y el conjunto de pruebas independiente del lenguaje del proyecto.
La solicitud de extracción fusionada mostró más de un millón de líneas de código nuevas, junto con código eliminado y modificado. El número de líneas por sí solo no mide la calidad, por lo que los indicadores más importantes son los resultados de compilación, pruebas multiplataforma, rendimiento, uso de memoria, tamaño del binario y el manejo de regresiones posteriores a la fusión.
Según 5900 millones de tokens de entrada no almacenados en caché y 690 millones de tokens de salida, Anthropic estimó un costo de API de aproximadamente 165 000 USD. El costo real de la organización puede variar según acuerdos de precios, infraestructura interna, horas de personal, uso de CI y reparaciones posteriores a la fusión.
Un manual de reglas de migración es un conjunto de políticas legibles por máquina o por agentes que describe cómo se asignan los patrones del lenguaje fuente a la implementación objetivo. Abarca tipos, propiedad, errores, interfaces, nomenclatura, casos no soportados, decisiones arquitectónicas y otras reglas que los agentes de implementación deben seguir de manera consistente.
Los agentes de implementación tienen contexto e inercia que pueden inclinarlos a aceptar sus propias soluciones. El revisor adversarial trabaja en un contexto independiente y se le indica que busque defectos, violaciones de reglas y diferencias de comportamiento, en lugar de ayudar a fusionar el código.
Es posible, pero el equipo debe establecer otro árbitro objetivo. Una plataforma de pruebas de consistencia puede ejecutar escenarios reales en ambas implementaciones y comparar salidas, mientras que nuevas pruebas de extremo a extremo pueden exponer fallos que las comprobaciones de traducción estática pasan por alto.
No. La migración aún requiere beneficios medibles, una implementación de referencia estable, validación objetiva, presupuesto suficiente y un plan de reversión aceptable. Los sistemas con pruebas débiles, comportamiento no documentado, requisitos cambiantes o restricciones de seguridad críticas pueden necesitar una preparación significativa o ser inviables con las capacidades actuales de IA.
Preparación necesaria antes de que los agentes puedan ayudar de manera responsable.
Las prácticas recientes de migración de Anthropic demuestran que los proyectos de portabilidad lingüística pueden reorganizarse en torno a flujos de trabajo de agentes, en lugar de depender de una única reescritura manual prolongada. La migración de Bun de Zig a Rust y el proyecto de Anthropic de Python a TypeScript se basan en implementación paralela, revisión adversarial, verificación determinista y regeneración iterativa.
La parte reutilizable es el proceso: construir evaluadores, definir reglas, mapear dependencias, someter los métodos a pruebas de estrés, traducir en lotes recuperables, compilar, ejecutar y comparar comportamientos. Cuando un mismo defecto aparece repetidamente, se corrige la regla o el flujo de trabajo que lo genera, en lugar de reparar manualmente cada salida.
Este enfoque aún requiere un presupuesto considerable, pruebas sólidas, permisos controlados y juicio humano a nivel arquitectónico. Reduce los costos de migración, pero no elimina el trabajo de ingeniería.
Responsabilidad.
El punto clave es simple: una migración confiable de IA surge de ciclos de producción verificables, no de una sola instrucción que haga que el modelo reescriba toda la base de código.
Empieza con una sola frase y obtén un sitio completo en minutos.



