For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/claude-distillation-defenses-and-preserve-b64c5fd8.md.
Anthropic afirma que nuevas protecciones han reducido aproximadamente entre un 90 % y un 99 % la cantidad de razonamiento de Claude extraído...
Anthropic afirma que nuevas protecciones han reducido aproximadamente entre un 90 % y un 99 % la cantidad de razonamiento de Claude extraído por destiladores en su propia plataforma. Su actualización del 12 de octubre describe tres capas de defensa: restricciones para reutilizar razonamiento protegido, clasificadores de extracción más sólidos y controles de cuentas que encarecen los intentos repetidos.
También hay una consecuencia práctica para los desarrolladores habituales. Algunas integraciones deben cambiar la forma en que reproducen el historial de conversación, y algunas solicitudes bloqueadas antes de que Claude responda ahora son facturables. Comprender esos costes exige separar los resultados antiabuso de la empresa de las reglas de API que las aplicaciones realmente encuentran.
La destilación entrena un modelo usando las salidas de otro modelo. También es una técnica legítima: los desarrolladores pueden destilar sus propios modelos o utilizar datos para los que tienen permiso. El informe de Anthropic se centra en campañas de extracción no autorizada, que con frecuencia implican cuentas fraudulentas, en lugar de considerar que toda destilación sea abuso.
En este contexto, las respuestas finales son datos útiles para el entrenamiento, pero el razonamiento detallado puede ser aún más útil. Una transcripción de razonamiento revela decisiones intermedias, enfoques intentados y correcciones que un modelo estudiante tendría que inferir de otro modo.
Anthropic ilustra la diferencia con un experimento que entrenó un modelo Claude preentrenado con transcripciones de Claude Opus 4.8. Las puntuaciones resultantes en SWE-bench Verified fueron:
| Material de entrenamiento | Puntuación reportada en SWE-bench Verified |
|---|---|
| Transcripciones con razonamiento completo | 80,4 % |
| Transcripciones con razonamiento resumido | 71,8 % |
Eso representa una diferencia de 8,6 puntos porcentuales en este experimento. Respalda el valor de las transcripciones de razonamiento para esa configuración de entrenamiento; no establece una ventaja universal de la misma magnitud entre modelos o tareas.
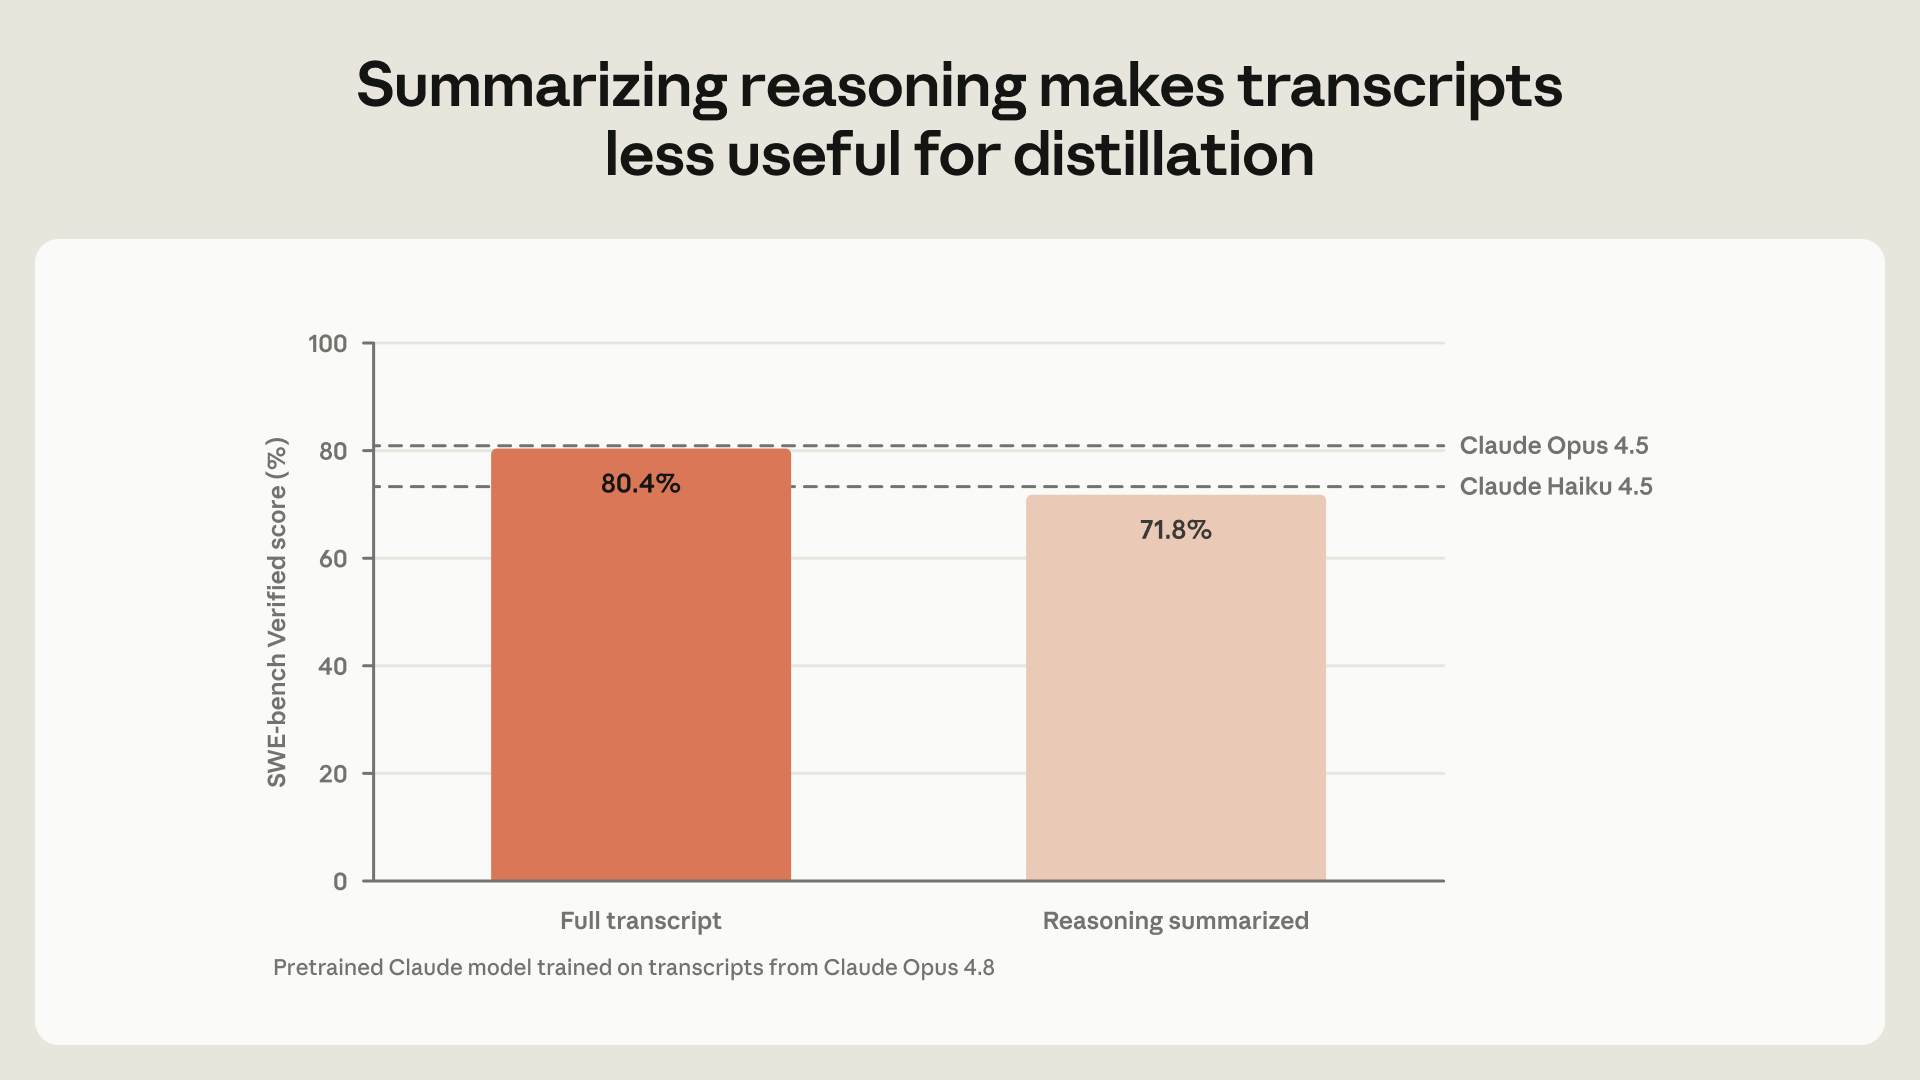
Fuente: Anthropic. Las barras describen el modelo estudiante entrenado con transcripciones de Opus 4.8, no una comparación directa en benchmarks entre los modelos de producción mostrados como líneas de referencia.
Mostrar resúmenes reduce la recopilación pasiva, pero crea un incentivo para obtener el razonamiento oculto mediante solicitudes de seguimiento. Anthropic afirma que un laboratorio probó 12.000 solicitudes de extracción diferentes. También describe redes de proxy que distribuyen la actividad entre un gran número de cuentas, incluida una red reportada anteriormente que gestionaba más de 20.000 cuentas fraudulentas a la vez.
Para tareas largas, un modelo puede necesitar continuar a partir del razonamiento producido durante un turno anterior. La API puede preservar bloques de pensamiento protegidos para ese fin sin exponer el razonamiento subyacente como texto ordinario legible por el usuario.
Esto crea un problema de control de acceso. Según Anthropic, los atacantes han intentado mover razonamiento entre conversaciones, modelos o cuentas para encontrar un contexto en el que pueda revelarse. Por tanto, proteger el bloque requiere controlar su reutilización, además de su visualización.
Anthropic introdujo el razonamiento preservado con Claude Fable 5.1 y Claude Opus 5.5. La documentación actual describe dos verificaciones centrales:
La verificación del prefijo se aplica de forma predeterminada a las cuentas creadas a partir del 31 de agosto de 2026 a las 00:00 UTC. Las cuentas más antiguas pueden habilitar su aplicación mediante los controles documentados. La verificación de compatibilidad de modelos se aplica a todas las cuentas.
El anuncio de investigación también describe restricciones de organización para el razonamiento de Sonnet 5.5. La documentación actual de la API proporciona la regla más específica: los bloques de pensamiento de Sonnet 5.5 y Haiku 5.5 solo funcionan en la cuenta que los produjo o en una cuenta vinculada, cuando se aplica la regla documentada. Los desarrolladores deben utilizar esa documentación de compatibilidad al implementar cambios de enrutamiento o de cuenta.
El comportamiento habitual de una aplicación puede modificar un prefijo protegido: reconstruir un prompt del sistema con una marca de tiempo nueva, editar una salida antigua de una herramienta, cambiar las descripciones de herramientas o resumir turnos anteriores mientras se conservan bloques de pensamiento posteriores.
De forma predeterminada, un prefijo no válido puede producir un 400 invalid_request_error. Los controles beta documentados también permiten configurar thinking.block_binding.prefix_mismatch_behavior como drop_block; en ese caso, los bloques de pensamiento no válidos y los bloques de pensamiento posteriores se descartan para esa solicitud. Esto permite que la solicitud continúe, pero no repara la modificación del historial.
Mantenga estable el historial reproducido y añada información nueva mediante patrones compatibles. Ya no es seguro asumir que se puede cambiar el texto visible de una conversación y seguir reutilizando todo su razonamiento protegido anterior.
La segunda capa de Anthropic utiliza un sistema de clasificadores en dos etapas inspirado en su investigación sobre Constitutional Classifiers. La empresa prueba los intentos de extracción con equipos rojos internos y externos, y después actualiza las defensas cuando una técnica tiene éxito.
La empresa afirma que las salvaguardas contra la destilación resultantes tienen una tasa de falsos positivos inferior al 0,1 % en su evaluación. Compara su solidez con sus defensas contra la asistencia para crear armas biológicas. Esta es una evaluación de la empresa bajo sus condiciones de prueba, no una garantía de que la solicitud legítima de un usuario concreto nunca será rechazada.
El sistema también cambia con el tiempo. Anthropic describe la corrección de técnicas que intentaban revelar razonamiento protegido mediante traducción o salidas con formatos especiales. La afirmación publicada es que el clasificador detecta las técnicas de extracción descritas en su informe de septiembre para los modelos cubiertos por el sistema.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La tercera capa actúa sobre el comportamiento repetido. Las cuentas que persisten en intentos de extracción pueden recibir límites de uso más estrictos, y las cuentas asociadas pueden ser prohibidas. Anthropic informa de que ha prohibido decenas de miles de cuentas, a veces dentro de las dos horas posteriores al inicio de una campaña.
Desde el 24 de septiembre, Anthropic también volvió a cobrar por solicitudes bloqueadas antes de la respuesta de un modelo en categorías de salvaguarda seleccionadas con tasas reportadas de falsos positivos inferiores al 0,1 %, incluida la destilación. La fuente también identifica las categorías de uso indebido biológico y desarrollo de modelos de frontera. Esta política no debe generalizarse a cada solicitud rechazada ni a cada tipo de filtro de seguridad.
Anthropic estima que los tokens de razonamiento extraídos en su propia plataforma se redujeron por un factor de 10 a 100 después de la introducción del clasificador, junto con los cambios de razonamiento preservado. Algunos días tuvieron muy pocos tokens extraídos como para que la empresa pudiera medirlos.
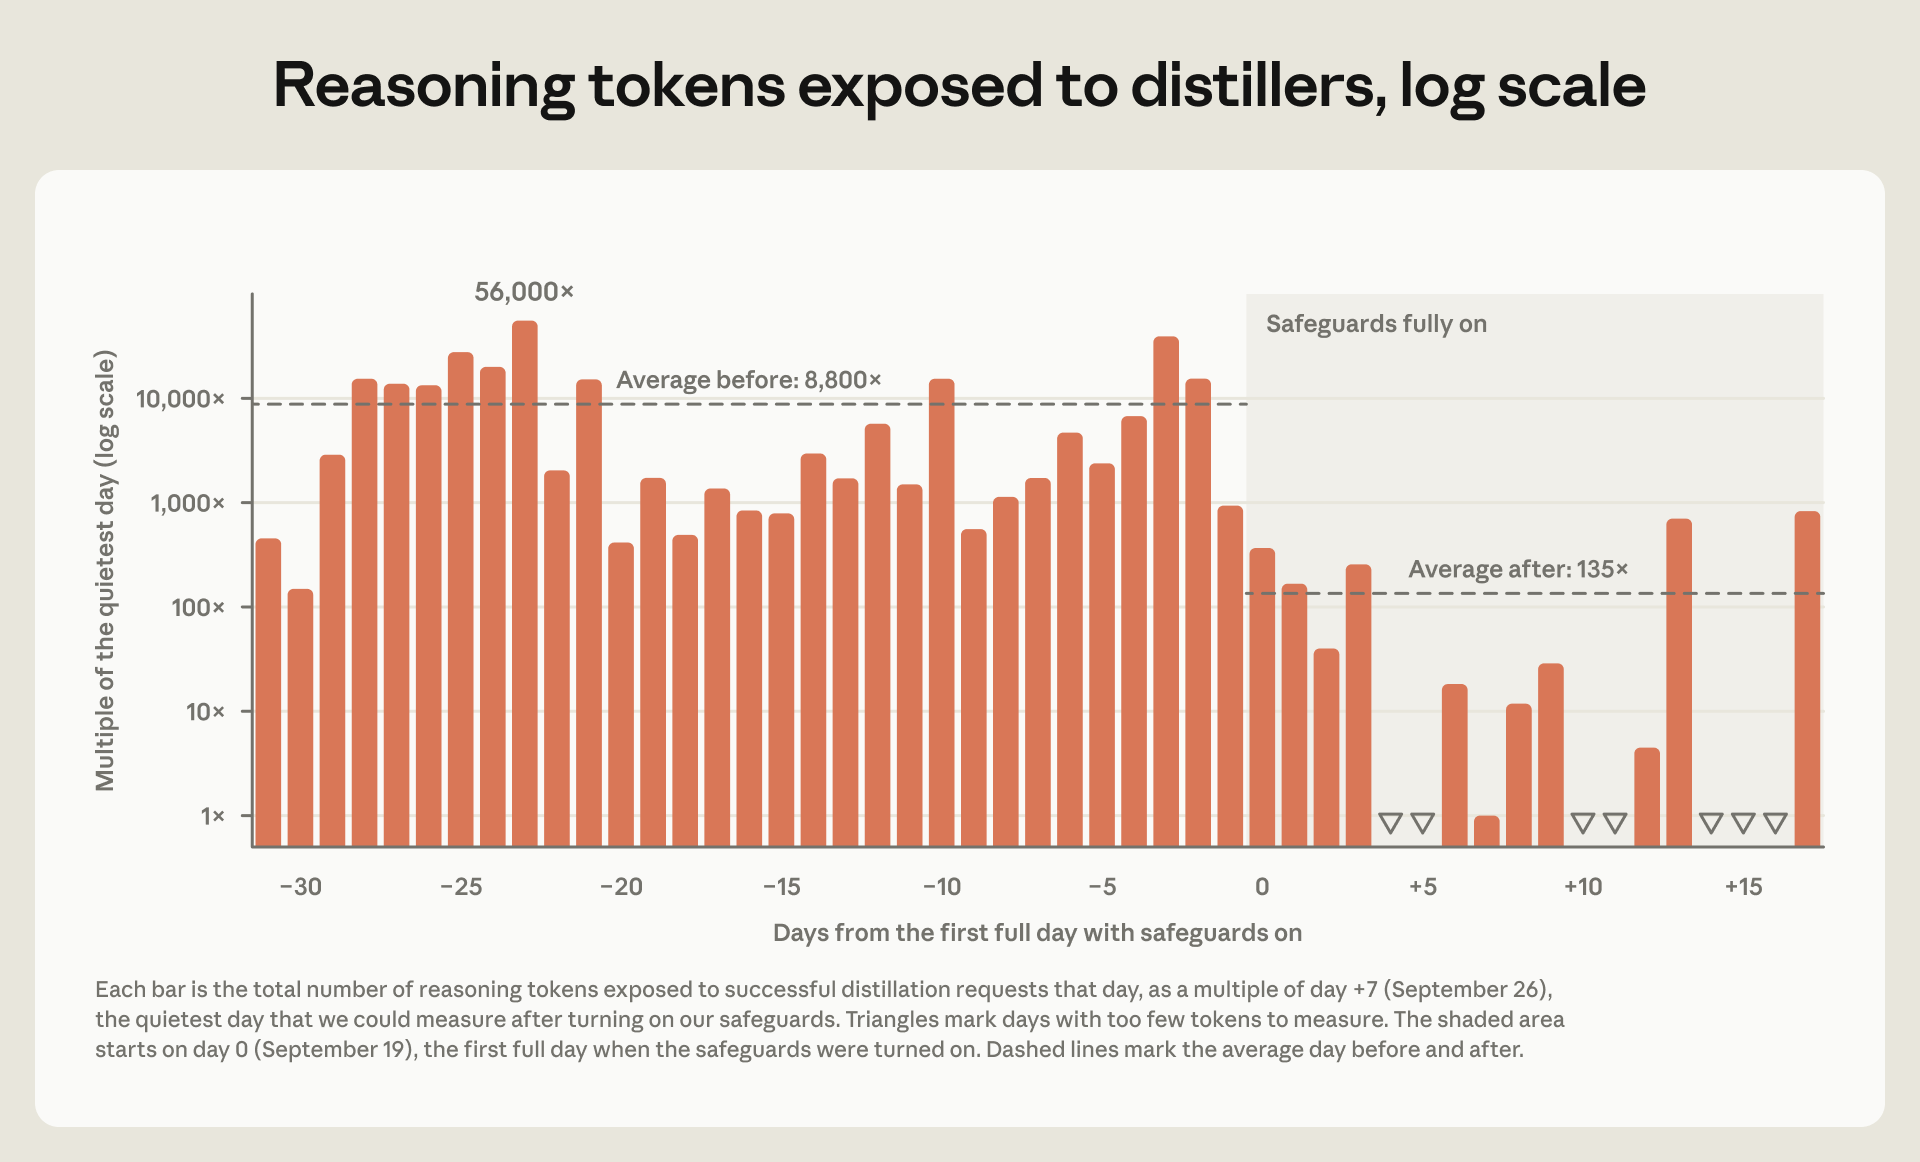
Fuente: Anthropic. El eje vertical es logarítmico y está normalizado respecto de un día de baja extracción, no representa un recuento absoluto de tokens. Los triángulos hacia abajo indican días con muy pocos tokens para medir.
El alcance es importante. Estas cifras describen la estimación de Anthropic para su propia plataforma; no miden toda la actividad de destilación entre proveedores externos de inferencia. La empresa también afirma que aún no ha observado un intento altamente sofisticado y persistente de vencer las defensas completamente implementadas, y que no sabe cuánto durarán las mejoras.
Anthropic reconoce que los cambios no han sido totalmente transparentes para los usuarios habituales. Las integraciones pueden necesitar actualizaciones, las solicitudes benignas pueden clasificarse erróneamente y esos bloqueos equivocados ahora pueden generar cargos en las categorías afectadas.
La pérdida de razonamiento reutilizable tiene otro coste: el modelo puede necesitar reconstruir el trabajo. En un benchmark de programación multiturno descrito en la documentación de la API, descartar el razonamiento una vez por sesión incrementó los tokens de salida un 20,1 % con esfuerzo máximo. Es una estimación específica de una carga de trabajo con amplios márgenes de error, no un recargo estándar ni una predicción para todas las aplicaciones.
Para un desarrollador, la distinción útil es la existente entre un bloque de entrada ilegible o descartado y una salida generada de nuevo. El bloque descartado no se factura, mientras que reconstruir el razonamiento puede generar tokens de salida adicionales. Supervisar las discrepancias de prefijo y probar las propias cargas de trabajo de la aplicación resulta más informativo que asumir que un reintento exitoso no tiene coste.
En el uso de Anthropic, es una campaña no autorizada para recopilar salidas o razonamiento protegido de Claude con el fin de entrenar otro modelo. La destilación en sí misma es una técnica estándar de aprendizaje automático y puede ser legítima cuando el desarrollador cuenta con los derechos y la autorización necesarios.
No. Anthropic reporta una reducción estimada del 90 % al 99 % en el razonamiento extraído en su propia plataforma después de desplegar las protecciones. Esa cifra no cubre todos los proveedores, todos los ataques ni todos los métodos de extracción futuros.
No, siempre que la aplicación siga las reglas documentadas para reproducir el razonamiento y preservar el prefijo de conversación. Los problemas surgen cuando cambia el contexto anterior mientras la aplicación sigue enviando bloques de pensamiento vinculados al contexto original.
Solo cuando las reglas documentadas de compatibilidad de modelos lo permiten. Un modelo que no puede leer un bloque se ejecuta sin ese bloque, por lo que cambiar a un modelo más económico no preserva necesariamente el razonamiento del modelo anterior.
Sí. Anthropic afirma que ciertas categorías de salvaguarda volvieron a ser facturables el 24 de septiembre, incluso cuando la solicitud se bloquea antes de que Claude responda. El informe reconoce explícitamente que un falso positivo en esas categorías puede afectar a un cliente legítimo.
No. Ese fue el incremento reportado al descartar el razonamiento una vez por sesión con esfuerzo máximo en una prueba concreta de programación multiturno. El efecto depende del nivel de esfuerzo, el historial de conversación, la tarea y la frecuencia con la que la integración descarta bloques.
Las nuevas defensas de Anthropic combinan restricciones sobre el razonamiento protegido, clasificadores de extracción y medidas contra el abuso repetido. La empresa informa de una reducción sustancial del razonamiento extraído en su propia plataforma, aunque reconoce que los atacantes pueden adaptarse.
Para los desarrolladores de Claude API, el trabajo inmediato consiste en mantener un historial de conversación válido y comprender los costes de las solicitudes bloqueadas o del razonamiento descartado. Las mejoras de seguridad reportadas son considerables, pero las integraciones estables y las pruebas específicas de cada carga de trabajo siguen siendo importantes.
Empieza con una sola frase y obtén un sitio completo en minutos.



