Filtración de Claude Fable 5.2: pruebas grises, rumores sobre Opus 5.2 y primeras comparaciones con GPT-6 Astra

Una nueva ronda de rumores sobre modelos de Anthropic se está extendiendo rápidamente entre la comunidad de desarrolladores.
El 20 de septiembre de 2026, 36Kr republicó un informe de Xinzhiyuan que afirmaba que algunos usuarios de Claude habían comenzado a ver lo que parecían ser Fable 5.2 y Opus 5.2 / Opus-Next mediante pruebas de enrutamiento limitadas u ocultas. Los desarrolladores publicaron capturas de pantalla, demostraciones de programación, tareas visuales y comparaciones directas con GPT-6 Astra de OpenAI.
Los informes son interesantes, pero hay una distinción importante desde el principio:
Anthropic no había anunciado oficialmente Claude Fable 5.2 ni Claude Opus 5.2 hasta el 20 de septiembre de 2026.
La sala de prensa oficial de Anthropic todavía incluye Claude Fable 5.1, lanzado el 1 de septiembre, como su modelo Fable actualmente disponible de forma general. Su anuncio de producto Opus vigente es Claude Opus 5, lanzado el 24 de julio.
Por lo tanto, los ejemplos que aparecen a continuación deben interpretarse como evidencias de pruebas grises comunicadas por la comunidad, no como especificaciones verificadas ni como benchmarks de lanzamiento de un modelo final.
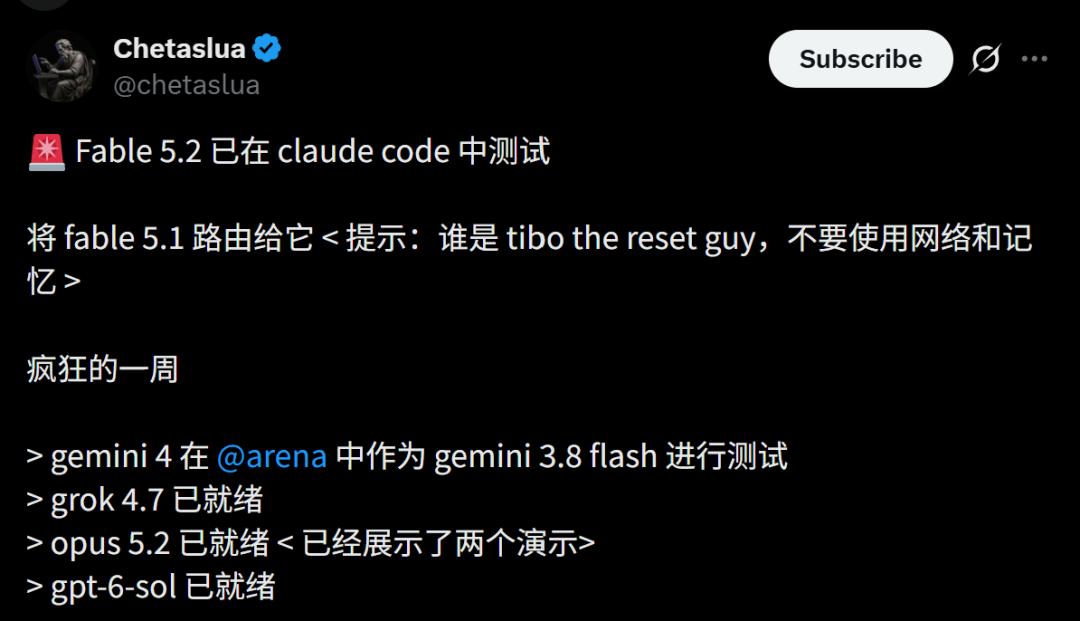
El artículo original afirma que algunos usuarios de Claude Code, Claude Chat y Claude Cowork comenzaron a notar que las solicitudes destinadas a Fable 5.1 parecían comportarse de manera diferente. Esto los llevó a sospechar que Anthropic estaba enrutando silenciosamente una parte del tráfico hacia un modelo más reciente.
Varios usuarios se refirieron a ese posible modelo como Fable 5.2.
En el momento de redactar este artículo, Anthropic no había publicado ningún identificador oficial de modelo, nota de lanzamiento, página de modelo de API, página de precios ni tarjeta de sistema para Fable 5.2.
Esto significa que la afirmación más sólida que puede hacerse actualmente es la siguiente:
Algunos usuarios creen que Anthropic está realizando pruebas A/B o un enrutamiento gris hacia una variante Fable más reciente, pero las pruebas públicas no demuestran de forma independiente su nombre final de producto, arquitectura, precio ni calendario de lanzamiento.
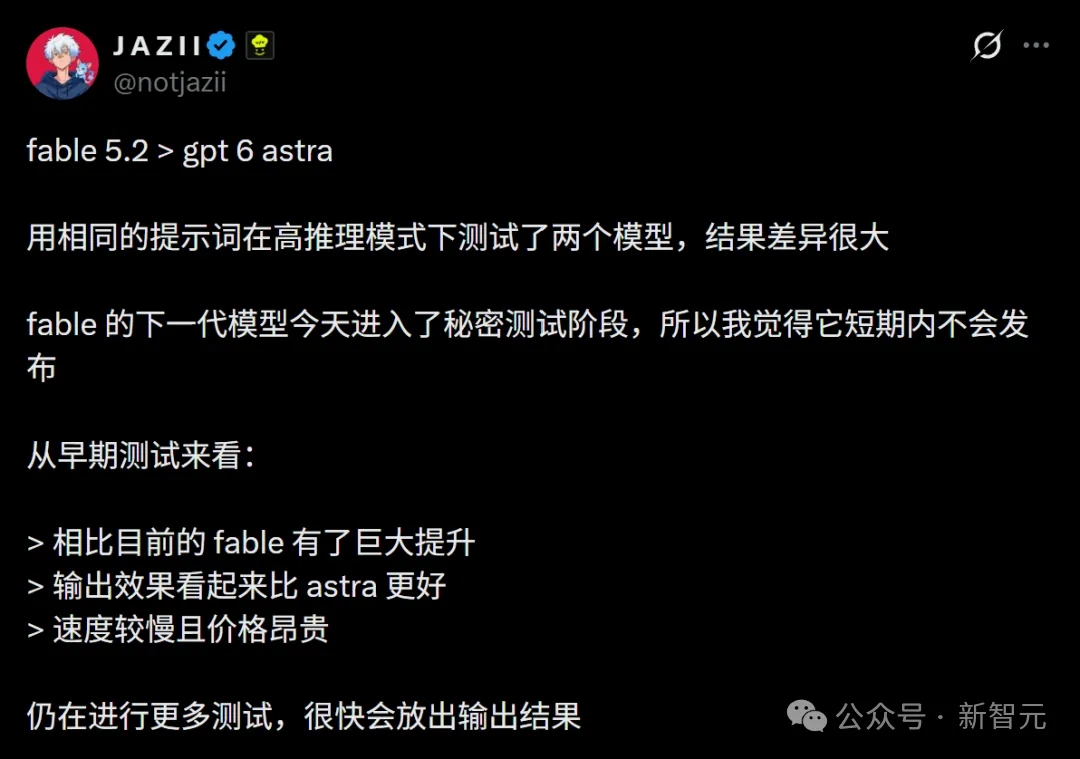
El evaluador de IA @notjazii informó que una sesión de Claude que, según creía, había sido enrutada hacia un modelo Fable más reciente produjo resultados notablemente mejores que la versión de Fable que había estado utilizando anteriormente.
Después comparó el resultado del supuesto Fable 5.2 con GPT-6 Astra utilizando la misma instrucción y configuraciones de razonamiento alto.
Su conclusión fue que el supuesto nuevo modelo Fable parecía representar un avance importante frente a la versión actual y que producía resultados más impresionantes en su prueba.
También informó de dos compensaciones:
Estas compensaciones serían plausibles en un modelo que utilizara más computación durante la inferencia o configuraciones de mayor esfuerzo, pero Anthropic no ha publicado información oficial sobre la latencia o los precios de Fable 5.2.
Por lo tanto, deben seguir considerándose observaciones de usuarios y no especificaciones del producto.
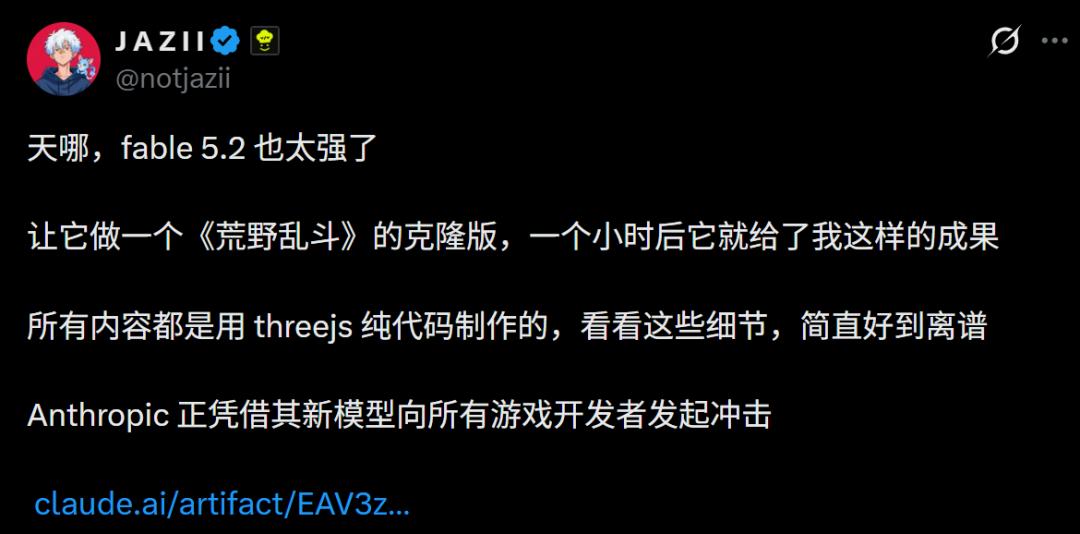
El mismo evaluador también pidió al supuesto nuevo modelo que construyera un clon inspirado en Brawl Stars utilizando Three.js.
Según la publicación, el modelo produjo un prototipo jugable y visualmente detallado después de aproximadamente una hora.
Este tipo de ejemplo resulta útil para entender qué están probando los desarrolladores: no solo la finalización breve de código, sino también sesiones de programación agéntica más largas que implican resultados visuales, lógica de juego, iteración e implementación del frontend.
Sin embargo, no se trata de un benchmark controlado. El resultado depende de la instrucción, el entorno, las herramientas, la intervención humana, los reintentos y el enrutamiento del modelo.
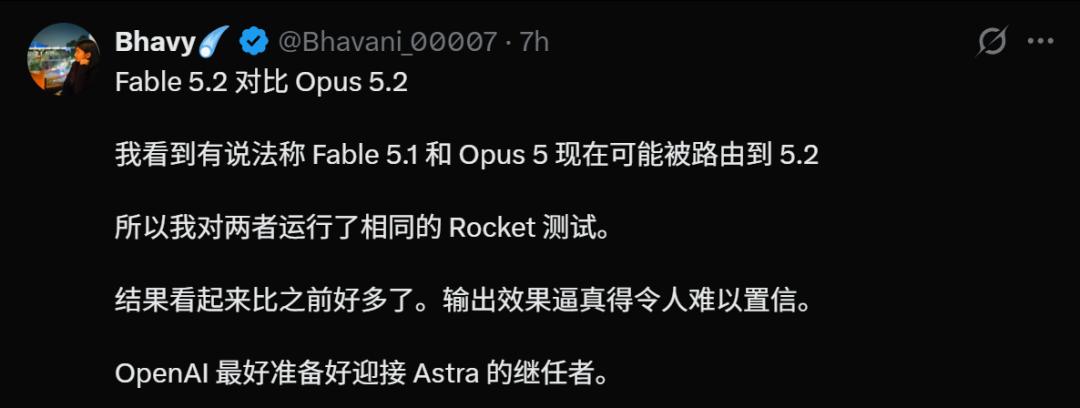
Otro evaluador, @Bhavani_00007, informó que había ejecutado la misma “prueba del cohete” con supuestas instancias de Fable 5.2 y Opus 5.2.
La tarea se describió como una prueba de:
El evaluador afirmó que los resultados parecían mucho mejores que los resultados anteriores de Claude.
De nuevo, la afirmación no incluía una puntuación estandarizada ni un protocolo de benchmark reproducible, por lo que debe tratarse como evidencia anecdótica y no como una prueba de un aumento de capacidad medido.
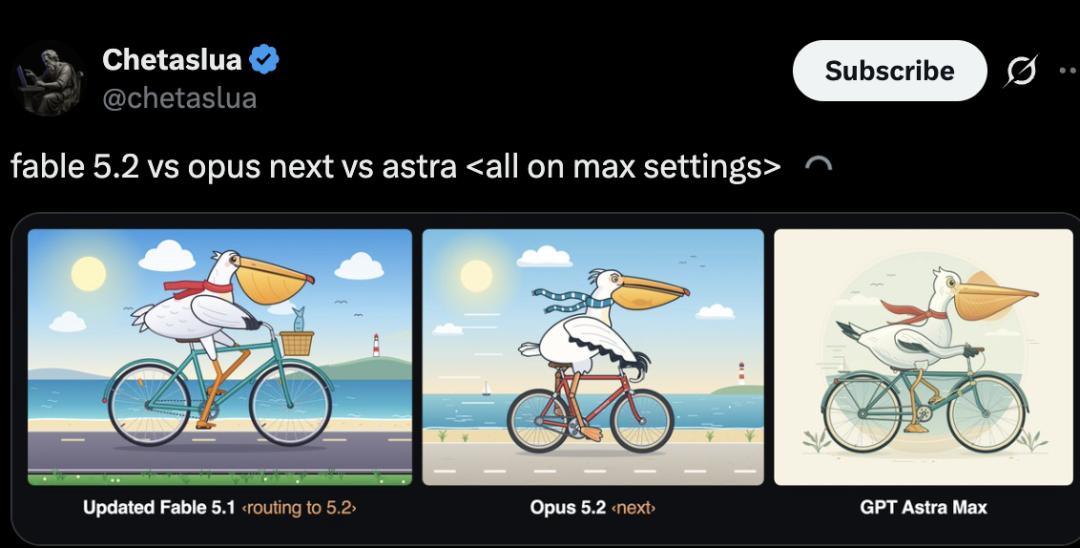
Otra comparación de la comunidad colocó lado a lado el supuesto Fable 5.2, un supuesto modelo Opus-Next y GPT-6 Astra, todos con sus configuraciones disponibles más altas.
El artículo original interpreta los resultados de Anthropic como más ricos en detalles que el resultado de Astra.
Se trata de una valoración visual subjetiva, no de un resultado de benchmark controlado. Las diferentes configuraciones de esfuerzo, el acceso a herramientas, el procesamiento de las instrucciones, el muestreo y el enrutamiento oculto pueden afectar a la comparación.
Una conclusión más prudente es simplemente que los resultados filtrados fueron lo suficientemente sólidos como para hacer creer a usuarios experimentados que Anthropic podría estar probando una actualización significativa.
El artículo también cita al evaluador @Mr_Salio, quien afirmó que Anthropic parecía estar protagonizando un regreso importante y predijo que Fable 5.2 superaría a GPT-6 Astra en su configuración de razonamiento más exigente.
Esto sigue siendo una predicción de un evaluador individual.
Actualmente no existe una tabla de benchmarks pública de Anthropic para Fable 5.2 que pueda compararse directamente con los resultados publicados por OpenAI para GPT-6 Astra.
Como referencia, el Claude Fable 5.1 lanzado oficialmente ya es el modelo de Anthropic más capaz disponible de forma general para programación y trabajo de conocimiento. Anthropic afirma que Fable 5.1 está diseñado para tareas ambiciosas y prolongadas, y que está disponible en Claude, Claude Code, Claude Platform, AWS, Google Cloud y Microsoft Azure.
El artículo también comparte un truco de la comunidad para intentar inferir si una sesión de Claude ha sido enrutada hacia un modelo más reciente.
La instrucción sugerida es esencialmente:
¿Sabes quién es “Tibo, el tipo de los reinicios”? No utilices la búsqueda web.
La teoría sostiene que un modelo antiguo no conocería la referencia reciente, mientras que un modelo más nuevo con datos de entrenamiento posteriores podría responder correctamente a partir de su memoria.
Es un experimento ingenioso de la comunidad, pero no es un método fiable para identificar modelos.
Un modelo podría responder de manera diferente debido a:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La ausencia o presencia de un único dato reciente no puede demostrar qué modelo backend procesó una solicitud.
La única forma fiable de identificar un modelo de API es mediante identificadores oficiales de modelo y documentación de la plataforma. Las interfaces de consumo de Claude pueden utilizar un enrutamiento dinámico que no se muestra completamente al usuario.
La segunda mitad del artículo se centra en otro supuesto modelo: Opus 5.2, al que algunos evaluadores se refieren como Opus-Next.
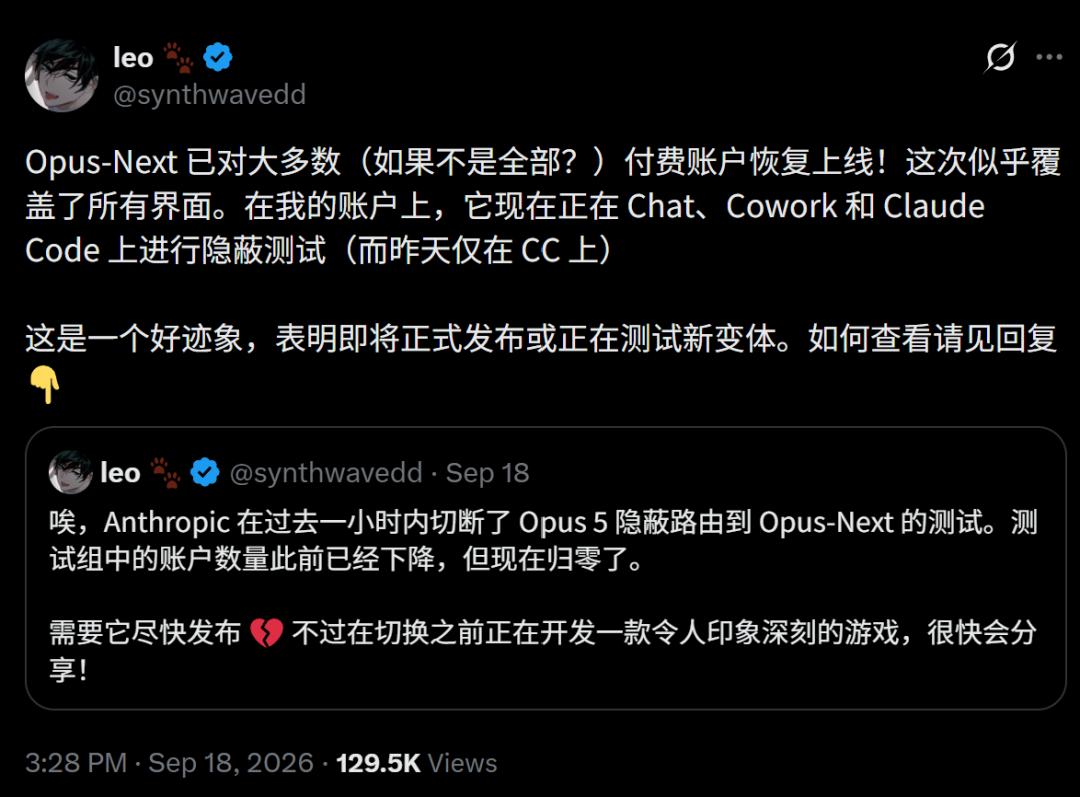
Los usuarios afirmaron que el modelo apareció temporalmente en Claude Code, desapareció y regresó varias horas después con pruebas más amplias en Chat, Cowork y Claude Code.
Un evaluador describió una desaparición repentina mientras trabajaba en un proyecto complejo, seguida del aparente regreso del modelo.
El artículo interpreta esto como una señal de que Anthropic podría estar realizando experimentos de enrutamiento en una fase avanzada.
Es posible, pero no está confirmado.
El modelo Opus anunciado oficialmente por Anthropic sigue siendo Claude Opus 5, lanzado el 24 de julio de 2026. Anthropic lo describe como un modelo reflexivo y proactivo que se acerca a la capacidad de Fable 5 con un coste menor, y cuyo precio es de 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida.
Hasta el 20 de septiembre no había aparecido ninguna página oficial de producto ni identificador de API para Opus 5.2.
El artículo cita especulaciones en redes sociales según las cuales Anthropic podría llamar “5.2” al próximo modelo Opus porque la actualización sería mayor que una revisión menor típica.
No existe evidencia oficial de que esta sea la lógica de nomenclatura de Anthropic.
De hecho, Anthropic sí lanzó oficialmente Fable 5.1 el 1 de septiembre, por lo que la compañía utiliza claramente el versionado .1 cuando decide hacerlo.
Si finalmente se lanza un modelo Opus 5.2, el anuncio de lanzamiento de Anthropic —no las teorías de nomenclatura de la comunidad— será la explicación autorizada.
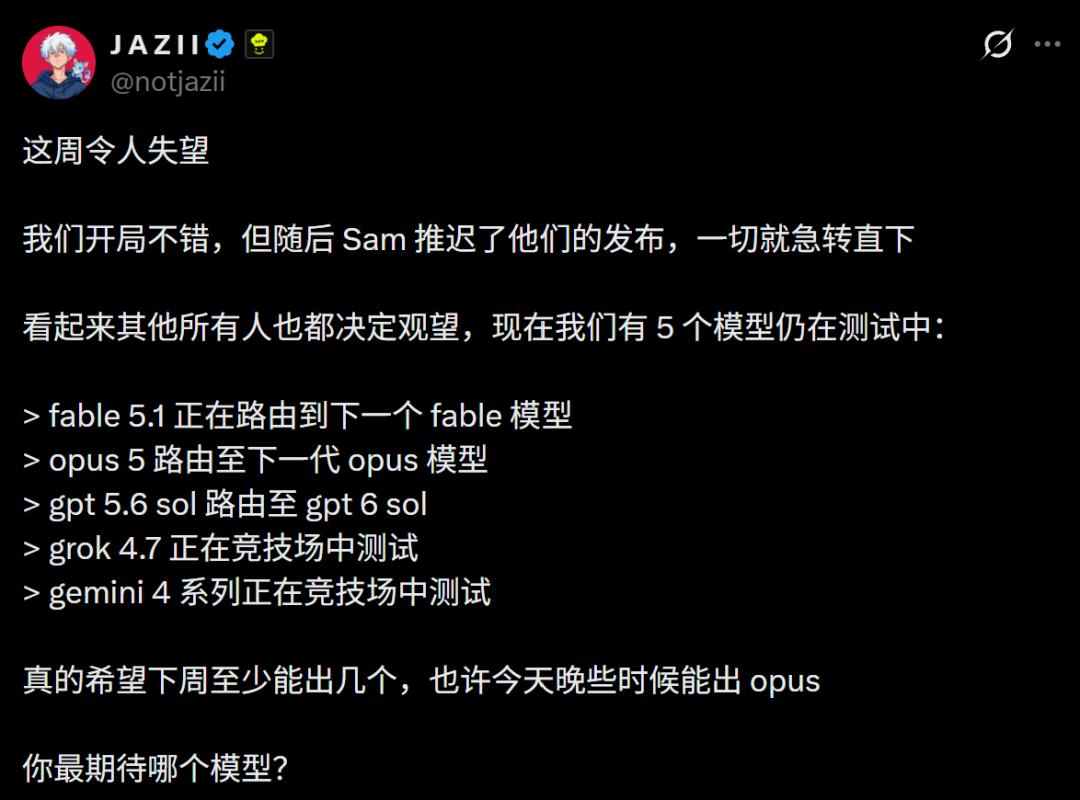
El artículo concluye situando los rumores sobre Claude dentro de una semana más amplia de especulaciones sobre modelos de frontera.
Las publicaciones de la comunidad afirmaban que varias empresas estaban probando discretamente nuevas variantes de modelos, entre ellas:
No todos estos informes tienen el mismo nivel de verificación.
Los proveedores de modelos suelen realizar pruebas A/B, despliegues escalonados, alias internos y experimentos de enrutamiento oculto. Sin embargo, sin un anuncio oficial o un identificador de modelo estable, los usuarios externos normalmente no pueden determinar con exactitud qué modelo se utilizó basándose únicamente en su comportamiento.
La fuente también menciona rumores de que los modelos de frontera podrían estar acercándose a problemas matemáticos abiertos difíciles y de que equipos de investigación estarían contactando con matemáticos por posibles resultados.
Esa afirmación es demasiado vaga para verificarse con las pruebas disponibles y no debe considerarse una evidencia de que se haya resuelto ningún Problema del Milenio.
A 20 de septiembre, la referencia confirmada más importante de Anthropic sigue siendo Claude Fable 5.1.
Anthropic afirma oficialmente que Fable 5.1:
Cualquier lanzamiento futuro de Fable 5.2 u Opus 5.2 debería compararse con esa referencia oficial una vez que Anthropic publique la tarjeta de modelo, los benchmarks, el precio, los límites de contexto y los identificadores de API reales.
No. Hasta el 20 de septiembre de 2026, la sala de prensa oficial de Anthropic y la página de producto de Fable incluyen Claude Fable 5.1 como el modelo Fable actualmente disponible de forma general. Las afirmaciones sobre Fable 5.2 se basan en informes de la comunidad sobre posibles pruebas grises o enrutamiento oculto.
Todavía no, según los anuncios públicos de productos de Anthropic revisados para este artículo. El lanzamiento oficial actual de Opus es Claude Opus 5, presentado el 24 de julio de 2026.
Son útiles como primeras impresiones de usuarios, pero no son benchmarks controlados. El enrutamiento oculto, el esfuerzo de razonamiento, las herramientas, el muestreo, los detalles de las instrucciones y los intentos repetidos pueden cambiar el resultado.
No de forma fiable. El conocimiento que tenga un modelo sobre una referencia reciente de internet no demuestra la identidad de su backend, y los productos de consumo de Claude pueden utilizar un enrutamiento o un comportamiento del sistema que los usuarios no pueden inspeccionar directamente.
Anthropic lanzó oficialmente Claude Fable 5.1 el 1 de septiembre de 2026. Es el modelo Fable actualmente disponible de forma general para programación avanzada, trabajo de conocimiento y tareas agénticas prolongadas.
Anthropic establece el precio de Fable 5.1 en 10 dólares por millón de tokens de entrada y 50 dólares por millón de tokens de salida, con lecturas de caché a 0,25 dólares por millón de tokens. Anthropic afirma que el precio reducido de las lecturas de caché disminuye el coste de las cargas de trabajo habituales frente a Fable 5.
Anthropic presenta Opus 5 como un modelo diario sólido para programación y trabajo de conocimiento, con una capacidad cercana a la frontera a un coste inferior al de Fable. Su precio es de 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida.
Anthropic no ha confirmado públicamente una fecha de lanzamiento para ninguno de los dos modelos. Cualquier predicción concreta sobre el día de lanzamiento seguirá siendo especulación hasta que Anthropic publique un anuncio oficial o documentación del modelo.
La historia de Fable 5.2 debe entenderse como una filtración de pruebas grises, no como un lanzamiento de producto. Los desarrolladores han publicado suficientes comportamientos de enrutamiento inusuales, resultados de programación y pruebas comparativas para que los rumores resulten interesantes, pero Anthropic todavía no ha proporcionado los identificadores de modelo, benchmarks, precios, tarjeta de sistema ni notas de lanzamiento necesarios para verificar un producto final Fable 5.2 u Opus 5.2.
Los primeros ejemplos sugieren que Anthropic podría estar probando un comportamiento más sólido en programación de largo alcance, generación visual y razonamiento. Todavía no demuestran que Fable 5.2 supere definitivamente a GPT-6 Astra, ni prueban que todas las sesiones etiquetadas por los usuarios como “5.2” hayan sido procesadas por el mismo modelo oculto.
Por ahora, los puntos de referencia verificados son Claude Fable 5.1 y Claude Opus 5.
Las filtraciones merecen seguimiento, pero la comparación real comenzará únicamente cuando Anthropic publique los modelos oficiales 5.2 y los detalles reproducibles de su evaluación.
Empieza con una sola frase y obtén un sitio completo en minutos.