For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/claude-haiku-5-vs-gpt-6-luna-benchmarks-p-ec36c306.md.
Anthropic ha lanzado **Claude Haiku 5.5**, y no se trata de una actualización rutinaria de un modelo pequeño.

Anthropic ha lanzado Claude Haiku 5.5, y no se trata de una actualización rutinaria de un modelo pequeño.
El nuevo Haiku supera ampliamente a Haiku 4.5 en uso de ordenadores, programación, trabajo profesional y tareas de agentes con un uso intensivo de herramientas, al tiempo que reduce de forma drástica su precio principal de API.
En las comparaciones de lanzamiento de Anthropic, Haiku 5.5 también supera a GPT-6 Luna en varios benchmarks, incluidos GDPval-AA v2.1, OSWorld 2.1, Terminal-Bench 4.0, FrontierCode 1.1 y Chartography.
Esto convierte a Haiku 5.5 en una nueva opción importante para cargas de trabajo de gran volumen, como:
Sin embargo, el lanzamiento también incluye algunas advertencias importantes.
El precio cambia en el límite de 100K tokens de entrada, el tokenizador utiliza más tokens para el mismo texto y actualizar una integración existente de Haiku 4.5 requiere varios cambios en la API.
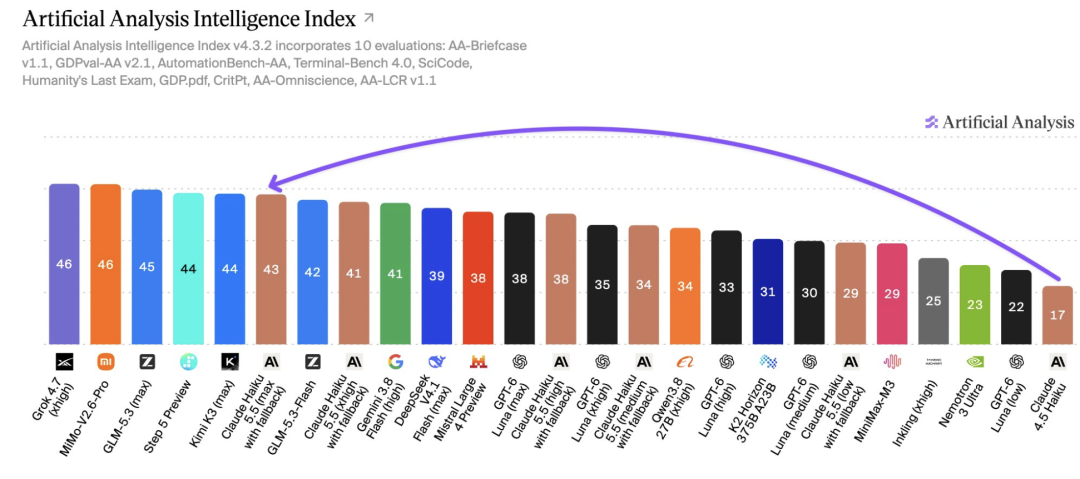
Anthropic presenta Haiku 5.5 como su modelo pequeño más barato, rápido y capaz hasta la fecha.
La tabla oficial de benchmarks deja claro cuál es el competidor previsto: GPT-6 Luna aparece directamente junto a Haiku 5.5.
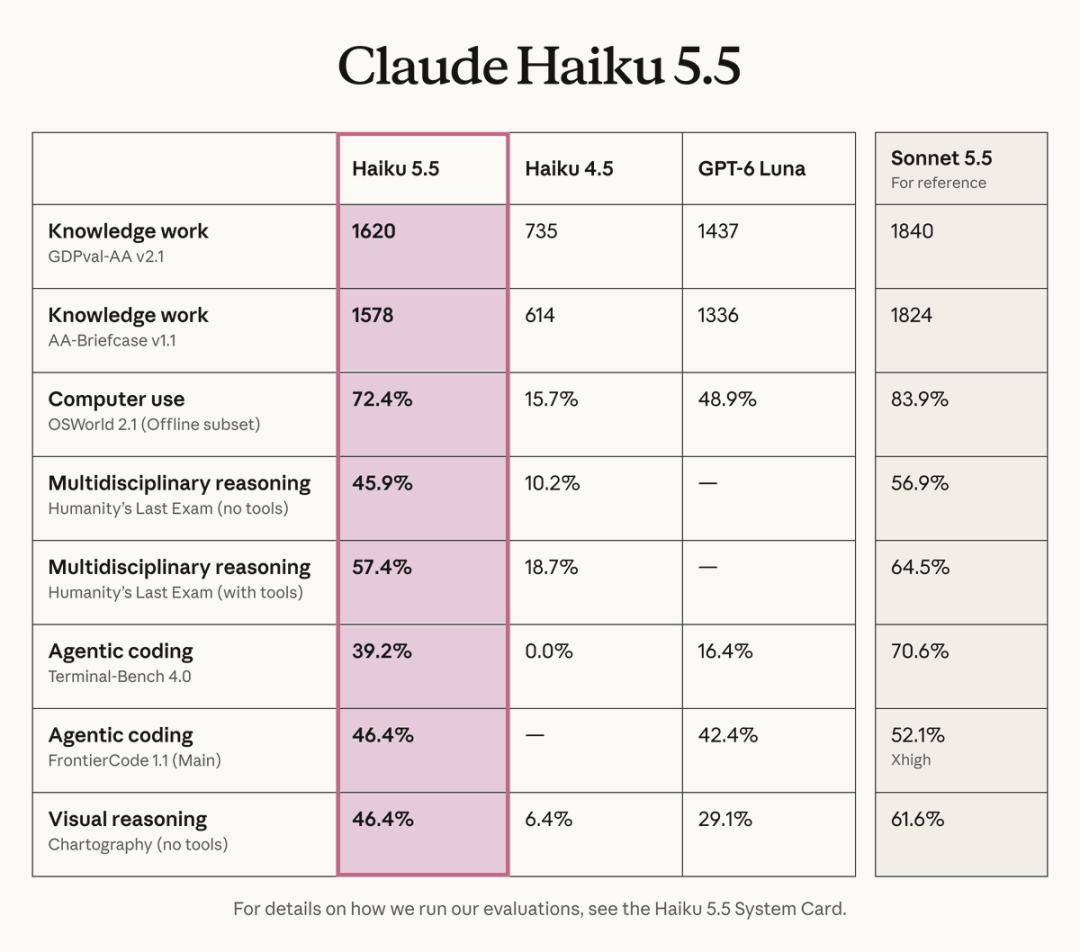
Los resultados del lanzamiento incluyen:
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1, subconjunto sin conexión | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity’s Last Exam, sin herramientas | 45.9% | 10.2% | — | 56.9% |
| Humanity’s Last Exam, con herramientas | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (principal) | 46.4% | — | 42.4% | 52.1% |
| Chartography, sin herramientas | 46.4% | 6.4% | 29.1% | 61.6% |
La conclusión no es que Haiku 5.5 sustituya de repente a todos los modelos más grandes.
La conclusión es que el nivel Claude más pequeño se ha vuelto mucho más capaz en los tipos de tareas que antes requerían un modelo de mayor tamaño.
Para prompts de hasta 100K tokens, Anthropic cobra:
Entrada de Haiku 5.5:  $0.10 / 1M tokens
Salida de Haiku 5.5:   $0.50 / 1M tokens
Lectura de caché:      $0.01 / 1M tokens
Escritura de caché:    $0.125 / 1M tokens
El precio estándar actual de GPT-6 Luna de OpenAI es:
Entrada de GPT-6 Luna:        $0.10 / 1M tokens
Entrada en caché de GPT-6 Luna: $0.01 / 1M tokens
Escritura de caché de GPT-6 Luna: $0.125 / 1M tokens
Salida de GPT-6 Luna:          $0.50 / 1M tokens
Por tanto, para el trabajo estándar de API con contexto corto, ambos modelos se alinean casi exactamente en las tarifas principales por token.
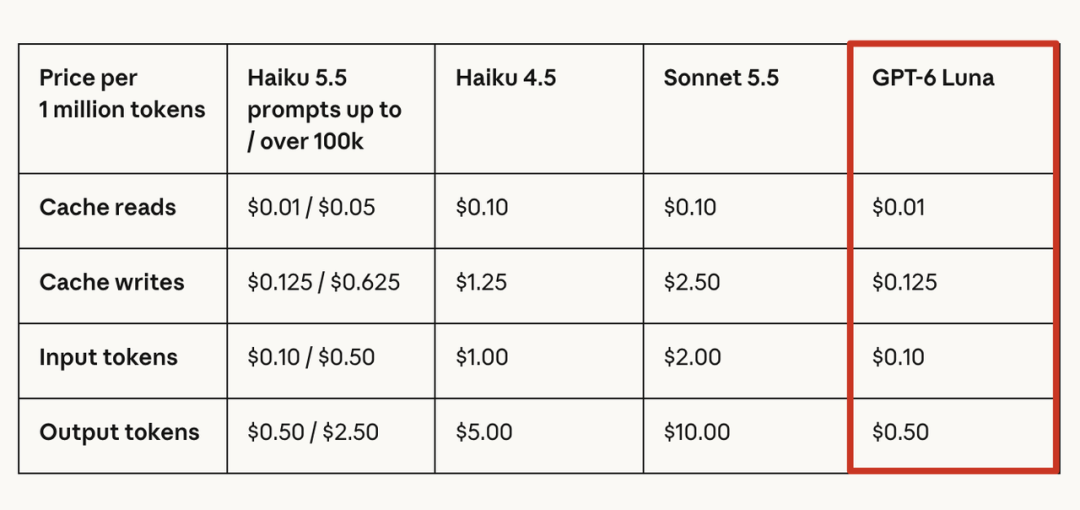
Haiku 5.5 utiliza dos niveles de precios.
| Tipo de token | Prompt ≤100K | Prompt >100K |
|---|---|---|
| Lectura de caché | $0.01/M | $0.05/M |
| Escritura de caché | $0.125/M | $0.625/M |
| Entrada | $0.10/M | $0.50/M |
| Salida | $0.50/M | $2.50/M |
Anthropic afirma que los prompts de hasta 100K tokens representaban aproximadamente el 90% de las solicitudes de Haiku 4.5, por lo que el nivel inferior cubre la mayoría del tráfico previsto.
Para prompts de más de 100K, Haiku 5.5 sigue siendo más barato que Haiku 4.5, pero el descuento es menor.
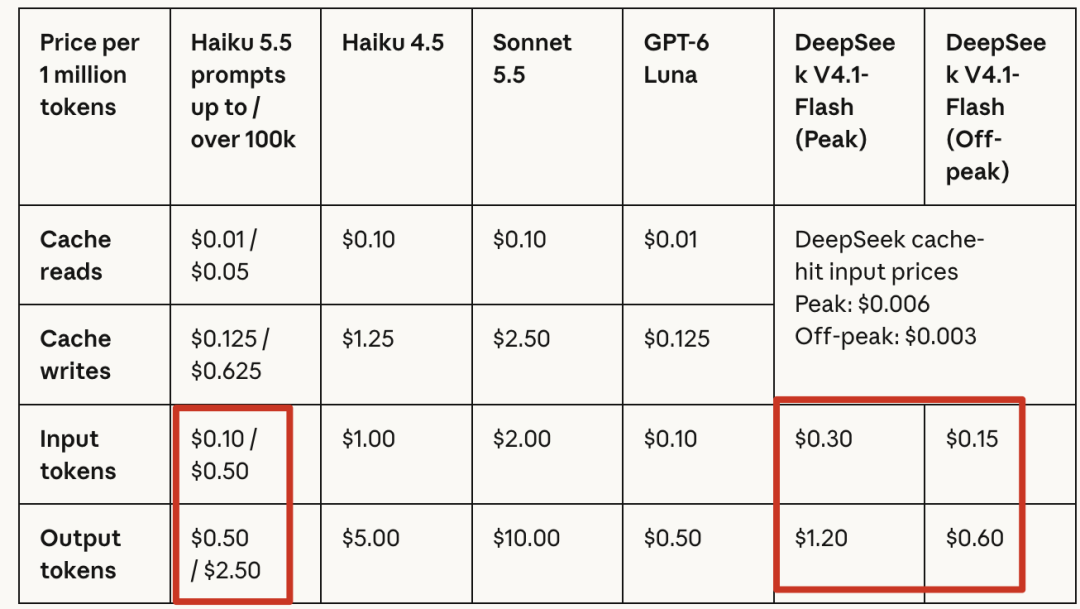
El artículo original compara Haiku 5.5 con DeepSeek-V4.1-Flash.
Los precios oficiales de DeepSeek utilizan actualmente tarifas de horas punta y horas valle.
Para la entrada sin coincidencia de caché y la salida:
| Modelo | Entrada / 1M | Salida / 1M |
|---|---|---|
| Haiku 5.5, prompt ≤100K | $0.10 | $0.50 |
| DeepSeek-V4.1-Flash, horas valle | $0.15 | $0.60 |
| DeepSeek-V4.1-Flash, horas punta | $0.30 | $1.20 |
DeepSeek sigue siendo más barato para la entrada con coincidencia de caché, especialmente en horas valle, por lo que el coste total continúa dependiendo de la estructura de la carga de trabajo.
La generación anterior de Haiku no era competitiva en tareas exigentes de uso de ordenadores.
Haiku 5.5 cambia esto de forma drástica.
El resultado de Anthropic en el subconjunto sin conexión de OSWorld 2.1 aumenta de 15.7% con Haiku 4.5 a 72.4% con Haiku 5.5 en el nivel máximo de esfuerzo.
El artículo original también realizó una prueba práctica: pidió a Haiku 5.5 que añadiera los datos de precios de GPT-6 y DeepSeek a la tabla de lanzamiento de Haiku.
En lugar de editar manualmente elementos HTML individuales mediante la interfaz, el modelo abrió la consola del navegador e inyectó los cambios mediante un script.
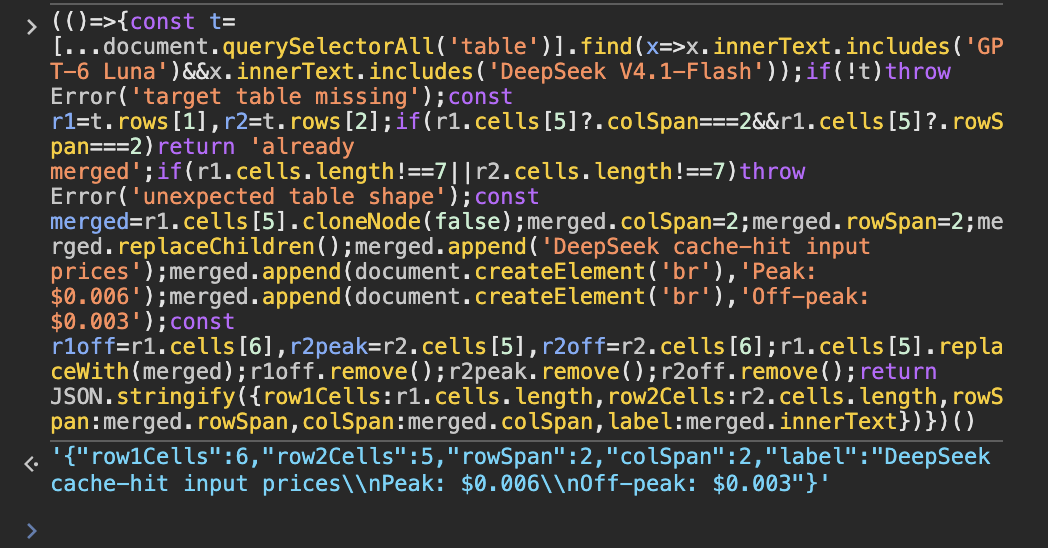
Este comportamiento es útil porque los agentes que utilizan ordenadores no siempre necesitan imitar literalmente los movimientos del ratón de una persona.
Si un entorno de navegador ofrece una vía de ejecución más directa, utilizar un script puede ser más rápido y fiable que hacer clic en cada celda.
Haiku 5.5 es el primer modelo de la clase Haiku con un control de esfuerzo ajustable.
El modelo admite un espectro que va desde un comportamiento más rápido y de menor coste hasta un razonamiento más deliberado y costoso.
El gráfico de lanzamiento de Anthropic muestra una curva clara de precisión frente a coste en OSWorld.
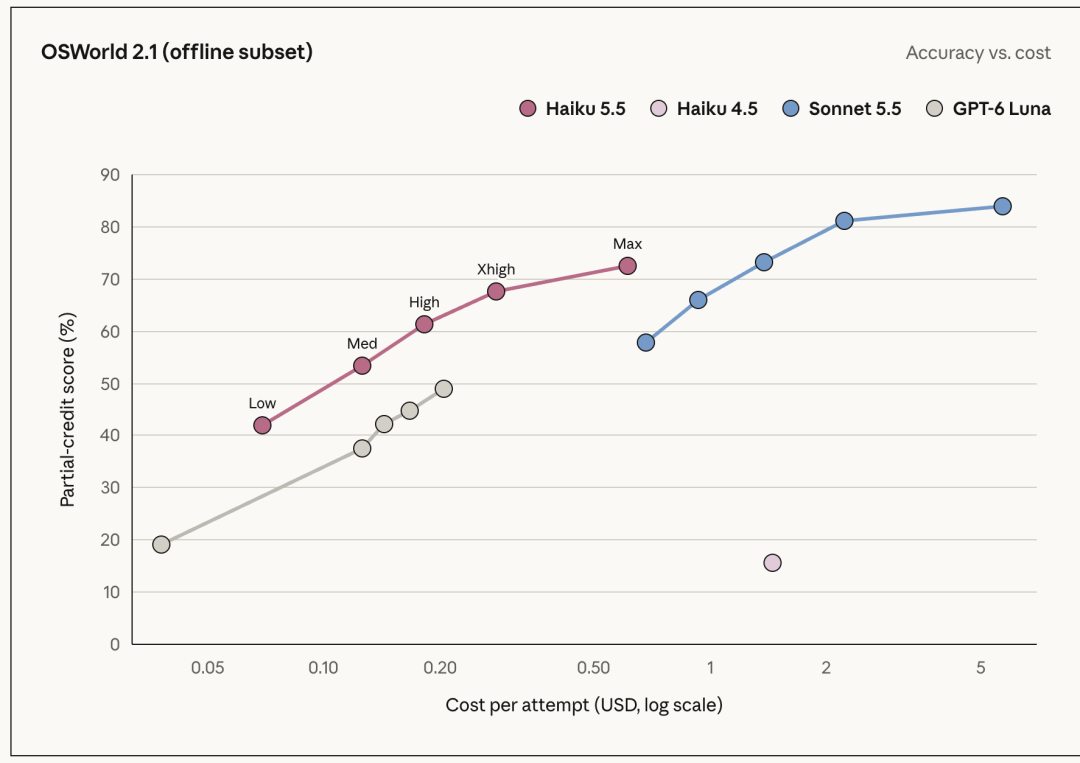
El artículo original destaca dos puntos de esa curva:
El coste exacto de una tarea de producción variará según la longitud del prompt, la longitud de la salida, el uso de caché y el uso de herramientas, pero el patrón general es importante.
Ahora puedes ajustar Haiku según el trabajo, en lugar de tratar el concepto de modelo pequeño como un único nivel fijo de capacidad.
GDPval-AA v2.1 mide trabajo profesional del mundo real en 44 ocupaciones.
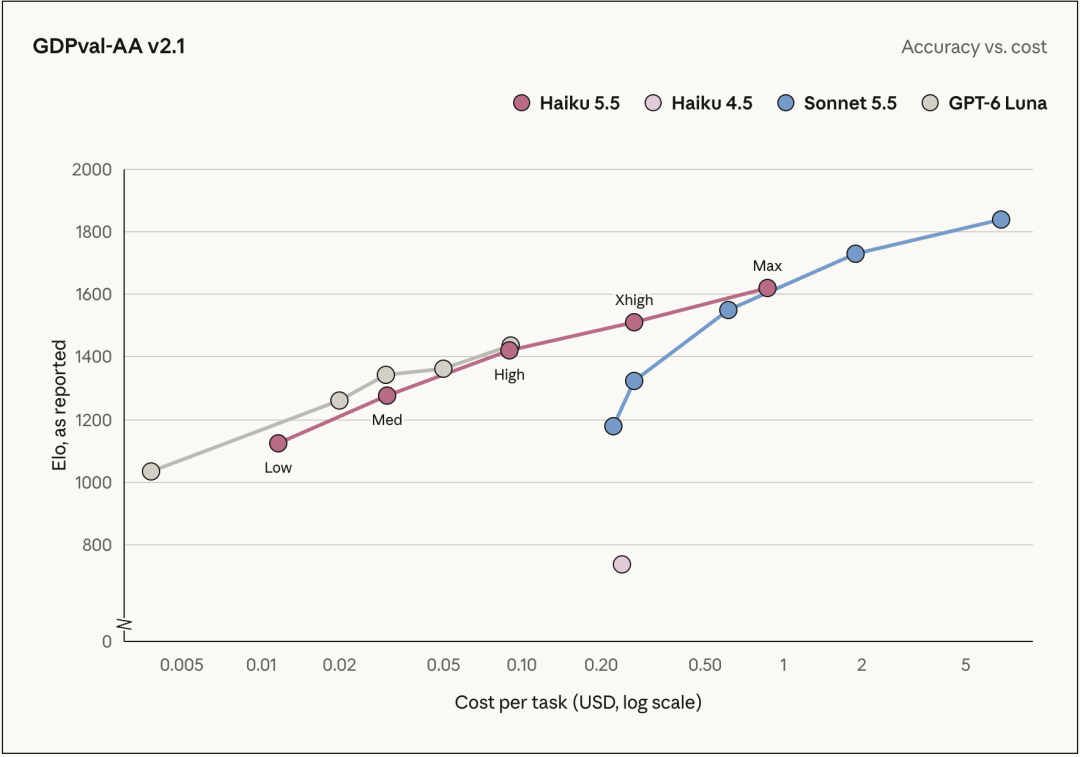
En el nivel máximo de esfuerzo, Anthropic informa de un Elo de 1620 para Haiku 5.5, frente a 735 para Haiku 4.5.
Una vez más, Sonnet 5.5 sigue siendo más potente, pero la distancia entre «pequeño» y «útil para uso profesional» se ha reducido considerablemente.
Haiku 5.5 introduce un tokenizador más reciente, compartido con las generaciones más nuevas de Claude.
Esto es importante porque el mismo texto no produce el mismo número de tokens que en Haiku 4.5.
La guía de migración de Anthropic afirma que el mismo texto de entrada produce aproximadamente un 30% más de tokens en Haiku 5.5 que en Haiku 4.5, aunque el aumento exacto depende del contenido.
El impacto puede ser mayor o menor según la carga de trabajo. El código, las tablas y el texto en idiomas distintos del inglés merecen una nueva medición específica.
Esto significa que la siguiente comparación es demasiado simple:
Precio de entrada anterior: $1.00
Precio de entrada nuevo: $0.10
Por tanto, cada tarea es exactamente un 90% más barata
El cálculo más adecuado es:
coste real de la tarea
= nuevo número de tokens
× nuevo precio por token
+ coste de caché
+ coste de salida
+ coste de herramientas
La propia Anthropic afirma que, después de tener en cuenta los cambios del tokenizador, Haiku 5.5 cuesta aproximadamente un 75% menos de media que Haiku 4.5, en lugar de aplicar una reducción uniforme del 90% a todas las tareas.
Artificial Analysis también muestra por qué la eficiencia de tokens importa al comparar modelos económicos.
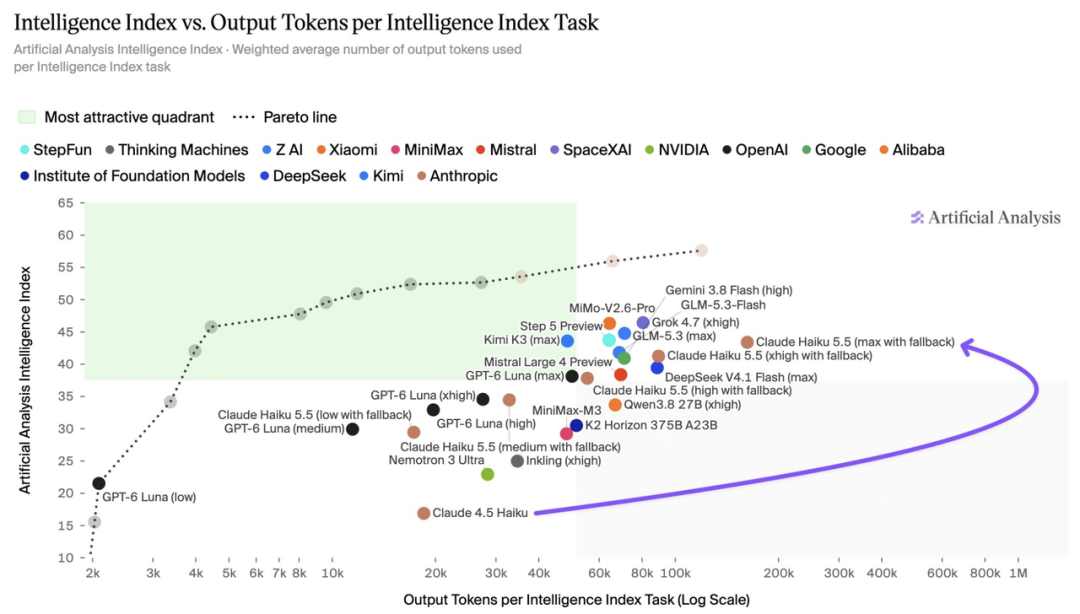
Un modelo puede tener un precio bajo por token y, aun así, utilizar muchos más tokens de salida para completar una tarea.
En los sistemas de producción, el coste por tarea completada es más útil que el precio por millón de tokens por sí solo.
El artículo original lo deja claro: la «taza pequeña» sigue siendo la taza pequeña.
Haiku 5.5 es mucho más potente que Haiku 4.5, pero la programación autónoma compleja sigue siendo un trabajo para modelos más grandes.
Terminal-Bench 4.0 muestra la diferencia:
Haiku 5.5:  39.2%
Sonnet 5.5: 70.6%
Anthropic recomienda explícitamente Sonnet 5.5 u Opus 5.5 para la programación agéntica compleja.
Haiku 5.5 es más adecuado para tareas que ya están bien delimitadas:
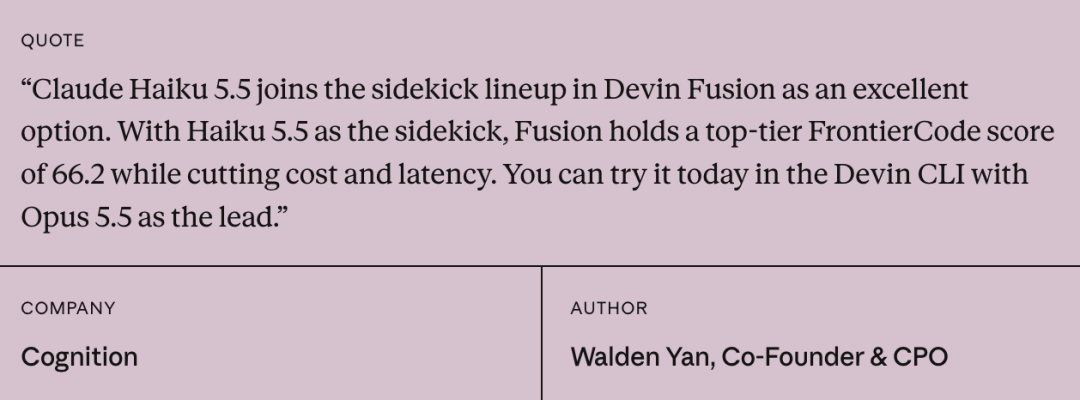
Cognition ya utiliza esta estructura en Devin Fusion.
La página de lanzamiento afirma que Opus 5.5 puede actuar como líder mientras Haiku 5.5 trabaja como asistente.
Esa combinación alcanzó una puntuación de 66.2 en FrontierCode en la configuración comunicada por Cognition, al tiempo que redujo el coste y la latencia.
El patrón es sencillo:
Opus / Sonnet
→ planificación, descomposición y decisiones difíciles

Haiku 5.5
→ subtareas específicas, ejecución en paralelo, consultas rápidas y resúmenes
Probablemente esta sea una forma más realista de utilizar Haiku 5.5 que intentar sustituir a un modelo más grande en todas partes.
Si una aplicación ya utiliza Haiku 4.5, Anthropic advierte que varios cambios pueden romper las solicitudes existentes.
El ID oficial del modelo es ahora:
claude-haiku-5-5
Sin embargo, la migración incluye varios requisitos adicionales.
Una solicitud de Haiku 4.5 como esta ya no es válida:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Haiku 5.5 utiliza en su lugar razonamiento adaptativo y controles de esfuerzo:
{
  "thinking": {
    "type": "adaptive"
  },
  "output_config": {
    "effort": "medium"
  }
}
Una solicitud que envíe el formato antiguo de budget_tokens devuelve un error 400.
El razonamiento adaptativo también está activado de forma predeterminada, por lo que las aplicaciones no deben asumir que el primer bloque de contenido de la respuesta siempre es texto de respuesta normal.
Analiza los bloques según su type.
max_tokensComo el nuevo tokenizador cuenta el mismo texto como un mayor número de tokens, los valores antiguos de max_tokens pueden dejar de proporcionar espacio suficiente para una salida equivalente.
Los tokens de razonamiento también cuentan para el presupuesto de salida.
Vuelve a contar los prompts utilizando claude-haiku-5-5 en lugar de reutilizar las estimaciones de tokens de Haiku 4.5.
Haiku 5.5 ya no admite configuraciones de muestreo arbitrarias del mismo modo que Haiku 4.5.
Anthropic recomienda omitir:
temperature
top_p
top_k
Los valores distintos de los predeterminados pueden producir errores 400, y top_k no se acepta.
Las aplicaciones que utilizaban parámetros de muestreo para generar variaciones creativas deben trasladar ese control a los prompts o a otra estrategia a nivel de aplicación.
Haiku 4.5 podía continuar a partir de un mensaje final del asistente en algunas configuraciones.
Haiku 5.5 rechaza el prefilling del asistente.
Si antes utilizabas un prefijo como:
{"result":
para forzar una salida JSON, migra a salidas estructuradas o a un esquema de herramientas.
Para las integraciones de Claude API y Google Cloud, la antigua declaración de uso de ordenadores:
computer_20250124
debe sustituirse por:
computer_toolset_20260801
El nuevo conjunto de herramientas tiene una estructura de eventos diferente, por lo que el bucle del agente debe distribuir correctamente los bloques de uso de herramientas devueltos y conservar toolset_name en los resultados.
Haiku 5.5 también admite el conjunto de herramientas de uso de navegadores de Anthropic para tareas web en las plataformas compatibles.
Antes de desplegar Haiku 5.5, comprueba al menos estos puntos:
claude-haiku-5-5.budget_tokens por razonamiento adaptativo y esfuerzo.type en lugar de asumir que el bloque cero contiene texto de respuesta.computer_toolset_20260801 cuando sea necesario.refusal.Anthropic también proporciona un comando automatizado de migración para Claude Code:
/claude-api migrate this project to claude-haiku-5-5
La herramienta puede aplicar cambios en el ID del modelo y detectar varios patrones de solicitud incompatibles, pero se sigue recomendando una verificación manual.
Haiku 5.5 no fue el único cambio de precios anunciado por Anthropic.
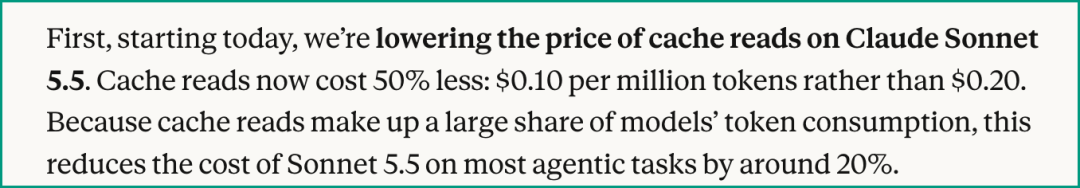
El precio de lectura de caché de Sonnet 5.5 bajó de:
$0.20 / 1M tokens
a:
$0.10 / 1M tokens
Anthropic afirma que las lecturas de caché representan una parte importante del consumo de tokens en muchos flujos de trabajo agénticos, por lo que este cambio reduce aproximadamente un 20% el coste de la mayoría de las tareas agénticas de Sonnet 5.5.
Esto hace más atractiva una arquitectura de modelos mixtos:
Sonnet 5.5
→ planificación y ejecución más compleja

Haiku 5.5
→ subtareas económicas de gran volumen
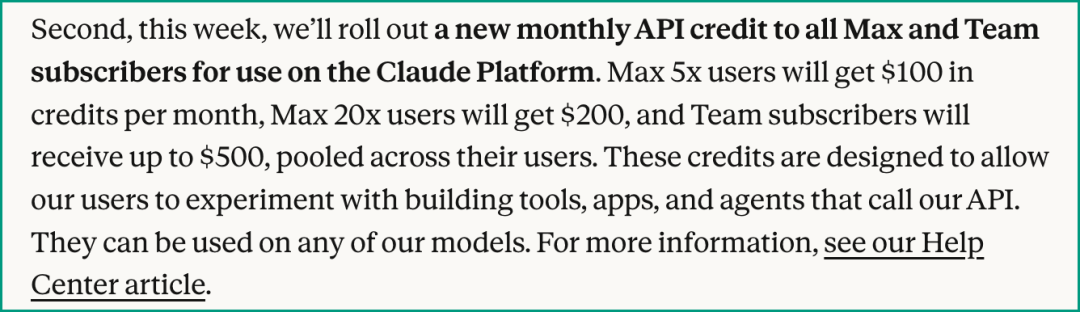
Anthropic también introdujo créditos mensuales de Claude Platform para los suscriptores Max y Team que cumplen los requisitos.
Los importes oficiales actuales de los créditos son:
| Plan | Crédito mensual de API |
|---|---|
| Max 5x | $100 |
| Max 20x | $200 |
| Asiento Team Standard | $20 por asiento |
| Asiento Team Premium | $100 por asiento |
| Máximo común del equipo | $500 |
Los créditos pueden utilizarse para cargas de trabajo de Claude Platform, como:
No aumentan los límites de uso de la suscripción de Claude o Claude Code del usuario, y no cubren las sesiones interactivas normales de Claude Code cuando se facturan mediante el plan de suscripción.
Los créditos están vinculados a una organización de Claude Console y no se acumulan indefinidamente.
El artículo original termina con una comparación más desenfadada.
Mientras Anthropic anunciaba modelos más baratos, lecturas de caché de Sonnet más económicas y créditos mensuales de API, Thibault Sottiaux, responsable de Codex y ChatGPT Work en OpenAI, anunció otro reinicio acumulable para las cuentas de pago mientras celebraba 40 millones de usuarios activos entre Codex y ChatGPT Work.
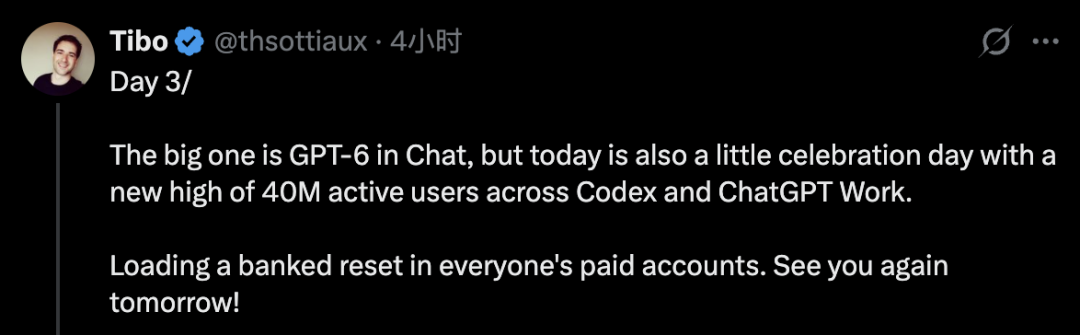
Un reinicio acumulable es diferente de una reducción permanente de precios.
Se trata de un reinicio adicional de uso que los usuarios elegibles pueden guardar y canjear, no de un cambio en el precio continuo por token del modelo.
Por tanto, la comparación es más retórica que técnica:
Lanzamiento de Anthropic:
modelo pequeño nuevo + menor precio de lectura de caché + créditos mensuales de API

Actualización de OpenAI:
reinicio de uso acumulable adicional para cuentas de pago de Codex / Work
Ambas iniciativas intentan ofrecer a los usuarios intensivos más margen para experimentar, pero funcionan mediante mecanismos diferentes.
El lanzamiento hace que Haiku sea mucho más útil, pero su función ideal sigue estando relativamente clara.
Utiliza Haiku 5.5 para:
Prefiere un modelo Claude más grande para:
El modelo más barato no siempre es la forma más barata de terminar un trabajo.
En los sistemas de producción, mide:
coste por tarea completada
=
entrada + caché + salida + uso de herramientas + reintentos + fallos
Esta métrica te dirá más que el precio principal de entrada de un modelo.
Claude Haiku 5.5 es el último modelo pequeño de Claude de Anthropic, lanzado para cargas de trabajo de gran volumen y sensibles al coste y la latencia. También es el primer modelo Haiku con esfuerzo ajustable y es considerablemente más potente que Haiku 4.5 en evaluaciones de programación, uso de ordenadores y trabajo profesional.
Para prompts de hasta 100K tokens, cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Para prompts de más de 100K, las tarifas aumentan a $0.50 por la entrada y $2.50 por la salida por millón de tokens, con precios independientes para la lectura y escritura de caché.
En los precios estándar por token para contextos cortos, sus tarifas principales de entrada, entrada en caché, escritura de caché y salida están prácticamente alineadas. El precio de Haiku 5.5 aumenta por encima del umbral de prompts de 100K, por lo que las cargas de trabajo con contexto largo deben compararse por separado.
No. Los propios resultados de Anthropic en Terminal-Bench 4.0 muestran un 70.6% para Sonnet 5.5 frente a un 39.2% para Haiku 5.5. Haiku está mejor posicionado para tareas específicas, repetibles y de gran volumen, así como para el trabajo de subagentes, mientras que Sonnet y Opus siguen siendo mejores para la programación autónoma compleja.
Haiku 5.5 utiliza un tokenizador más reciente. La guía de migración de Anthropic afirma que el mismo texto produce aproximadamente un 30% más de tokens de media que en Haiku 4.5, aunque el aumento exacto depende del contenido.
Sí. Entre los cambios importantes se incluyen el razonamiento adaptativo en lugar de budget_tokens manual, un comportamiento revisado de los parámetros de muestreo, la eliminación del prefilling del asistente, un nuevo conjunto de herramientas para el uso de ordenadores y la necesidad de analizar los bloques de respuesta según su type. Anthropic proporciona una guía de migración oficial y un comando de migración para Claude Code.
En Claude API, el ID del modelo es claude-haiku-5-5. Anthropic documenta los ID correspondientes para Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform en AWS.
Los suscriptores Max y Team que cumplen los requisitos pueden reclamar créditos mensuales de Claude Platform. Max 5x recibe $100, Max 20x recibe $200 y los créditos de Team se calculan según el tipo de asiento, con un máximo común de $500 al mes.
Claude Haiku 5.5 es una actualización importante de la gama de modelos pequeños de Anthropic. Supera ampliamente a Haiku 4.5 en uso de ordenadores, trabajo profesional, programación y razonamiento, al tiempo que iguala los precios principales de API de GPT-6 Luna para contextos cortos y supera a Luna en varias comparaciones de benchmarks publicadas por Anthropic.
La reducción de precio es real, pero los equipos de producción no deben ignorar el nuevo tokenizador ni el límite de precios para prompts de 100K. El mismo texto puede consumir aproximadamente un 30% más de tokens que en Haiku 4.5, y los prompts largos utilizan el nivel de precios superior.
La migración también incluye cambios incompatibles reales: el razonamiento adaptativo sustituye a los presupuestos de razonamiento manuales, los controles de muestreo personalizados están restringidos, el prefilling del asistente se elimina y las integraciones de uso de ordenadores necesitan el nuevo conjunto de herramientas. Las aplicaciones existentes de Haiku 4.5 deben seguir la guía de migración en lugar de limitarse a cambiar el nombre del modelo.
Haiku 5.5 debe entenderse como un modelo de ejecución rápido y económico para trabajar a escala y con subagentes, no como un sustituto universal de Sonnet u Opus en trabajos complejos y de largo horizonte.
Empieza con una sola frase y obtén un sitio completo en minutos.