Un nuevo patrón de prompt de Claude Opus 5 se está difundiendo rápidamente en la comunidad de programación con IA, permitiendo a los desarro...
Un nuevo patrón de indicaciones para Claude Opus 5 se está difundiendo rápidamente en la comunidad de programación con IA, ya que los desarrolladores lo están utilizando para crear prototipos de juegos de navegador sorprendentemente pulidos a partir de instrucciones iniciales breves.
Este método ahora se conoce como el "Bucle de Prueba" (Gauntlet Loop).
La idea central es simple: no permitas que el mismo agente construya una vez, evalúe su propio trabajo y se detenga ahí. Dale al agente principal un objetivo de alto nivel, haz que divida el proyecto en partes más pequeñas, asigne constructores especializados y utilice agentes de revisión independientes para comparar la salida real con estándares de calidad específicos.
Si el resultado generado no supera la comparación, se devuelve para otra ronda de iteración.
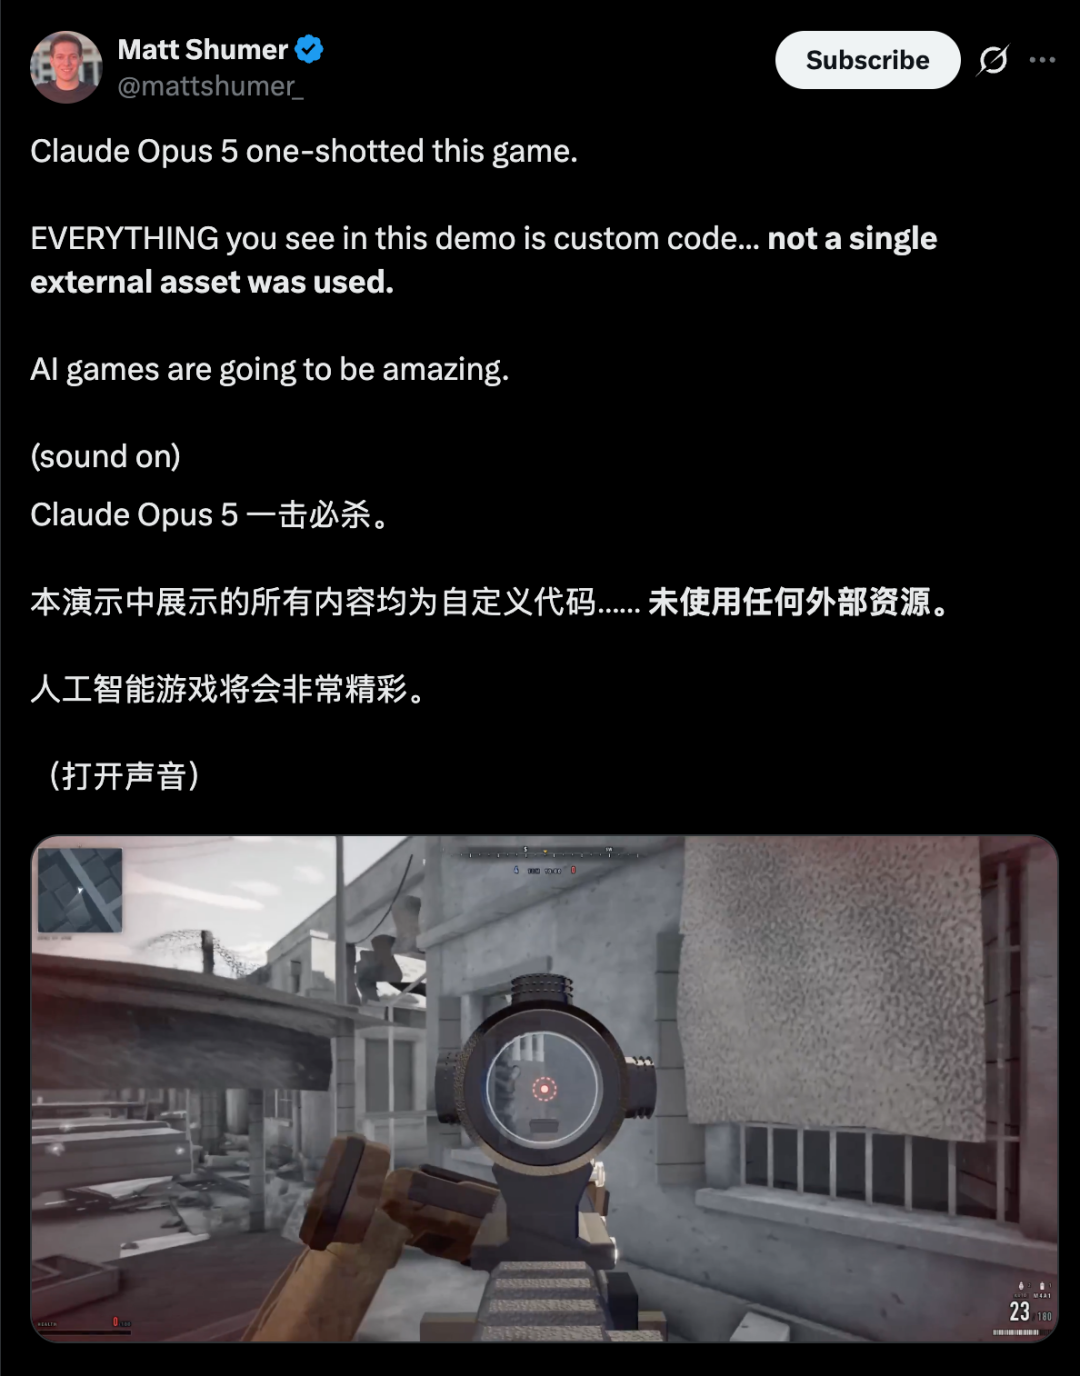
Matt Shumer popularizó este método después de crear un juego de disparos en primera persona para navegador inspirado en los juegos modernos de Call of Duty, utilizando Claude Code y Opus 5. Posteriormente publicó las indicaciones, el código fuente y la explicación del flujo de trabajo.
Otro desarrollador, Anshu Chimala, adoptó un flujo de trabajo similar para construir "El Largo Silencio" (The Long Silence), un juego de exploración espacial procedural que se ejecuta en el navegador.
Estos proyectos deben describirse con precisión. No demuestran que una sola indicación pueda producir inmediatamente un juego AAA de calidad comercial. Demuestran que un agente de codificación potente, cuando se le proporcionan herramientas, subagentes, tiempo de ejecución prolongado, umbrales de calidad medibles y verificación repetida, puede llevar un prototipo mucho más lejos de lo que una indicación tradicional de un solo intento podría lograr.
La tarea inicial de Shumer estableció un objetivo deliberadamente extremo: construir un juego de disparos en primera persona con una ambición visual comparable a la de un título AAA moderno.
La parte clave no era el género del juego, sino la estructura de evaluación.
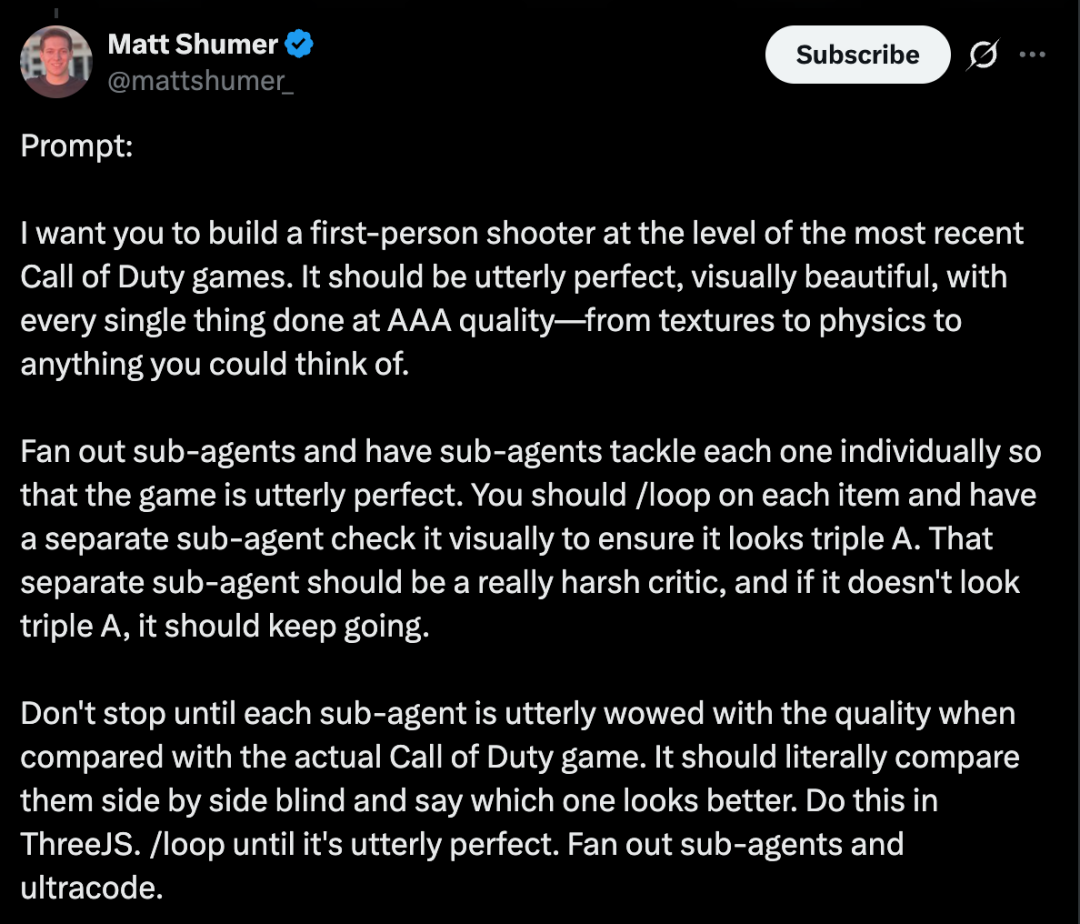
El flujo de trabajo indicaba al agente:
Shumer más tarde formalizó este método como el "Bucle de Prueba" (Gauntlet Loop).
La versión simplificada se muestra a continuación:
Objetivo
  ↓
Agente principal
  ↓
Descomposición de tareas
  ↓
Agentes constructores
  ↓
Salida real
  ↓
Revisión independiente
  ↓
Comparación con referencia
  ↓
¿Aprueba? ── Sí → Integración
  │
  No
  ↓
Explicar la mayor brecha
  ↓
El constructor mejora
  ↓
Repetir
"Mejorar" es una retroalimentación débil, porque el modelo debe definir por sí mismo qué significa "mejor".
El "Bucle de Prueba" le da al evaluador un punto de referencia externo.
Para juegos, pueden ser capturas de pantalla de obras comerciales consolidadas.
Para sitios web, pueden ser varios sitios líderes en la misma categoría.
Para ingeniería de backend, podría ser:
El objetivo no tiene que ser completamente alcanzable. Su función es evitar que el agente declare éxito prematuramente.
La segunda regla clave es la independencia.
El constructor conoce la razón detrás de cada elección que hizo, y le resulta fácil defender sus propios resultados. En cambio, un evaluador completamente nuevo recibe el artefacto real, sin conocer los pormenores de la implementación.
Para trabajos visuales, el evaluador puede examinar los píxeles renderizados.
Para software, el evaluador puede revisar las pruebas y el comportamiento en tiempo de ejecución.
Para trabajos de rendimiento, el evaluador puede revisar mediciones reales.
El principio más amplio es: la generación y la evaluación deben ser dos cosas separadas.
La demostración inicial de Shumer se ha publicado públicamente como Claude of Duty.
Su repositorio en GitHub describe un juego de disparos en primera persona basado en Three.js y WebGL2, con aproximadamente 55,000 líneas de código distribuidas en unos 11 subsistemas.
El repositorio indica que el juego no utiliza ningún recurso artístico externo. Las texturas, mallas, animaciones y sonidos se generan proceduralmente mediante código.
Sus sistemas incluyen:
Decir que el proyecto se completó "de un solo golpe" no significa que todo apareciera en una sola respuesta. Según Shumer, una indicación de alto nivel inició una sesión de Claude Code de larga duración, que luego derivó subagentes, escribió archivos, ejecutó herramientas, renderizó el juego, inspeccionó la salida y modificó continuamente.
El repositorio incluye las siguientes herramientas:
Su archivo README también es más cauteloso que algunas publicaciones virales: establece claramente que el proyecto final no alcanza el nivel de los juegos modernos de Call of Duty.
Esto hace que el experimento sea aún más valioso. El verdadero resultado no es "la IA ya ha reemplazado a los estudios AAA", sino que: un punto de referencia alto establecido deliberadamente permite que el agente continúe trabajando mucho tiempo después de que una indicación normal ya se habría detenido.
Posteriormente, Anshu Chimala aplicó un flujo de trabajo similar a The Long Silence, un juego de exploración espacial procedural para navegador construido con Claude Opus 5.

El repositorio público indica que el juego utiliza renderizado en navegador estilo WebGL2 y Three.js, junto con GLSL personalizado.
También emplea generación de contenido procedural basada en semillas, en lugar de descargar bibliotecas tradicionales de recursos artísticos.
El artículo fuente describe un proceso de desarrollo de aproximadamente 24 horas, dividido principalmente en tres fases.
La primera solicitud fue crear un juego de exploración espacial usando Three.js.
Los requisitos se mantuvieron deliberadamente a alto nivel:
La mayor parte de la construcción del mundo y la arquitectura técnica quedó a criterio del agente.
Esto sigue el principio central del método:
Define el destino, no la ruta.
El artículo fuente también menciona que Claude Code se conectó a herramientas relacionadas con Blender durante el proceso. El repositorio público incluye un directorio de habilidades de Claude para modelado de superficies duras en Blender, lo que confirma que las instrucciones reutilizables de Blender ya forman parte del proyecto.
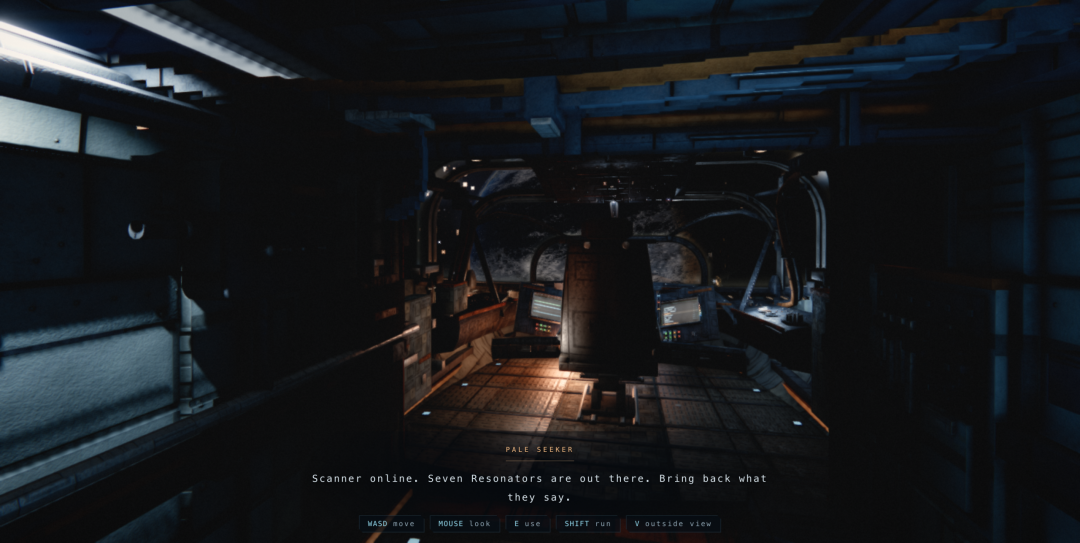
Tras completar la primera versión jugable, el proyecto entró en una larga fase de refinamiento visual.
Múltiples subagentes manejaron diferentes áreas, mientras que un agente evaluador comparaba capturas de pantalla con imágenes de referencia de juegos espaciales pulidos.
El objetivo no era simplemente decirle a Opus 5 "haz que el juego se vea mejor". El agente evaluador debía identificar diferencias visibles y enviar las áreas débiles de vuelta para otra iteración.
El artículo fuente menciona que obras como Starfield se utilizaron como referencia de calidad.
El bucle largo también necesitaba condiciones de detención. Puntos de corte útiles incluyen:
El bucle es un mecanismo de presión, no una garantía de que el resultado final será "perfecto".
El proceso no fue completamente autónomo.
Según el artículo fuente, Chimala supervisó el progreso de forma remota e intervino cuando el agente dedicaba demasiado esfuerzo a una sola área.
Una vez finalizado el bucle largo, se utilizaron sesiones adicionales de Claude para:
Posteriormente, se pidió al modelo que resumiera las lecciones reutilizables en forma de una habilidad.
El repositorio público contiene:
.claude/skills/blender-hardsurface
Este es un patrón útil para el trabajo de agentes de larga duración. Un proyecto no solo produce artefactos, sino que también puede consolidar conocimiento operativo reutilizable: qué herramientas funcionan, qué pruebas importan, qué falló y cómo deberían estructurarse las tareas futuras.
Una de las partes más destacadas del repositorio público es el
conjunto de herramientas de validación.
El README documenta los siguientes comandos:
node tools/play.mjs
node tools/survey.mjs
node tools/probe.mjs "" --shot out.png
node tools/sheet.mjs a.png b.png --out s.png
node tools/levels.mjs shots/*.png
node tools/judgeset.mjs
Los usos documentados de estos comandos incluyen:
play.mjs: 17 aserciones interactivas que cubren vuelo, escaneo, plegado y saltosurvey.mjs: capturas de pantalla de las escenas principales e informes de rendimientoprobe.mjs: ejecución de una expresión de navegador y una sola captura de pantallasheet.mjs: hoja de contactos con miniaturas para comparación visuallevels.mjs: estadísticas de tono y exposiciónjudgeset.mjs: reconstrucción del conjunto de evaluación visual
El punto clave es que el agente no solo creó el juego en sí, sino también los mecanismos para evaluarlo.
Esta es una de las razones por las que un agente de larga duración puede mejorar de manera más fiable que un flujo de trabajo simple de "generar y detenerse".
El README documenta varias decisiones gráficas prácticas:
El repositorio también indica que la validación en navegador se ejecutó en instancias reales de Chromium con rasterización GPU habilitada.
Estos detalles son importantes porque demuestran cómo el modelo maneja restricciones de ingeniería familiares: rendimiento, precisión, reproducibilidad, comportamiento del navegador y calidad visual.
The Long Silence se puede jugar públicamente en el navegador.
Su repositorio ofrece comandos de desarrollo estándar:
npm install
npm run dev
npm run build
El juego incluye vuelo espacial, escaneo, entornos procedurales, navegación, objetivos de exploración y múltiples sistemas de interfaz.
Esto lo convierte en algo más que un modelo estático.
Pero aún no equivale a un juego comercial AAA desarrollado durante varios años por un gran estudio.
La producción de nivel AAA suele requerir grandes equipos responsables de:
La conclusión más sólida es esta: un solo desarrollador hoy puede orquestar agentes de codificación de vanguardia para crear prototipos jugables, visualmente ambiciosos y técnicamente no triviales, a una velocidad que antes no era viable en la práctica.
Los desarrolladores de la comunidad comenzaron a reutilizar este patrón
Después de que Shumer publicara el prompt y el código, este flujo de trabajo se difundió rápidamente.
Ryan Campbell adoptó un patrón similar
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Impulsó de forma iterativa un proyecto de kart racing en el navegador, refinando continuamente el renderizado, los controles, el comportamiento de la cámara y el rendimiento en dispositivos móviles.
El directorio Gauntlet Loop que Shumer hizo público más tarde mostró experimentos de carreras jugables en el navegador creados con este método.
El diseñador Yogi Suria compartió un proyecto Three.js de estilo cyberpunk, inspirado en el mismo patrón de prompt.
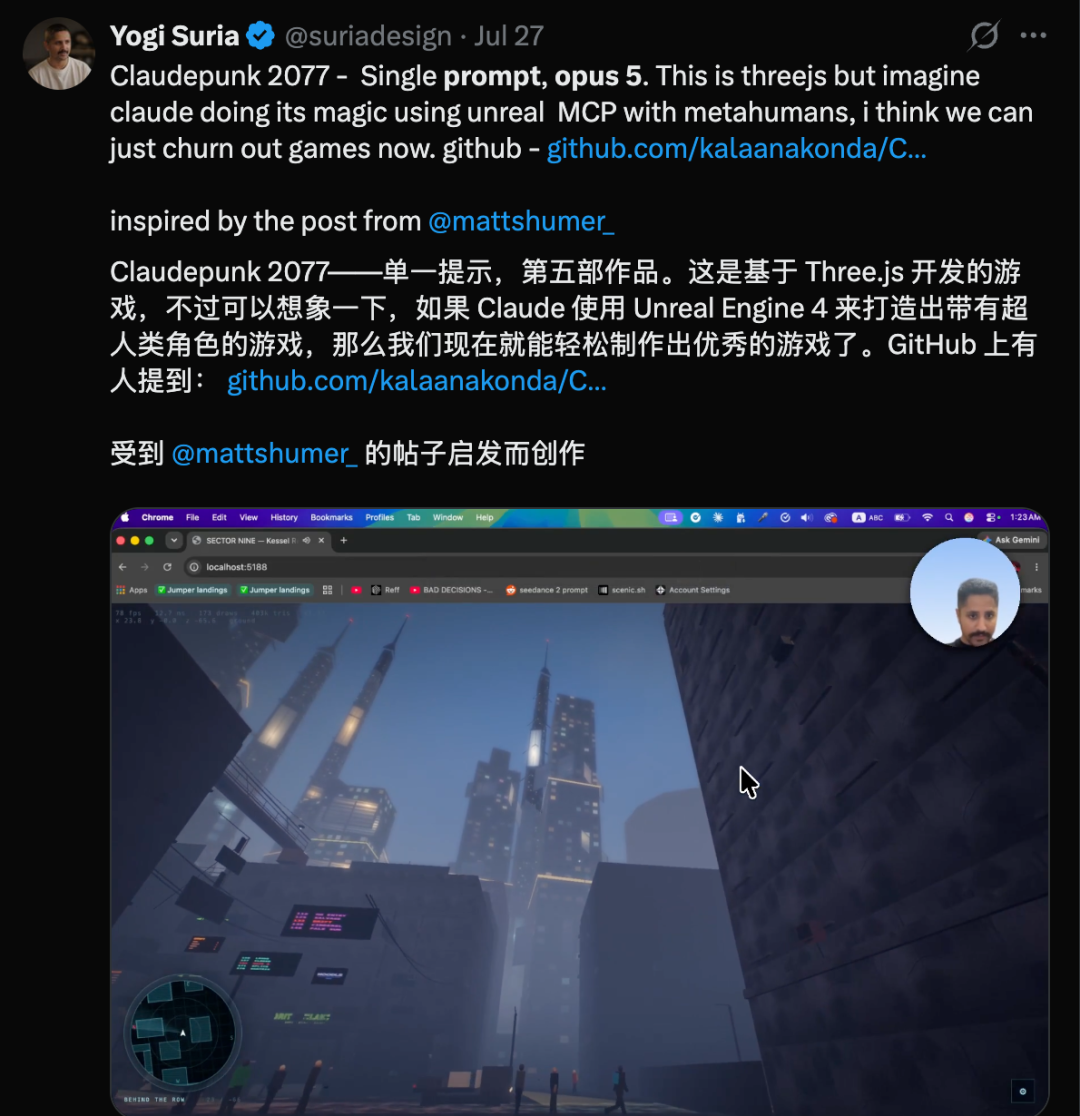
Este ejemplo demuestra que el método no se limita a un solo género de juego. La referencia objetivo, la dirección artística y la cadena de herramientas pueden cambiar, pero la estructura de "construir-criticar-repetir" permanece constante.
La fuente también mostró a un desarrollador que intentó un prompt similar con GPT-5.6 Sol a través de Codex.
El desarrollador informó que el tiempo de construcción fue de aproximadamente dos horas y describió el resultado como bueno, aunque no tan pulido como la demostración de Shumer.
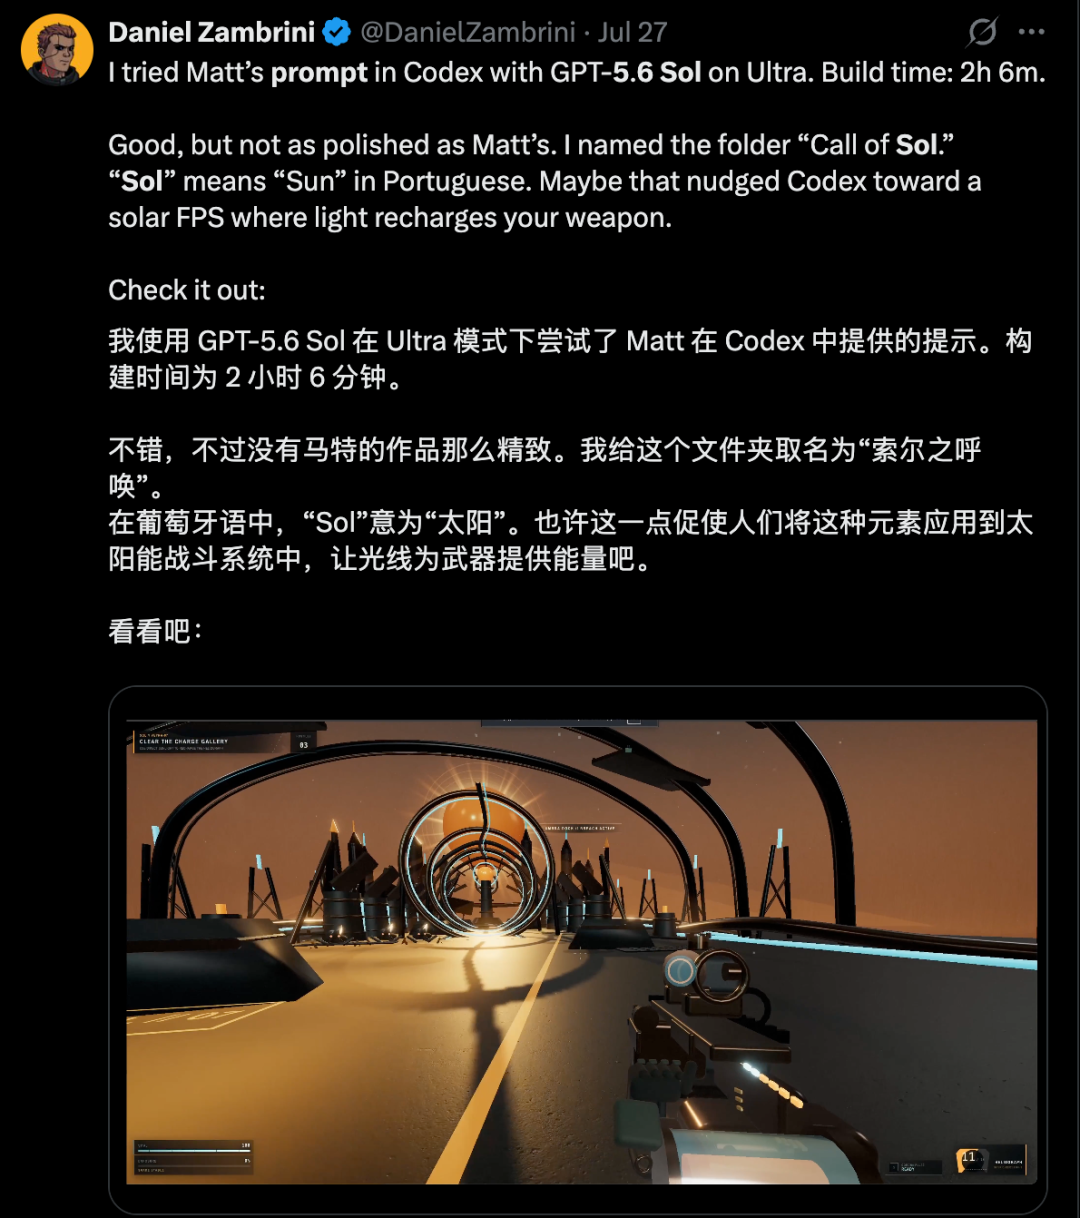
Esto demuestra que Gauntlet Loop no es, en esencia, exclusivo de Claude.
El patrón depende de un entorno de agente con las siguientes capacidades:
Diferentes modelos pueden tener un rendimiento distinto dentro del bucle, pero la arquitectura es trasladable.
El flujo de generación tradicional suele ser así:
Usuario → Modelo → Salida → Usuario
Gauntlet Loop añade una capa de evaluación:
Usuario
  ↓
Agente principal
  ↓
Constructor
  ↓
Artefacto
  ↓
Crítico independiente
  ↓
Medición de brechas
  ↓
Revisión del constructor
  ↓
Nuevo artefacto
Esto crea más oportunidades para detectar resultados de baja calidad antes de la entrega.
Que el agente diga "la página ahora debería ser responsive" no es tan contundente como abrir la página en un ancho de móvil y comprobarlo realmente.
"El juego debería ser más rápido" no es tan contundente como medir el tiempo de fotograma.
"El renderizado se ve mejor" no es tan contundente como comparar capturas de pantalla.
Las mejores señales de retroalimentación están arraigadas en artefactos reales.
El constructor recuerda cada compromiso que hizo.
Esto puede sesgar la revisión.
Un crítico independiente puede plantear una pregunta más simple: ¿el resultado realmente cumple con el estándar?
Esto refleja los flujos de trabajo humanos. Los desarrolladores usan pruebas y revisiones de código. Los diseñadores usan revisiones visuales y pruebas de usuario. Los escritores usan editores.
Los agentes de IA pueden reproducir esta separación con mayor frecuencia.
Anthropic lanzó Claude Opus 5 el 24 de julio de 2026.
Su comunicado oficial
destaca un mejor desempeño en codificación, trabajo de múltiples pasos de larga duración, verificación e iteración.
Anthropic señaló específicamente que Opus 5 rinde mejor en:
Estos comportamientos se alinean perfectamente con Gauntlet Loop.
El prompt no otorga al modelo capacidades nuevas. Crea una estructura que obliga repetidamente al modelo a usar las capacidades que ya posee.
Anthropic también afirmó que Opus 5 es más eficiente que Opus 4.8 al mismo precio base: 5 dólares por millón de tokens de entrada y 25 dólares por millón de tokens de salida.
Los agentes de ejecución prolongada aún pueden enfrentar problemas como:
Por lo tanto, los puntos de control humanos siguen siendo útiles.
El flujo de trabajo más sólido no es "no volver a mirar al agente nunca más", sino "hacer que el agente trabaje durante más tiempo entre dos intervenciones humanas de alto valor".
El método puede generalizarse más allá del ámbito de los juegos.
Describe el resultado deseado, sin especificar cada detalle de implementación.
Crea un refinado juego de exploración espacial para navegador, con controles fluidos,
una atmósfera visual potente y un rendimiento estable.
Usa contenido que el revisor pueda comprobar.
Para trabajos visuales:
Compara la iluminación, la profundidad, la composición y el refinamiento de la interfaz con un conjunto seleccionado de capturas de juegos comerciales de alta calidad.
Para software, usa pruebas, benchmarks o implementaciones de referencia.
El agente puede dividir componentes, como:
Para los componentes importantes, usa:
El crítico debe señalar la diferencia accionable más importante, en lugar de enumerar una larga lista de quejas vagas.
Itera continuamente hasta alcanzar un punto de detención por calidad, presupuesto o tiempo.
Los agentes en paralelo pueden producir un trabajo localmente bueno pero globalmente inconsistente.
El agente de integración final puede verificar:
Almacena las partes útiles del proceso como:
Las ejecuciones posteriores deberían partir de las lecciones aprendidas previamente.
Gauntlet Loop es más eficaz cuando la calidad puede medirse de forma repetida.
Los candidatos adecuados incluyen:
Pero el patrón es menos eficaz cuando el crítico carece de señales fiables.
Un crítico sin capturas de pantalla, pruebas,
benchmarks, materiales de referencia o comentarios reales de usuarios puede acabar simplemente generando otra "opinión" más del modelo.
Los flujos de trabajo multiagente de larga duración pueden consumir una gran cantidad de recursos computacionales.
Cada ronda de revisión puede requerir:
Los medios prácticos de control presupuestario incluyen:
Un crítico estricto puede mejorar la calidad, pero también puede hacer que el sistema siga funcionando durante mucho tiempo cuando las mejoras restantes ya no valen la pena.
El Gauntlet Loop es un método de prompts multiagente popularizado por Matt Shumer. Un agente principal descompone el objetivo en tareas más pequeñas, un agente constructor produce los resultados y un agente crítico independiente compara el resultado real con referencias concretas; los resultados que no alcanzan el estándar se devuelven para rehacerlos.
Según Shumer, el proyecto comenzó con una instrucción de alto nivel, pero no se generó en una sola respuesta del modelo. Claude Code trabajó durante horas, derivando subagentes, escribiendo aproximadamente 55,000 líneas de código, usando herramientas, revisando salidas e iterando.
No. Estas demostraciones son juegos de navegador y prototipos técnicamente impresionantes, pero no equivalen a lanzamientos comerciales AAA. El repositorio de Claude of Duty señala que el resultado final no es comparable con las entregas modernas de Call of Duty que se usaron como referencia de calidad.
The Long Silence es un juego de exploración espacial procedural basado en navegador creado por Anshu Chimala. Su repositorio público muestra que se construyó con Claude Opus 5 e incluye renderizado personalizado, contenido generado proceduralmente y herramientas de verificación basadas en navegador.
Un crítico nuevo difícilmente defenderá las decisiones de implementación del constructor. Puede examinar el producto real y compararlo con pruebas, capturas de pantalla, benchmarks o ejemplos de referencia antes de solicitar otra revisión.
No. Esta arquitectura puede aplicarse a otros agentes de codificación que admitan herramientas, edición de archivos, ejecución de código, inspección visual y trabajo repetitivo. El texto fuente contiene un ejemplo con GPT-5.6 Sol y Codex.
El flujo de trabajo completo requiere un entorno de ejecución de agentes, no una interfaz de chat normal. Claude Code es una opción porque puede manejar archivos, ejecutar comandos, conectar herramientas y coordinar tareas de codificación de larga duración.
Cuando los estándares de calidad son vagos o no medibles, los bucles de larga duración pueden desperdiciar tiempo y recursos computacionales. El propietario humano debe establecer presupuestos, revisar el progreso, reajustar las prioridades cuando sea necesario y decidir cuándo más iteraciones ya no aportan valor.
Cubre las capacidades de Opus 5 en codificación, verificación, iteración y tareas de ciclos prolongados.
Los experimentos de juegos con Opus 5 que se volvieron virales deben entenderse más como una demostración de un flujo de trabajo que como una "generación única" mágica. El Gauntlet Loop combina descomposición de tareas, constructores expertos, críticos independientes, estándares de calidad concretos e iteración repetida.
The Long Silence demuestra hasta dónde puede llegar este patrón en un proyecto agéntico de aproximadamente un día de duración. Su repositorio público incluye no solo el juego jugable, sino también scripts de verificación, herramientas de captura de pantalla, aserciones interactivas e instrucciones agénticas reutilizables.
El método sigue dependiendo del juicio humano, presupuestos computacionales, buenas referencias y un entorno de trabajo agéntico. No equivale a lograr que un prototipo de navegador rivalice con un juego AAA de estudio.
El verdadero cambio está en que un objetivo de alto nivel ahora puede iniciar un ciclo de "construir–medir–criticar–mejorar" de larga duración, completando mucho más trabajo antes de que un humano necesite intervenir.
Empieza con una sola frase y obtén un sitio completo en minutos.



