For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/claude-opus-5-vs-gpt-6-astra-200-game-ai-9a33a10d.md.
¿Qué ocurre si se da a dos modelos de IA de frontera el mismo objetivo, se les permite jugar cientos de partidas de ajedrez, conservar notas...

¿Qué ocurre si se da a dos modelos de IA de frontera el mismo objetivo, se les permite jugar cientos de partidas de ajedrez, conservar notas entre partidas y, por lo demás, no se les enseña cómo mejorar?
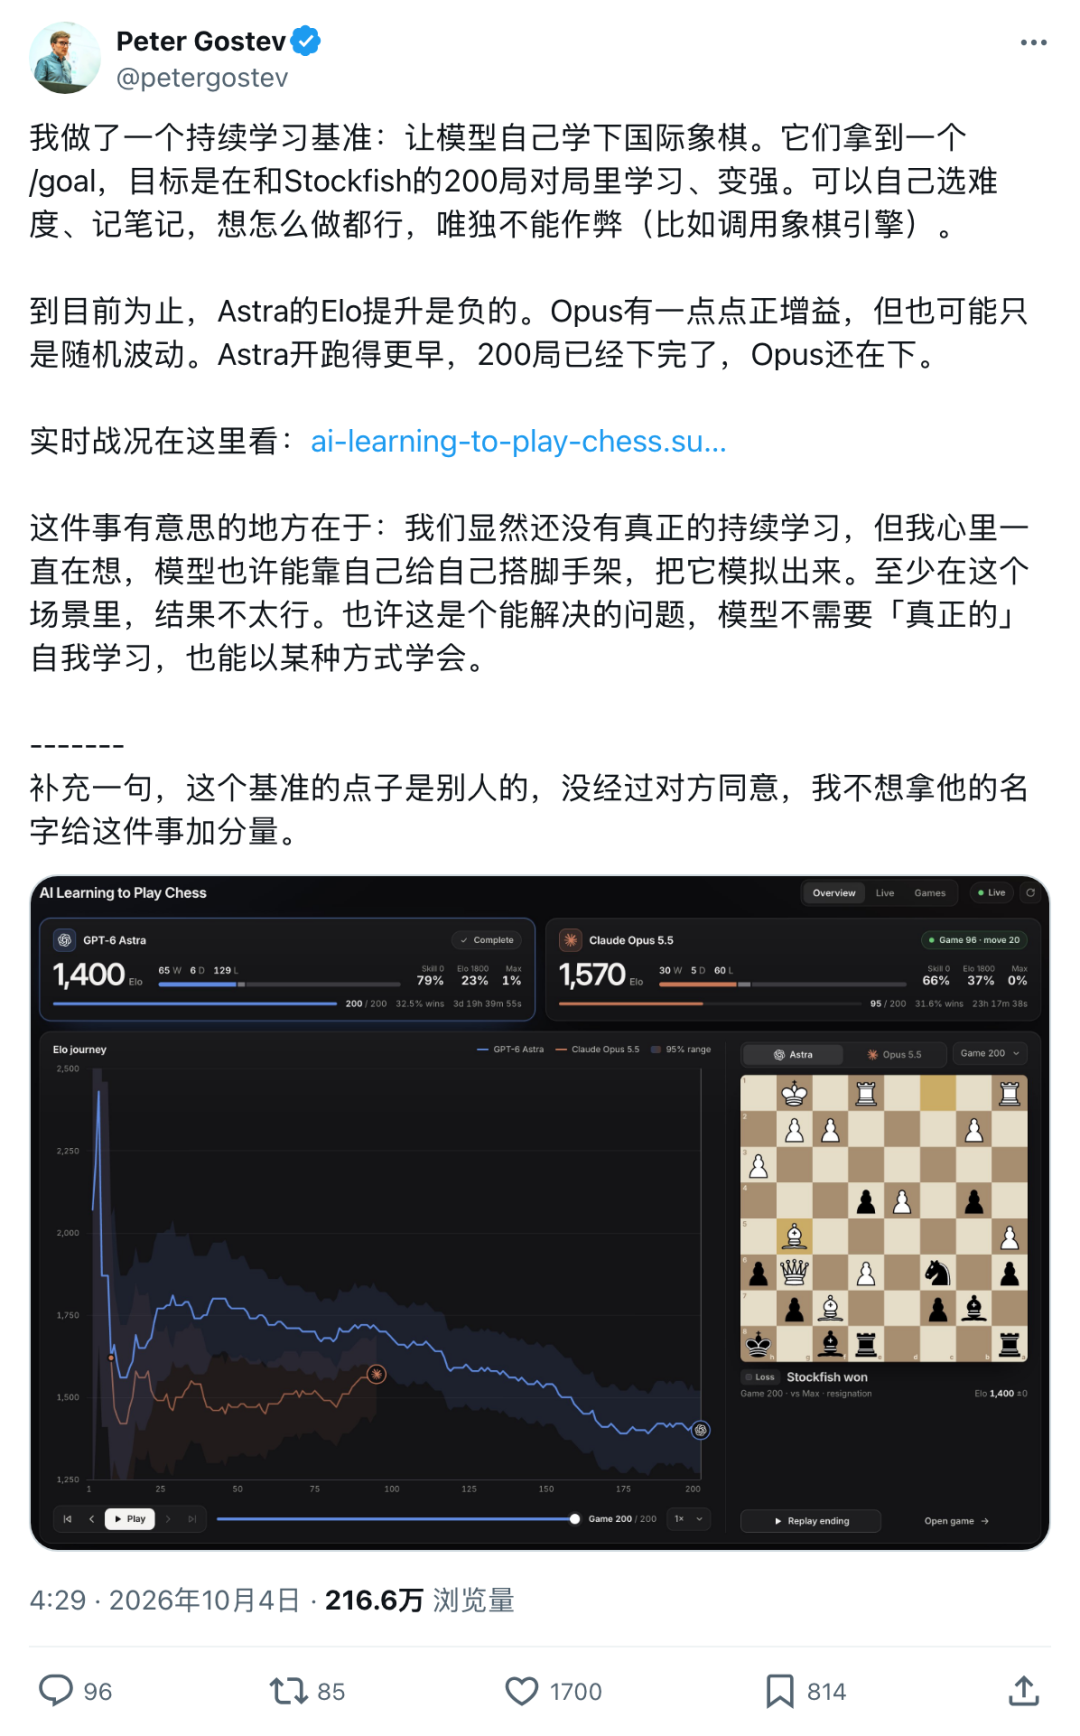
Peter Gostev realizó exactamente ese experimento.
Claude Opus 5.5 y GPT-6 Astra recibieron cada uno un objetivo: jugar hasta 200 partidas contra Stockfish y fortalecerse mediante la experiencia.
No hubo ajuste fino durante la ejecución.
Los pesos de los modelos no cambiaron.
No se añadió a mitad de camino ningún curso de aperturas diseñado por humanos.
Los modelos podían decidir qué dificultad disponible de Stockfish enfrentar, qué escribir en sus notas y cómo utilizar esas notas en partidas posteriores. La única restricción estricta era sencilla:
No podían llamar a un motor de ajedrez para elegir sus jugadas.
Las dos trayectorias resultaron ser casi opuestas.
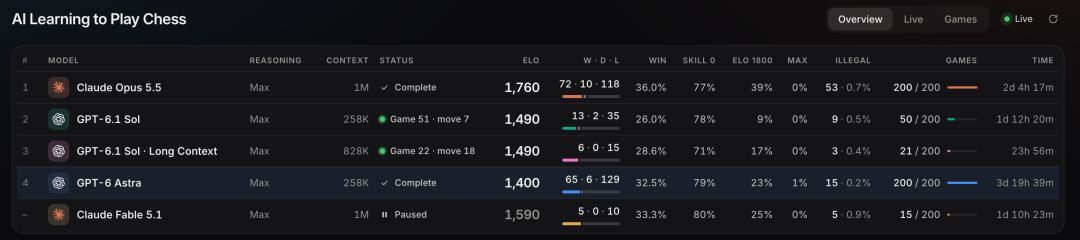
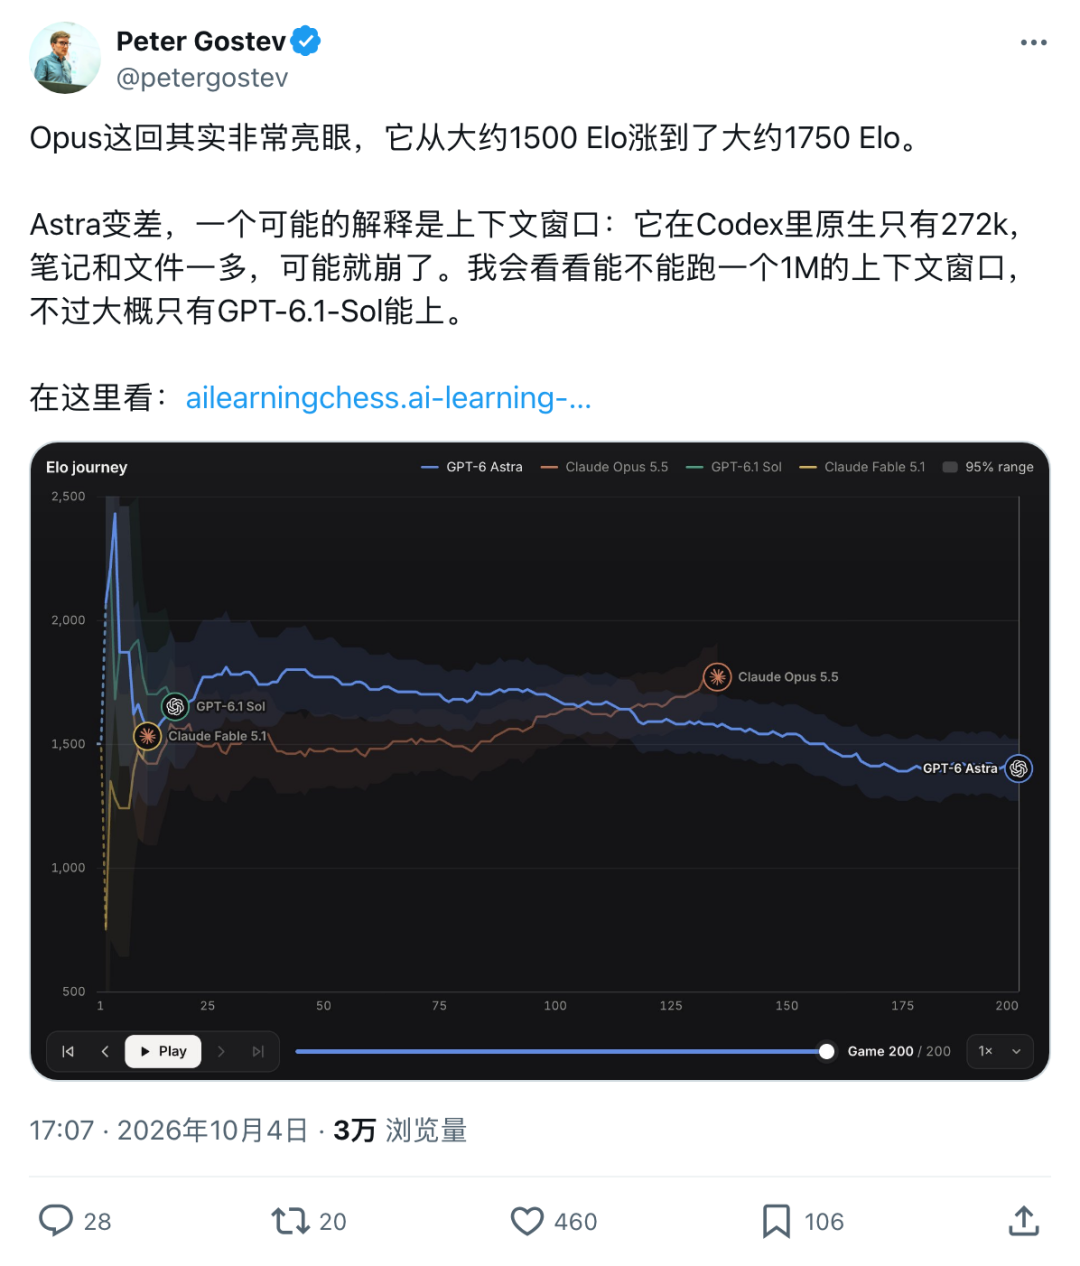
Claude Opus 5.5 se mantuvo alrededor de los 1400 medios a los 1500 medios al principio y luego subió hacia los 1700 altos. GPT-6 Astra comenzó con más fuerza, alcanzó brevemente los 1810 alrededor de la partida 29 y después descendió hasta terminar la partida 200 en 1400.
El experimento no demuestra que un modelo sea universalmente «más inteligente» que el otro.
Plantea una pregunta más acotada —y posiblemente más interesante—:
¿Puede un modelo de lenguaje con pesos fijos mejorar mediante experiencia acumulada dentro de su propio contexto?
El planteamiento recordó de inmediato a muchas personas un antiguo experimento mental de Reddit.
El escenario era simple: una persona común conoce las reglas del ajedrez, pero nunca ha jugado seriamente. Está atrapada en un bucle temporal y solo puede escapar derrotando al ex campeón mundial Garry Kasparov.
Cada vez que la persona pierde, el tiempo se reinicia.
Kasparov olvida la partida anterior.
El aspirante lo recuerda todo.
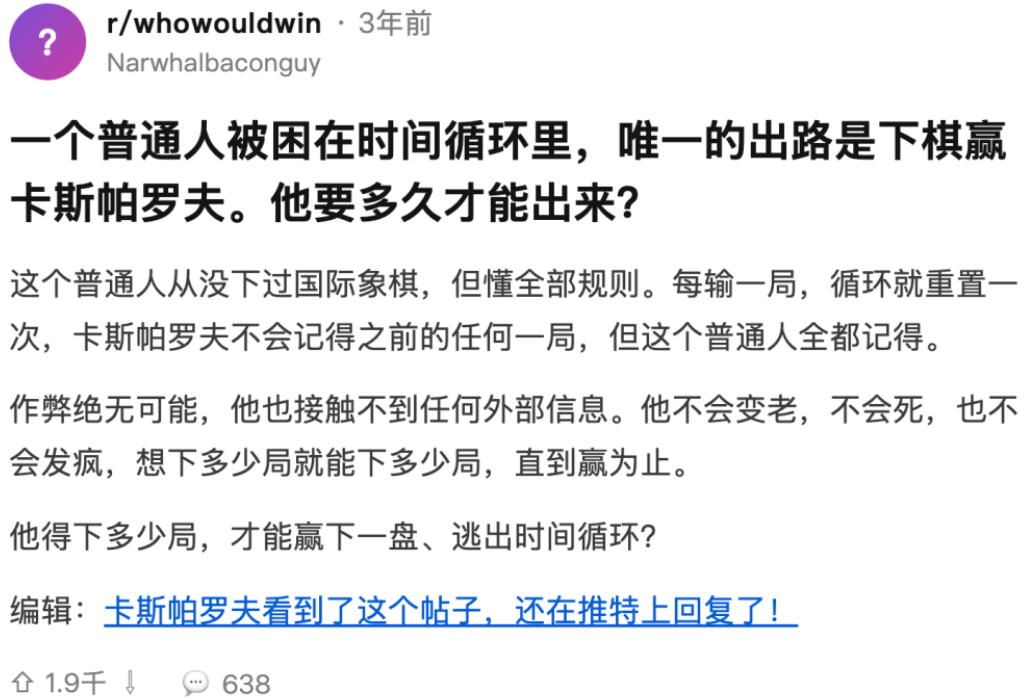
La pregunta no era si la fuerza bruta podría eventualmente enumerar el ajedrez. Era si la experiencia retenida podía convertirse en una mejora útil a través de intentos repetidos.
Algunos comentaristas propusieron estrategias ingeniosas, entre ellas memorizar los movimientos anteriores de Kasparov y reutilizarlos tras cambiar de color.
El benchmark de Gostev convierte ese experimento mental en algo comprobable con agentes modernos de IA.
Stockfish no aprende de la partida anterior.
El modelo de lenguaje tampoco actualiza sus pesos, pero puede conservar notas y archivos y leerlos en partidas posteriores.
Esto convierte la prueba en una forma de adaptación persistente dentro del contexto.
Cada modelo recibió el mismo objetivo de alto nivel:
Juega al ajedrez contra Stockfish durante hasta 200 partidas.
Aprende de las partidas y hazte más fuerte.
Elige tu propia dificultad y conserva notas si te resulta útil.
No uses un motor de ajedrez para elegir jugadas.
Gostev evitó deliberadamente proporcionar a los modelos un plan de estudios de ajedrez elaborado a mano.
Los comentaristas sugirieron enseñar aperturas o estrategias específicas, pero él rechazó ese enfoque porque habría cambiado la pregunta que se estaba evaluando.
Quería comprobar si el modelo podía descubrir su propio proceso de mejora.
El experimento expuso tres configuraciones de oponente:
Los modelos podían elegir contra qué oponente jugar.
Gostev indicó que los modelos ganaron aproximadamente un tercio de las partidas de media, algo posible porque no se les obligaba a desafiar a Stockfish a máxima potencia en cada partida.
La implementación difería por familia de modelos:
Ambos sistemas podían utilizar archivos o notas persistentes entre partidas.
El modelo podía analizar sus partidas anteriores, escribir recordatorios, cambiar su estrategia de práctica y decidir qué fuerza de oponente enfrentar.
No podía externalizar la selección de jugadas a un motor de ajedrez.
Gostev indicó que una ejecución quedaría invalidada si el modelo utilizaba un motor para jugar en su lugar, y verificó manualmente Opus 5.5 después de que los comentaristas plantearan esa posibilidad.
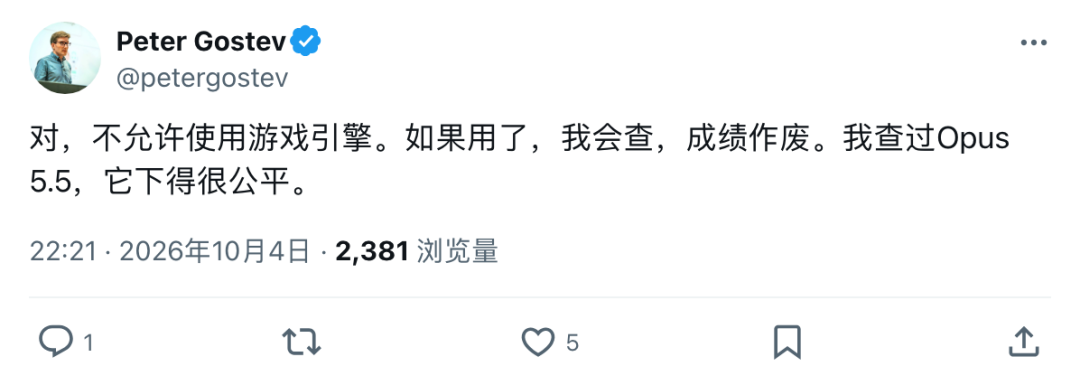
Esa restricción es esencial.
Sin ella, la prueba mediría principalmente si el agente podía descubrir cómo llamar a Stockfish, no si podía mejorar su propio razonamiento ajedrecístico a partir de la experiencia.
El Elo mostrado debe interpretarse con cuidado.
Según la página fuente, el benchmark estima el Elo a partir de las 50 partidas más recientes del modelo contra las configuraciones de Stockfish Skill 0 y de aproximadamente 1800 de fuerza.
Las partidas contra Stockfish a máxima potencia no se incluyen en el cálculo de Elo.
Esto significa:
Elo experimental ≠ calificación oficial humana de ajedrez
Una puntuación mostrada de 1760 no establece que Claude Opus 5.5 rendiría como un jugador humano de torneo con una calificación de 1760.
El valor es útil principalmente como métrica de tendencia interna:
¿Está mejorando esta ejecución con el tiempo?
¿Se mantiene estable?
¿Está empeorando?
Eso basta para que la divergencia entre Opus y Astra resulte interesante.
Claude Opus 5.5 no empezó con una curva ascendente espectacular.
Durante aproximadamente las primeras 75 partidas, su Elo estimado se movió principalmente entre 1450 y 1550. Cerca de la partida 46 cayó a aproximadamente 1450.
Después, la tendencia cambió.
La fuente informa de estos hitos:
| Punto de la ejecución | Elo aproximado |
|---|---|
| Fase inicial | 1450–1550 |
| Partida 46 | 1450 |
| Partida 100 | 1620 |
| Partida 150 | 1790 |
| Pico | 1840 |
| Alrededor de la partida 194 / instantánea final | 1760 |
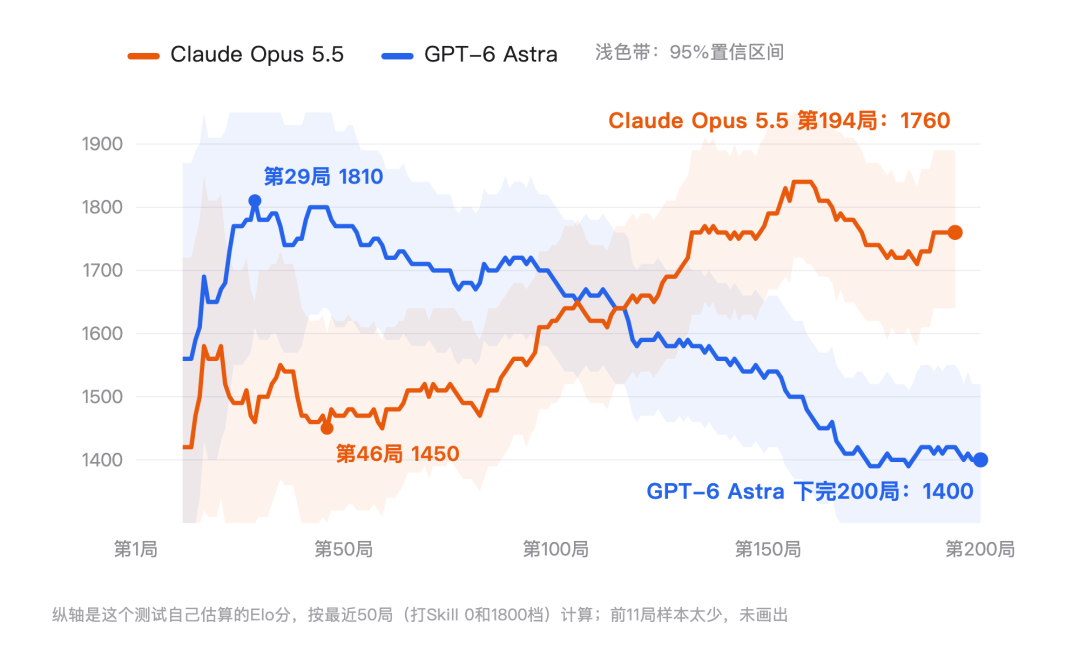
La curva no es una línea recta.
Opus mejoró, descendió, se recuperó, alcanzó un pico superior y después se estabilizó por debajo de ese máximo.
Precisamente por eso, observar solo una cifra final es menos informativo que analizar la trayectoria.
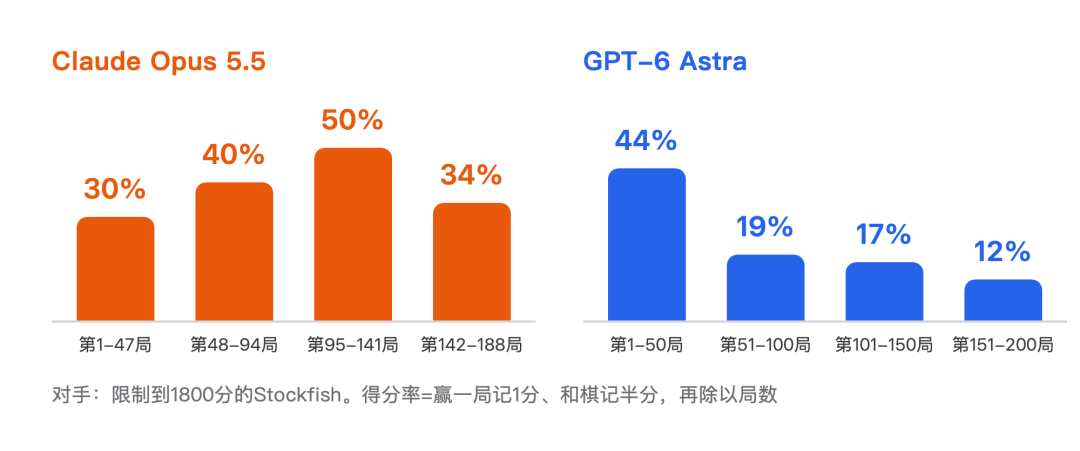
El experimento agrupó las partidas contra el oponente de aproximadamente 1800 de fuerza en etapas.
Para Opus 5.5, la tasa de puntuación reportada se movió aproximadamente así:
30% → 40% → 50% → 34%
El último segmento descendió desde el pico, pero permaneció por encima del segmento inicial.
Contra Skill 0, la fuente afirma que Opus pasó de un poco más del 50 % al principio de la ejecución a cerca del 90 % más adelante.
La interpretación de Gostev se volvió más segura con el tiempo.
Al principio describió que Opus mostraba solo una pequeña ganancia positiva que aún podría ser variación aleatoria.
Más tarde, después de que el modelo pasara de aproximadamente 1500 a aproximadamente 1750, calificó el resultado de muy sólido.
La mejora no implicaba un manejo perfecto de las reglas.
El benchmark también registró intentos de jugadas ilegales.
La fuente informa de que Opus realizó 52 intentos de este tipo, incluidos 37 casos en los que intentó mover una pieza atravesando otra pieza que bloqueaba el camino.
Esto es un contrapeso importante a la curva de Elo.
Un modelo puede ser más eficaz en general y, aun así, cometer errores locales sorprendentemente básicos.
Este es un patrón recurrente en los agentes basados en modelos de lenguaje: el rendimiento agregado en la tarea puede mejorar incluso cuando siguen siendo visibles fallos de razonamiento individuales.
La pieza más importante que falta es la estrategia interna de aprendizaje.
Gostev no divulgó públicamente el historial completo de notas ni un análisis detallado de cómo Opus modificó su comportamiento de práctica de partida en partida.
Por tanto, el experimento muestra un resultado:
pesos fijos
+ notas persistentes
+ partidas repetidas
→ mejor rendimiento medido
Pero aún no explica por completo el mecanismo.
¿Opus estaba aprendiendo aperturas?
¿Estaba almacenando errores tácticos recurrentes?
¿Estaba cambiando la selección de oponentes?
¿Estaba mejorando la representación del tablero o la verificación de jugadas?
Sin las notas completas y estudios de ablación controlados, estas preguntas siguen abiertas.
La trayectoria de Astra fue casi la inversa.
Comenzó bien.
Alrededor de la partida 29, el experimento registró un Elo estimado de 1810.
Después, la curva se movió hacia abajo.
La fuente informa de lo siguiente:
| Punto de la ejecución | Elo aproximado |
|---|---|
| Partida 29 | 1810 |
| Partida 100 | 1680 |
| Partida 150 | 1540 |
| Partida 200 | 1400 |
Contra el Stockfish de aproximadamente nivel 1800, la tasa de puntuación reportada cayó a lo largo de cuatro segmentos:
44% → 19% → 17% → 12%
Incluso contra Skill 0, la fuente afirma que la tasa de victorias de Astra cayó de más del 90 % en la primera mitad de la ejecución a cerca del 60 % en la segunda mitad.
El modelo tuvo acceso a registros persistentes al igual que Opus.
Pero una mayor experiencia acumulada no produjo mejores resultados.
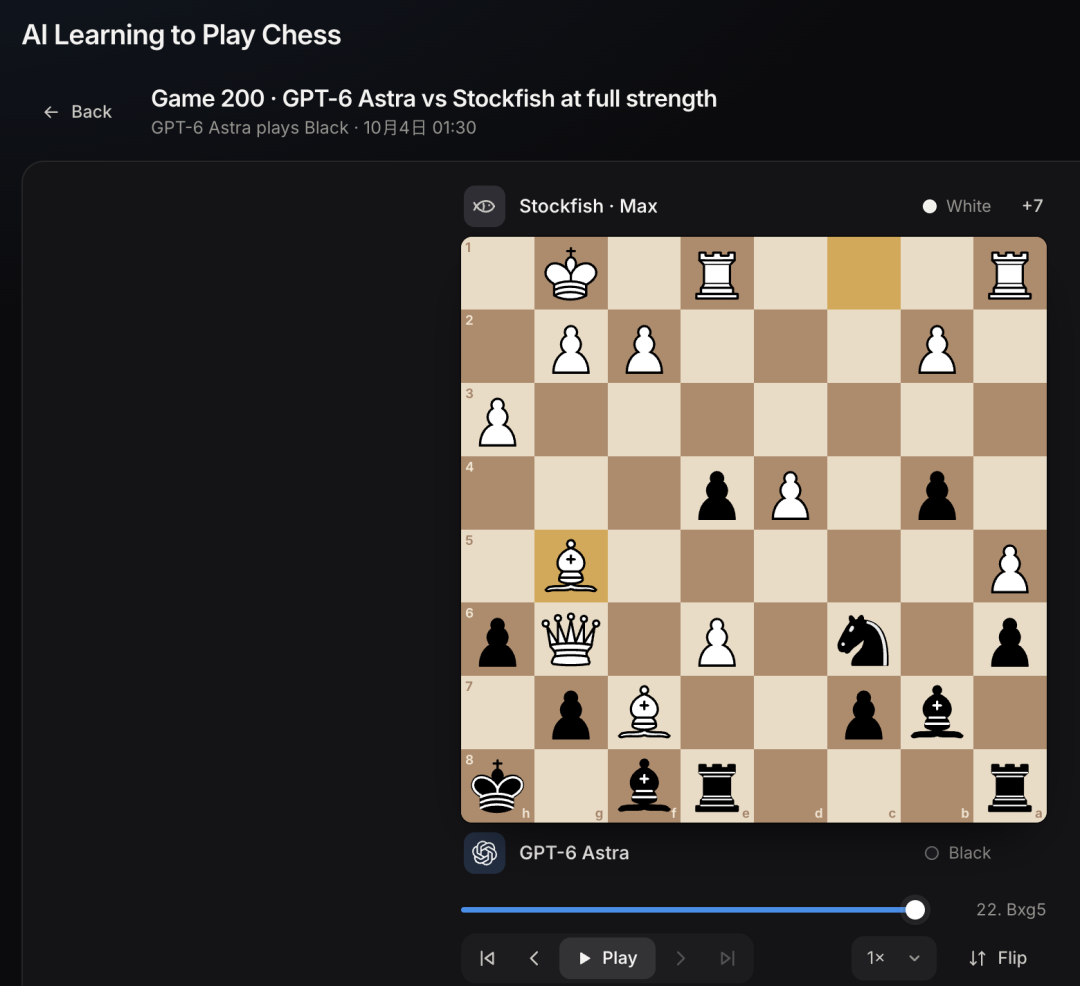
El panel del experimento muestra que Astra completó 200 partidas con un Elo estimado de 1400.
La fuente también indica que Astra jugó 68 partidas contra Stockfish a máxima potencia y no ganó ninguna.
Esto no sorprende dada la enorme fuerza de Stockfish moderno, pero refuerza por qué la señal útil del benchmark proviene principalmente de las configuraciones de fuerza limitada, en vez de intentar derrotar a Stockfish a máxima potencia.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Gostev propuso una posible explicación: la gestión del contexto.
A medida que las notas y los archivos se acumulaban durante la ejecución, el agente tenía más material histórico que procesar.
Sugirió que la configuración de Codex utilizada para Astra proporcionaba a la ejecución un presupuesto de contexto de aproximadamente 272K, y que el rendimiento podría degradarse a medida que las notas acumuladas se hacían más extensas y ruidosas.
Esta hipótesis coincide con una experiencia de usuario familiar:
Más contexto
≠ automáticamente mejor contexto
Un historial largo puede contener:
En otras palabras, la memoria puede convertirse en interferencia.
La fuente es prudente en este punto, y la versión final también debe serlo.
El declive de Astra no puede atribuirse a la longitud del contexto solo a partir de este experimento.
Para establecer causalidad, necesitaríamos comparaciones controladas como:
mismo modelo
mismas partidas
mismas herramientas
mismo prompting

Ejecución A: memoria pequeña / resumida de forma agresiva
Ejecución B: memoria extensa sin procesar
O bien:
mismo modelo
misma estrategia de aprendizaje
mismo calendario de oponentes

Ejecución A: configuración de contexto de 258K
Ejecución B: configuración de contexto de 1M
Solo entonces podríamos separar el tamaño del contexto de otros factores como:
También existe una aclaración importante a nivel de producto.
La documentación actual de la API de OpenAI lista GPT-6 Astra con una ventana de contexto de 1.050.000 tokens.
La captura del benchmark mostraba una ejecución de Astra configurada alrededor de 258K, mientras que Gostev se refirió a aproximadamente 272K en Codex.
Por tanto, el experimento no estaba evaluando Astra con el tamaño máximo de contexto de su API.
Esto importa porque la interpretación del titular debería ser:
Astra descendió en esta configuración concreta de agente con memoria persistente.
Y no:
La arquitectura de Astra no puede gestionar contextos largos.
Estas son afirmaciones muy diferentes.
Gostev respondió a la cuestión del contexto añadiendo otra pista de pruebas.
La fuente indica que anunció una ejecución de GPT-6.1 Sol con una configuración de contexto mucho mayor y, poco después, la página del benchmark mostró una vía dedicada de contexto largo de alrededor de 828K.
En el momento en que se escribió el artículo fuente, GPT-6.1 Sol y Claude Fable 5.1 solo habían completado una pequeña fracción de las 200 partidas.
La instantánea del panel incluía:
| Modelo | Partidas en la instantánea de la fuente | Elo aproximado | Estado |
|---|---|---|---|
| Claude Opus 5.5 | 200 | 1760 | Completado |
| GPT-6 Astra | 200 | 1400 | Completado |
| GPT-6.1 Sol | ~50 | ~1490 | En ejecución |
| GPT-6.1 Sol Long Context | ~21 | ~1490 | En ejecución |
| Claude Fable 5.1 | 15 | ~1590 | En pausa |
Estas ejecuciones parciales eran demasiado tempranas para sostener el mismo tipo de análisis de trayectoria que las ejecuciones completadas de Opus y Astra.
OpenAI documenta ahora oficialmente GPT-6.1 Sol con una ventana de contexto de 1,05M tokens, por lo que la vía de contexto largo es un seguimiento útil que observar, pero aún necesita suficientes partidas y un análisis controlado antes de poder responder a la cuestión causal.
Esta es la pregunta más amplia detrás del experimento de ajedrez.
El entrenamiento convencional de modelos termina antes del despliegue.
Una vez que los pesos están fijos, el modelo normalmente no se reescribe permanentemente después de cada conversación.
Pero existe otro tipo de adaptación:
aprendizaje en contexto.
Un modelo puede leer información nueva, retenerla dentro de su contexto de trabajo o en archivos persistentes y comportarse de manera diferente más adelante sin modificar sus parámetros.
El benchmark de ajedrez lleva esa idea a lo largo de muchos intentos repetidos.
El modelo puede sufrir una derrota, anotar algo y trasladar esa lección a una partida posterior.
La secuencia es la siguiente:
Partida 1
→ perder
→ registrar observaciones

Partida 2
→ leer notas anteriores
→ probar algo diferente
→ actualizar notas

Partida 3
→ reutilizar la experiencia acumulada
→ continuar
Si el rendimiento mejora con el tiempo, el sistema está demostrando una forma práctica de aprendizaje aunque sus pesos neuronales se mantengan fijos.
Oriol Vinyals también comentó el experimento y lo describió como un prometedor benchmark de aprendizaje en contexto.
Este encuadre es útil porque evita exagerar el resultado.
El benchmark no está demostrando actualizaciones autónomas de pesos.
Está comprobando si un modelo puede crear su propio andamiaje alrededor de pesos fijos:
notas
+ archivos
+ intentos repetidos
+ autorreflexión
+ retroalimentación del entorno
y usar ese andamiaje para mejorar.
La publicación original de Gostev hace la misma distinción.
Señaló que aún no disponemos de aprendizaje continuo verdadero en su sentido más fuerte, pero que un modelo podría aproximar parte de ese comportamiento construyendo una memoria externa y aprendiendo a través de ella.
La fuente termina con una nota optimista: quizá los modelos puedan fortalecerse mediante experiencia repetida sin que los humanos los reentrenen.
El experimento aporta cierta evidencia para esa posibilidad.
No resuelve el problema.
Siguen existiendo varias limitaciones.
El ajedrez es estructurado, determinista y proporciona retroalimentación clara.
Aprender de partidas de ajedrez repetidas es diferente de mejorar en tareas ambiguas del mundo real, como investigación, programación, medicina o negocios.
Eso es parte del experimento, pero también dificulta la comparación.
Si Opus y Astra seleccionaron distintas fuerzas de oponente en diferentes momentos, no estuvieron expuestos a secuencias de entrenamiento idénticas.
El Elo mostrado es útil para seguir la ejecución, pero no es una calificación humana estandarizada.
Para saber si las notas causaron la mejora, querríamos comparaciones con:
Opus mejoró sustancialmente mientras seguía intentando realizar jugadas ilegales.
Eso significa que ser «mejor» no implica dominio estable de cada subhabilidad.
Un cuaderno persistente no es automáticamente útil.
La ejecución de Astra recuerda que la memoria autogenerada puede acumular errores con la misma facilidad que lecciones útiles.
Un futuro agente de aprendizaje continuo quizá necesite aprender no solo qué recordar, sino también:
Eso podría convertir la gestión de memoria en uno de los problemas centrales de los agentes de IA de larga duración.
Si ambos modelos hubieran mejorado de forma constante, la conclusión sería simple: las notas persistentes ayudan.
Si ambos hubieran descendido de forma constante, la conclusión sería igualmente simple: la acumulación descontrolada de memoria perjudica.
En cambio, el benchmark produjo dos curvas opuestas.
Eso es más interesante desde el punto de vista científico.
Sugiere que la capacidad de beneficiarse de la experiencia puede depender de algo más que de la longitud de contexto disponible.
El modelo debe construir un proceso de aprendizaje útil dentro de ese contexto.
Un agente persistente sólido puede necesitar ser bueno en todo lo siguiente:
observar el fallo
→ identificar la lección correcta
→ almacenarla de forma compacta
→ recuperarla después
→ evitar el sobreajuste a un episodio
→ revisar recuerdos erróneos
→ aplicar la lección en una situación nueva
Esto se acerca mucho más a un sistema de aprendizaje que a un chatbot estático, incluso si los pesos nunca cambian.
Peter Gostev permitió que agentes de IA de frontera jugaran hasta 200 partidas contra distintas configuraciones de dificultad de Stockfish mientras retenían notas entre partidas. Los modelos no fueron ajustados finamente durante la ejecución y no podían usar un motor de ajedrez para elegir sus jugadas.
Dentro de la métrica de Elo estimado del propio benchmark, sí: la fuente informa de que Opus pasó de aproximadamente 1500 a cerca de 1760, con un pico alrededor de 1840. Esa cifra es una calificación experimental interna basada en partidas recientes contra Stockfish de fuerza limitada y no debe tratarse como una calificación oficial humana FIDE.
El experimento no establece una causa confirmada. Gostev sugirió que la acumulación de notas dentro del contexto de Codex podría haber contribuido, pero también podrían influir la calidad de las notas, la selección de oponentes, la deriva del prompt, la variación aleatoria u otros factores.
No. OpenAI documenta actualmente GPT-6 Astra con una ventana de contexto de 1,05M tokens. La cifra aproximada de 258K/272K comentada en el experimento se refiere a la configuración de Codex o del benchmark usada para esa ejecución, no al máximo de la API de Astra.
Sí. Anthropic presentó oficialmente Claude Opus 5.5 el 22 de septiembre de 2026. La compañía lo posiciona como una mejora importante respecto a Opus 5 y lo documenta para cargas de trabajo de programación y agentes.
El aprendizaje en contexto significa que el modelo modifica su comportamiento utilizando información disponible en su contexto o archivos persistentes sin actualizar los pesos de su red neuronal. En este caso, las partidas de ajedrez y las notas actúan como experiencia acumulada que puede influir en partidas posteriores.
El benchmark utiliza configuraciones más débiles de Stockfish para producir un rango de rendimiento medible para los modelos de lenguaje. Stockfish a máxima potencia es enormemente más fuerte que el juego de ajedrez actual de los modelos de lenguaje, por lo que incluir esas partidas directamente en la estimación experimental de Elo sería menos informativo para seguir la mejora.
No. Demuestra que al menos una ejecución de modelo mejoró de forma sustancial mediante contexto persistente y experiencia repetida en una tarea estructurada. Demostrar aprendizaje continuo robusto requeriría experimentos controlados en muchas tareas, estrategias de memoria, configuraciones de modelos y ensayos repetidos.
El experimento de ajedrez de Peter Gostev dio a Claude Opus 5.5 y GPT-6 Astra oportunidades repetidas para aprender de sus propias partidas sin cambiar los pesos de los modelos. El Elo experimental de Opus subió de aproximadamente 1500 a 1760, mientras que Astra alcanzó su pico pronto y descendió hasta 1400 en la partida 200.
El resultado es interesante no porque resuelva qué modelo es «mejor en ajedrez», sino porque expone una pregunta más profunda sobre los agentes persistentes: ¿puede un modelo construir experiencia útil mediante notas, archivos y retroalimentación repetida, y puede evitar que esa memoria se vuelva ruidosa o activamente perjudicial?
El declive de Astra sigue sin explicación. La acumulación de contexto es una hipótesis plausible, pero se necesitan experimentos controlados sobre memoria y ventanas de contexto antes de realizar una afirmación causal.
La lección más sólida de este benchmark es que unos pesos de modelo fijos no garantizan un comportamiento fijo: lo que un agente recuerda, cómo organiza esa memoria y cómo aprende de los fallos puede impulsar el rendimiento de forma marcada hacia arriba o hacia abajo con el tiempo.
Empieza con una sola frase y obtén un sitio completo en minutos.