Anthropic afirmó que Claude Sonnet 5.5 y Haiku 5.5 seguirían a Opus 5.5 «en las próximas semanas».
Sonnet 5.5 llegó solo seis días después.
El nuevo modelo Claude de gama media no es simplemente una versión más pequeña de Opus 5.5. En algunas pruebas de programación, de hecho, obtiene una puntuación superior.
El ejemplo más llamativo es Terminal-Bench 4.0:
Claude Sonnet 5.5: 70,6 %
Claude Opus 5.5:   66,4 %
Claude Sonnet 5:   10,3 %
Sin embargo, en el trabajo profesional más amplio, Opus 5.5 todavía mantiene una ventaja estrecha.
Anthropic informa de los siguientes resultados:
GDPval-AA v2.1
Opus 5.5:   1846 Elo
Sonnet 5.5: 1844 Elo

OSWorld 2.1
Opus 5.5:   81,8 %
Sonnet 5.5: 80,1 %
Esto hace que Sonnet 5.5 esté inusualmente cerca del modelo insignia de Anthropic en varias tareas medibles, al tiempo que mantiene el nivel de precios inferior de Sonnet.
Pero la diferencia entre ambos modelos sigue siendo importante.
Anthropic afirma que Opus 5.5 continúa siendo claramente superior para trabajos complejos y abiertos que requieren un criterio sostenido durante largos periodos. Sonnet 5.5 está orientado más directamente al trabajo cotidiano bien definido, como:
- Programación
- Corrección de errores
- Revisión de código
- Documentos
- Presentaciones
- Hojas de cálculo
- Tareas estructuradas con agentes
- Flujos de trabajo iterativos rápidos
Por tanto, la conclusión útil no es que Sonnet 5.5 haya «reemplazado» a Opus.
La conclusión es que la diferencia de rendimiento se ha reducido considerablemente para muchas cargas de trabajo rutinarias y centradas en la programación.
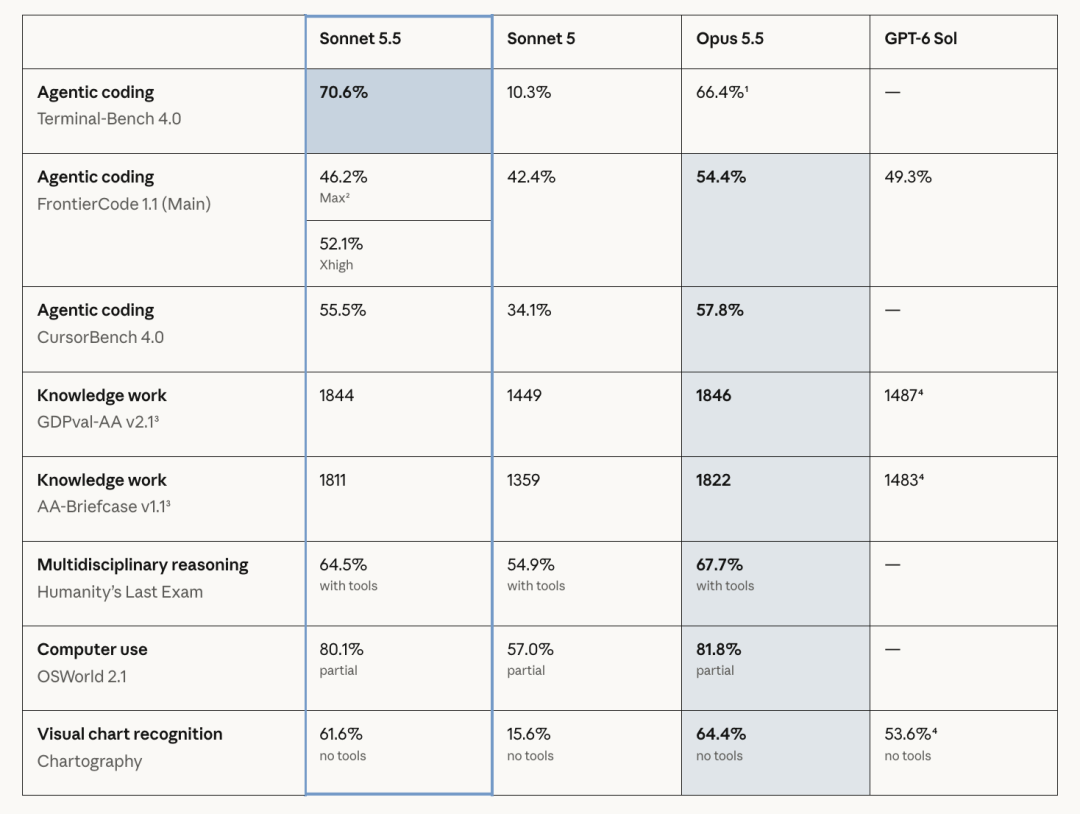
El artículo original describe Sonnet 5.5 como la «taza mediana» que persigue a la «taza grande».
La metáfora encaja sorprendentemente bien con la tabla de pruebas.
| Evaluación | Sonnet 5.5 | Opus 5.5 | Sonnet 5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % | 10,3 % | — |
| FrontierCode 1.1 Main | 52,1 % en Xhigh | 54,4 % | 42,4 % | hasta 52,1 % |
| CursorBench 4.0 | 55,5 % | 57,8 % | 34,1 % | — |
| GDPval-AA v2.1 | 1844 | 1846 | 1449 | 1487 |
| Humanity's Last Exam | 64,5 % | 67,7 % | 54,9 % | — |
| OSWorld 2.1 | 80,1 % | 81,8 % | 57,0 % | — |
| Chartography | 61,6 % | 64,4 % | 15,6 % | 53,6 % |
La tabla muestra el patrón real.
Sonnet 5.5 gana claramente una prueba de programación importante, se acerca mucho en varias otras, pero no supera a Opus 5.5 de forma universal.
Anthropic establece la misma distinción: las puntuaciones de las pruebas son solo una perspectiva sobre la calidad del modelo, y Opus sigue siendo más fuerte cuando una tarea es ambigua, abierta o requiere un criterio sostenido durante más tiempo.
Sonnet 5.5 utiliza las herramientas de forma más eficiente
La mejora no se limita a las puntuaciones brutas.
Los primeros evaluadores también observaron que Sonnet 5.5 cambia su forma de trabajar.
En comparación con Sonnet 5, el modelo está más dispuesto a agrupar llamadas a herramientas cuando las tareas pueden ejecutarse en paralelo, en lugar de procesarlo todo acción por acción.
Los comentarios de clientes de Anthropic incluyen una evaluación de programación en la que Sonnet 5.5 utilizó:
~1/3 menos llamadas a herramientas
~1/2 de ejecuciones de shell
para completar el mismo tipo de tarea.
Esto es importante para los sistemas de agentes porque cada llamada adicional a una herramienta puede añadir:
- Latencia
- Consumo de tokens
- Costes de infraestructura
- Riesgo de fallos
- Estado adicional que gestionar
Un modelo que llega al mismo resultado con menos interacciones con herramientas puede ser significativamente más barato, aunque su precio por token publicado no cambie.
Base44: resultados similares con la mitad de iteraciones
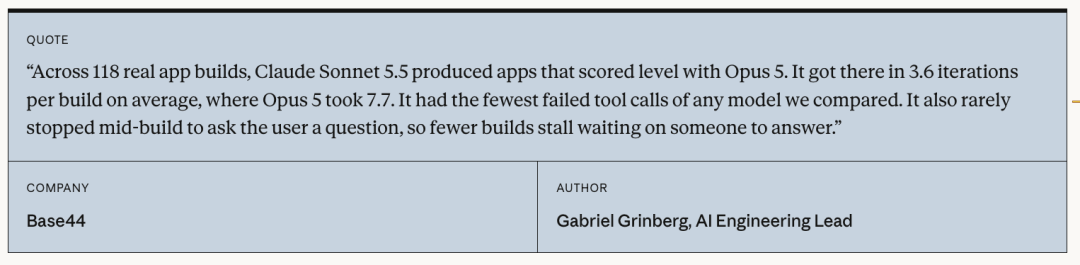
Base44 probó Sonnet 5.5 en 118 tareas reales de creación de aplicaciones.
El resultado comunicado fue especialmente práctico.
Sonnet 5.5 produjo aplicaciones que obtuvieron una puntuación equivalente a la de Opus 5, pero necesitó:
Sonnet 5.5:
3,6 iteraciones por creación de media

Opus 5:
7,7 iteraciones por creación de media
Base44 también afirmó que Sonnet 5.5 tuvo el menor número de llamadas fallidas a herramientas de todos los modelos comparados.
Esto recuerda que el «coste del modelo» no es solo:
precio de los tokens de entrada
+
precio de los tokens de salida
En los flujos de trabajo reales con agentes, el coste total también depende de:
número de iteraciones
número de llamadas a herramientas
acciones fallidas
reintentos
interrupciones humanas
tiempo hasta obtener un resultado aceptado
Si un modelo termina en la mitad de iteraciones, la diferencia de coste efectivo puede ser mucho mayor de lo que sugiere la tabla de precios de la API.
Epic Games lo probó con grandes bases de código
Epic Games probó Sonnet 5.5 en sistemas de software mucho más grandes.
Según los comentarios de clientes publicados por Anthropic, el modelo gestionó decenas de miles de líneas de código de sistemas de juego mientras trabajaba en tareas como:
- Auditorías del diseño de sistemas
- Revisiones del flujo de datos
- Tareas de programación de varias horas
Epic Games afirmó que el modelo alcanzó un nivel de calidad normalmente esperado de un modelo de gama superior y necesitó instrucciones menos prescriptivas.
Este es exactamente el tipo de carga de trabajo en el que un modelo más pequeño puede resultar valioso.
Un desarrollador puede seguir queriendo utilizar Opus 5.5 para definir la arquitectura o resolver los problemas ambiguos más difíciles, pero Sonnet 5.5 puede asumir una parte mucho mayor del trabajo de implementación y revisión a un coste inferior.
Unity solo cuenta una tarea cuando el proyecto se ejecuta
Unity utilizó un estándar de finalización más estricto.
En lugar de aceptar un parche de código simplemente porque el modelo afirmó haber terminado, Unity volvió a abrir el proyecto y comprobó si el resultado funcionaba realmente en tiempo de ejecución.
Con esta evaluación, Sonnet 5.5 completó:
90 %
de las tareas del benchmark de varios pasos de Unity para el Editor y la programación.
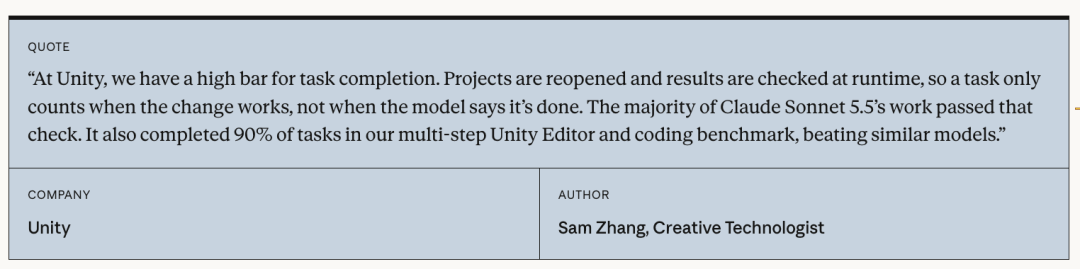
Este tipo de prueba es más informativo que la calidad de generación de código por sí sola.
Un parche puede parecer correcto y aun así fallar debido a:
- Dependencias ausentes
- Estado incorrecto del proyecto
- Errores de compilación
- Supuestos sobre el tiempo de ejecución
- Errores en el uso de herramientas
- Cambios fuera del alcance solicitado
El benchmark de Unity intenta medir la tarea real de extremo a extremo, no solo la respuesta textual.
Sonnet 5.5 puede completar Pokémon Red a partir de capturas de pantalla
Anthropic también continuó con una de sus demostraciones recurrentes de horizonte largo.
Sonnet 5.5 se convirtió en el primer modelo Sonnet de la familia Claude en superar Pokémon Red trabajando únicamente a partir de capturas de pantalla.
Esta prueba no es directamente útil como benchmark de programación.
Su valor es diferente.
El juego exige que el modelo pueda:
- Interpretar el estado visual
- Recordar objetivos a largo plazo
- Planificar varios pasos por adelantado
- Recuperarse de los errores
- Seguir actuando durante un horizonte prolongado
Esas mismas propiedades son importantes en los agentes de uso informático y en los flujos de trabajo de software de larga duración.
También mejoraron el diseño y el trabajo de oficina
El artículo original señala que Sonnet 5.5 no solo es más capaz con el código.
Anthropic también lo está posicionando para documentos, presentaciones, hojas de cálculo y trabajos visuales más pulidos.
El modelo está diseñado para seguir las convenciones visuales existentes en lugar de crear cada recurso desde cero.
Por ejemplo, cuando recibe una plantilla de presentación existente, puede continuar utilizando el mismo:
- Diseño
- Espaciado
- Jerarquía visual
- Convenciones de estilo
- Lenguaje de diseño
Anthropic afirma que esto reduce la cantidad de limpieza manual necesaria después de la generación.
Esto hace que Sonnet 5.5 sea especialmente relevante para flujos de trabajo empresariales en los que la tarea está bien definida, pero aún necesita coherencia visual.
El precio de la API no ha aumentado
A pesar del salto de rendimiento, Sonnet 5.5 mantiene los mismos precios básicos de API que Sonnet 5.
Anthropic indica actualmente:
| Tipo de token | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Entrada | 2 $ / 1 M | 4 $ / 1 M |
| Salida | 10 $ / 1 M | 20 $ / 1 M |
| Lectura de caché | 0,20 $ / 1 M | 0,20 $ / 1 M |
| Escritura de caché | 2,50 $ / 1 M | 5 $ / 1 M |
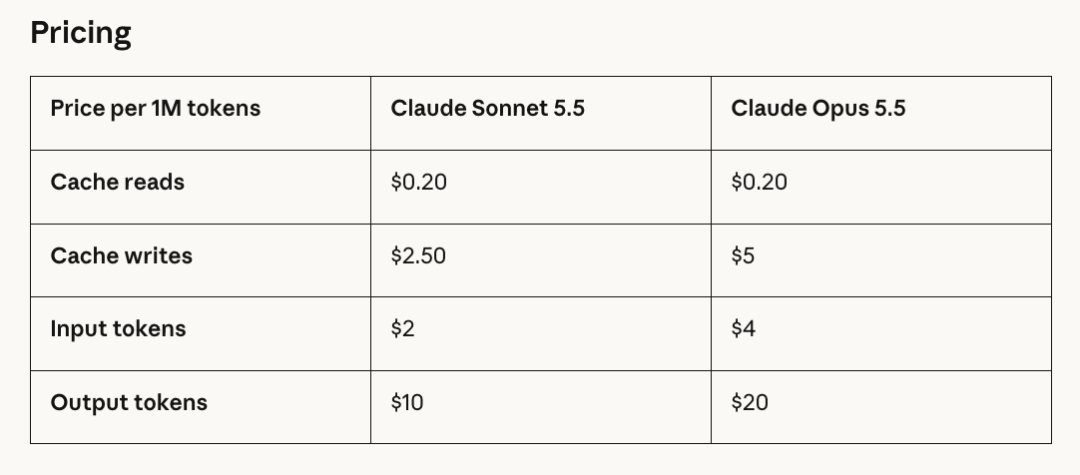
Al nivel del precio de lista, los tokens estándar de entrada y salida de Sonnet 5.5 cuestan exactamente la mitad que los de Opus 5.5.
Pero Anthropic está dando ahora más importancia a otra métrica:
Coste por tarea completada.
El coste por tarea es menor aunque los precios por token se mantengan
Anthropic afirma que Sonnet 5.5 genera resultados más de un 30 % más rápido que Sonnet 5.
También afirma que el modelo suele necesitar menos tokens y menos pasos para completar el mismo trabajo.
Como resultado, Anthropic informa de que Sonnet 5.5 puede costar:
hasta un 30 % menos por tarea
que Sonnet 5 en la mayoría de las cargas de trabajo.
Por eso, observar únicamente la tarifa de 2 $ / 10 $ por token deja fuera parte de la mejora.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La tarifa nominal se mantuvo.
La cantidad de trabajo del modelo necesaria para terminar una tarea disminuyó.
Terminal-Bench: el esfuerzo medio puede superar a Sonnet 5 a una fracción del coste
Anthropic ofrece ahora varios niveles de esfuerzo.
Un esfuerzo mayor permite que el modelo razone durante más tiempo y revise más trabajo.
Un esfuerzo menor lo hace más rápido y barato.
En Claude Code y en las aplicaciones de consumo de Anthropic, el esfuerzo predeterminado es Medio. En Claude Platform, el valor predeterminado es Alto.
En Terminal-Bench 4.0, el gráfico de coste y rendimiento de Anthropic muestra que Sonnet 5.5 con esfuerzo Medio ya supera el mejor resultado de Sonnet 5 y cuesta aproximadamente una décima parte por intento.
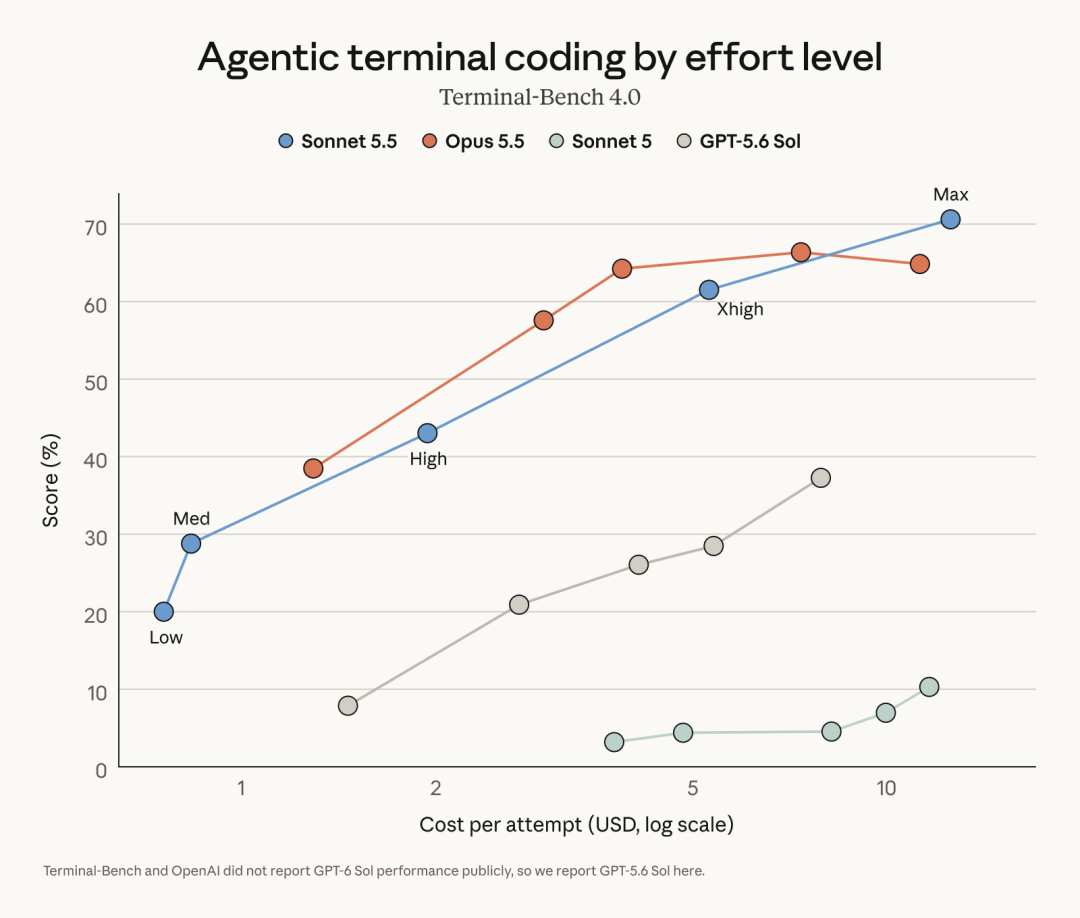
La conclusión importante no es que el nivel Medio sea siempre la configuración adecuada.
Es que ahora un desarrollador puede ajustar la calidad y el coste de forma más directa.
Para la programación rutinaria, un nivel de esfuerzo inferior puede ser suficiente.
Para las tareas difíciles, aumentar el esfuerzo da a Sonnet más tiempo para razonar.
CursorBench muestra un patrón similar
CursorBench 4.0 evalúa el trabajo de programación a partir de sesiones reales de Cursor.
Sonnet 5.5 alcanza:
55,5 %
frente a:
57,8 %
para Opus 5.5.
El gráfico de costes de Anthropic muestra que, incluso con un nivel de esfuerzo relativamente bajo, Sonnet 5.5 puede superar la puntuación más alta de Sonnet 5 por aproximadamente una décima parte del coste por tarea.
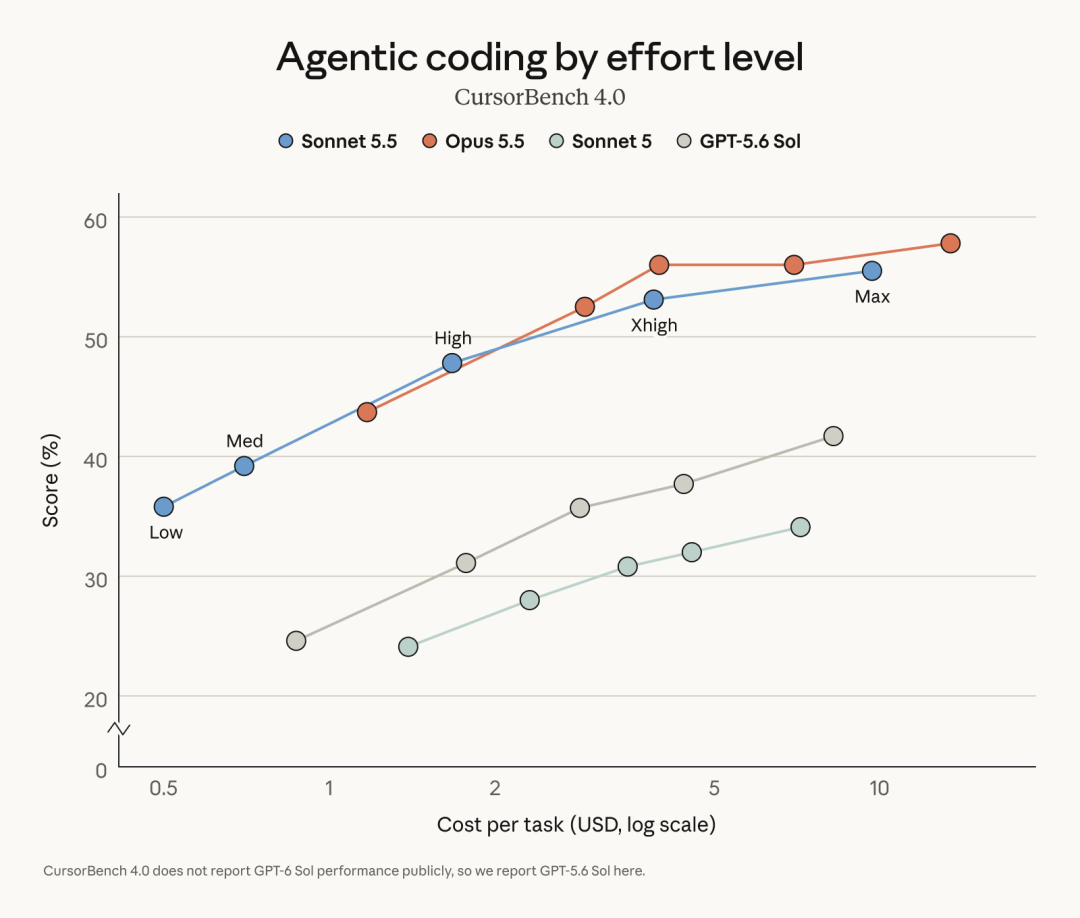
Aquí es donde el nuevo Sonnet resulta especialmente atractivo.
La diferencia absoluta de rendimiento con Opus puede ser lo bastante pequeña como para que el modelo de menor coste sea a menudo la mejor opción de producción para la programación de alto volumen.
FrontierCode enfrenta a Sonnet 5.5 con GPT-6 Sol
El artículo original presta especial atención a FrontierCode 1.1 porque la comparación incluye GPT-6 Sol.
El gráfico publicado por Anthropic muestra que Sonnet 5.5 alcanza su mejor puntuación en FrontierCode con el nivel de esfuerzo Xhigh, mientras que los distintos niveles de esfuerzo de GPT-6 Sol se sitúan en un intervalo de puntuaciones similar.
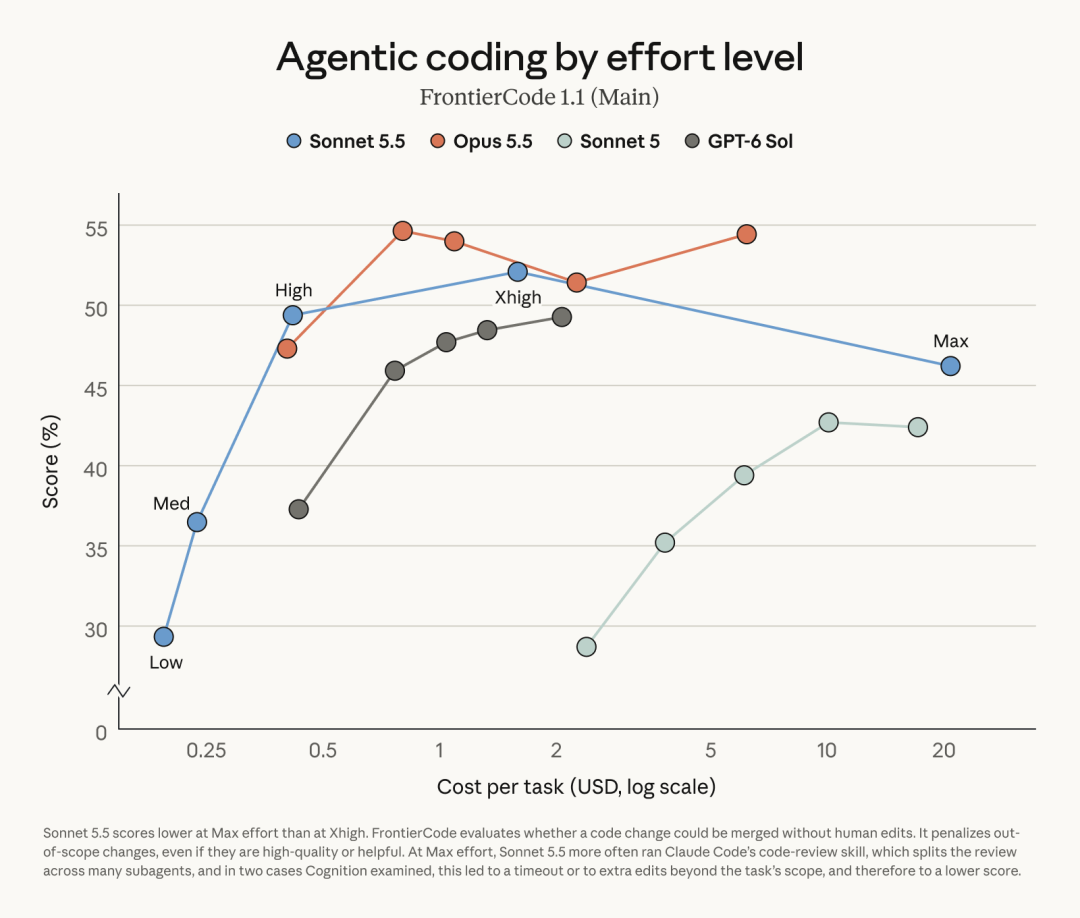
Con un nivel de esfuerzo Alto, Sonnet 5.5 ya se encuentra aproximadamente en el intervalo de puntuación de las configuraciones probadas más fuertes de GPT-6 Sol, mientras que Anthropic estima un coste por tarea considerablemente menor.
El artículo original resume la diferencia aproximadamente así:
Coste por tarea de Sonnet 5.5:
~1/5 del de GPT-6 Sol
para el punto comparable destacado en el gráfico de Anthropic.
Esta cifra debe interpretarse como una comparación específica del coste por tarea en un benchmark, no como una proporción universal de precios de API.
Los modelos:
- Tienen estructuras de precios diferentes
- Utilizan cantidades diferentes de razonamiento
- Generan volúmenes de tokens diferentes
- Pueden necesitar cantidades diferentes de reintentos
- Se comparan con configuraciones de esfuerzo específicas
Por tanto, es más prudente decir que el gráfico de pruebas de Anthropic muestra que Sonnet 5.5 alcanza una calidad similar en FrontierCode con un coste de tarea medido mucho menor en esa configuración.
Esto no significa que cada carga de trabajo de Sonnet cueste exactamente un 80 % menos que la de GPT-6 Sol.
Sonnet 5.5 no sustituye a Opus 5.5
Los titulares de las pruebas hacen tentador concluir que el modelo Sonnet más barato ha vuelto innecesario a Opus.
Anthropic rechaza explícitamente esa interpretación.
Sus propias pruebas y los comentarios de clientes siguen mostrando que Opus 5.5 es claramente superior en trabajos que requieren:
- Razonamiento abierto
- Criterio sostenido durante más tiempo
- Planificación más ambigua
- Decisiones de arquitectura
- Investigación compleja
- Decisiones de varios pasos y alto riesgo
Por tanto, una estrategia práctica de enrutamiento de modelos se parece más a esto:
Opus 5.5
→ arquitectura
→ planificación difícil
→ investigación ambigua
→ tareas de máxima complejidad

Sonnet 5.5
→ implementación
→ corrección de errores
→ revisiones
→ tareas rutinarias con agentes
→ documentos y trabajo de oficina
→ programación de alto volumen
Un cliente de Anthropic describió la relación de forma similar: dejar que Opus defina la arquitectura y después dejar que Sonnet la implemente.
Probablemente esta sea la forma más útil de entender la familia 5.5.
Las medidas de seguridad aumentaron junto con la capacidad de programación
El artículo original se centra principalmente en el rendimiento y el coste, pero merece la pena señalar un detalle oficial.
Anthropic afirma que la capacidad de ciberseguridad de Sonnet 5.5 mejoró lo suficiente como para que sea el primer modelo Sonnet que se lanza con medidas de seguridad y mecanismos de respaldo similares a los utilizados en sus modelos más capaces.
Anthropic también afirma que estas medidas se dirigen a un conjunto limitado de solicitudes de alto riesgo y no pretenden interferir con el desarrollo de software rutinario.
Esto es importante porque un mayor rendimiento en programación y uso de herramientas también puede aumentar la capacidad de seguridad de uso dual.
Sonnet 5.5 está disponible en las plataformas de Claude
Anthropic afirma que Sonnet 5.5 está disponible a través de:
- Claude.ai
- Claude Code
- Claude Platform / API
- Amazon Web Services
- Google Cloud
- Microsoft Foundry
El ID del modelo en la API es:
claude-sonnet-5-5
Anthropic también admite la retención cero de datos para Sonnet 5.5 en configuraciones de API elegibles.
Para los equipos que migran desde Sonnet 5, Anthropic recomienda revisar los nuevos controles de esfuerzo y el razonamiento de configuración, en lugar de asumir que todos los ajustes de ejecución anteriores deben copiarse sin cambios.
Haiku 5.5 será el siguiente
El artículo de origen termina mirando hacia el siguiente miembro de la familia Claude 5.5.
Anthropic afirma que Haiku 5.5 llegará en las próximas semanas.
Su posicionamiento ya está claro:
alto rendimiento de procesamiento
+
cargas de trabajo sensibles al coste
Si Sonnet 5.5 es el caballo de batalla rápido de propósito general y Opus 5.5 es el modelo para el criterio abierto difícil, se espera que Haiku 5.5 avance aún más hacia una economía de despliegue de alto volumen.
La dirección de la familia Claude 5.5 es cada vez más clara.
Anthropic no solo compite en puntuaciones brutas de benchmarks.
Cada vez presenta más sus modelos en torno a:
calidad
+
velocidad
+
coste por tarea completada
Para los desarrolladores, esta puede ser una métrica de despliegue más útil que la puntuación de un benchmark por sí sola.
Preguntas frecuentes
¿Qué es Claude Sonnet 5.5?
Claude Sonnet 5.5 es el último modelo Sonnet de Anthropic y el segundo lanzamiento de la familia Claude 5.5. Está diseñado como un complemento más rápido y económico de Opus 5.5 para programación, agentes, trabajo de conocimiento, documentos, presentaciones y otras tareas bien definidas.
¿Es Sonnet 5.5 mejor que Opus 5.5?
En algunas pruebas, sí. Sonnet 5.5 obtiene un 70,6 % en Terminal-Bench 4.0, frente al 66,4 % de Opus 5.5, pero Opus sigue liderando la mayoría de las evaluaciones más amplias y continúa siendo más fuerte para trabajos complejos y abiertos que requieren un criterio sostenido.
¿Cuánto cuesta Claude Sonnet 5.5?
Anthropic establece un precio estándar de API de 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida. Las lecturas de caché cuestan 0,20 $ por millón de tokens y las escrituras de caché cuestan 2,50 $ por millón de tokens.
¿Es Sonnet 5.5 más barato que Sonnet 5?
Los precios por token son los mismos, pero Anthropic afirma que Sonnet 5.5 suele utilizar menos tokens y completar el trabajo de forma más eficiente. En sus pruebas, esto reduce el coste por tarea hasta un 30 % en muchas cargas de trabajo.
¿Cuánto más rápido es Sonnet 5.5?
Anthropic afirma que la generación de resultados es más de un 30 % más rápida que en Sonnet 5. Los evaluadores externos también informan de menos llamadas a herramientas, menos ejecuciones de shell y menos iteraciones en muchas tareas de programación.
¿Cómo se compara Sonnet 5.5 con GPT-6 Sol?
El gráfico de coste y rendimiento de FrontierCode de Anthropic muestra que Sonnet 5.5 alcanza un intervalo de calidad similar al de las configuraciones probadas de GPT-6 Sol con un coste de tarea medido considerablemente menor en ese benchmark. No se trata de una proporción de costes universal y no debe interpretarse como una prueba de que Sonnet gane en todas las cargas de trabajo de programación o razonamiento.
¿Qué ID de modelo deben utilizar los desarrolladores?
El ID oficial del modelo en la API de Claude es:
claude-sonnet-5-5
Anthropic afirma que el modelo también está disponible a través de AWS, Google Cloud y Microsoft Foundry.
¿Cuándo se lanzará Claude Haiku 5.5?
Anthropic afirma que Haiku 5.5 llegará en las próximas semanas. Está orientado a aplicaciones de alto rendimiento de procesamiento y sensibles al coste.
Herramientas relacionadas
- Claude: Interfaz de consumo de Anthropic para trabajar con modelos Claude.
- Claude Code: Entorno de programación con agentes de Anthropic para el desarrollo de software a escala de repositorio.
- Claude API: Documentación oficial de la API para integrar
claude-sonnet-5-5en aplicaciones. - Amazon Bedrock: Plataforma de AWS que ofrece modelos Claude para aplicaciones empresariales.
- Google Vertex AI: Plataforma de Google Cloud que proporciona acceso a modelos Claude.
- Microsoft Foundry: Plataforma de desarrollo de IA de Microsoft con disponibilidad de modelos Claude.
Enlaces relacionados
- Artículo original de BAAI Hub: Artículo en chino de QbitAI adaptado y comprobado en esta publicación.
- Anthropic — Presentación de Claude Sonnet 5.5: Anuncio principal con benchmarks, evaluaciones de clientes, precios, gráficos de coste por tarea y notas de seguridad.
- Página de producto de Claude Sonnet: Descripción oficial de los casos de uso, la disponibilidad y los precios de Sonnet 5.5.
- Claude Opus 5.5: Anuncio oficial de Opus 5.5 para compararlo con el modelo insignia de Anthropic.
- Documentación de la API de Anthropic: Documentación oficial de la API y orientación para la integración de modelos.
- Precios de Anthropic: Información actual sobre los precios de los modelos Claude y los planes de producto.
Resumen
Claude Sonnet 5.5 reduce la distancia entre los modelos de gama media e insignia de Anthropic más de lo que su nombre podría sugerir. Supera a Opus 5.5 en Terminal-Bench 4.0, se queda a dos puntos Elo en GDPval-AA y casi iguala a Opus en OSWorld y CursorBench.
La historia más importante para el despliegue es la eficiencia. Sonnet 5.5 mantiene los mismos precios de 2 $ / 10 $ por token que Sonnet 5, pero Anthropic afirma que funciona más de un 30 % más rápido y puede reducir hasta un 30 % el coste por tarea completada. Los evaluadores externos también informan de menos llamadas a herramientas, menos ejecuciones de shell y muchas menos iteraciones.
Opus 5.5 sigue siendo la opción más sólida para trabajos difíciles y abiertos que requieren un criterio sostenido. Sonnet 5.5 se entiende mejor como el caballo de batalla de alto volumen que ahora alcanza una calidad de nivel insignia en un número creciente de tareas bien definidas.
La mejora más importante de Sonnet 5.5 no es una victoria en un único benchmark: es lo cerca que llega de la calidad del modelo insignia mientras mantiene el precio de Sonnet y un coste mucho menor por tarea completada.