Durante la mayor parte de la era de la computación, la tendencia parecía clara: los chips mejoraban continuamente, la infraestructura en la ...
Durante la mayor parte de la era informática, la dirección del desarrollo parecía obvia: los chips mejoraban continuamente, la infraestructura en la nube se expandía de forma constante y el precio efectivo de la computación no dejaba de bajar.
La IA podría romper este patrón.
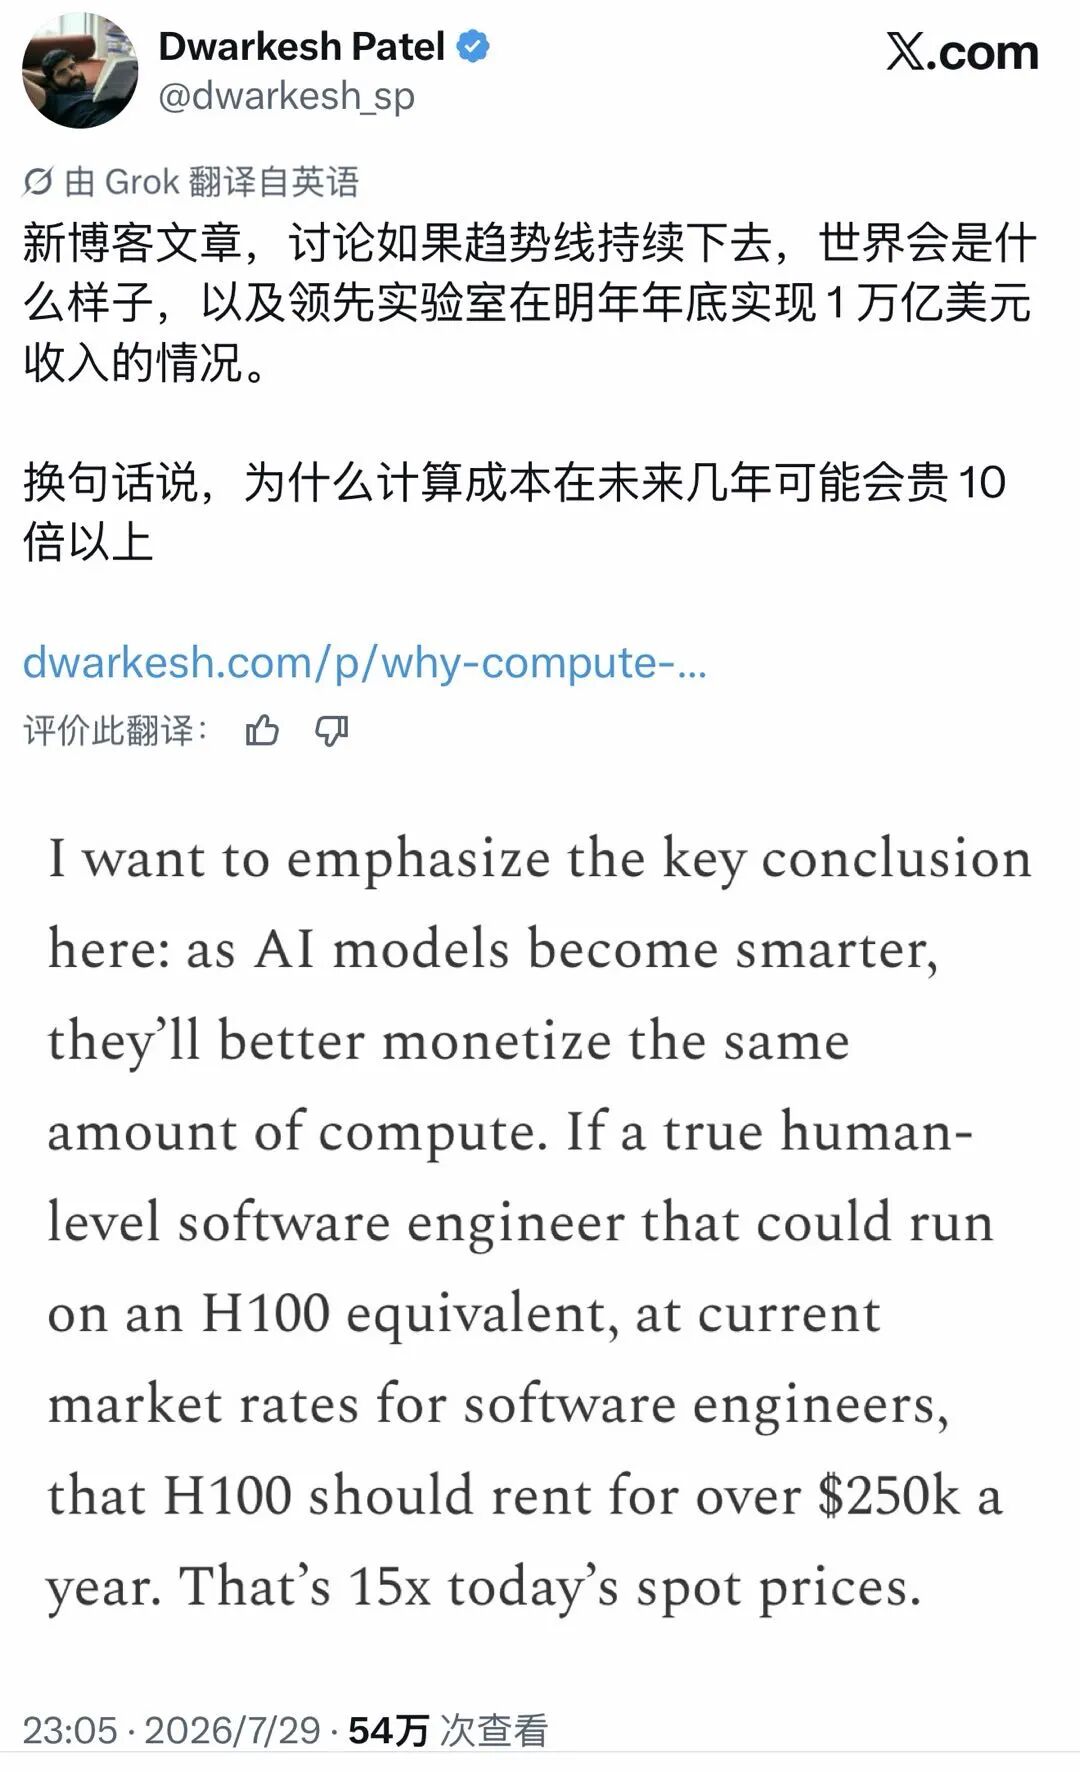
En un artículo del 29 de julio de 2026, el entrevistador tecnológico y escritor Dwarkesh Patel planteó un escenario deliberadamente agresivo: la capacidad de la IA de vanguardia para convertir cómputo en valor económico aumenta drásticamente, mientras que la expansión física de la oferta de cómputo avanzado avanza mucho más lentamente.
En ese escenario, el precio de mercado del cómputo de IA de alta gama podría aumentar 10 veces o más antes de retomar finalmente su trayectoria de reducción de costos a largo plazo.
El argumento comienza con una comparación provocadora.
Si un agente de IA que opera con la capacidad de cómputo equivalente a una NVIDIA H100 pudiera realizar el trabajo de un ingeniero de software bien remunerado, ¿por qué el precio de alquiler de esa GPU seguiría determinado principalmente por la depreciación del hardware y la competencia en la nube?
¿Por qué su precio no se acercaría más al valor económico del trabajo humano que reemplaza o aumenta?
El artículo original expande este experimento mental hacia predicciones más amplias sobre laboratorios de IA, centros de datos, capacidad de semiconductores avanzados y la posibilidad de que el mundo esté entrando en un período de inflación severa de cómputo.
Desde el principio hay varios límites importantes que deben quedar claros:
Bajo las condiciones anteriores, este experimento mental es valioso porque plantea una pregunta que la industria a menudo evita:
¿Qué sucede cuando el valor económico que crea la IA aumenta más rápido que la velocidad a la que el mundo construye la infraestructura para sustentarla?
El argumento comienza cambiando la unidad de comparación.
Hoy en día, el cómputo generalmente se valora como infraestructura:
La pregunta que plantea Patel es: ¿qué sucede cuando el mismo hardware se convierte en el contenedor de fuerza laboral autónoma?
Imaginemos un ingeniero de software de IA capaz de:
Si ese agente requiere aproximadamente la capacidad equivalente a una H100 para operar, entonces la GPU ya no es simplemente un componente de servidor. Es parte de un sistema de producción digital.
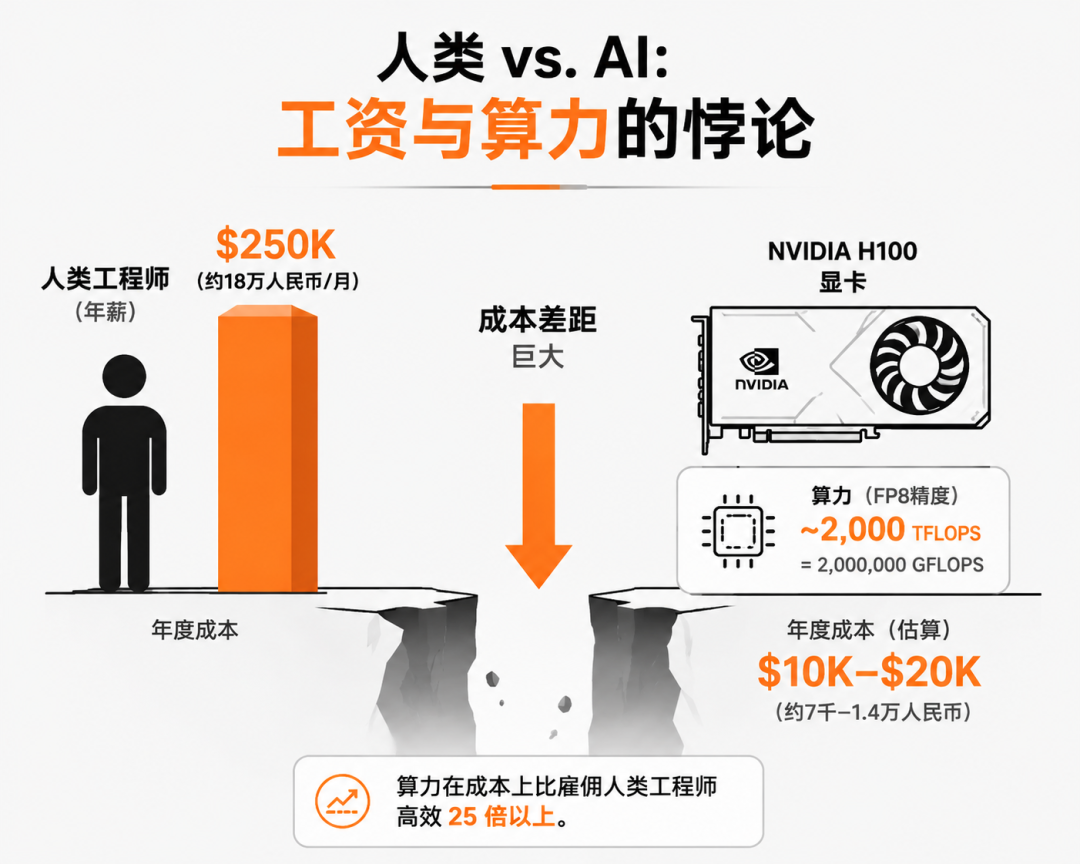
Patel utiliza como referencia el valor de mercado de 250.000 dólares anuales de un ingeniero de software senior de Silicon Valley.
Luego lo compara con la estimación de alquiler al contado anualizado de una H100, aproximadamente 16.000 dólares.
La brecha implícita es:
250.000 / 16.000 ≈ 15,6 veces
En este experimento mental simplificado, una GPU capaz de albergar fuerza laboral digital equivalente parece gravemente infravalorada en relación con el valor laboral que puede generar.
Este cálculo no predice directamente que cada H100 se alquilará por 250.000 dólares.
Omite varios factores importantes:
El punto más estricto de Patel es que cuando el cómputo puede producir resultados más valiosos, la disposición a pagar por cómputo podría aumentar drásticamente.
Una objeción natural es que agregar millones de ingenieros de software de IA reduciría el valor de mercado del trabajo de ingeniería de software.
Si el software se vuelve abundante, un ingeniero digital podría dejar de valer 250.000 dólares.
Patel reconoce esta posibilidad, pero argumenta que no ocurre automáticamente.
El razonamiento económico estándar generalmente rechaza la idea de que "la cantidad de trabajo útil es fija". Trabajadores adicionales calificados pueden crear nuevos productos, nuevas empresas, nuevas especialidades y nueva demanda.
Desde esta perspectiva, un gran aumento de trabajadores capaces no solo divide el trabajo existente entre más participantes. Expande el alcance de lo que es económicamente posible.
La IA podría provocar un shock de oferta laboral inusualmente rápido, por lo que las comparaciones históricas podrían no ser aplicables. Aun así, Patel sostiene que es razonable que el valor marginal del cómputo de IA se mantenga alto a medida que nuevos software y servicios se vuelven viables.
Un contrapunto útil en la discusión bajo el artículo de Patel es que la comparación del valor laboral es más sólida cuando toda la tarea puede completarse en un entorno digital.
La ingeniería de software se acerca a este ideal:
Cuando los cuellos de botella físicos dominan, la comparación se debilita.
Un sistema de IA podría diseñar rápidamente un fármaco, pero los ensayos clínicos aún requieren pacientes, regulaciones, fabricación y tiempo. Podría optimizar una fábrica, pero la construcción, los permisos, la cadena de suministro y los equipos siguen sujetos a limitaciones físicas.
En estas áreas, la inteligencia podría dejar de ser el cuello de botella principal antes de que el poder de cómputo pueda capturar plenamente el valor del trabajo humano que reemplaza.
La segunda parte del argumento pasa de una GPU individual a la situación financiera de los laboratorios de IA de vanguardia.
Anthropic es el ejemplo principal, debido a su crecimiento de ingresos inusualmente rápido en los últimos tiempos.
Los datos reportados oficialmente por Anthropic son los siguientes:
Estos son datos de tasa anualizada, no ingresos auditados del año completo.
Describen la velocidad de crecimiento implícita en los ingresos en un momento determinado.
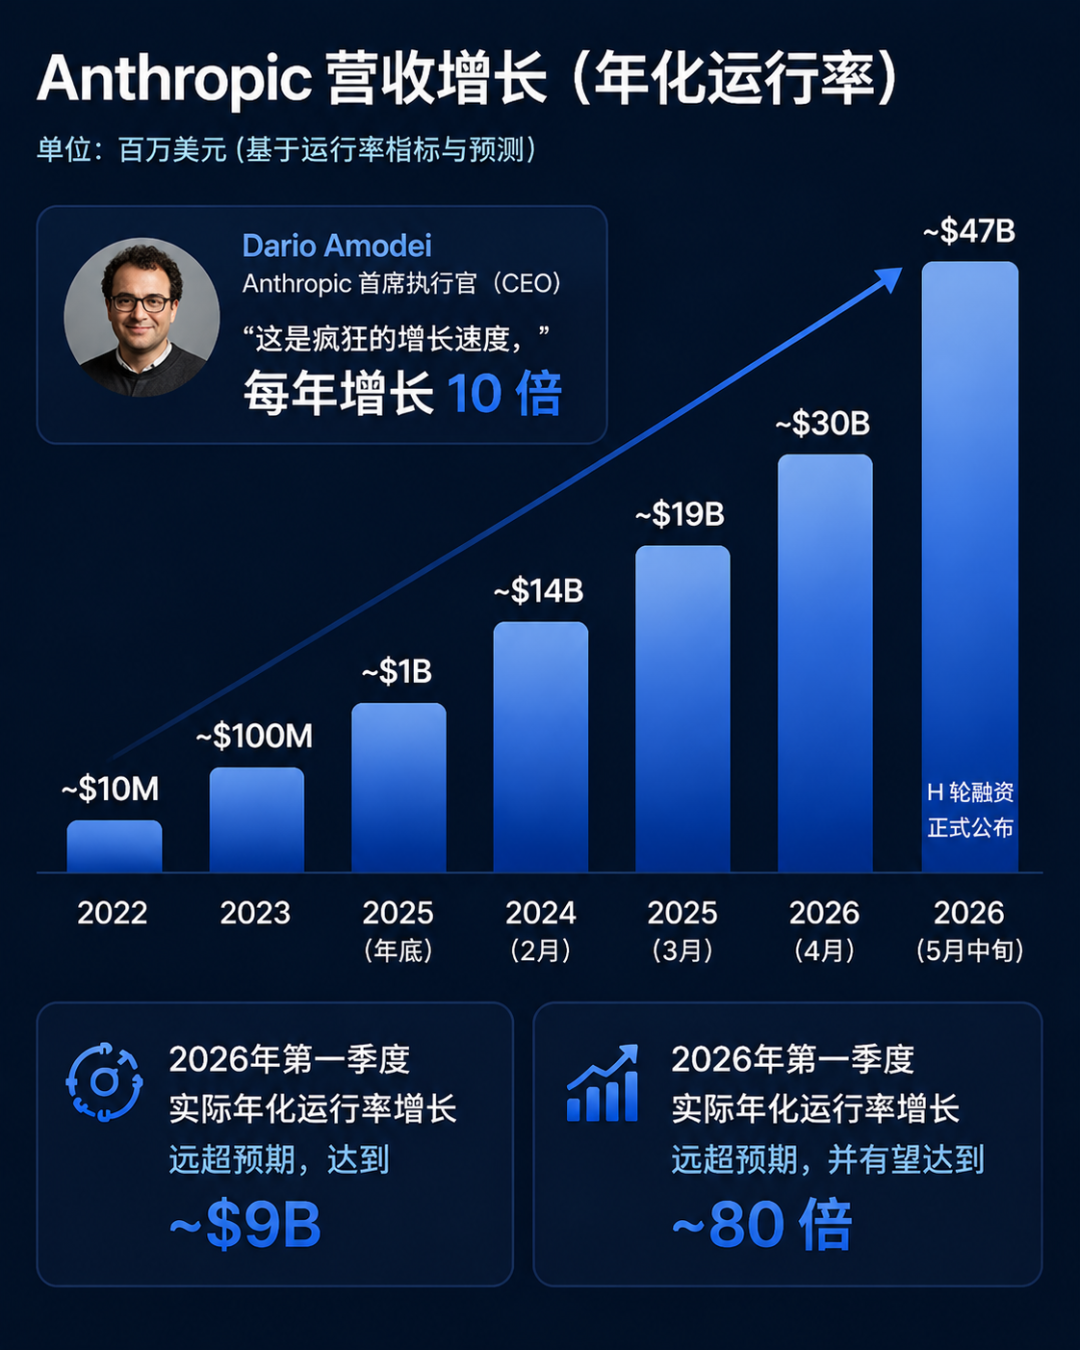
El punto de partida de Patel es una observación: los ingresos de Anthropic han crecido aproximadamente un orden de magnitud interanual.
A partir de ahí, construye un escenario deliberadamente extremo:
Patel señala explícitamente que esta trayectoria no es inevitable ni tiene una razón profunda. Depende de las futuras capacidades de IA, la adopción de productos, los precios y la competencia.
El propósito de este escenario no es afirmar que Anthropic predice un billón de dólares en ingresos, sino plantear: si una empresa de IA realmente creciera a ese ritmo, ¿qué otras condiciones tendrían que cumplirse?
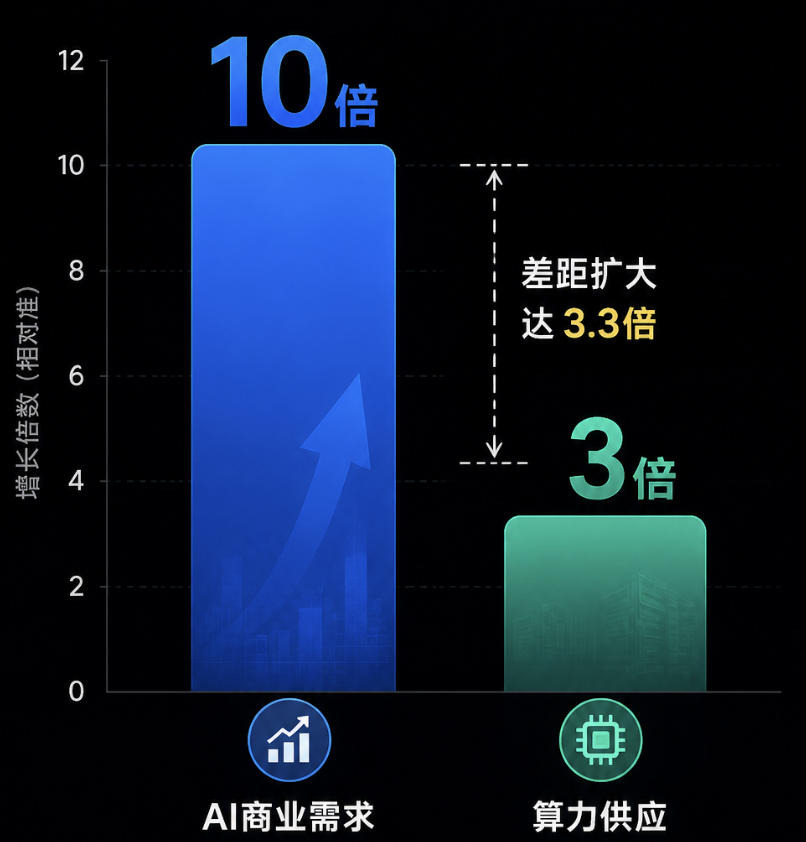
Patel compara un hipotético crecimiento de ingresos de 10 veces con la estimación de una expansión anual de 3 veces en la capacidad computacional de IA.
Epoch AI estima que el inventario global de capacidad computacional de IA en 2025 creció aproximadamente el doble (es decir, se triplicó) en términos equivalentes a H100, aunque también señala que las estimaciones a nivel empresarial y las relacionadas con el futuro siguen siendo inciertas.
El desajuste resultante es de aproximadamente:
Crecimiento de la demanda del negocio de IA: 10 veces
Crecimiento físico de la capacidad computacional: 3 veces
Brecha: aproximadamente 3,3 veces
Si los ingresos de un laboratorio de vanguardia crecen mucho más rápido que su capacidad computacional disponible, entonces necesariamente debe cambiar alguna combinación de las siguientes tres cosas:
Patel cree que los tres cambios ya están ocurriendo en cierta medida.
Los proveedores de modelos invierten grandes costos fijos en entrenar modelos y luego venden las capacidades aprendidas a numerosos clientes.
Esto genera posibles economías de escala.
Las mismas capacidades entrenadas pueden venderse a través de:
El costo marginal de una solicitud adicional puede ser mucho menor que el valor que esa solicitud genera.
Patel señala que los márgenes de inferencia en los laboratorios líderes ya han mejorado significativamente. Sin embargo, los datos específicos de márgenes de inferencia del servicio Fable de Anthropic se presentan explícitamente como estimaciones aproximadas, no como cifras corporativas auditadas.
Los márgenes altos pueden absorber parte de la brecha entre el crecimiento de ingresos y el crecimiento de la capacidad computacional.
La dificultad está en la escala.
En el escenario del billón de dólares de Patel, si los precios y la asignación de capacidad computacional no se ajustan adecuadamente, los márgenes tendrían que elevarse a niveles muy altos, en torno al 95%. En su opinión, incluso para las plataformas tecnológicas líderes, este nivel es excepcionalmente alto.
El margen exacto requerido depende de muchas variables, pero la idea central sigue siendo válida: los márgenes por sí solos probablemente no puedan conciliar una demanda explosiva con una infraestructura limitada.
La segunda opción es asignar una mayor proporción de la capacidad computacional al servicio al cliente.
Epoch AI estima que OpenAI gastó alrededor de 1800 millones de dólares en capacidad de inferencia en 2024, frente a unos 5000 millones en I+D. Según esta estimación, la inferencia representó aproximadamente una cuarta parte del gasto total reportado en capacidad computacional.
A medida que el uso comercial se expande, la proporción de inferencia puede aumentar aún más.
Esto ayuda a sostener los ingresos, pero los laboratorios de vanguardia enfrentan un dilema estratégico.
Los servicios de inferencia pagan las facturas actuales.
El entrenamiento y la experimentación producen los modelos que podrían definir la próxima generación de productos.
Un laboratorio que destina la mayor parte de su capacidad computacional a atender modelos actuales puede generar ingresos más inmediatos, pero tendrá menos infraestructura disponible para:
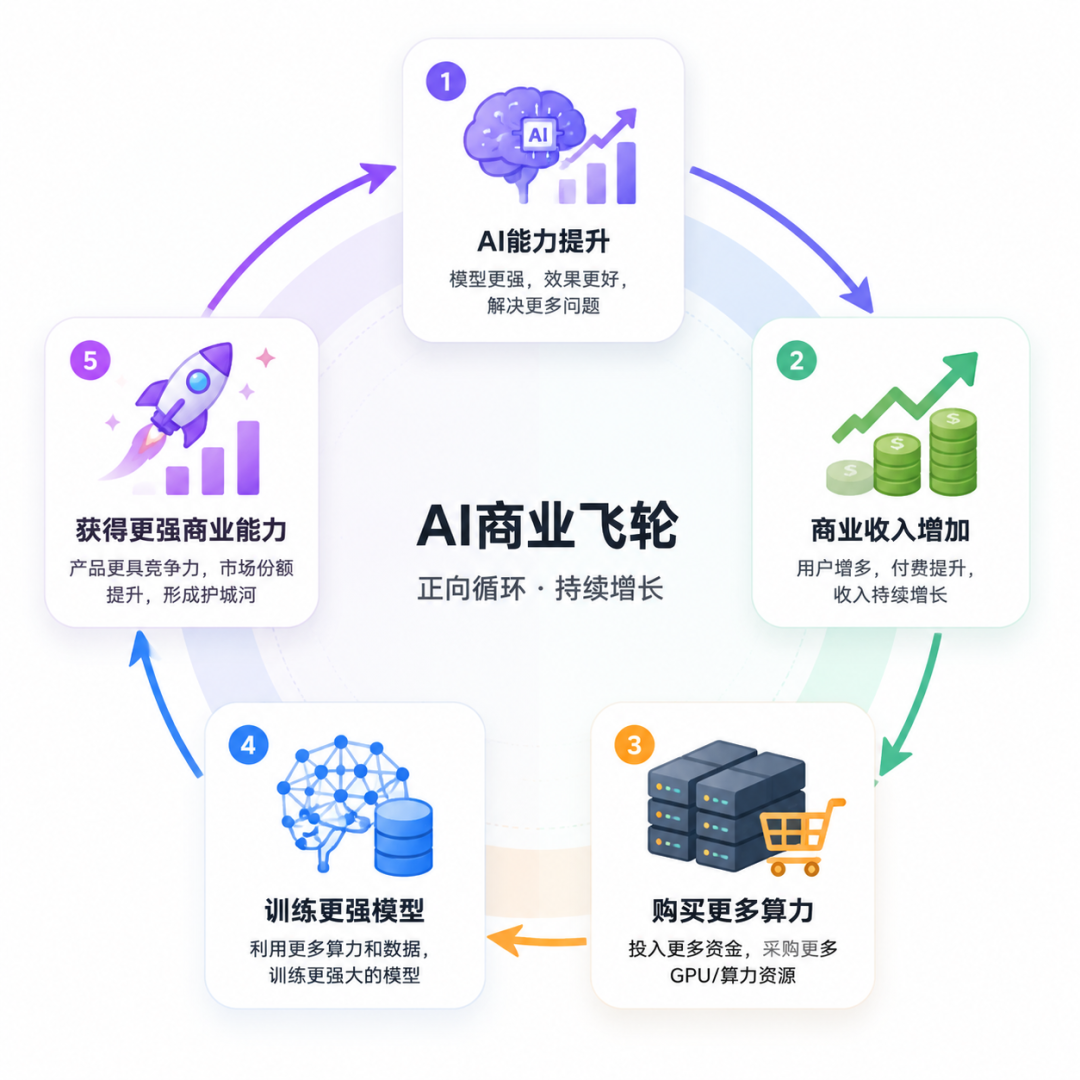
Patel describe un efecto de volante en Silicon Valley: los ingresos actuales por inferencia ayudan a financiar la recaudación de fondos, que compra más capacidad computacional, que entrena mejores modelos, que generan más ingresos.
Estos laboratorios generalmente no consideran los modelos actuales como el punto final. Esperan que los sistemas de vanguardia actuales pronto sean superados.
Esto los hace reacios a transformarse por completo en proveedores de servicios en la nube de alto margen que atienden a generaciones estáticas de modelos.
El ajuste restante es el precio.
Si los laboratorios de IA y sus clientes pueden crear más valor económico por unidad de capacidad computacional, pueden competir con ofertas más agresivas por la infraestructura escasa.
Esto no significa que el precio por hora de GPU aumente de manera uniforme.
Los laboratorios de vanguardia necesitan un tipo de capacidad computacional especializada:
Las instancias de mercado abierto no pueden sustituir por completo un contrato seguro de infraestructura multigigavatio y de varios años.
Los contratos recientes reflejan la prima por la capacidad inmediata.
Anthropic confirmó formalmente su acuerdo con SpaceXAI para acceder a Colossus 1, y posteriormente señaló que ha ampliado la capacidad en Colossus 1 y Colossus 2.
SpaceXAI describió Colossus 1 como un sistema que contiene más de 220 000 GPU NVIDIA, incluyendo sistemas H100, H200 y GB200.
Axios informó que Anthropic acordó pagar aproximadamente 1250 millones de dólares al mes hasta 2029 por este acuerdo.
Posteriormente, un documento regulatorio reportado por TechCrunch mostró que Google pagará a SpaceX aproximadamente 920 millones de dólares al mes entre octubre de 2026 y junio de 2029 para acceder a alrededor de 110 000 GPU y componentes relacionados.
No se trata de compras ordinarias de nube bajo demanda.
Reflejan el valor de obtener rápidamente infraestructura escalable disponible cuando construir nuevos centros de datos, conexiones a la red eléctrica y la entrega de chips pueden llevar años.
Patel estima que el precio implícito por hora de GPU en el acuerdo de Google es aproximadamente el doble del precio spot actual de hardware híbrido comparable.
Esta comparación es aproximada, porque el contrato incluye más que solo GPU y la combinación de hardware abarca aceleradores de diferentes generaciones.
El artículo original utiliza una analogía industrial.
En la era de Internet, las empresas competían por:
La competencia de IA de vanguardia añade una dimensión más tangible:
Los clústeres de GPU de vanguardia se parecen más a líneas de producción industrial que a un conjunto de servidores alquilados comunes.
Su producto no es físico, sino inteligencia con valor económico:
Las empresas que controlan los modelos más potentes y la capacidad de cómputo más fiable tienen el potencial de producir más de este tipo de trabajo digital.
La capacidad spot presenta múltiples desventajas para cargas de trabajo de vanguardia:
Los laboratorios que están entrenando o ejecutando modelos
Los compradores que sirven a modelos de vanguardia valoran más la capacidad de cómputo garantizada que aquellos que ejecutan tareas por lotes a corto plazo.
Esto ayuda a explicar por qué la capacidad de cómputo contratada puede mantener una prima incluso cuando las ofertas de nube pública parecen más baratas.
El argumento de Patel se basa en la afirmación de que la oferta de cómputo no puede reaccionar lo suficientemente rápido a un gran shock de demanda.
Él resume el crecimiento anual de la capacidad de cómputo como el producto de tres multiplicadores amplios:
Crecimiento anual de cómputo para IA ≈
1.4× mejora de hardware
× 1.2× nueva capacidad de obleas
× 1.8× reasignación de obleas avanzadas a IA
≈ 3.0×
Estas cifras son estimaciones, no constantes físicas inmutables.
Están diseñadas para ilustrar de dónde proviene el crecimiento reciente.
Las mejoras en tecnología de semiconductores aumentan el cómputo efectivo entregado por vatio, por chip y por dólar invertido.
Las ganancias potenciales provienen de:
El ritmo de avance no está exento de límites.
Cada nueva generación de proceso es más difícil y más cara. La densidad de potencia, las fugas, el rendimiento, el movimiento de memoria y el empaquetado son cada vez más determinantes del rendimiento real.
Los sistemas de IA también pueden ganar eficiencia mediante mejoras en modelos y software, lo que podría compensar en cierta medida la escasez de hardware. Por lo tanto, cualquier predicción de precios de cómputo depende de la velocidad a la que las ganancias de eficiencia superen el crecimiento de la demanda.
La nueva capacidad de semiconductores requiere años para planificación, financiación, construcción, instalación de equipos, validación y aumento de producción.
La cadena de suministro depende en gran medida de sistemas especializados, incluida la litografía ultravioleta extrema.
Las fábricas avanzadas también necesitan:
Patel sostiene que, al menos hasta finales de esta década, la disponibilidad de equipos EUV limitará una expansión rápida de la capacidad.
Un precio más alto puede estimular la inversión, pero no puede producir instantáneamente una fábrica de proceso avanzado totalmente validada.
Gran parte del crecimiento reciente de chips para IA proviene de desviar capacidad de fabricación avanzada desde otros productos.
Los teléfonos inteligentes, los ordenadores personales, los chips de red y otros dispositivos compiten por los mismos recursos de proceso avanzado y empaquetado.
Patel cita una estimación según la cual, para finales de 2027, la proporción de IA en la capacidad N3 de TSMC podría aumentar de aproximadamente el 60% al 86%.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Se trata de una estimación del modelo de oferta, no de una guía pública de capacidad de TSMC.
La implicación es clara: la reasignación como palanca solo es efectiva mientras la demanda no relacionada con IA siga ocupando capacidad que pueda transferirse.
Una vez que la IA ya consume la mayor parte de la capacidad de los nodos relevantes, esta palanca de crecimiento se debilita considerablemente.
Incluso si la oferta de obleas se expande, todo el sistema puede verse limitado por:
La oferta de cómputo sigue siendo
Por lo tanto, se trata de una cadena, no de la producción de una sola fábrica.
La capacidad efectiva está limitada por el eslabón crítico más lento.
La fuente presenta entonces un argumento contraintuitivo: si el cómputo se vuelve más caro, los compradores no necesariamente se dirigirán a modelos más débiles.
Incluso podrían preferir aún más a los modelos más fuertes.
Patel lo relaciona con el efecto Alchian-Allen.
Cuando se añade un coste fijo a bienes de distinta calidad, la versión de gama alta puede volverse relativamente más atractiva, porque la prima de calidad representa una proporción menor del precio total.
Supongamos que el coste base del cómputo es de 20 dólares por hora.
Un modelo fuerte completa la tarea en una hora, con una prima de 5 dólares sobre el modelo:
Modelo fuerte:
20 $ de cómputo + 5 $ de prima = 25 $
Un modelo débil no tiene prima, pero necesita dos horas debido a reintentos e inferencia ineficiente:
Modelo débil:
2 × 20 $ de cómputo = 40 $
Un modelo aparentemente gratuito resulta más caro por tarea completada.
La métrica clave no es el precio por token ni la licencia del modelo, sino el coste por resultado exitoso.
Los modelos más potentes pueden reducir costes mediante:
Si el cómputo es barato, el coste de intentos ineficientes puede ser asumible.
Si el cómputo es caro, desperdiciar capacidad se vuelve mucho más doloroso.
El laboratorio que pueda extraer la mayor producción útil de cada hora de GPU escasa podría cobrar una prima considerable.
La versión más agresiva del artículo fuente afirma que los modelos mediocres pueden no tener futuro.
Esta conclusión es demasiado amplia.
Los modelos más pequeños y especializados siguen siendo atractivos en los siguientes casos:
Un clasificador ligero no necesita ser un agente de programación de vanguardia.
El argumento Alchian-Allen se aplica cuando ambos modelos consumen infraestructura cara similar y el modelo más débil requiere significativamente más trabajo para lograr el mismo resultado.
Cuando un modelo más pequeño es realmente más eficiente para esa tarea, la fuerza del argumento se debilita.
Patel sostiene que el aumento de los precios del cómputo puede desplazar capacidad desde usos de bajo valor.
Si una GPU puede ejecutar un agente que produce software o resultados comerciales de alto valor, el coste de oportunidad de usar ese mismo hardware para contenido multimedia desechable es mucho mayor.
Esto puede afectar a las siguientes aplicaciones:
El mercado no necesariamente elimina el contenido en sí.
Puede empujarlo hacia:
La clave está en la asignación de recursos.
La escasez
El cómputo de vanguardia tenderá a fluir hacia las cargas de trabajo con mayor disposición a pagar.
El artículo fuente también plantea varias objeciones.
Estas son importantes porque las predicciones sobre escasez permanente de recursos a menudo resultan equivocadas.
La comparación con el ingeniero de 250.000 dólares asume que las GPU pueden capturar un valor cercano al valor económico actual de un ingeniero.
Esta suposición puede fallar por las siguientes razones:
Algunos comentaristas señalan que el valor inicial de un trabajador digital puede ser alto, pero una vez que la mano de obra de IA es abundante, podría estabilizarse en torno a 50.000 dólares.
En ese escenario, el valor del cómputo podría seguir aumentando, pero no necesariamente 15 veces.
El precio por token no es lo mismo que el precio del cómputo.
Los modelos y los sistemas de servicio mejoran continuamente mediante:
Caché
Las respuestas futuras de video o chat de bajo valor podrían requerir solo una fracción del costo computacional actual.
Incluso si el cómputo de los agentes de frontera se vuelve costoso, los servicios generales de IA podrían seguir bajando de precio porque migrarían a modelos y hardware más eficientes.
Los modelos de pesos abiertos pueden ejercer presión sobre los precios de las API de frontera.
Si varios modelos ofrecen capacidades similares, los usuarios pueden cambiar entre las siguientes opciones:
Esto limita la capacidad de un solo laboratorio para obtener márgenes de ganancia extremadamente altos.
La escasez de cómputo aún podría elevar los costos de la infraestructura subyacente, pero la competencia entre modelos determina cuánto valor puede retener cada laboratorio.
La respuesta clásica a la escasez es la inversión.
Los precios más altos del cómputo incentivarían:
Patel también coincide en que el cómputo eventualmente volverá a ser barato.
Su argumento se centra en el período de transición actual, cuando el crecimiento de la demanda podría superar la respuesta de la infraestructura física de ciclo largo.
La fuente compara la predicción sobre el cómputo con la famosa apuesta entre el biólogo Paul Ehrlich y el economista Julian Simon.
En 1980, Ehrlich eligió una canasta de cinco metales y apostó a que sus precios reales subirían en la década siguiente.
Para 1990, el precio ajustado por inflación de la canasta había caído, y Ehrlich pagó la apuesta a Simon.
Esta apuesta se cita a menudo para argumentar que las predicciones de escasez subestiman la innovación, la sustitución y la respuesta de la oferta.
La lectura histórica es más compleja. Los análisis señalan que diferentes décadas iniciales podrían haber producido ganadores distintos.
Patel reconoce que su argumento sobre el cómputo se asemeja a predicciones de escasez que a menudo han resultado erróneas.
Él sostiene que el cómputo podría diferir de la extracción de metales porque su elasticidad de oferta a corto plazo es menor:
Por lo tanto, el desacuerdo es principalmente una cuestión de tiempo.
¿Pueden las señales de precios y la innovación expandir la oferta efectiva de cómputo antes de que la demanda de IA supere la construcción actual?
En lugar de tratar el "10x" como una predicción fija, el argumento puede transformarse en un conjunto de variables medibles.
Un aumento de 10x en el precio es más probable si:
Es menos probable si:
Incluso si el costo del cómputo no se multiplica por 10, el argumento tiene implicaciones prácticas.
Hacer seguimiento de:
Si un modelo más barato falla repetidamente, en realidad no es barato.
Reservar los modelos de frontera costosos para las tareas que realmente se benefician de ellos.
Usar modelos más pequeños para:
Solo escalar los casos difíciles.
Evitar vincular todo el producto a un único modelo o proveedor de GPU.
Las abstracciones útiles incluyen:
Los bucles de agente de larga duración pueden desperdiciar cómputo por contexto repetido y salidas de herramientas demasiado grandes.
Áreas de mejora:
Las empresas con demanda predecible pueden beneficiarse de:
La estrategia correcta depende de la utilización. El hardware reservado es costoso cuando está inactivo.
El argumento también desplaza el foco de los benchmarks de modelos hacia la infraestructura.
Áreas importantes incluyen:
Si la inteligencia se convierte en un insumo económico principal, el control de estas capas se vuelve estratégico.
El resultado podría ser la concentración.
Los laboratorios con los mejores modelos y los ingresos más fuertes podrían pujar por encima de los nuevos participantes por los recursos de cómputo escasos. Estos recursos les ayudan a mejorar sus modelos, lo que refuerza sus ingresos y hace que la siguiente puja sea aún más fácil.
Es un bucle de refuerzo:
Mejores modelos
    ↓
Productos más valiosos
    ↓
Más ingresos
    ↓
Mayor acceso a recursos de cómputo
    ↓
Más entrenamiento e inferencia
    ↓
Mejores modelos
El riesgo es que la producción de inteligencia pueda concentrarse en unas pocas empresas capaces de asumir inversiones de infraestructura masivas.
Patel cree que los modelos de IA más inteligentes podrían generar más ingresos por unidad de cómputo, mientras que la oferta real de cómputo avanzado crece mucho más lentamente. Si la demanda y la disposición a pagar crecen más rápido que la oferta de chips, energía y centros de datos, los precios de mercado podrían subir bruscamente.
No. Anthropic reporta oficialmente ingresos anualizados superiores a 47 mil millones de dólares en mayo de 2026. Las cifras de 100 a 150 mil millones para fin de año y 1 billón para el año siguiente son supuestos en el experimento mental de Patel, no proyecciones de la empresa.
Esta comparación explora cómo podría fijarse el precio del cómputo si un sistema equivalente a una H100 pudiera alojar un agente de IA que realiza el trabajo de un ingeniero bien pagado. Es una referencia de valor hipotética, no evidencia de que un agente actual pueda sustituir a un ingeniero por cada H100.
Epoch AI estima que el cómputo total de IA en 2025 creció aproximadamente 3 veces en equivalentes H100. El crecimiento futuro es incierto y depende del rendimiento de los chips, la fabricación, el empaquetado, la energía, la construcción y el gasto de capital.
Los laboratorios de frontera necesitan clústeres seguros, confiables, a gran escala y con redes de alta velocidad y rendimiento predecible a largo plazo. Las instancias spot públicas no son equivalentes a implementaciones dedicadas de varios años con cientos de miles de aceleradores coordinados.
No necesariamente. Cuando el modelo más fuerte logra el mismo resultado con menos tokens, menos reintentos o menos tiempo, el cómputo caro sí lo favorece. Pero para cargas de trabajo de nicho, baja latencia, privadas o en el dispositivo, los modelos pequeños y dedicados pueden seguir siendo más económicos.
Patel no sostiene que el cómputo permanezca caro permanentemente.
Su argumento involucra un período de transición — durante el cual la demanda de IA podría superar la capacidad de expansión de la cadena de suministro de semiconductores y centros de datos; a más largo plazo, el hardware y la automatización podrían volver a abaratar la capacidad de cómputo.
Si el crecimiento de los ingresos de IA se desacelera, las capacidades de los modelos alcanzan un techo, los modelos de código abierto se convierten en sustitutos muy cercanos, la eficiencia de los servicios mejora más rápido que el crecimiento de la demanda, o la expansión del suministro de semiconductores y electricidad supera lo esperado, entonces el argumento se debilitaría.
AI: Gasto en cómputo de OpenAI en 2024](https://epoch.ai/data-insights/openai-compute-spend): Estimaciones sobre la distribución del cómputo de OpenAI en 2024 entre investigación, entrenamiento e inferencia.
El argumento de Dwarkesh Patel sobre el precio del cómputo 10 veces mayor comienza con una idea simple: si una GPU puede albergar agentes de IA que realizan trabajo de conocimiento de alto valor, la disposición a pagar por esa GPU podría pasar a estar vinculada al valor de ese trabajo, en lugar del costo histórico del servidor.
Cuando se combina con el rápido crecimiento de los ingresos de Anthropic y las estimaciones de que el cómputo global de IA se está expandiendo a un ritmo de aproximadamente 3 veces por año, este argumento cobra más fuerza. Si la demanda comercial de IA crece más rápido, el ajuste inevitablemente se producirá a través de los márgenes de beneficio, la asignación de cómputo, el aumento de los precios de la infraestructura, o alguna combinación de estos tres factores.
Esta predicción está lejos de ser segura. Las mejoras en eficiencia energética, los modelos de código abierto, los sistemas especializados más pequeños, las nuevas fábricas de semiconductores, los nuevos aceleradores y la desaceleración del crecimiento de capacidades podrían impedir que ocurra el aumento de 10 veces. Históricamente, las predicciones de escasez de recursos también han subestimado con frecuencia la capacidad de adaptación.
La visión verdaderamente duradera no es que el cómputo deba encarecerse exactamente 10 veces, sino que una IA más inteligente puede elevar el valor económico de cada GPU más rápido de lo que el mundo físico puede fabricar y alimentar nuevas GPUs.
Empieza con una sola frase y obtén un sitio completo en minutos.



