DeepSeek V4 Flash 0731 ha generado una combinación inusual de reacciones. Los desarrolladores están impresionados por sus puntuaciones en ag...
DeepSeek V4 Flash 0731 ha generado una combinación inusual de reacciones.
Los desarrolladores están impresionados por sus puntuaciones en agentes de codificación.
Los equipos de infraestructura están interesados en su contexto de 1 millón de tokens y su bajo número de parámetros activos.
Las plataformas de IA están ofreciendo uso gratuito y descuentos agresivos.
Y las redes sociales se llenan de capturas de pantalla de prototipos cuyas facturas de inferencia reportadas se miden en céntimos en lugar de dólares.
Los ejemplos más compartidos en el artículo fuente incluyeron:
Estos ejemplos capturan la emoción, pero también pueden difuminar varias cosas distintas:
El modelo es genuinamente económico.
Eso no significa que cada aplicación cueste siete céntimos.
La pregunta útil no es si una demo viral es reproducible exactamente. Es cómo DeepSeek logró un salto de capacidad tan grande sin cambiar la arquitectura base—y qué significan las nuevas economías para los desarrolladores.
El precio oficial de la API ya era bajo antes de aplicar las promociones de terceros.
DeepSeek actualmente lista los siguientes precios por millón de tokens:
| Tipo de uso | Precio de DeepSeek V4 Flash |
|---|---|
| Entrada, acierto de caché | $0,0028 |
| Entrada, fallo de caché | $0,14 |
| Salida | $0,28 |
La API admite:
low, high y max.Esos precios oficiales son la línea base.
Las plataformas pueden entonces elegir:
Por eso un desarrollador puede pagar el precio de lista de DeepSeek mientras otro no paga nada durante un período limitado.
OpenCode declaró públicamente que DeepSeek Flash procesó 8 billones de tokens el 1 de agosto a través de su plataforma.
La publicación desglosa la cifra de la siguiente manera:
5 billones de tokens de uso gratuito
+
3 billones de tokens a través de OpenCode Go

La documentación actual de Zen de OpenCode enumera una opción DeepSeek V4 Flash Free disponible por tiempo limitado.
Esta es una distinción importante.
La cifra de ocho billones de tokens describe el tráfico a través de OpenCode, no el uso directo reportado por DeepSeek en todas las plataformas.
Sigue siendo una señal contundente de que los modelos de bajo costo pueden generar una demanda enorme cuando se integran en un flujo de trabajo popular de agentes de codificación.
Nous Research anunció una promoción de siete días que ofrece DeepSeek V4 Flash 0731 con un 90% de descuento a través de Nous Portal en colaboración con Novita Labs.

La publicación promocional comparó el costo con descuento con Claude Fable 5 y afirmó una diferencia de precio de más de 1,000 veces en tareas comparables.
Esa comparación depende de varias elecciones:
Una comparación de precio por token es útil, pero la métrica más significativa es:
Costo total por tarea aceptada
Un modelo que utiliza menos tokens costosos puede ser más barato que un modelo de bajo precio que reintenta repetidamente.
Por el contrario, cuando un modelo de bajo precio también es lo suficientemente capaz para completar la tarea rápidamente, la ventaja de costo puede volverse enorme.
Cline anunció inicialmente el uso gratuito de V4 Flash 0731 a través de su agente de codificación.
Una publicación pública posterior dijo que la cuota gratuita se había triplicado porque la economía parecía sostenible.

El catálogo de modelos actual de Cline y el material de ClinePass incluyen DeepSeek V4 Flash como una opción rápida y orientada al valor para tareas de codificación enfocadas.
Las cuotas gratuitas y la disponibilidad de modelos pueden cambiar, por lo que los usuarios deben consultar la página del proveedor en vivo en lugar de confiar en una captura de pantalla antigua.
La lección más amplia es más duradera.
Cuando la inferencia se vuelve lo suficientemente barata, una plataforma de agentes puede usar el acceso gratuito como adquisición de clientes sin absorber
el mismo costo que enfrentaría con un modelo frontera premium.
El artículo original incluye un panel que muestra:
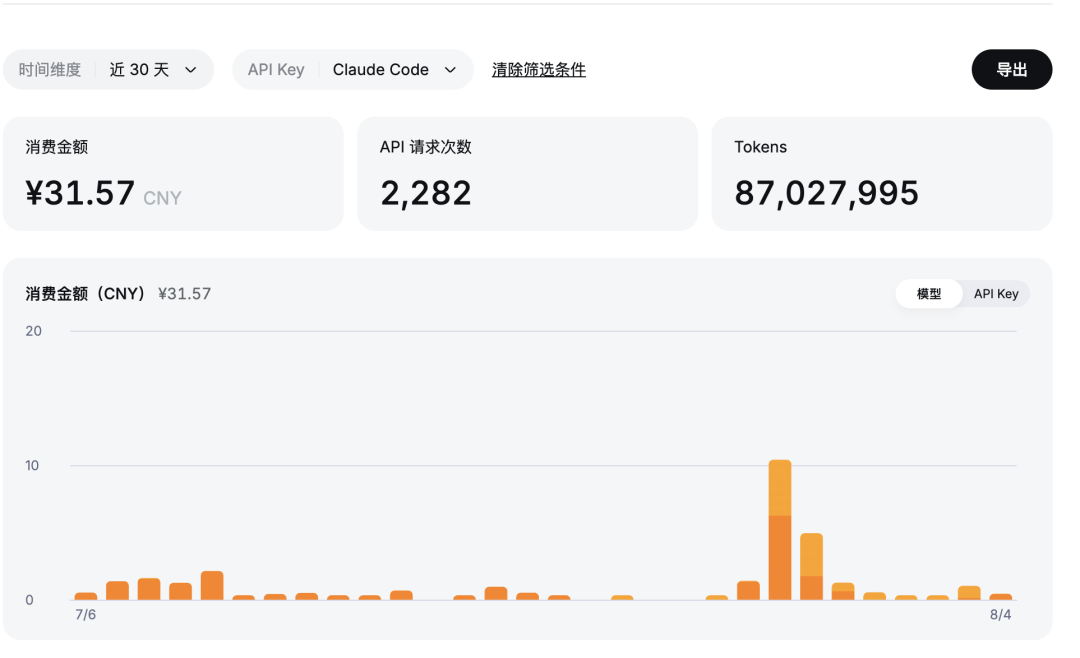
La captura de pantalla es útil porque demuestra el orden de magnitud que los desarrolladores pueden ver bajo patrones de uso favorables.
No revela suficiente información para reconstruir la factura exactamente.
Las variables que faltan incluyen:
Un prompt de sistema largo y repetido puede ser extremadamente barato cuando se sirve desde la caché.
Un prompt único y largo enviado una sola vez se factura al precio de entrada sin acierto de caché.
La salida también es mucho más cara que la entrada con caché.
Para sistemas de agentes, estas diferencias dominan la factura final.
DeepSeek V4 Preview se lanzó el 24 de abril de 2026.
La familia incluía:
El lanzamiento de Preview estableció la arquitectura principal:
V4 Flash Preview se posicionó como la alternativa más pequeña, rápida y barata a V4 Pro.
La actualización del 31 de julio cambió su posición competitiva.
DeepSeek afirma que V4 Flash 0731 utiliza la misma arquitectura y tamaño de modelo que V4 Flash Preview.
La actualización se produjo ejecutando un nuevo proceso de post-entrenamiento.
En forma simplificada:
Misma arquitectura base preentrenada
+
nuevo post-entrenamiento y optimización de agentes
=
comportamiento de agente de código mucho más fuerte
Esto es importante porque muestra cuánta capacidad puede permanecer latente en un modelo preentrenado.
La arquitectura y el número de parámetros no son todo el producto.
El post-entrenamiento determina la eficacia con la que el modelo:
La ficha técnica del modelo original V4 Flash describe el modelo base como:
| Especificación | DeepSeek V4 Flash |
|---|---|
| Parámetros MoE base totales | 284B |
| Parámetros activados | 13B |
| Longitud de contexto | 1M |
| Licencia | MIT |
| Modalidad principal | Texto |
| Precisión base | FP8 / precisión mixta baja según el checkpoint |
La ficha técnica del modelo 0731 dice que el nuevo lanzamiento tiene la misma estructura que la variante DSpark e incluye un módulo adjunto de decodificación especulativa.
Esto explica por qué algunos metadatos de archivos del modelo pueden mostrar
un recuento total de puntos de control mayor que la cifra base de 284B del MoE.
La descripción más clara es:
El modelo MoE subyacente de V4 Flash sigue siendo de aproximadamente 284B en total con 13B de parámetros activos, mientras que la versión 0731 incluye el componente adicional de decodificación especulativa DSpark en el punto de control publicado.
La decodificación especulativa utiliza un proceso de borrador rápido para proponer varios tokens futuros.
El modelo principal verifica entonces esas propuestas.
Cuando las predicciones se aceptan, el sistema puede producir múltiples tokens con menos trabajo secuencial.
La tarjeta del modelo 0731 de DeepSeek proporciona soporte explícito de DSpark para vLLM y SGLang.
Para vLLM, la configuración relevante es:
--speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Para SGLang, la tarjeta del modelo utiliza:
--speculative-algorithm DSPARK
DSpark no mejora el razonamiento del modelo por sí mismo.
Es una optimización de inferencia destinada a reducir la latencia de decodificación o aumentar el rendimiento, preservando al mismo tiempo la distribución de salida del modelo objetivo bajo la configuración compatible.
DeepSeek publica la siguiente comparación para V4 Flash 0731:
| Punto de Referencia | V4 Flash 0731 | V4 Flash Preview | V4 Pro Preview |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
| CyberGym | 76.7 | 38.7 | 52.7 |
| DeepSWE | 54.4 | 7.3 | 12.8 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| Agents’ Last Exam | 25.2 | 15.8 | 16.5 |
| AutomationBench Public | 25.1 | 10.8 | 12.8 |
| DSBench-FullStack | 68.7 | 37.0 | 41.8 |
| DSBench-Hard | 59.6 | 25.8 | 31.1 |
El aumento más drástico es DeepSWE:
7.3 → 54.4
CyberGym casi se duplica:
38.7 → 76.7
Terminal Bench 2.1 sube más de veinte puntos:
61.8 → 82.7
El nuevo modelo Flash también supera a V4 Pro Preview en todos los puntos de referencia de la tabla publicada por DeepSeek.
Eso es un cambio importante para un modelo posicionado originalmente principalmente como la opción más barata y rápida.
La tabla no debe leerse como una comparación pura de puntos de control sin procesar.
La tarjeta del modelo de DeepSeek incluye varias notas importantes.
Para las tareas públicas de agentes de código, la empresa utilizó:
DeepSeek Harness modo mínimo
Esfuerzo de razonamiento: máximo
Temperatura: 1.0
Top-p: 0.95
DeepSeek Harness no había sido publicado públicamente en el momento de la verificación.
Esto significa que los investigadores externos pueden no ser capaces aún de reproducir el entorno de software exacto utilizado para los resultados publicados de agentes de código.
Dos pruebas también son internas:
Los puntos de referencia internos pueden ser útiles para el desarrollo de productos, pero los equipos independientes no pueden inspeccionar sus tareas ocultas ni los controles de contaminación.
La interpretación correcta es:
DeepSeek reporta una gran mejora bajo su pila de agentes y configuración de evaluación elegidas. La reproducibilidad pública mejorará cuando el harness, los prompts, los registros y la configuración completa de evaluación estén disponibles.
Un punto de referencia de codificación a menudo mide un sistema completo:
Modelo
+
prompt del sistema
+
herramientas de repositorio
+
terminal

ejecución
+
gestión de contexto
+
política de reintentos
+
retroalimentación de pruebas
+
lógica de envío de parches

El mismo modelo puede puntuar de manera diferente cuando cambia un componente.

Un mejor entorno de ejecución puede:

- Seleccionar archivos más relevantes.
- Conservar salida útil de terminal.
- Evitar el desbordamiento de contexto.
- Reintentar comandos fallidos de forma inteligente.
- Detener bucles improductivos.
- Aplicar parches de forma más fiable.
- Dar al modelo resultados de prueba más claros.

Esto no hace que el modelo sea irrelevante.

Significa que el resultado del benchmark pertenece a la combinación modelo-entorno.

Los sólidos números de 0731 sugieren que DeepSeek mejoró tanto el comportamiento del agente del modelo como el proceso de evaluación circundante.

## Artificial Analysis lo puntúa en 50

Artificial Analysis reporta un puntaje de Índice de Inteligencia de aproximadamente **50** para DeepSeek V4 Flash 0731, unos diez puntos por encima de la versión Flash anterior.

La firma independiente de análisis de modelos también describe a V4 Flash como excepcionalmente económica en comparación con otros sistemas frontera conocidos.

Reuters resumió los hallazgos de Artificial Analysis al informar un costo promedio de prueba de benchmark de aproximadamente tres centavos de dólar estadounidense bajo su metodología.

Esa comparación respalda el argumento de valor.

No significa que cada tarea de producción cueste tres centavos.

Artificial Analysis también reporta resultados más débiles en algunas medidas de confiabilidad del conocimiento.

Su artículo sobre V4 Flash 0731 señala:

- La precisión de omnisciencia se mantuvo alrededor del 37%.
- La tasa de alucinaciones disminuyó pero siguió siendo alta, aproximadamente al 84% bajo esa evaluación.

Esas cifras son un recordatorio útil.

Un modelo puede ser:

- Muy fuerte en agentes de codificación.
- Extremadamente económico.
- Competitivo en un índice compuesto.
- Aún poco confiable en algunas preguntas fácticas de mundo abierto.

"Mejor valor" no es lo mismo que "mejor para cada tarea".

## Precios oficiales de la API

El precio directo de la API de DeepSeek es:

| Categoría de facturación | Precio por 1M de tokens |
|-|-|
| Entrada con acierto de caché | \$0.0028 |
| Entrada sin acierto de caché | \$0.14 |
| Salida | \$0.28 |

La diferencia de precio entre un acierto de caché y un fallo de caché es enorme:

```Plaintext
\$0.14 ÷ \$0.0028 = 50
La entrada en caché es cincuenta veces más barata que la entrada sin caché.
Para agentes de larga duración, la estructura del prompt se convierte en arquitectura de costos.
Supongamos que una solicitud utiliza:
100,000 tokens de entrada sin caché
20,000 tokens de salida
El costo directo del modelo es:
Entrada:
100,000 / 1,000,000 × \$0.14
= \$0.014

Salida:
20,000 / 1,000,000 × \$0.28
= \$0.0056

Total:
\$0.0196
Eso es menos de dos centavos de dólar estadounidense.
Ahora supongamos que el mismo prefijo de 100,000 tokens está en caché:
Entrada en caché:
100,000 / 1,000,000 × \$0.0028
= \$0.00028

Salida:
20,000 / 1,000,000 × \$0.28
= \$0.0056

Total:
\$0.00588
La salida ahora domina la factura.
Estos ejemplos explican por qué los prototipos de codificación de bajo costo son plausibles.
No incluyen:
La codificación agéntica rara vez es una sola solicitud.
Un flujo de trabajo típico puede incluir:
fallo.
7. Editar de nuevo.
8. Ejecutar las pruebas otra vez.
9. Revisar el diff.
10. Producir la respuesta final.
Cada paso puede generar otra llamada al modelo.
Una tarea aparentemente pequeña puede resultar costosa cuando:
V4 Flash reduce el precio de estos errores.
No los elimina.
DeepSeek utiliza caché de contexto basado en disco.
Cuando se reutiliza el mismo prefijo, los tokens de entrada coincidentes pueden recibir el precio más bajo de caché.
Buenos candidatos para un prefijo estable incluyen:
Un diseño de prompt simplificado es:
Prefijo estable reutilizable
+
nueva solicitud del usuario
+
último resultado de la herramienta
Un diseño menos compatible con caché es:
Instrucciones reordenadas
+
resumen del repositorio reescrito
+
marcas de tiempo cambiantes
+
metadatos aleatorios de la solicitud
+
nueva solicitud del usuario
Pequeños cambios en el prefijo pueden reducir la reutilización de caché.
Los desarrolladores deben inspeccionar los campos de uso de tokens en lugar de asumir que un prompt largo fue almacenado en caché.
DeepSeek también ofrece aislamiento por user_id para privacidad y programación. La reutilización de caché y el aislamiento de usuarios deben diseñarse juntos para que el contexto de un cliente no se mezcle accidentalmente con el de otro.
La URL base oficial sigue siendo:
https://api.deepseek.com
El ID del modelo es:
deepseek-v4-flash
DeepSeek afirma que el ID de API estable sirve automáticamente la última versión oficial de Flash.
Eso es conveniente, pero los equipos de producción deberían registrar la huella digital del modelo devuelto y probar los cambios, porque el comportamiento detrás de un ID estable puede actualizarse.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_DEEPSEEK_API_KEY",
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-flash",
    messages=[
        {
            "role": "user",
            "content": "Revisa esta función y propón un refactor seguro.",
        }
    ],
)

print(response.choices[0].message.content)
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-flash",
    "messages": [
      {
        "role": "user",
        "content": "Escribe una pequeña CLI en Python que valide archivos JSON."
      }
    ]
  }'
Los desarrolladores deberían consultar la referencia de API en vivo para conocer los campos exactos de esfuerzo de razonamiento y modo de pensamiento compatibles con su endpoint y versión del SDK.
La documentación del modo de pensamiento de DeepSeek dice que cuando un turno incluye llamadas a herramientas, el reasoning_content del mensaje del asistente debe pasarse de vuelta en solicitudes posteriores.
Un agente multi-turno debe conservar:
contentreasoning_content
tool_callsEliminar el estado de razonamiento puede reducir la continuidad o causar problemas de validación de solicitudes.
Esto es especialmente relevante al integrarse mediante un cliente compatible con OpenAI que normalmente ignora los campos de razonamiento específicos del proveedor.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
DeepSeek ofrece más de una interfaz.
Utilice la URL base estándar de DeepSeek y el ID del modelo:
deepseek-v4-flash
DeepSeek también documenta una interfaz en formato Anthropic.
Esto puede ayudar a que el software creado en torno a los mensajes estilo Claude se conecte a DeepSeek con menos cambios en la aplicación.
La compatibilidad no garantiza un comportamiento idéntico.
Los campos específicos del proveedor, el historial de razonamiento, los esquemas de herramientas, el comportamiento de seguridad y el manejo de errores aún requieren pruebas.
DeepSeek afirma que la versión 0731 es compatible de forma nativa con el formato de la API Responses y se ha adaptado para su uso estilo Codex.
Esto es importante para los productos de agentes de codificación que dependen cada vez más de objetos de respuesta con estado, llamadas a herramientas y bucles de agente estructurados.
DeepSeek ha publicado los pesos de V4 Flash 0731 en Hugging Face bajo la licencia MIT.
Esto permite a los desarrolladores inspeccionar, modificar, implementar y redistribuir el modelo sujeto a los términos de la licencia.
La publicación de pesos abiertos ofrece más control que un modelo solo de API.
Los equipos pueden:
La barrera práctica es el hardware.
"Pesos abiertos" no significa "se ejecuta en una computadora portátil normal".
La tarjeta oficial del modelo 0731 proporciona un ejemplo de vLLM para un solo nodo 4×GB300:
vllm serve deepseek-ai/DeepSeek-V4-Flash-0731 \
  --trust-remote-code \
  --kv-cache-dtype fp8 \
  --block-size 256 \
  --data-parallel-size 4 \
  --enable-expert-parallel \
  --moe-backend deep_gemm_mega_moe \
  --attention-config '{"use_fp4_indexer_cache": true}' \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"greedy"}'
Este ejemplo demuestra la clase de infraestructura esperada para un servicio de calidad completa.
No debe interpretarse como la única configuración admitida.
La receta de vLLM puede agregar soporte para otras topologías de GPU con el tiempo.
El ejemplo oficial de SGLang es:
sglang serve \
  --trust-remote-code \
  --model-path deepseek-ai/DeepSeek-V4-Flash-0731 \
  --tp 4 \
  --moe-runner-backend flashinfer_mxfp4 \
  --speculative-algorithm DSPARK \
  --mem-fraction-static 0.90 \
  --chunked-prefill-size 4096 \
  --swa-full-tokens-ratio 0.1
Los pesos objetivo y de borrador provienen del mismo punto de control, por lo que la documentación indica no configurar una ruta separada para el modelo de borrador especulativo.
Los motores de inferencia evolucionan rápidamente.
Utilice la tarjeta de modelo y la receta del motor de servicio actuales en lugar de copiar un comando de lanzamiento antiguo de la versión Preview.
Aunque solo alrededor de
13B parámetros están activos para un token, los pesos completos del modelo deben permanecer disponibles en todo el sistema de servicio.
La planificación del despliegue debe considerar:
Cuantificaciones más pequeñas pueden hacer posible la experimentación en diferentes hardware, pero pueden cambiar la calidad, la velocidad o la longitud de contexto admitida.
Para la mayoría de los desarrolladores individuales, la API directa o un proveedor alojado será más fácil y más barato que el autoalojamiento.
Hay tres formas comunes de usar V4 Flash.
| Ruta | Ventaja principal | Compensación principal |
|---|---|---|
| API de DeepSeek | Precio oficial y modelo oficial actual | Los datos salen de tu entorno; la ID estable puede actualizarse |
| Plataforma de terceros | Cuotas gratuitas, agentes integrados, facturación más fácil | Las promociones y el enrutamiento pueden cambiar |
| Pesos autoalojados | Máximo control y privacidad | Requisitos significativos de hardware e ingeniería |
La ruta más económica depende de la carga de trabajo.
Una cuota gratuita de Cline u OpenCode puede ser la mejor para experimentación.
La API directa puede ser la mejor para uso predecible a pequeña escala.
El autoalojamiento puede volverse atractivo solo con un volumen suficientemente alto y sostenido o cuando los requisitos de privacidad dominan.
El artículo fuente compara la IA económica con la producción en masa de automóviles.
La analogía es imperfecta pero útil.
Cuando una tecnología se vuelve drásticamente más barata, el mercado no simplemente compra la misma cantidad por menos dinero.
Se vuelven posibles nuevos usos.
Los modelos de agentes de bajo costo pueden respaldar experimentos que previamente habrían sido rechazados antes de las pruebas.
Ejemplos incluyen:
El valor no es que el modelo reemplace toda la ingeniería de software.
Reduce el costo de preguntar:
¿Vale la pena desarrollar esta idea más a fondo?
La generación barata puede producir una primera demostración convincente.
Un producto de producción todavía necesita:
Una factura de modelo de siete centavos no significa un negocio de siete centavos.
Significa que el primer experimento computacional puede ser lo suficientemente barato como para intentarlo.
Eso cambia quién puede participar y cuántas ideas pueden probarse.
El artículo fuente incluye un espacio de trabajo de documentos ligero mostrado como un ejemplo de lo que los desarrolladores estaban construyendo con agentes de codificación económicos.
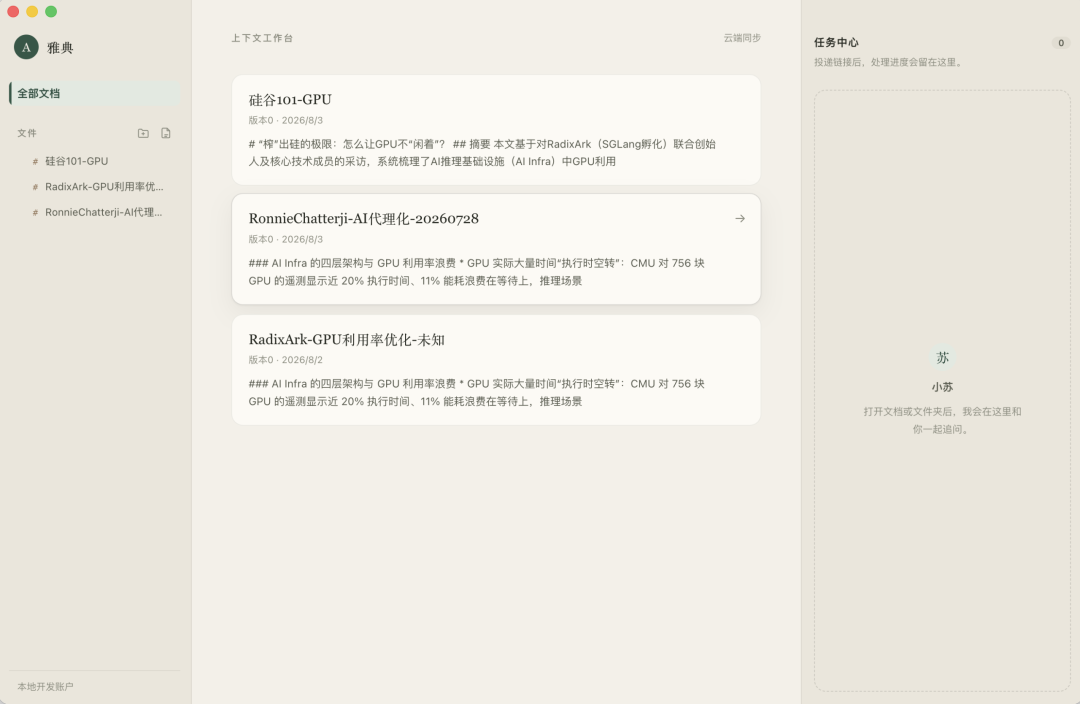
Una captura de pantalla no puede establecer qué parte de la aplicación fue producida por el modelo, cuánta edición humana se requirió, ni si el producto es seguro y mantenible.
Sí muestra el tipo de proyecto que los modelos de codificación de bajo costo facilitan para crear prototipos.
V4 Flash 0731 es especialmente atractivo cuando:
Puede ser menos adecuado cuando:
Un enrutador de modelos puede combinar Flash con un sistema más potente o más especializado.
Por ejemplo:
Ediciones rutinarias de repositorio
→ V4 Flash

Decisiones de arquitectura o seguridad de alto riesgo
→ modelo más potente + revisión humana
Cuando las llamadas a modelos son caras, los desarrolladores intentan minimizar cada solicitud.
Cuando las llamadas se vuelven baratas, un agente puede permitirse:
Esto puede aumentar la fiabilidad.
También puede desperdiciar tokens.
El objetivo correcto no es el uso mínimo de tokens.
Es:
El costo total más bajo que alcanza la calidad requerida
DeepSeek describe la API oficial de Flash como una beta pública.
Los precios, el comportamiento, los límites y las versiones del modelo pueden cambiar.
Los equipos de producción deben mantener pruebas de regresión.
Los resultados más sólidos del agente de código utilizan una configuración de harness no publicada.
La reproducción independiente exacta aún no es sencilla.
La salida, los reintentos, las herramientas y el contexto no almacenado en caché pueden dominar el costo final.
Una ventana de 1 millón de tokens es un límite de capacidad, no una recomendación para enviar un millón de tokens en cada solicitud.
Las cargas de trabajo grandes de prefill aumentan la latencia y el costo.
La evaluación independiente muestra que el valor y la capacidad de codificación pueden coexistir con una alta tasa de alucinaciones en pruebas fácticas.
Los datos críticos deben verificarse contra las fuentes.
Los modelos de bajo costo pueden generar más código del que un equipo puede inspeccionar de forma segura.
Las pruebas automatizadas, el análisis estático, el escaneo de dependencias y la revisión humana siguen siendo necesarios.
Los modelos gratuitos de terceros y los descuentos pueden desaparecer.
No construyas un modelo de negocio permanente basado en un subsidio de siete días o de tiempo limitado.
El ID del modelo deepseek-v4-flash apunta a la versión actual.
Una actualización detrás de ese ID puede cambiar los resultados sin que haya un cambio de código en tu aplicación.
Mantén las instrucciones del sistema y las definiciones de herramientas consistentes para mejorar la reutilización de la caché.
No te bases únicamente en el total de tokens de entrada.
Establece un presupuesto de salida realista para la tarea.
Reserva max para tareas que se beneficien de una deliberación más larga.
Detén los bucles que no están progresando.
Usa linters, pruebas, validadores de esquemas y comprobaciones deterministas.
Escala solo cuando la tarea falle una prueba o supere un umbral de riesgo.
Incluye los intentos fallidos y la revisión humana.
El artículo original termina con un posible siguiente paso en el ecosistema de desarrolladores de DeepSeek.
Tianyi Cui, identificado en la fuente como el responsable de DeepSeek Harness, publicó un mensaje de reclutamiento para desarrolladores de proyectos de código abierto de agent-harness.
El mensaje invitaba a los desarrolladores interesados a compartir una cuenta de GitHub y trabajo de código abierto representativo para participar en pruebas internas.
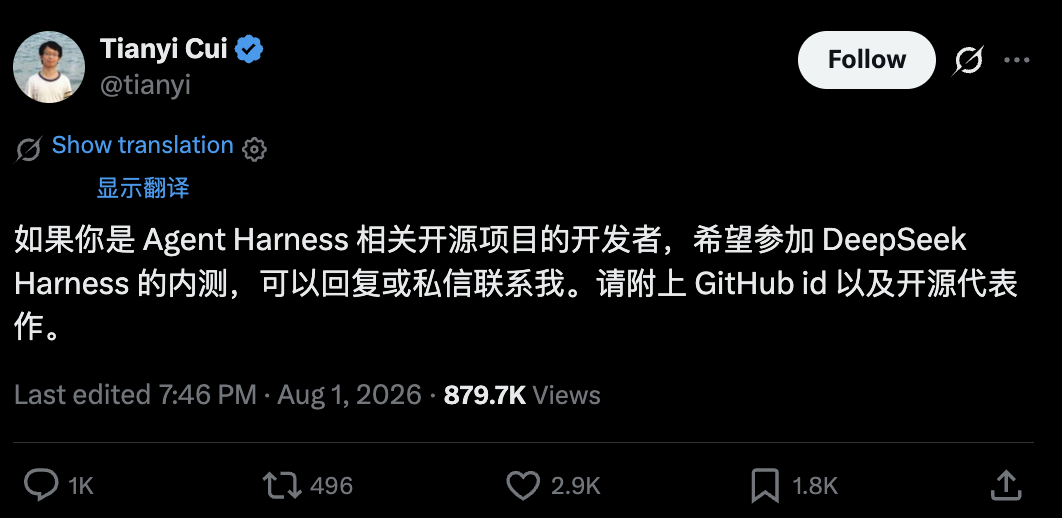
El registro de cambios del 31 de julio de DeepSeek también dice que el modo mínimo de DeepSeek Harness utilizado para la evaluación de benchmarks "se lanzará pronto".
Al momento de la verificación, no pude localizar:
La evidencia respalda esta conclusión más acotada:
DeepSeek está probando un agent harness y tiene la intención de lanzar al menos parte del marco, pero el nombre final del producto, el alcance público y el momento del lanzamiento siguen sin confirmarse.
El modelo, la API y los pesos abiertos están disponibles ahora.
El harness sigue siendo un componente futuro del ecosistema.
Un harness de primera parte podría ayudar a DeepSeek a controlar toda la pila del agente de codificación.
Podría proporcionar:
DeepSeek ya documenta integraciones con harnesses externos y agentes de codificación.
Una herramienta de primera parte podría convertir optimizaciones específicas de benchmarks en un producto que los desarrolladores ordinarios puedan usar.
También podría revelar cuánto del salto en benchmarks de V4 Flash 0731 proviene del checkpoint y cuánto del runtime del agente.
Varios desarrollos determinarán si el momento V4 Flash se convierte en un cambio duradero del ecosistema.
DeepSeek dice que el lanzamiento oficial de V4 Pro seguirá a la actualización de Flash.
La brecha de rendimiento y precio entre Pro y Flash afectará las decisiones de enrutamiento.
Un lanzamiento público mejoraría la reproducibilidad de los benchmarks y daría a los desarrolladores un framework de agentes nativo del modelo.
El precio directo ya es bajo, pero las promociones de terceros podrían no mantenerse.
La inferencia barata atrae tráfico muy alto.
La latencia, los límites de velocidad y la fiabilidad importarán a medida que el uso escale.
vLLM, SGLang, los proveedores de hardware y los proyectos de cuantización determinarán qué tan accesible se vuelve el autoalojamiento.
Más evaluaciones públicas deberían probar:
DeepSeek V4 Flash 0731 es el lanzamiento oficial del 31 de julio de V4 Flash, actualmente servido a través de la API deepseek-v4-flash en beta pública. DeepSeek dice que mantiene la arquitectura base y el tamaño del modelo Preview mientras mejora sustancialmente las capacidades de agente mediante nuevo post-entrenamiento.
La API oficial de DeepSeek lista $0.14 por millón de tokens de entrada sin caché, $0.0028 por millón de tokens de entrada con caché y $0.28 por millón de tokens de salida. Las plataformas de terceros pueden ofrecer precios diferentes, cuotas gratuitas o descuentos temporales.
El artículo fuente cita un ejemplo comunitario con ese costo de modelo reportado. El ejemplo no está acompañado de prompts completos, registros de tokens, datos de caché, reintentos, costos de herramientas o registros de trabajo humano, por lo que debe tratarse como una anécdota más que como un presupuesto garantizado.
DeepSeek reporta 82.7 en Terminal Bench 2.1, 76.7 en CyberGym, 54.4 en DeepSWE, 70.3 en Toolathlon-Verified y 54.2 en NL2Repo. Las evaluaciones públicas de agentes de código usaron el modo mínimo no lanzado de DeepSeek Harness con máximo esfuerzo de razonamiento.
Los pesos del modelo y el repositorio se lanzan bajo la Licencia MIT, por lo que "pesos abiertos" y uso ampliamente permisivo son descripciones precisas. Ejecutar el checkpoint completo aún requiere infraestructura sustancial de múltiples GPU.
Sí, DeepSeek publica pesos e instrucciones de servicio para vLLM y SGLang. Los ejemplos oficiales a escala completa usan hardware avanzado de múltiples GPU, por lo que una laptop normal no es el entorno objetivo para el modelo completo.
La API oficial y la tarjeta del modelo especifican una ventana de contexto de 1 millón de tokens. La API también lista un
longitud máxima de salida de 384K tokens, pero usar el contexto o la salida máximos puede aumentar significativamente la latencia y el uso de recursos.
DeepSeek ha hecho referencia pública a un modo mínimo de Harness y ha reclutado desarrolladores de harness de código abierto para pruebas internas. Durante la verificación no se localizó un repositorio público completo, una especificación final del producto ni una fecha de lanzamiento confirmada.
reasoning_content entre llamadas de herramientas.DeepSeek V4 Flash 0731 mantiene la base del modelo Preview
La arquitectura y el tamaño son similares, pero utiliza un nuevo post-entrenamiento que produce un gran salto en el rendimiento de agentes de codificación. DeepSeek reporta 82.7 en Terminal Bench 2.1, 76.7 en CyberGym y 54.4 en DeepSWE, aunque los resultados públicos más sólidos de agentes de código dependen de una configuración no publicada de DeepSeek Harness.
El precio oficial de la API es inusualmente bajo: $0.14 por millón de tokens de entrada no almacenados en caché, $0.0028 por millón de tokens de entrada en caché y $0.28 por millón de tokens de salida. Las cuotas gratuitas y descuentos de terceros pueden hacer que el acceso sea aún más barato, pero esas promociones son temporales y no deben confundirse con el precio de lista permanente.
El lanzamiento de pesos abiertos bajo licencia MIT, el contexto de 1 millón de tokens, las APIs compatibles con Responses y Anthropic, y el soporte en vLLM y SGLang hacen que el modelo sea accesible tanto en rutas alojadas como autogestionadas. La implementación local completa sigue siendo un proyecto serio de infraestructura multi-GPU.
Los prototipos virales de siete y cincuenta centavos son ejemplos plausibles de lo bajo que puede llegar a ser el costo marginal del modelo, pero no son estudios completos del costo del producto. Los bucles de agentes, la longitud de salida, las fallas de caché, las herramientas, las pruebas y el trabajo humano siguen siendo importantes.
DeepSeek V4 Flash 0731 es importante no porque cada aplicación ahora cueste unos centavos, sino porque la codificación agéntica capaz se ha vuelto lo suficientemente barata como para que muchos más desarrolladores experimenten a una escala significativa.
Empieza con una sola frase y obtén un sitio completo en minutos.



