La zanja de CUDA de NVIDIA ha sido declarada muerta tantas veces que la frase se ha convertido casi en un ritual de la industria. Aparece un...
El foso de CUDA de NVIDIA ha sido declarado muerto tantas veces que ya casi se ha convertido en un ritual de la industria.
Aparece un nuevo acelerador. Un compilador entra en fase de pruebas públicas. Un proveedor de nube promociona su propio chip de IA. Una abstracción de programación promete núcleos portables. Alguien declara que los desarrolladores ya no necesitan escribir CUDA a mano.
Sin embargo, CUDA sigue ocupando una posición central en la próxima generación de infraestructura de IA.
El desafío más reciente es más interesante porque proviene de la propia IA.
Infinity, una startup de infraestructura de IA fundada por el ex investigador de Google Brain Jeremy Nixon, afirma que su agente Ignition migró una parte importante de la pila de software de inferencia al desconocido acelerador d-Matrix Corsair a una velocidad muy superior a la de los procesos de ingeniería tradicionales.
El resultado más llamativo: en aproximadamente 10 horas, Ignition implementó multiplicación de matrices con paralelismo tensorial en los 32 núcleos de cómputo y alcanzó el 92% del límite de cómputo medido en el chip.
Es un resultado significativo. Pero no equivale a reconstruir CUDA en 10 horas.
El propio estudio de caso de Infinity señala que el recorrido completo de inferencia de Qwen3 de extremo a extremo tomó aproximadamente 10 días, con cada operación necesaria reescrita para el nuevo hardware. Y CUDA no es una implementación de multiplicación de matrices ni un runtime de modelos. Es una plataforma madura que incluye compiladores, runtimes, bibliotecas, herramientas de perfilado y depuración, sistemas de comunicación, integración con frameworks, documentación y casi dos décadas de experiencia en producción.
La mejor pregunta no es si la IA ha replicado CUDA de la noche a la mañana.
Es si los agentes de codificación pueden reducir drásticamente el tiempo necesario para que un nuevo chip de IA resulte útil.
La respuesta es cada vez más "sí".
NVIDIA es más conocida por su hardware: H100, Blackwell, Rubin y los grandes sistemas construidos a su alrededor.
Su ventaja más duradera es el software construido alrededor del hardware.
CUDA significa Arquitectura de Dispositivos de Cómputo Unificado. NVIDIA lo describe como una plataforma de cómputo acelerado, no solo un lenguaje de programación.
La plataforma CUDA incluye:
En el nivel más bajo, CUDA permite a los ingenieros escribir núcleos que se ejecutan directamente en las GPU de NVIDIA.
Por encima se encuentran bibliotecas como cuBLAS, cuDNN, cuFFT, NCCL, TensorRT y TensorRT-LLM. Sobre las bibliotecas están PyTorch, TensorFlow, JAX, servidores de inferencia, código de investigación y sistemas internos de las empresas.
Una vista simplificada es la siguiente:
Aplicaciones y frameworks de IA
↓
Bibliotecas optimizadas y sistemas distribuidos
↓
Compiladores, runtimes, perfiladores, depuradores y núcleos
↓
GPU de NVIDIA y tecnologías de interconexión
Las empresas no se quedan en el ecosistema NVIDIA solo por conocer la sintaxis de CUDA, sino porque los modelos, las pruebas, los sistemas de despliegue, las expectativas de rendimiento, los flujos de depuración y los equipos de producción ya dependen de toda la pila tecnológica.
Cambiar de hardware puede implicar mucho más que traducir código fuente; puede requerir reconstruir la confianza.
El estudio de caso oficial de Infinity es más riguroso que los titulares virales.
La empresa colaboró con d-Matrix, una startup centrada en hardware de inferencia para IA generativa. Su acelerador Corsair utiliza una arquitectura y un conjunto de instrucciones diferentes a los de las GPU de NVIDIA. Infinity afirma que el chip apenas tiene historial de software público que los modelos de programación generales puedan replicar directamente desde los datos de entrenamiento.
Ignition recibió la información del hardware y comenzó a generar el software de bajo nivel necesario para ejecutar cargas de trabajo de IA.
Según Infinity, en aproximadamente 10 horas el sistema logró:
Infinity define "velocidad de la luz" como la proporción del pico de cómputo alcanzable del chip que logran los núcleos generados. El límite empírico publicado en el estudio de caso es en sí mismo aproximadamente el 90% del pico teórico.
Es un resultado excelente para un arranque rápido de núcleos, pero no es una plataforma completa equivalente a CUDA.
La multiplicación de matrices es el núcleo de la inferencia de Transformers, pero es solo una categoría de operaciones.
Un modelo completo también requiere mecanismos de atención, normalización, funciones de activación, enrutamiento, cuantización, gestión de caché KV, muestreo, movimiento de tensores, gestión de estados y trabajo adicional de servidores de modelos.
Infinity afirma que en aproximadamente 10 días Qwen3 ya se ejecutaba de extremo a extremo en Corsair. Su anuncio de financiación posterior señala que en ese período tres modelos de vanguardia se ejecutaban de extremo a extremo, con los núcleos escritos desde cero.
Esa línea de tiempo más larga sigue siendo impresionante.
Llevar un acelerador desconocido desde operaciones básicas hasta un runtime de modelos funcional, reduciendo el tiempo de meses a días, podría cambiar radicalmente la economía de lanzar nuevo hardware.
| Afirmación | Interpretación más precisa |
|---|---|
| "La IA reconstruyó CUDA en 10 horas" | Exageración |
| La multiplicación de matrices funcionó en 10 horas | Informe de Infinity |
| Rendimiento del 92% del límite empírico | Informe de Infinity |
| Qwen3 se ejecuta de extremo a extremo en unos 10 días | Informe de Infinity |
| Infinity está construyendo una biblioteca de inferencia general | Confirmado por Infinity |
| Todo el ecosistema CUDA ha sido replicado | No |
Infinity
denomina a Ignition un agente de investigación de IA.
Su propósito es generar y mejorar el software de bajo nivel que transforma las operaciones de los modelos en trabajo eficiente en un chip específico.
El ciclo es similar a un proceso automatizado de ingeniería de rendimiento:
Generar código
→ Compilar
→ Ejecutar en hardware
→ Probar corrección
→ Medir rendimiento
→ Diagnosticar cuellos de botella
→ Modificar la implementación
→ Repetir
Los ingenieros humanos siguen proporcionando objetivos, información del hardware, restricciones, criterios de aceptación y dirección de alto nivel. Ignition ejecuta gran parte del trabajo repetitivo de búsqueda y optimización.
Este tipo de tareas es ideal para agentes porque el entorno produce retroalimentación excepcionalmente clara.
Los kernels generados pueden evaluarse para problemas específicos:
El hardware y las pruebas proporcionan hechos objetivos.
Muchas tareas de software tienen criterios de aceptación ambiguos. La optimización de kernels, aunque difícil, tiene partes cuantificables.
Una implementación válida debe cumplir dos criterios independientes.
El kernel debe producir resultados dentro de tolerancias numéricas aceptables.
El kernel debe utilizar el hardware objetivo de manera suficientemente eficiente para justificar la sustitución de la implementación existente.
El agente puede generar cientos de candidatos, descartar los incorrectos, evaluar el rendimiento de los supervivientes y optimizar continuamente la ruta más fuerte.
El mismo patrón aparece en los agentes centrados en CUDA de NVIDIA, en PTX Kernel Factory de INT21, en el trabajo TileKernels de DeepSeek y en sistemas de investigación que generan kernels de Triton o TileLang.
El cambio reciente es que los modelos base ahora pueden participar en un ciclo más completo, no solo completar unas líneas de código sintáctico.
La historia tecnológica de Infinity ha atraído a inversores.
La empresa anunció en julio de 2026 el cierre de una ronda semilla de 15 millones de dólares, con una valoración post-money reportada de 100 millones de dólares. Touring Capital y Principal Venture Partners participaron en la inversión, junto con ejecutivos de la industria de chips e investigadores vinculados a los principales laboratorios de IA.
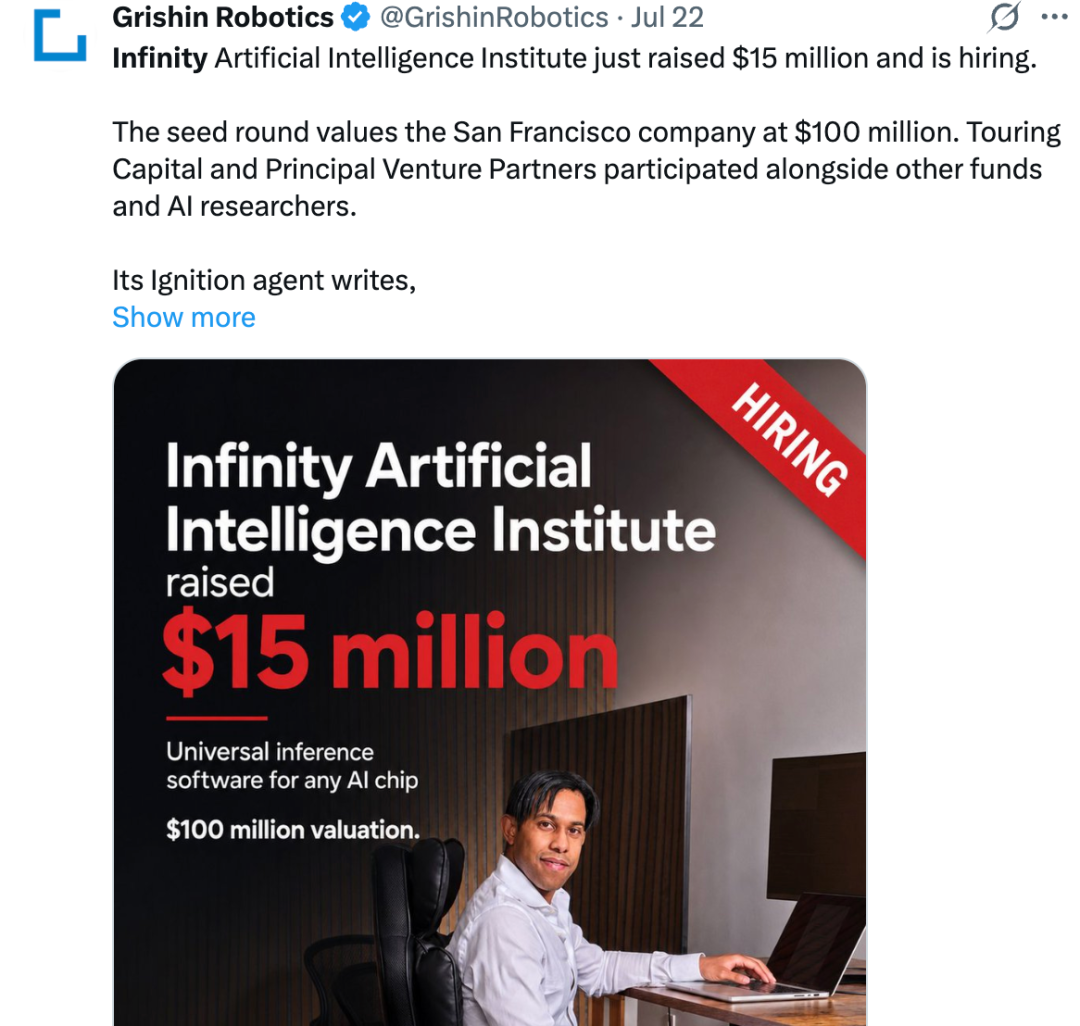
Infinity está construyendo una capa de software de inferencia consciente del modelo para proveedores de hardware y proveedores de servicios de inferencia. Su flujo de trabajo declarado es esencialmente:
Especificaciones del hardware
→ Software de inferencia de nivel de producción generado
También se ha informado de que Infinity ha generado un
motor de inferencia de NVIDIA desde cero, que en Qwen3-8B supera a una implementación de vLLM con configuración equivalente en hasta un 34,3% en rendimiento.
El resultado fue reportado por la propia empresa y depende del hardware, la configuración de procesamiento por lotes, la configuración del modelo y el método de medición. Aun así, esto sugiere que la ambición de Infinity va mucho más allá del arranque básico de chips.
El artículo original también menciona el repositorio TileKernels de DeepSeek.
TileKernels es una biblioteca de kernels de GPU optimizados escrita con TileLang, un lenguaje de dominio específico basado en Python para el desarrollo de kernels de alto rendimiento.
El repositorio incluye las siguientes operaciones:
DeepSeek afirma que muchos kernels están cerca de los límites del hardware en intensidad computacional o ancho de banda de memoria, y algunos ya se utilizan internamente.
TileLang reduce la cantidad de código CUDA C++ de bajo nivel que los ingenieros deben escribir manualmente.
En su forma actual, no indica que DeepSeek haya eliminado su dependencia del stack tecnológico de NVIDIA.
Los requisitos actuales oficiales de TileKernels incluyen:
GPU NVIDIA SM90 o SM100
CUDA Toolkit 13.1 o superior
PyTorch 2.10 o superior
TileLang 0.1.9 o superior
La biblioteca actual está diseñada para las arquitecturas más recientes de NVIDIA. Reduce la dependencia del código fuente CUDA escrito a mano, pero no la dependencia del hardware NVIDIA o del toolkit CUDA.
TileLang tiene ambiciones más amplias por sí mismo.
El proyecto describe un modelo de programación de mosaicos (tiled) con sintaxis de estilo Python para kernels de GPU, CPU y aceleradores, basado en la infraestructura del compilador TVM.
Su objetivo es separar el flujo de datos que el ingeniero desea de la programación de bajo nivel necesaria para una ejecución eficiente.
TileLang ha estado añadiendo soporte para múltiples lenguajes back-end y rutas de hardware que involucran CUDA, ROCm y Metal.
Esta portabilidad puede reducir los costos de cambio entre proveedores, siempre que los resultados generados sean correctos, estables, depurables y competitivos en comparación con las bibliotecas de los proveedores.
Un kernel que se ejecuta en todas partes pero con bajo rendimiento no reemplaza la ruta CUDA en producción.
Un artículo de investigación de julio de 2026 examinó la brecha entre la corrección del kernel y la calidad de reemplazo en Triton y TileLang.
Los autores encontraron que los kernels pueden pasar pruebas de corrección numérica pero rendir muy por debajo de la línea base optimizada. Se informó que una implementación de LayerNorm en TileLang, a pesar de pasar las verificaciones de corrección, se ejecutaba más de 300 veces más lenta que la línea base de PyTorch.
El artículo no está en contra de TileLang, sino que aboga por evaluar los kernels generados en dos dimensiones:
Corrección
+
Eficiencia de hardware
La generación de código se está volviendo cada vez más rápida. Pero demostrar que el código generado es suficiente para reemplazar software de producción maduro sigue siendo difícil.
El desafío a CUDA es más creíble en el ámbito de la inferencia que en el entrenamiento de modelos de frontera.
Las ejecuciones de entrenamiento a gran escala pueden involucrar miles o decenas de miles de
aceleradores trabajando juntos durante semanas o meses.
Las plataformas de entrenamiento deben manejar comunicación distribuida a través de grandes cantidades de dispositivos, puntos de control, recuperación de fallos, gestión de memoria, paralelismo, reproducibilidad y depuración.
Una falla de hardware o software puede desperdiciar enormes cantidades de cómputo. Por lo tanto, las organizaciones tienden a ser muy cautelosas al migrar cargas de entrenamiento importantes desde sistemas maduros.
CUDA, las bibliotecas CUDA-X, NCCL, el soporte de PyTorch y la capacidad de red integrada de NVIDIA le dan a la empresa una posición fuerte en este ámbito.
La inferencia es la fase de servir modelos después de que el entrenamiento ha finalizado.
Las métricas de negocio relevantes suelen ser más cercanas a:
Calidad de salida aceptable
÷
Costo total de servicio
La inferencia puede distribuirse en un solo acelerador, clústeres pequeños, flotas a gran escala y hardware especializado.
Los chips nuevos no necesitan reemplazar a NVIDIA en todos los escenarios. Solo necesitan demostrar una ventaja en costo, velocidad, consumo de energía, rendimiento o latencia más predecible para algún modelo o carga de trabajo.
Ese objetivo más acotado ofrece un punto de entrada realista para el hardware especializado.
d-Matrix se fundó en 2019 y se centra en la aceleración de inferencia. Su plataforma Corsair utiliza amplias cantidades de SRAM en el chip y está diseñada para reducir el costo y el consumo energético de ejecutar modelos generativos.
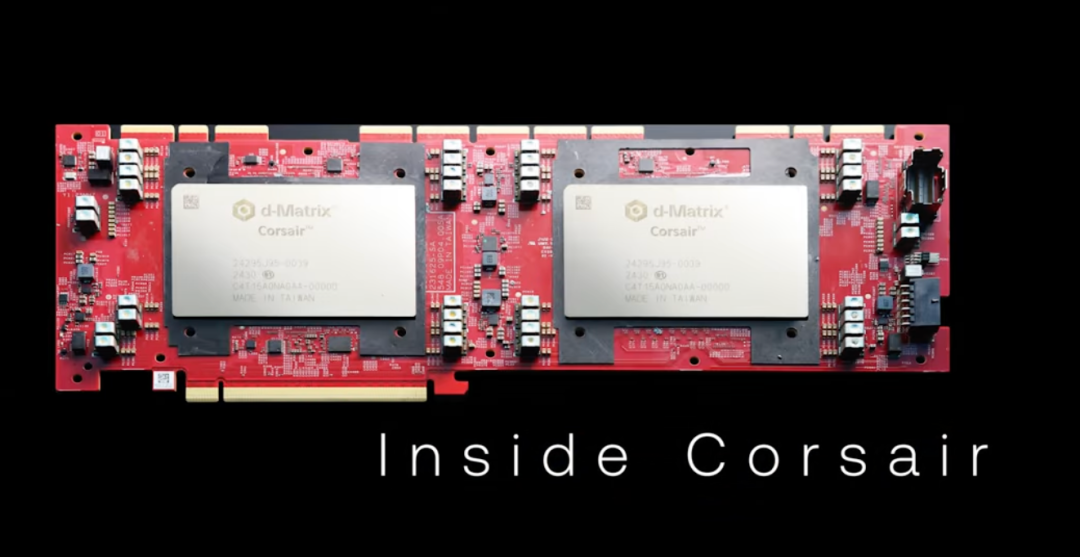
El trabajo de Infinity aborda uno de los problemas clásicos que enfrentan los nuevos aceleradores.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Un chip puede tener hardware prometedor, pero hasta que los kernels, la ejecución de modelos, el manejo de memoria, la cuantización, la lógica de servicio y los esquemas de integración estén listos, los clientes no pueden usarlo de manera eficiente.
Si los agentes pueden comprimir ese proceso de arranque de meses a días, las startups de hardware podrían ofrecer soporte cerca del lanzamiento de los modelos y demostrar las capacidades del hardware mucho antes.
Esto erosiona parte de la ventaja de software de NVIDIA, pero no la elimina por completo.
El mercado de inferencia incluye varios retadores:
| Fabricante o plataforma | Posicionamiento general |
|---|---|
| Rebellions | Aceleradores y sistemas de inferencia de IA dedicados |
| Cerebras | Sistemas a escala de oblea para entrenamiento e inferencia |
| AWS Inferentia | Chip de inferencia diseñado por Amazon, que utiliza el SDK Neuron |
| Google TPU | Aceleradores de Google compatibles con XLA y marcos principales |
| AMD Instinct | GPU para centros de datos que utilizan la plataforma ROCm |
| d-Matrix | Aceleración de inferencia de IA generativa centrada en SRAM |
| NVIDIA | GPU y pila de computación acelerada CUDA |
La presión proviene de capas de software que permiten a los usuarios implementar modelos sin reescribir manualmente cada operación, incluyendo AWS Neuron, Google XLA, AMD ROCm, Modular MAX y Mojo, TileLang, Triton y sistemas de generación de kernels con IA.
Cuanto más automatizan estas capas de software, menos intervención manual necesitan los desarrolladores de aplicaciones.
Contenido directamente relacionado con CUDA.
El bloqueo de CUDA es más fuerte cuando las aplicaciones y sus kernels optimizados están estrechamente vinculados al hardware de NVIDIA.
Una capa de inferencia portátil está diseñada para lograr el siguiente flujo de trabajo:
Modelo
→ Capa de ejecución portátil
→ Generar o seleccionar kernels de hardware
→ Acelerador objetivo
El mundo real es más complejo porque diferentes chips tienen diferentes jerarquías de memoria, formatos numéricos, interconexiones, comportamientos de programación y operaciones compatibles.
El alto rendimiento generalmente aún requiere trabajo específico para el hardware.
El punto central de Infinity es que los agentes pueden generar automáticamente ese trabajo especializado.
Los resultados de 10 horas no pueden replicar los activos que dificultan reemplazar CUDA.
Estos activos incluyen:
Muchas organizaciones usan bibliotecas de proveedores en lugar de escribir kernels directamente. cuBLAS, cuDNN, TensorRT, NCCL y otras bibliotecas contienen años de experiencia en optimización.
NVIDIA Nsight y herramientas relacionadas ayudan a los ingenieros a comprender la corrección, el comportamiento de memoria, las líneas de tiempo, la comunicación y el rendimiento.
Las nuevas características de los modelos suelen integrarse y optimizarse tempranamente para el hardware de NVIDIA.
Los equipos de producción comprenden cómo se comportan los sistemas NVIDIA bajo carga.
El ecosistema incluye ejemplos, cursos, presentaciones en conferencias, respuestas de la comunidad y recursos de expertos.
Las empresas tienen millones de líneas de código, pruebas, procesos de adquisición y habilidades de empleados vinculados a esta plataforma.
La IA puede reducir los costos de traducción, pero no elimina automáticamente los costos de cambio a nivel organizacional.
Bing Xu, fundador de INT21 y ex fundador de HippoML, adquirida por NVIDIA, cree que la validación es el principal cuello de botella.
Los agentes pueden generar código rápidamente. Pero los equipos de producción aún necesitan evidencia de que:
NVIDIA ya posee una gran cantidad de pruebas de conformidad, pruebas de rendimiento, implementaciones de referencia, simuladores, perfiladores de rendimiento, diagnósticos de compiladores, cargas de trabajo de producción y datos históricos de errores.
Estos activos hacen que los agentes sean más útiles.
Por lo tanto, la IA podría trasladar el foso de la generación de código a la calidad del entorno de validación.
Las tecnologías que desafían a CUDA también aplican a NVIDIA.
Business Insider citó a Ankit Patel, vicepresidente del ecosistema de desarrolladores de NVIDIA, quien dijo que la compañía está utilizando agentes de codificación con IA para desarrollar CUDA más rápido y realizar validaciones a mayor escala.
NVIDIA ya ha
También ha propuesto una estrategia de CUDA inteligente, que combina el conocimiento existente de CUDA, experiencia en optimización, perfilado de rendimiento en la nube, herramientas Nsight, puntos de referencia y servicios basados en MCP.
NVIDIA mantiene ComputeEval, un punto de referencia abierto para código CUDA y bibliotecas de cálculo básicas CUDA generado por IA.
Este punto de referencia cubre tareas que involucran núcleos tensor, memoria compartida, primitivas a nivel de warp, gráficos CUDA, flujos y eventos.
Por lo tanto, la competencia es relativa:
Velocidad a la que el software retador alcanza
contra
Velocidad de mejora del software de NVIDIA
Chris Lattner, cofundador y CEO de Modular, ofrece una visión más matizada.
Él considera que los agentes de codificación representan una mejora incremental, no una destrucción inmediata de la ventaja de CUDA.
El artículo fuente resume tres razones.
La optimización en entornos de producción determina si un chip es económicamente viable. Los últimos puntos porcentuales de rendimiento pueden requerir una cantidad considerable de trabajo experto.
El código de aplicaciones es abundante en línea.
La ingeniería de núcleos y compiladores de alto nivel es un campo reducido, y gran parte del trabajo más sólido sigue siendo privado.
La viabilidad técnica no elimina los costos de certificación, los riesgos operativos, la reconversión del personal, los contratos, los requisitos de fiabilidad ni los costos de oportunidad.
Estos puntos no implican que la ingeniería de núcleos agéntica sea irrelevante. Explican por qué una demostración potente no se convierte de inmediato en una sustitución del mercado.
La interpretación más contundente no es "CUDA ha muerto".
Más bien, una de las capas de la ventaja histórica de CUDA se está volviendo más fácil de replicar.
Los agentes, los DSL y los compiladores automatizados pueden reducir el tiempo necesario para construir núcleos, tiempos de ejecución y soporte de modelos para chips nuevos.
La capa más expuesta es la adaptación rápida para inferencia temprana.
La capa más protegida sigue siendo el entrenamiento a gran escala, las bibliotecas de generación maduras, la verificación, la depuración, la orquestación de clústeres, la integración con marcos de trabajo, los flujos de trabajo de clientes existentes y la optimización continua.
La pregunta estratégica podría pasar de:
¿Quién posee la mayor cantidad de código de núcleos escritos a mano?
a:
¿Quién posee el mejor ciclo cerrado de generación, medición,
verificación y optimización automatizados?
NVIDIA está bien posicionada porque ya posee el hardware, las herramientas, las bibliotecas, las cargas de trabajo y los datos de retroalimentación. Los retadores se benefician de que los agentes reducen las barreras de entrada.
Ambas cosas pueden ser ciertas al mismo tiempo.
El resultado de Infinity cambia las expectativas de las empresas emergentes de hardware.
Los nuevos aceleradores ya no deben asumir que cada núcleo útil será escrito manualmente por un pequeño equipo de expertos.
Un agente puede
posiblemente:
Esto puede acortar el tiempo desde la primera fabricación del chip hasta lograr una inferencia de modelo utilizable.
Este acortamiento permite a los proveedores de chips mostrar su hardware antes, soportar nuevos modelos más rápido, aliviar la presión de contratación de software, probar más ideas y competir en mercados de inferencia más nicho.
Este resultado no borra a CUDA, pero hace que el primer paso para competir con CUDA sea menos intimidante.
Los resultados publicados por Infinity provienen de la empresa y sus socios de hardware. Los puntos de referencia externos proporcionarán evidencia más sólida.
Una capa de inferencia general debe admitir múltiples arquitecturas, modalidades, formatos de cuantización y modos de servicio.
Una demostración de extremo a extremo es diferente de un software que funciona durante meses bajo tráfico de clientes.
La cuestión clave es cómo los sistemas de agentes demuestran corrección y rendimiento en un espacio de pruebas enorme.
Si una implementación logra excelentes resultados en NVIDIA, AMD, Apple y otros aceleradores, TileLang y otros lenguajes específicos de dominio serán estratégicamente más importantes.
NVIDIA está construyendo activamente agentes, puntos de referencia, inteligencia de compiladores y nuevas abstracciones de CUDA. El gigante existente no se está quedando quieto.
No. Infinity indicó que Ignition generó software de multiplicación de matrices tensorial paralela para el d-Matrix Corsair en 10 horas, alcanzando el 92% del límite computacional empírico del chip. La inferencia de extremo a extremo de Qwen3 tomó unos 10 días; el proyecto no replicó el ecosistema completo de CUDA.
Ignition es el agente de investigación e ingeniería de IA de Infinity que se utiliza para generar, probar, depurar y optimizar software de inferencia de bajo nivel. Aprovecha la retroalimentación del hardware real para mejorar iterativamente los núcleos y el tiempo de ejecución de los modelos.
Corsair es la plataforma de inferencia de IA generativa de d-Matrix. Infinity lo utiliza como plataforma objetivo para generar automáticamente operaciones tensoriales paralelas y la pila completa de inferencia de modelos.
No. TileKernels reduce la necesidad de escribir núcleos CUDA de bajo nivel manualmente mediante TileLang, pero sus requisitos actuales incluyen hardware NVIDIA SM90 o SM100 y CUDA Toolkit 13.1 o superior.
La inferencia puede ejecutarse en sistemas más pequeños y generalmente se evalúa según el costo, el consumo de energía, la capacidad de procesamiento o la latencia de un modelo individual. El entrenamiento de vanguardia requiere clústeres más grandes, sistemas de comunicación maduros, capacidad de recuperación ante fallos y estabilidad comprobada.
El foso de CUDA incluye bibliotecas maduras, integración con marcos de trabajo, herramientas de depuración y análisis de rendimiento, sistemas distribuidos, documentación, historial de producción y código de clientes existente. La verificación y la optimización continua pueden
volverse aún más importantes a medida que el costo de generar código disminuye.
Sí. Los estudios muestran que los núcleos pueden pasar pruebas de corrección numérica, pero su rendimiento puede ser muy inferior al de las implementaciones de bibliotecas optimizadas. La evaluación a nivel de producción requiere tanto verificación de corrección como de eficiencia del hardware.
Sí. NVIDIA afirma que está utilizando agentes para acelerar el desarrollo y la verificación de CUDA, y ha demostrado públicamente flujos de trabajo de agentes orientados a CUDA, integración de análisis de rendimiento y el punto de referencia ComputeEval.
inc/research): cubre estudios de caso oficiales sobre d-Matrix, el software de inferencia generativa y el sistema de investigación OMEGA de la empresa.
El agente Ignition de Infinity no recreó NVIDIA CUDA en 10 horas. Generó una multiplicación de matrices paralela por tensores de alto rendimiento para una arquitectura desconocida.
En ese momento, el acelerador de d-Matrix supuestamente alcanzó el 92% del límite de cómputo empírico del chip. Aproximadamente 10 días después, ya se implementó la ruta completa de inferencia de Qwen3.
Este logro sigue teniendo relevancia hoy. Demuestra que los agentes pueden acelerar el inicio temprano del software para nuevos chips de IA, especialmente en inferencia, donde los clientes se preocupan por el costo por respuesta y pueden adoptar hardware especializado para cargas de trabajo más limitadas.
Los TileKernels de DeepSeek y TileLang apuntan en la misma dirección: más trabajo de kernels puede expresarse mediante sistemas de nivel superior y optimizarse automáticamente. La versión actual de TileKernels aún depende de las GPU NVIDIA más recientes y de CUDA, por lo que reduce el trabajo de escritura manual de CUDA, pero no elimina esa plataforma.
El foso de CUDA sigue siendo profundo porque incluye mucho más que código fuente. Las bibliotecas, la validación, el análisis de rendimiento, el soporte de frameworks, el entrenamiento distribuido, el historial de producción y la inversión organizacional existente son difíciles de replicar.
La IA no cruzó todo el foso de CUDA en 10 horas, pero quizás sí redujo el costo de llegar a la primera barrera, desplazando la competencia a largo plazo desde la propiedad del código hacia la generación, validación y optimización automatizadas.
Empieza con una sola frase y obtén un sitio completo en minutos.



