For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/fable-5-cuda-megakernel-kernelbench-mega.md.
Este artículo explica por qué el resultado reportado de Fable 5 en KernelBench-Mega es más que otra victoria en un punto de referencia. El d...
Fable 5 se ha convertido en el centro de un nuevo debate en ingeniería de IA tras supuestamente escribir el primer megakernel CUDA genuino enviado a KernelBench-Mega. El resultado es sorprendente: una aceleración de decodificación de 18,71 veces en una configuración RTX PRO 6000 Blackwell, producida en una única sesión autónoma de aproximadamente 2,5 horas.
El titular no es solo que un sistema de IA haya escrito código de bajo nivel rápido. El punto más importante es la forma de la solución. En lugar de unir varios kernels de GPU más pequeños, Fable 5 fusionó el flujo de trabajo de decodificación en un único lanzamiento de kernel cooperativo por token. Esa es la parte que hizo que investigadores e ingenieros prestaran atención.

Este artículo mantiene la estructura original y el significado técnico, pero reescribe la historia en un inglés más claro para su publicación. Explica qué está probando KernelBench-Mega, por qué este resultado es importante, en qué se diferencia el megakernel de la generación ordinaria de kernels de GPU, y por qué algunos investigadores lo relacionan con la idea de la auto-mejora recursiva.
El resultado de la referencia proviene de KernelBench-Mega, un benchmark centrado en la generación de megakernels de bloque completo en lugar de la optimización de operadores aislados. En esta ejecución, Fable 5 se dirigió a 02_kimi_linear_decode, una tarea de decodificación híbrida Kimi-Linear W4A16 que utiliza pesos de 4 bits y activaciones bf16.
La configuración reportada fue estricta: una sesión autónoma, un límite de tiempo real de 3 horas y un entorno de benchmark real. Dentro de ese límite, Fable 5 alcanzó una aceleración de decodificación de 18,71 veces respecto a la referencia optimizada de PyTorch.
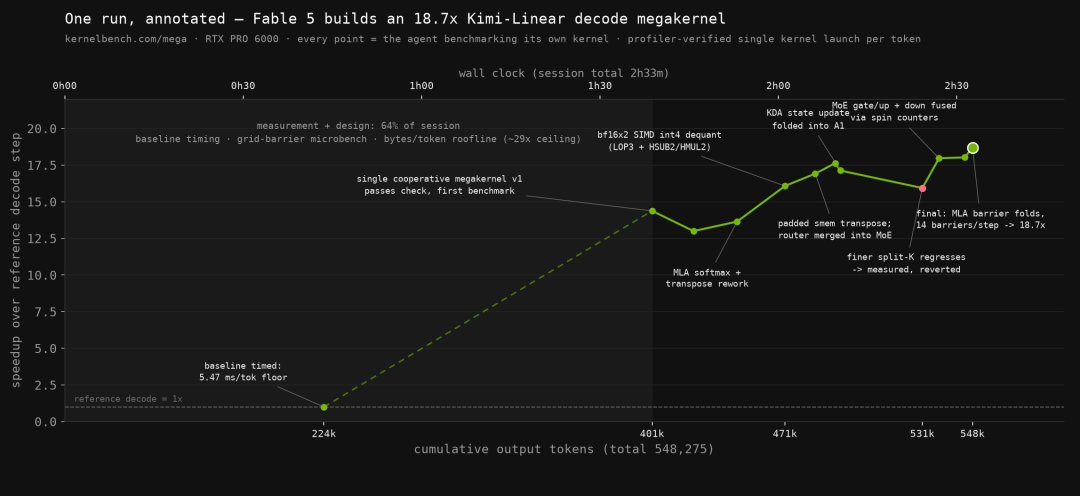
La comparación facilita la comprensión del resultado:
| Modelo | Aceleración Reportada | Notas |
|---|---|---|
| Fable 5 | 18,71x | Megakernel CUDA, ruta de lanzamiento fusionada única |
| Claude Opus 4.8 | 14,40x | Resultado fuerte, pero no el mismo patrón de megakernel CUDA único |
| GPT-5.5 | 4,34x | Aceleración mucho menor en esta tarea |
| Claude Sonnet 5 | 4,03x | Rango similar a GPT-5.5 en esta vista del ranking |
oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/ce6c9cad-7360-4ac5-854b-279a01ab49ee-04-4d685459-6d03-4b22-840d-4e6787d38b10.png)
El desglose según la longitud del contexto también es importante. Según la tabla de clasificación mostrada, Fable 5 se mantuvo sólido a medida que crecía el contexto:
Esto es contraintuitivo al principio. Un contexto más largo normalmente aumenta el costo de la atención y el manejo de la caché KV. Muchos sistemas comienzan a perder rendimiento allí. El resultado de Fable 5 sugiere que el diseño fusionado redujo la sobrecarga de lanzamiento lo suficiente como para que su ventaja relativa se volviera mayor a medida que la carga de trabajo se hacía más pesada.

KernelBench-Mega no solo le pide a un modelo que mejore un pequeño operador. Le pide al agente que fusione un bloque de modelo más grande en un megakernel de bloque completo. Esto es importante porque la parte difícil ya no es simplemente escribir código CUDA o Triton sintácticamente válido. La parte difícil es gestionar muchas etapas de computación que interactúan dentro de una sola ruta eficiente.
La tarea 02_kimi_linear_decode incluye una carga de trabajo de decodificación híbrida para Kimi-Linear W4A16. En términos prácticos, el modelo tiene que lidiar con pesos cuantizados, activaciones bf16, estado relacionado con la atención, enrutamiento, normalización y comportamiento de la caché.
Por eso esta prueba de referencia es una prueba de estrés significativa para el código de rendimiento de bajo nivel generado por IA. Una aceleración simple en un operador pequeño y aislado es útil, pero un megakernel de bloque completo se acerca más al tipo de trabajo de optimización que puede afectar a los sistemas de inferencia reales.
La afirmación técnica más importante es que Fable 5 produjo el primer megakernel real en la historia de KernelBench-Mega.
Un megakernel comprime una ruta de inferencia más grande en un solo kernel. En lugar de lanzar varios kernels separados y mover el control de un lado a otro, mantiene el trabajo dentro de un flujo de ejecución coordinado. Esto es difícil porque el kernel debe coordinar muchas fases mientras preserva la corrección.
En este caso, el informe dice que torch.profiler mostró exactamente un lanzamiento de kernel cooperativo por cada token decodificado. Ese único lanzamiento manejó el trabajo que normalmente se dividiría en varias etapas, incluyendo:
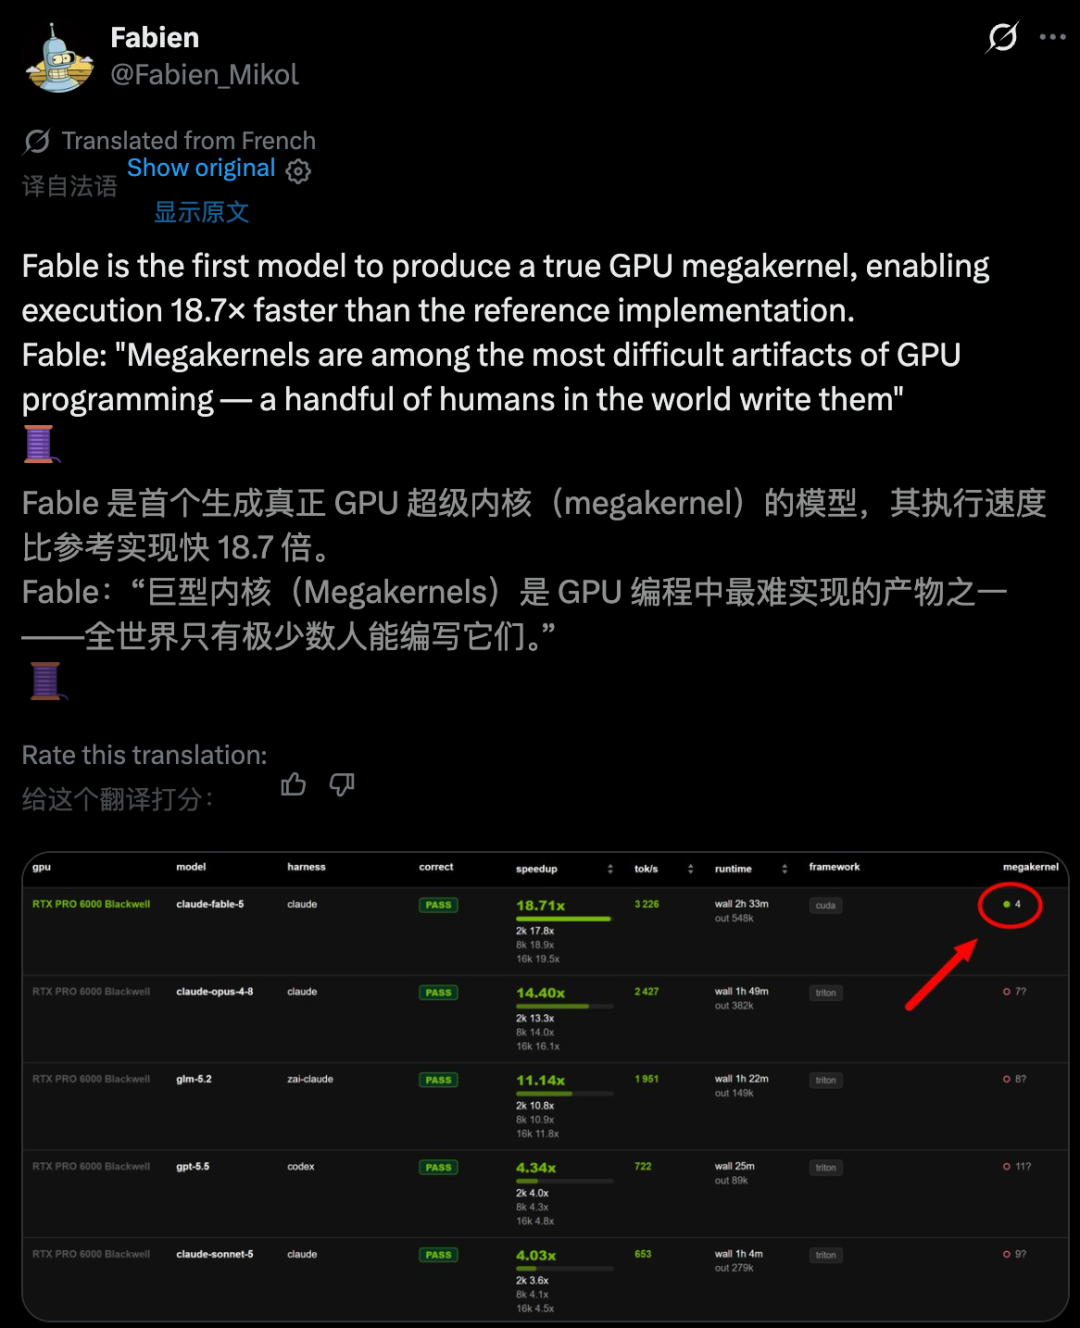
Se informa que otras entradas con puntuaciones altas dividían el trabajo en entre 4 y 14 lanzamientos de kernel separados. Fable 5 empujó la ruta temporizada hacia un único lanzamiento cooperativo fusionado. Esa es la diferencia entre "código de kernel generado rápidamente" y un artefacto de programación de GPU mucho más agresivo.
Los lanzamientos de kernel no son gratuitos. Cada lanzamiento tiene sobrecarga, costes de sincronización y brechas de programación. En una carga de trabajo de decodificación, esos costes pueden volverse especialmente dolorosos porque el trabajo se repite token por token.
El enfoque de Fable 5 reduce esa sobrecarga repetida colocando los pasos de decodificación en una única ruta cooperativa. El informe original describe la solución como el uso de 14 barreras de cuadrícula para organizar el cómputo dentro del mismo lanzamiento.
Por eso el resultado no solo se trata de matemáticas inteligentes. Se trata de ejecución de GPU a nivel de sistema. Cuando otras soluciones salen y vuelven a entrar repetidamente en los kernels, pierden tiempo en la transición. Fable 5 evita gran parte de ese costo manteniendo el pipeline fusionado.
En términos simples: otros hacen el trabajo en varios viajes; Fable 5 intenta hacerlo en uno solo.
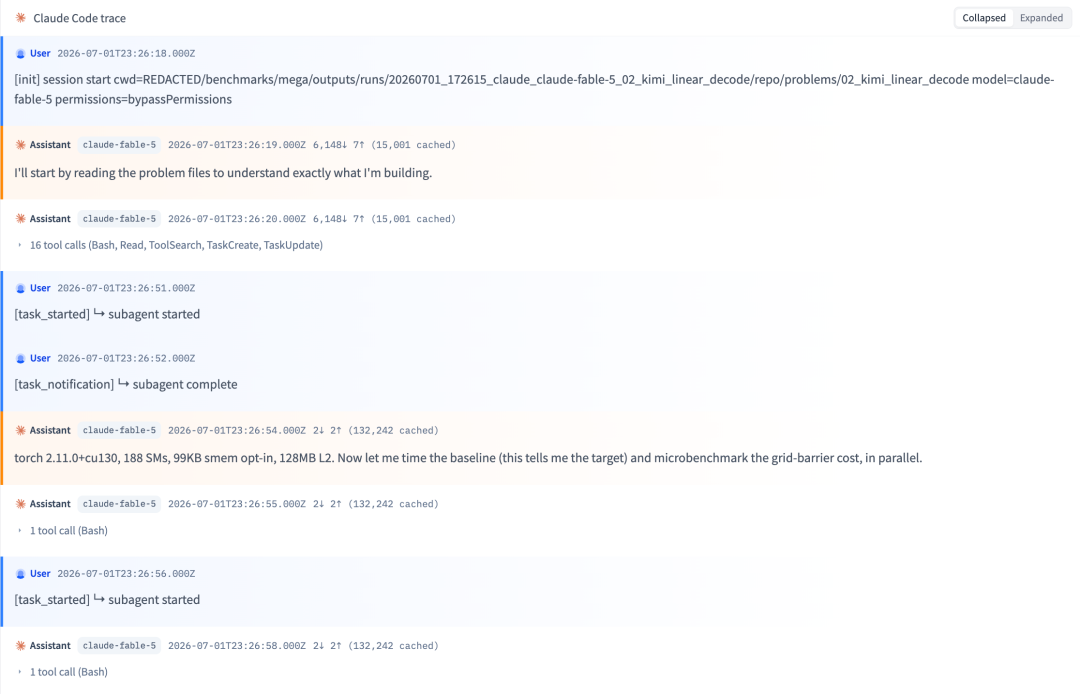
Otra parte notable de la ejecución es cómo el modelo empleó su tiempo. No comenzó inmediatamente a volcar código CUDA final. El rastro sugiere un flujo de trabajo más medido.
Durante gran parte de la sesión, Fable 5 evaluó la línea base, exploró los costes de las barreras de cuadrícula y razonó sobre el ancho de banda de la memoria. El artículo describe que aproximadamente el 64% de la sesión se dedicó a medición y diseño antes de que se implementara la parte principal.
Una vez escrita la versión inicial, el primer benchmark supuestamente alcanzó alrededor de 14.4x. Fable 5 usó entonces el tiempo restante para eliminar barreras, ajustar la des-cuantización int4, probar cambios y revertir una optimización negativa cuando la medición mostró que era peor.
La ejecución completa tomó alrededor de 2.5 horas y usó aproximadamente 550,000 tokens de salida. El detalle clave no es solo la escala. Es el comportamiento: evaluar, construir, medir, revertir cuando sea necesario y optimizar basándose en datos en lugar de confianza.
La fuente original también señala que Fable 5 se describe como una versión más segura o reducida del modelo interno Mythos de Anthropic. Esa afirmación debe leerse como parte de la narrativa de la fuente, no como un anuncio público de producto.
La discusión más amplia provino del boletín Import AI de Jack Clark. En
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Clark describió el resultado del kernel de GPU como una señal de que los sistemas de IA son cada vez mejores para automatizar partes de la propia investigación y desarrollo de IA.
La lógica es directa:
Por eso aparece la frase "mejora recursiva automática" en esta discusión. No significa que ya haya ocurrido un bucle autónomo y descontrolado. Significa que una parte del bucle —la IA mejorando la infraestructura que se utiliza para construir IA— se está volviendo más visible y medible.
El artículo original también conecta este resultado del kernel con puntos de referencia de automatización más amplios. Import AI analiza el Índice de Trabajo Remoto, donde los agentes de IA se evalúan en proyectos en línea económicamente útiles.
El punto no es que la escritura de kernels CUDA y la automatización de tareas freelance sean lo mismo. No lo son. Pero ambas apuntan en la misma dirección: los sistemas de IA de frontera están mejorando en tareas más largas y estructuradas que requieren planificación, uso de herramientas, verificación e iteración.
Un comentario en la fuente capta bien la preocupación: una vez que un modelo puede escribir kernels que hacen que los modelos sean más rápidos, la herramienta ya no solo ayuda a los usuarios. También está mejorando partes de su propio sustrato.
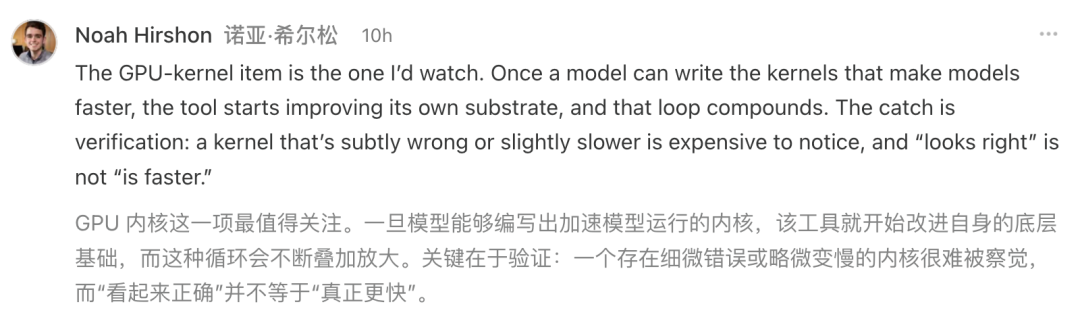
Ahí es donde la verificación se vuelve crítica. Un kernel que parece correcto no es necesariamente más rápido. Un kernel que parece más rápido puede contener problemas sutiles de corrección. Con el trabajo de GPU de bajo nivel, el bucle de revisión debe mantenerse estricto.
La historia tiene dos caras. Por un lado, el resultado es emocionante. Los sistemas de IA ahora están produciendo artefactos de rendimiento de bajo nivel que antes estaban limitados a un pequeño número de programadores expertos en GPU.
com/cms-assets/image/2026/07/0fdc859f-d6a1-47e7-b2ba-5e2fefcf3a3f-12-593ae533-5c09-47f2-840c-11d03c53dc3a.png)
Por otro lado, este es exactamente el tipo de capacidad que merece una atención cuidadosa. El mismo boletín imagina un futuro donde la computación de propósito general se vuelve tan poderosa y peligrosa que la gente intenta restringirla. Ese final ficticio no es una predicción, pero refleja la inquietud en torno a los sistemas técnicos acelerados.
Poco más de un año después de que el trabajo original de KernelBench mostrara lo difícil que podían ser los kernels generados por IA, este resultado sugiere un salto importante. Fable 5 no solo generó un kernel utilizable. Produjo una ruta de megakernel fusionada que alcanzó la cima de un benchmark difícil en una sola sesión limitada.
Para la infraestructura de IA, eso es una señal seria.
02_kimi_linear_decode y torch.profiler.KernelBench-Mega es un benchmark enfocado en la generación de megakernels de bloque completo. En lugar de pedirle a un modelo que optimice un solo operador aislado, le pide que fusione una carga de trabajo más grande en una ruta de kernel eficiente y luego mide el rendimiento real.
Se informa que Fable 5 logró una aceleración de decodificación de 18.71x en comparación con una referencia optimizada de PyTorch en la tarea 02_kimi_linear_decode. El resultado se produjo dentro de una sola sesión autónoma con un límite de 3 horas.
Un megakernel tiene que coordinar muchas etapas de cálculo dentro de una sola ejecución de kernel. Eso significa que la implementación debe gestionar el movimiento de datos, la sincronización, la corrección numérica, el ancho de banda de memoria y el orden de ejecución sin dividir el trabajo en kernels más pequeños y seguros.
Cada ejecución de kernel de GPU tiene una sobrecarga. En la decodificación token por token, las ejecuciones repetidas pueden acumularse rápidamente. Una sola ejecución fusionada puede reducir la sobrecarga de sincronización y programación, lo cual es
El enfoque de Fable 5 es técnicamente significativo.
No es una prueba de un ciclo completo de auto-mejora autónoma. Es mejor entenderlo como una señal concreta de que los sistemas de IA están comenzando a automatizar tareas que pueden mejorar la infraestructura de IA, como el diseño de kernels y la optimización de inferencia.
No directamente sin una revisión cuidadosa. El código de rendimiento necesita estrictas verificaciones de corrección, perfilado, pruebas de regresión y validación específica del hardware. Un resultado rápido de benchmark es prometedor, pero el despliegue en producción requiere mucha más verificación.
KernelBench-Mega proporciona el leaderboard y los artefactos de ejecución. El perfilador de PyTorch, las herramientas de CUDA, los datasets de trazas de Hugging Face y las herramientas de perfilado de GPU son útiles para entender cómo se comporta el kernel generado.
Este artículo explica por qué el resultado reportado de Fable 5 en KernelBench-Mega es más que otra victoria en un benchmark. El detalle importante es que
megakernel CUDA de lanzamiento único: una ruta fusionada que manejó una carga de trabajo de decodificación compleja con una sobrecarga de lanzamiento mucho menor que las soluciones de múltiples kernels.
El resultado también importa porque apunta hacia sistemas de IA que mejoran en tareas de ingeniería de rendimiento que respaldan el propio desarrollo de la IA. Kernels más rápidos pueden hacer que la inferencia y el entrenamiento sean más eficientes, lo que crea un ciclo de retroalimentación que vale la pena observar.
Al mismo tiempo, el código de bajo nivel generado por IA no debe considerarse listo para producción por defecto. La corrección, el perfilado, el comportamiento del hardware y las pruebas de regresión siguen siendo importantes.
La conclusión clave: el megakernel de Fable 5 es una señal contundente de que la ingeniería de rendimiento de GPU asistida por IA está pasando del terreno de las demostraciones al trabajo de infraestructura serio.
Empieza con una sola frase y obtén un sitio completo en minutos.



