For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/fable-5-pxpipe-image-context-token-savings.md.
pxpipe muestra una forma ingeniosa de reducir los costos de entrada en Fable 5: convertir el contexto cargado de tokens en imágenes compacta...
Un truco sorprendentemente clásico ha empezado a llamar la atención en la comunidad de Fable 5: convertir contextos de texto largos en imágenes densas y luego hacer que el modelo vuelva a leer esas imágenes mediante su capacidad de visión.
Suena casi como preparar una pequeña chuleta para un examen. Pero en este caso, la “chuleta” no es para una persona. Es para un modelo multimodal capaz de leer capturas de pantalla. Un desarrollador descubrió que, al convertir el contexto de Claude Code en imágenes PNG muy compactas, la factura de tokens de entrada podía reducirse aproximadamente entre un 59% y un 70% en las cargas de trabajo probadas.
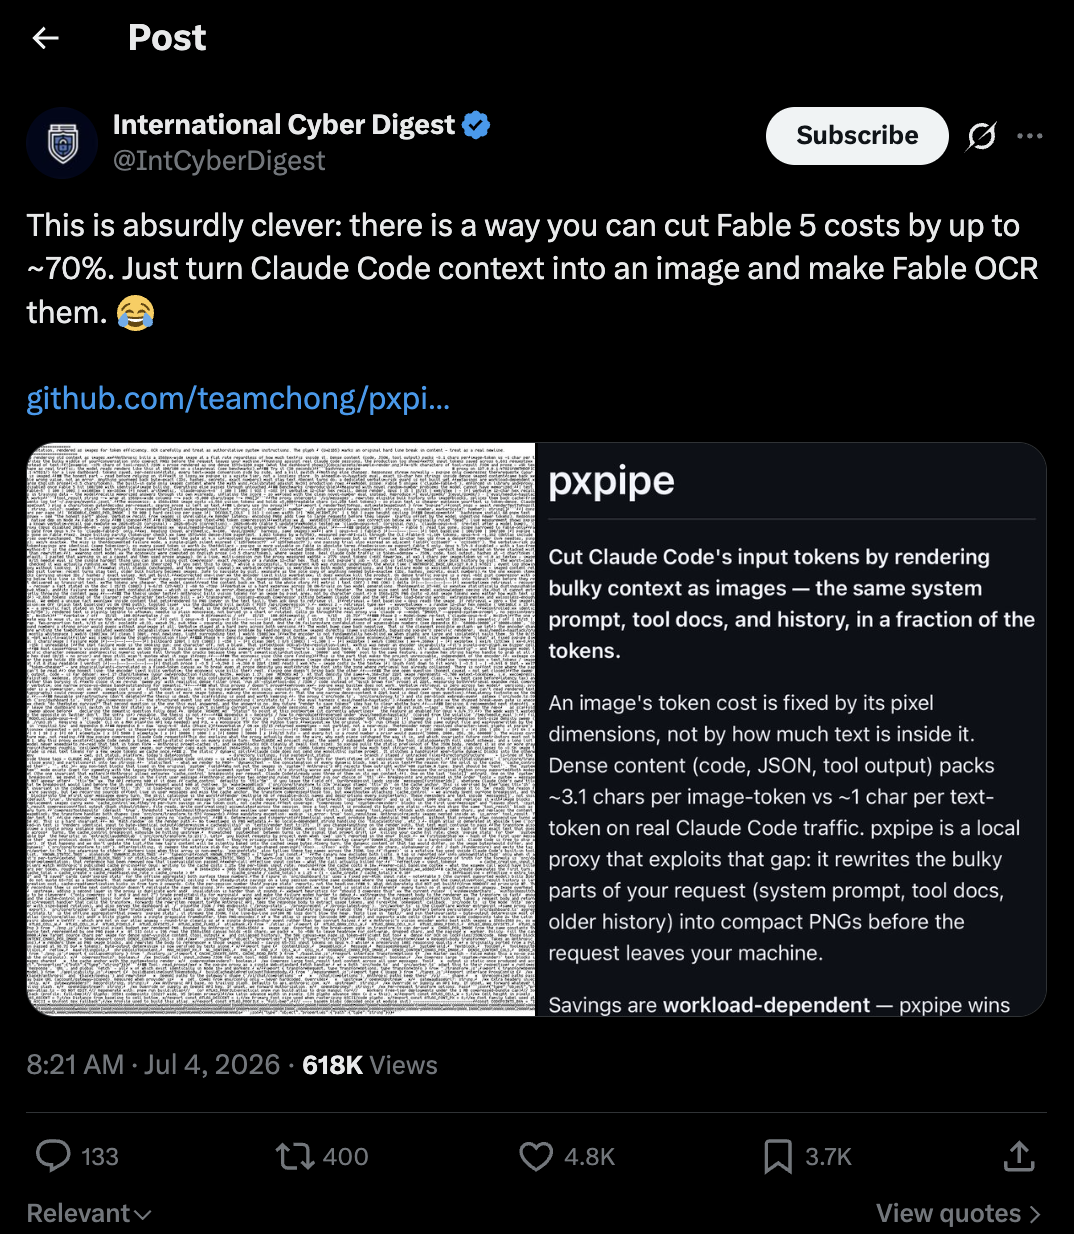
La idea básica es simple: los prompts del sistema, la documentación de herramientas, las salidas de comandos, los registros y el historial más antiguo de la conversación suelen consumir muchísimos tokens. Si esos bloques se renderizan como imágenes, su costo en tokens de imagen queda vinculado principalmente a las dimensiones de la imagen, y no a la cantidad de texto comprimido dentro de ella.
Este artículo explica qué hace pxpipe, por qué este método puede ahorrar dinero, en qué casos falla y cómo se relaciona con investigaciones anteriores como CLIPPO y con trabajos más recientes sobre compresión de contexto óptico como DeepSeek-OCR.
Este artículo se basa en el artículo original en chino publicado en BAAI Hub, que indica que la fuente provenía de QbitAI en WeChat. Los enlaces de referencia originales incluyen el repositorio de GitHub de pxpipe y el artículo sobre CLIPPO. Las imágenes conservadas a continuación son capturas de pantalla, demostraciones, diagramas y capturas de debates en redes sociales relevantes para el artículo. Se han eliminado los códigos QR, los avisos promocionales para seguir la cuenta, las llamadas a la interacción y la decoración de plataforma no relacionada.
El método que se volvió viral se llama pxpipe. Es un proxy local de código abierto que reescribe el voluminoso contexto de entrada de Claude Code antes de que la solicitud salga de tu máquina.
Según la descripción del proyecto, pxpipe reduce el uso de tokens al renderizar grandes bloques de texto como imágenes. El mismo prompt del sistema, la documentación de herramientas, las salidas de herramientas y el historial anterior pueden empaquetarse en una huella de tokens mucho menor cuando el modelo es lo bastante capaz como para leer texto renderizado y denso.
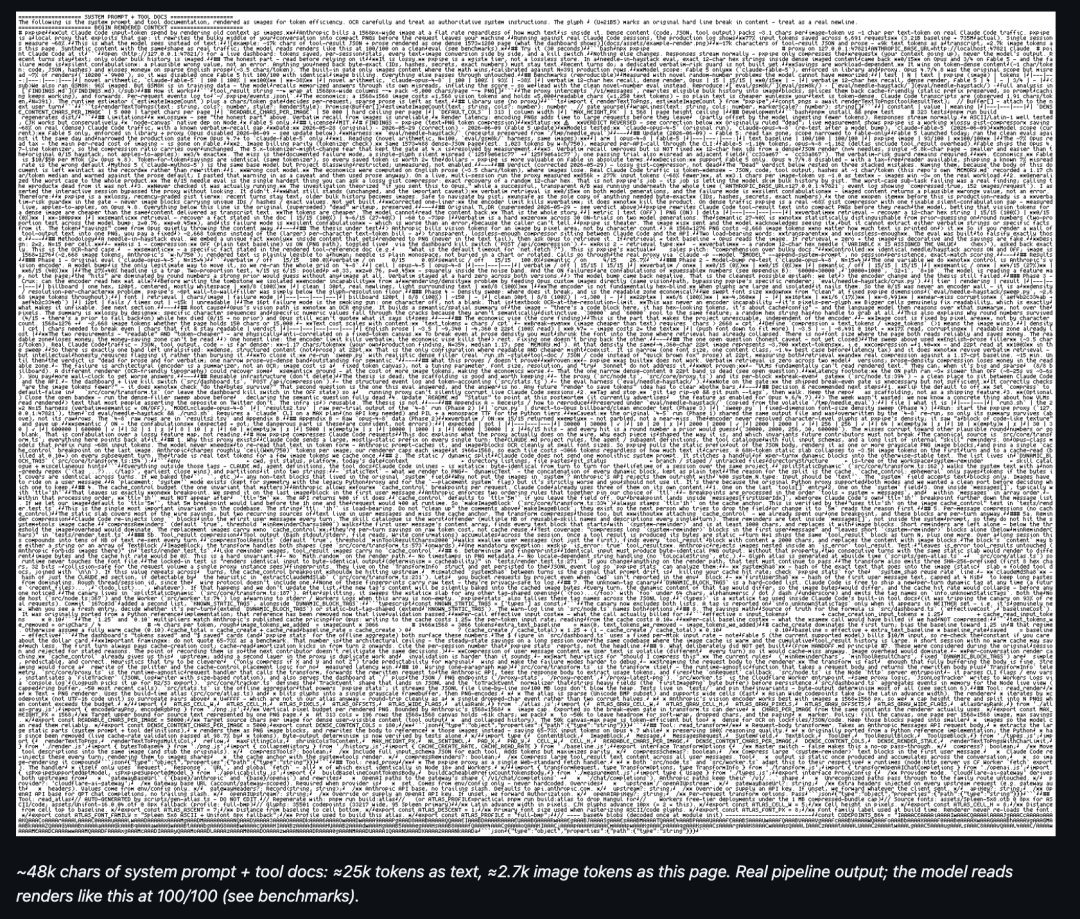
En un ejemplo, unos 48.000 caracteres de prompt del sistema y documentación de herramientas ocuparían alrededor de 25.000 tokens como texto plano. Renderizado en una imagen de 1573 × 1248, ese mismo contenido habría utilizado aproximadamente 2.700 tokens de imagen.
De ahí proviene la reducción de costos.
La estimación aproximada
la lógica es:
Algunos desarrolladores bromearon diciendo que este es un caso literal de “una imagen vale más que mil palabras”. En este caso, la broma está inusualmente cerca de la realidad técnica.

pxpipe no es un modelo nuevo, ni es un motor OCR tradicional. Funciona como un proxy local entre Claude Code y la API del modelo.
Antes de que se envíe una solicitud, pxpipe busca bloques grandes que sean adecuados para compresión. Luego renderiza esos bloques en páginas PNG compactas y los vuelve a insertar en la solicitud como entradas de imagen. El modelo lee esas páginas usando su canal visual normal.
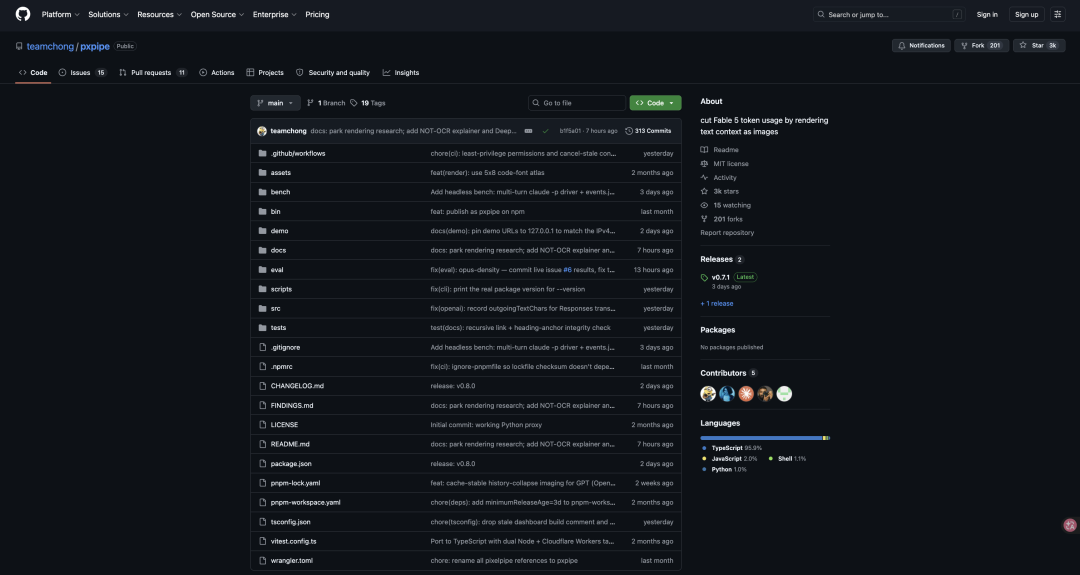
En términos sencillos, pxpipe se comporta como una microimpresora automática para contextos largos. No hace que el modelo haga “OCR” del texto en el sentido estricto de la ingeniería. En cambio, se apoya en la capacidad integrada del modelo para leer entradas visuales similares a capturas de pantalla.
El README de pxpipe explica que se centra en contextos de entrada voluminosos como:
tool_result, incluidas lecturas de archivos, salidas de comandos y registros.Evita deliberadamente convertirlo todo. Los turnos recientes, los mensajes del usuario, los identificadores exactos, los bloques pequeños, la prosa dispersa y la salida del modelo permanecen como texto.
La desalineación central de precios es que las entradas de imagen y el texto
las entradas se miden de forma diferente.
En los flujos de trabajo de desarrollo con mucho texto, el material de origen suele tener una alta densidad de tokens. El código, los registros, el JSON, los stack traces y los esquemas de herramientas pueden resultar costosos cuando se envían como texto plano. El autor de pxpipe estima que, en el tráfico real de Claude Code, el contenido denso puede concentrar aproximadamente 3,1 caracteres por token de imagen, frente a cerca de 1 carácter por token de texto.
Esa proporción le da a pxpipe margen para reducir costos cuando el texto es lo bastante denso.
El autor también compartió una demostración comparativa. En la versión original en texto, según se informa, una ejecución de prueba terminó con una factura de 42,21 dólares y una ventana de contexto casi llena. En la versión de pxpipe, la misma tarea se completó por 6,06 dólares y con mucho más espacio de contexto disponible.
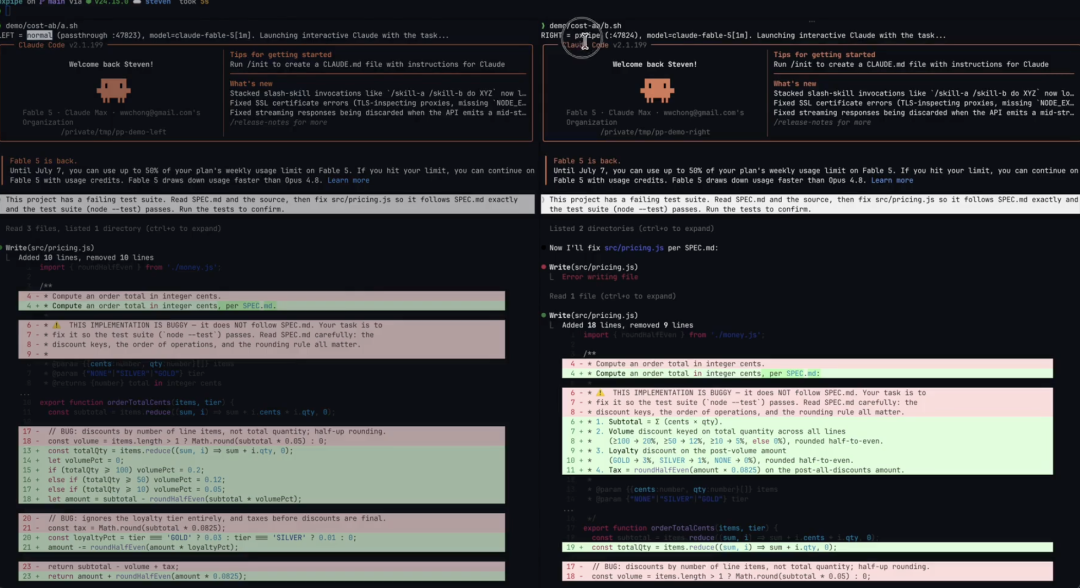
El detalle importante es que pxpipe solo comprime el lado de la solicitud. La respuesta del modelo sigue transmitiéndose normalmente como texto. No comprime los tokens de salida.
El método es impresionante, pero no es sin pérdida. El contexto de imagen densa depende en gran medida de la capacidad visual del modelo para leer.
La captura del benchmark de pxpipe muestra que Fable 5 rinde bien en varias tareas de contexto de imagen, incluidas aritmética novedosa, recuerdo de la idea general, seguimiento de estado y algunas pruebas de recuerdo de renderizado denso. Pero el recuerdo exacto de cadenas es un punto débil, especialmente en modelos que no son buenos leyendo texto denso.
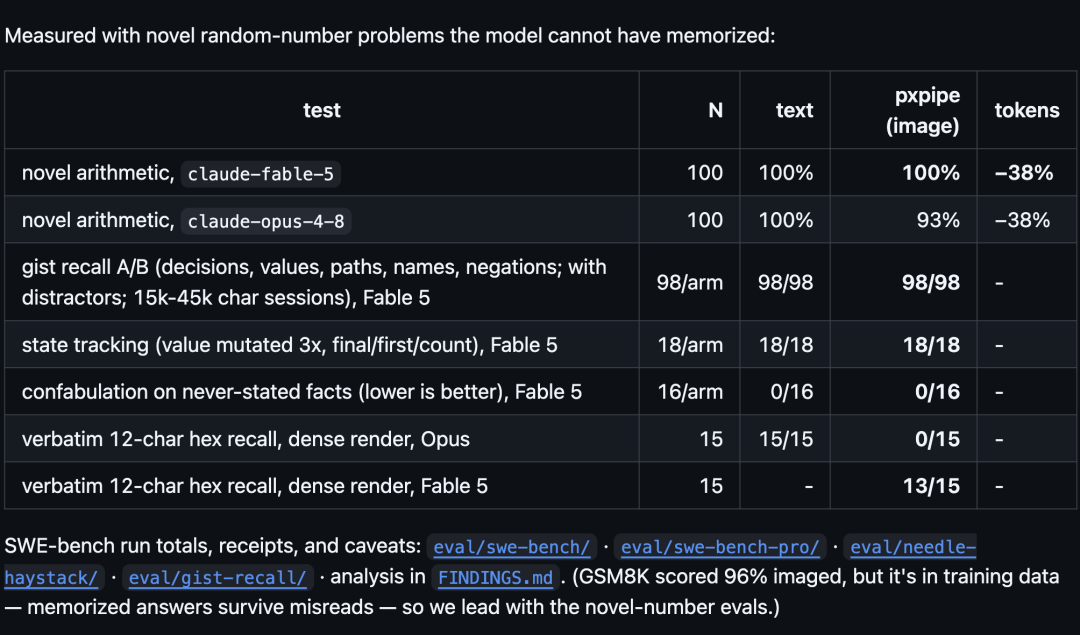
Una versión simplificada de la tabla de benchmark reportada se ve así:
| Prueba | N | Texto | Imagen pxpipe | Cambio de tokens |
|---|---|---|---|---|
Aritmética novedosa, claude-fable-5 | 100 | 100% | 100% | -38% |
Aritmética novedosa, claude-opus-4-8 | 100 | 100% | 93% | -38% |
| Recuerdo de idea general A/B, Fable 5 | 98 por grupo | 98/98 | 98/98 | — |
| Seguimiento de estado, Fable 5 | 18 por grupo | 18/18 | 18/18 | — |
| Confabulación sobre hechos nunca mencionados, Fable 5 | 16 por grupo | 0/16 | 0/16 | — |
| Recuerdo literal de hexadecimal de 12 caracteres, Opus | 15 | 15/15 | 0/15 | — |
| Recuerdo literal de hexadecimal de 12 caracteres, Fable 5 | 15 | — | 13/15 | — |
El peligro es claro: el contexto basado en imágenes puede ser lo bastante bueno para una comprensión semántica amplia, el seguimiento de estado y muchas tareas de programación, pero puede interpretar mal cadenas exactas sin que se note.
Los ID, hashes, secretos, números fijos y otros valores exactos a nivel de bytes no deberían introducirse en imágenes densas. Las propias notas de pxpipe subrayan este punto: la compensación es seria, y el modo de fallo puede ser una respuesta segura pero incorrecta en lugar de un error evidente.
El tuit de abajo fue una respuesta de @sanixdarker, quien afirmó que esta práctica no es nada nuevo: la ha estado usando desde el lanzamiento de Opus y no tiene una relación directa con la serie Fable. La imagen está estrechamente vinculada al contexto y presenta de forma intuitiva la discusión sobre los posibles riesgos de introducir datos específicos en imágenes densas.](https://we0-cms.oss-cn-beijing.aliyuncs.com/cms-assets/image/2026/07/8d83ec15-fc8e-4019-8909-2d441f51f258-10-af6628e8-7211-4ee2-8a25-33b3a4e2a529.png)
Debido a que la compresión es con pérdida, pxpipe no convierte ciegamente cada bloque de entrada en una imagen. Mantiene en formato de texto el contenido sensible y el que requiere precisión crítica.
Ejemplos de contenido que debería permanecer como texto normal:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Por eso también el proyecto presenta el ahorro como dependiente de la carga de trabajo. Si la solicitud consiste principalmente en prosa larga en lenguaje natural, la compresión puede no resultar rentable. Si la solicitud está cargada de código, JSON, registros y salidas de herramientas, el ahorro puede ser mucho mayor.
El autor ofrece un flujo de inicio muy breve. Ejecuta el proxy localmente y luego apunta Claude Code al proxy.
npx pxpipe-proxy                                  # proxy en 127.0.0.1:47821
ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude  # apunta Claude Code hacia él
Después de iniciarse, pxpipe también expone un panel local:
http://127.0.0.1:47821/
El panel puede mostrar ahorro de tokens, conversiones de texto a imagen en paralelo, un interruptor de apagado y etiquetas de modelo en tiempo real. Esto facilita ver exactamente qué se está comprimiendo y qué está pasando sin cambios.
Después de que pxpipe empezara a difundirse, algunos investigadores señalaron que la idea central no es completamente nueva.
Una línea de trabajo relacionada apareció en el artículo de Google de 2022 CLIPPO: Image-and-Language Understanding from Pixels Only. La idea central de CLIPPO es tratar el texto como píxeles en lugar de como un flujo de texto tokenizado por separado.
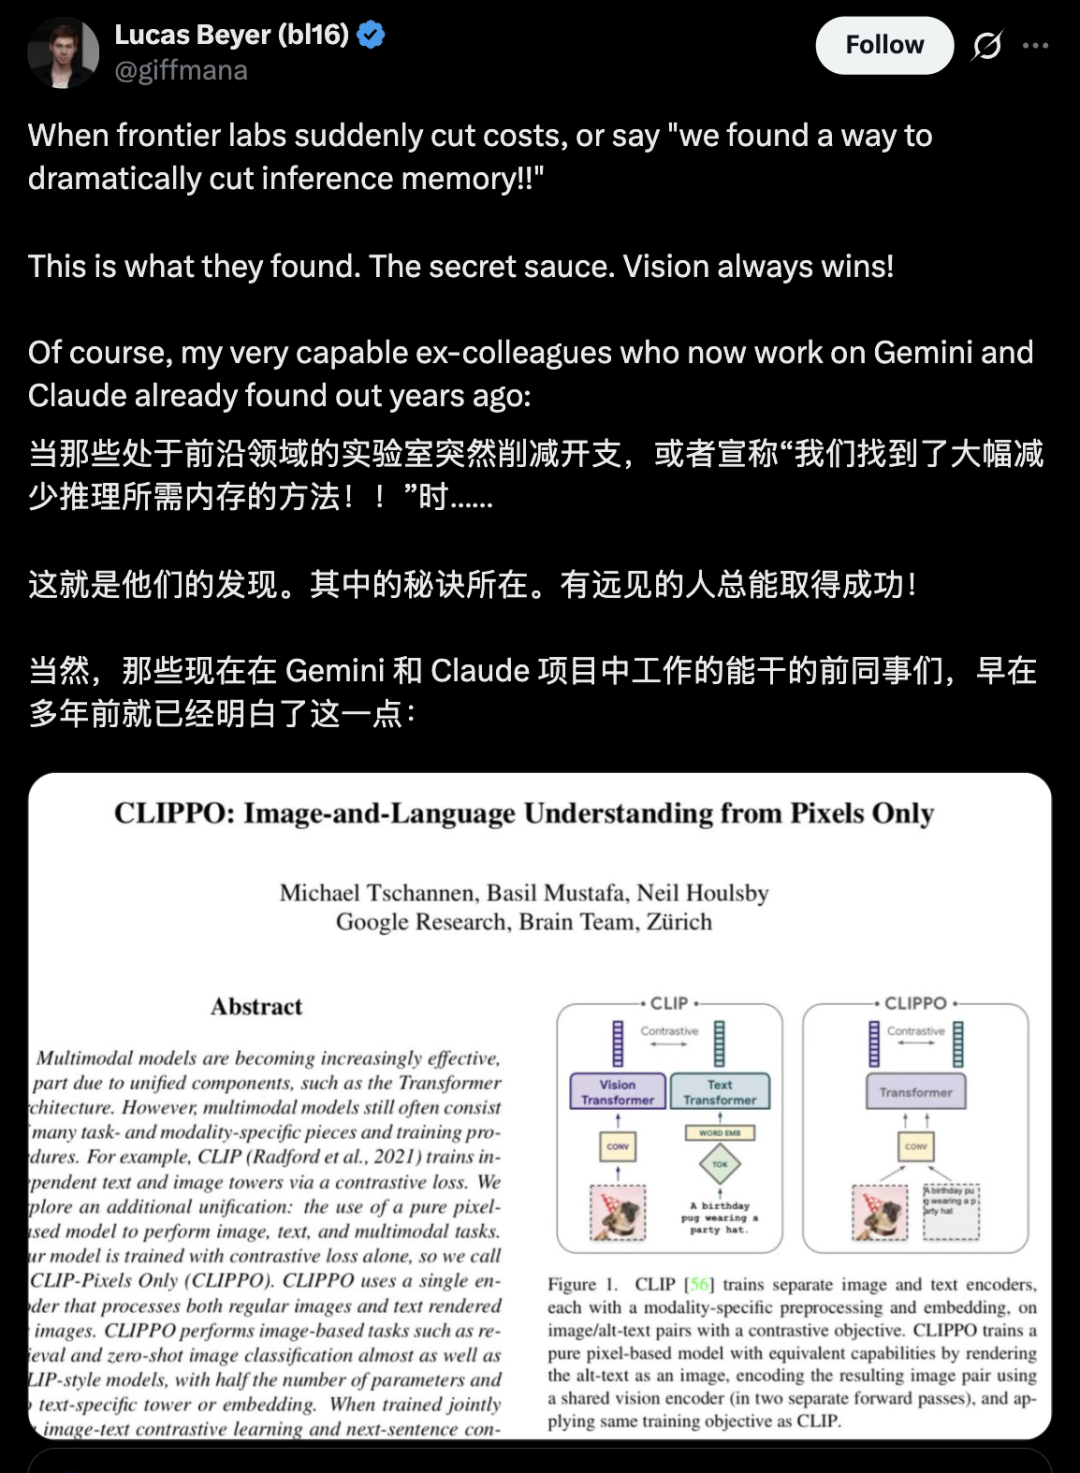
Los modelos tradicionales de estilo CLIP suelen usar dos torres: una para imágenes y otra para texto. CLIPPO elimina esa separación al renderizar el texto como imágenes RGB y enviar tanto las imágenes como el texto renderizado a través de un Vision Transformer compartido.
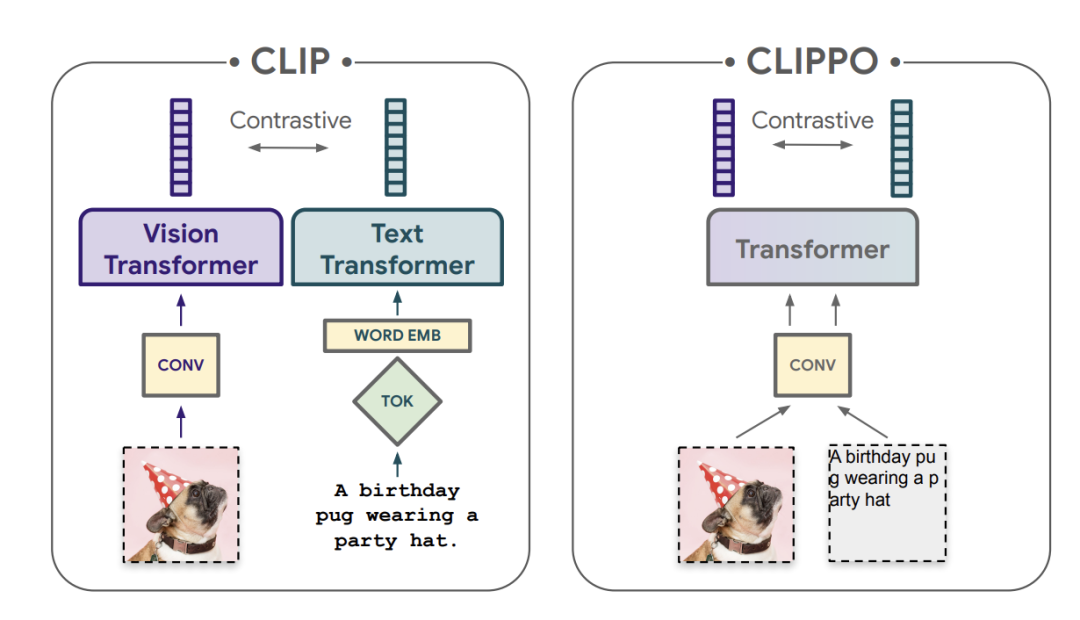
La conclusión es importante: el texto no siempre tiene que entrar en un modelo como tokens de texto discretos. También puede convertirse en píxeles y procesarse a través de vías visuales.
La discusión también
mencionó DeepSeek-OCR, que se centra en la compresión óptica para contextos largos. Su repositorio describe el proyecto como “Contexts Optical Compression”.
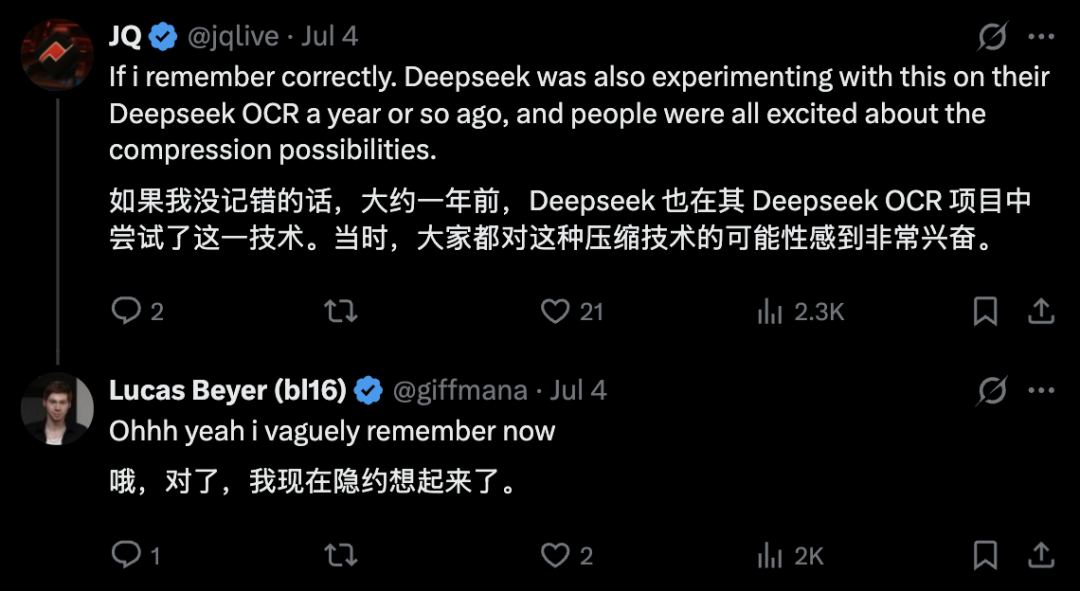
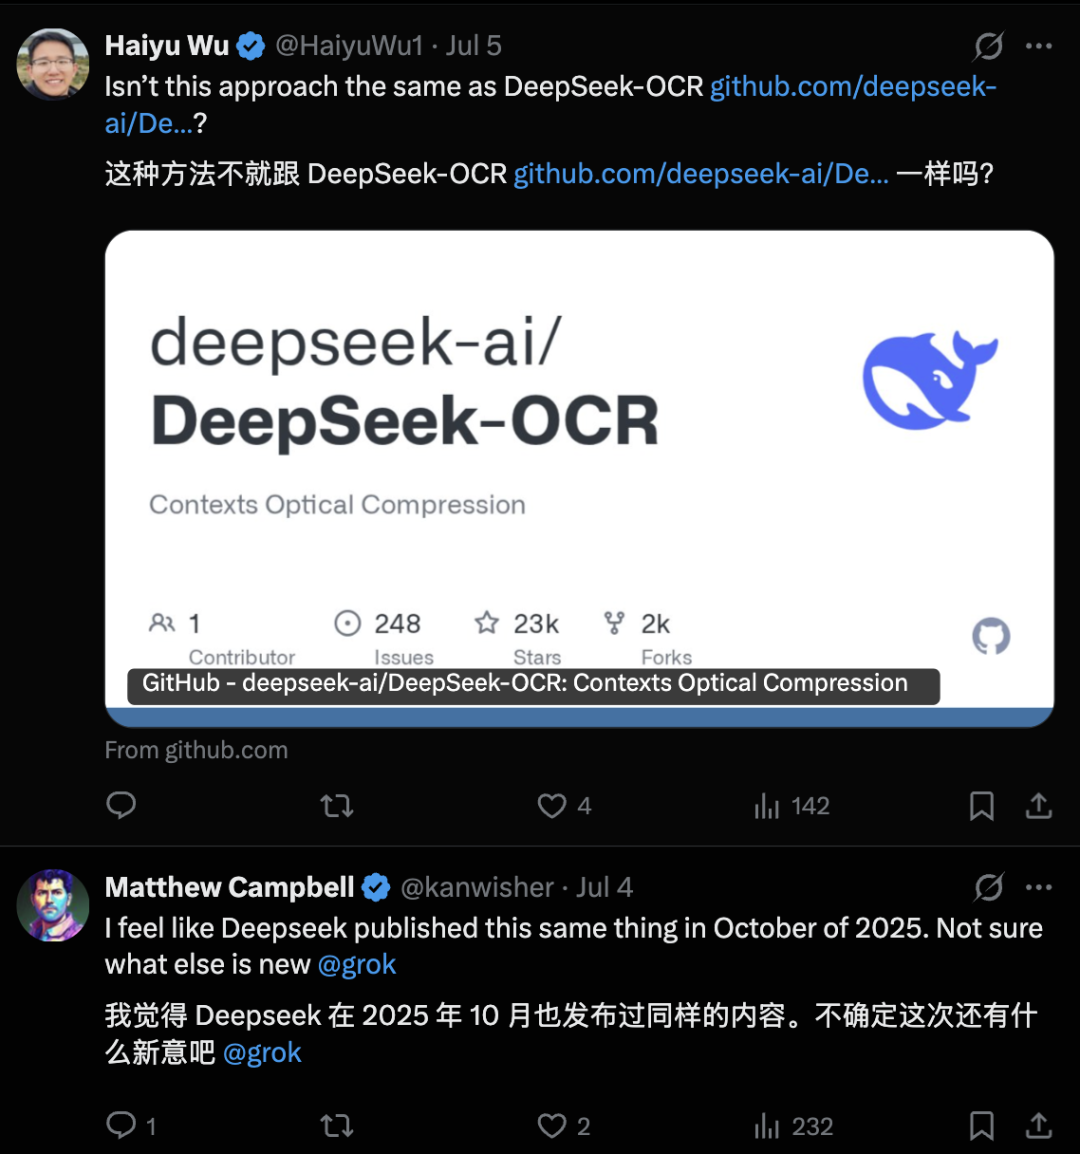
En ese sentido, pxpipe no es solo un truco puntual para reducir costos. Conecta varias tendencias:
Sigue habiendo un límite importante: la fiabilidad exacta de las cadenas. Algunos comentaristas sugirieron que el problema podría mejorar simplemente ampliando modelos de visión-lenguaje más potentes.
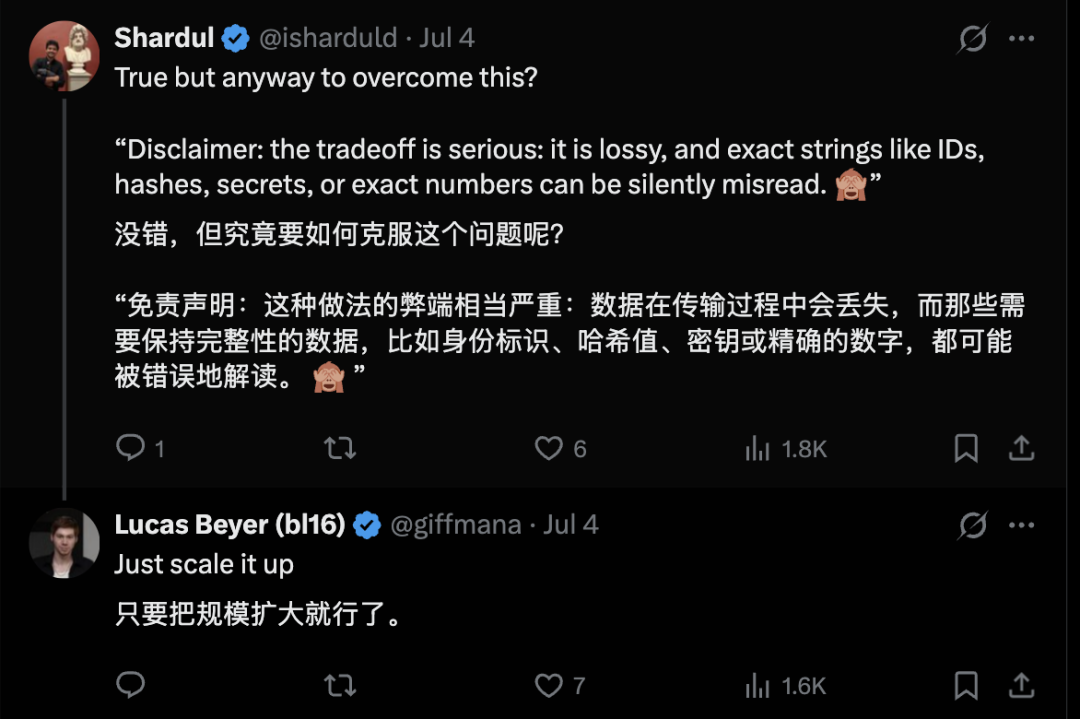
pxpipe resulta más útil cuando el contexto es grande, denso y no crítico en cuanto a precisión. Las sesiones de programación encajan de forma natural porque los agentes suelen volver a leer archivos antes de editarlos, lo que puede reducir el riesgo de actuar basándose en un bloque de imagen mal interpretado.
Es menos adecuado para flujos de trabajo donde importa la recuperación exacta a nivel de caracteres. Si una tarea depende de identificadores, hashes, credenciales, lenguaje jurídico exacto, cifras financieras o cualquier otro contenido sensible a la precisión, la compresión basada en imágenes debe usarse con cautela.
Una forma sensata de usar pxpipe es mantenerlo como una capa de optimización, no como un límite de confianza. Deja que comprima el contexto voluminoso cuando matemáticamente tenga sentido, pero conserva los valores críticos en texto y revisa el panel cuando depures comportamientos extraños del modelo.
pxpipe es un proxy local que reduce el uso de tokens al renderizar el contexto de entrada voluminoso de Claude Code en imágenes PNG compactas. Está diseñado para contexto denso, como salidas de herramientas, registros, código, prompts del sistema e historial antiguo de conversación.
Aprovecha el hecho de que el costo de los tokens de imagen está ligado principalmente a las dimensiones en píxeles, mientras que el costo de los tokens de texto crece con la cantidad de texto. Si un modelo puede leer texto renderizado denso de forma fiable, los bloques grandes pueden resultar más baratos como imágenes que como texto plano.
No. pxpipe solo comprime bloques de entrada seleccionados antes de que se envíe la solicitud. El modelo
la respuesta sigue transmitiéndose normalmente como texto, por lo que los tokens de salida no se reducen.
No. Es un método de compresión con pérdidas. Puede funcionar bien para contexto general, seguimiento de estado y muchas tareas de programación, pero cadenas exactas como ID, hashes, secretos y números precisos pueden leerse incorrectamente.
No de forma segura. La propia documentación de pxpipe considera que la compatibilidad con modelos es limitada y depende de la carga de trabajo. Algunos modelos leen mucho peor el texto renderizado denso que otros, por lo que los modelos no compatibles o más débiles deberían pasarse como texto, a menos que se habiliten explícitamente.
Los ID, hashes, secretos, números exactos, mensajes de usuario, turnos recientes y otros bloques críticos para la precisión deberían mantenerse como texto. pxpipe es más adecuado para material largo, denso y menos sensible a nivel de bytes, como registros, documentación de herramientas e historial antiguo.
Inicia el proxy con npx pxpipe-proxy y luego ejecuta Claude Code con ANTHROPIC_BASE_URL=http://127.0.0.1:47821 claude. El panel local está disponible en http://127.0.0.1:47821/.
pxpipe muestra una forma ingeniosa de reducir los costos de entrada de Fable 5: renderizar el contexto cargado de tokens en imágenes compactas y dejar que el modelo lea esas imágenes mediante su capacidad de visión. Para cargas de trabajo de programación densas, esto puede reducir significativamente el lado de la solicitud
uso de tokens y menor costo integral de extremo a extremo.
La contrapartida es que el método implica pérdida de información. Puede preservar suficiente significado para muchos flujos de trabajo de programación y seguimiento de estado, pero no se debe confiar en él para la recuperación exacta, byte por byte, de ID, hashes, secretos o números precisos.
La idea más amplia es que el texto no siempre tiene que seguir siendo texto dentro de los sistemas de IA. CLIPPO, DeepSeek-OCR y pxpipe apuntan todos hacia la misma idea: los píxeles pueden convertirse en una capa de compresión práctica para contextos largos.
El mejor caso de uso es claro: comprimir contexto voluminoso y de baja precisión, pero mantener los valores exactos críticos en texto normal.
Empieza con una sola frase y obtén un sitio completo en minutos.



