For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/flux-3-image-klein-specs-gpu-memory-api-a-c62c858a.md.
Black Forest Labs lanzó **FLUX 3 Image Klein** el 15 de octubre como un modelo de pesos abiertos para generar y editar imágenes. Un único mo...
Black Forest Labs lanzó FLUX 3 Image Klein el 15 de octubre como un modelo de pesos abiertos para generar y editar imágenes. Un único modelo gestiona solicitudes de texto a imagen, ediciones basadas en una referencia y composiciones basadas en múltiples referencias.
Su generador de imágenes contiene 5.600 millones de parámetros. Esa cifra excluye el codificador de texto independiente, un detalle importante al comparar tamaños de modelos o planificar hardware local. BFL ofrece tanto un checkpoint base para adaptación como un checkpoint destilado para una generación más rápida, además de acceso mediante su API.
El lanzamiento combina un generador más pequeño con compatibilidad para hasta diez imágenes de referencia, generación nativa en 4K y guía mediante cuadros delimitadores. Las decisiones de implementación siguen dependiendo del checkpoint, la precisión, la implementación de inferencia y los términos de licencia.
El modelo acepta un prompt y hasta diez imágenes de referencia, y devuelve una imagen. Las entradas de referencia pueden ayudar a fijar un sujeto o combinar material de varias fuentes, mientras que la descripción escrita controla la escena y composición previstas.
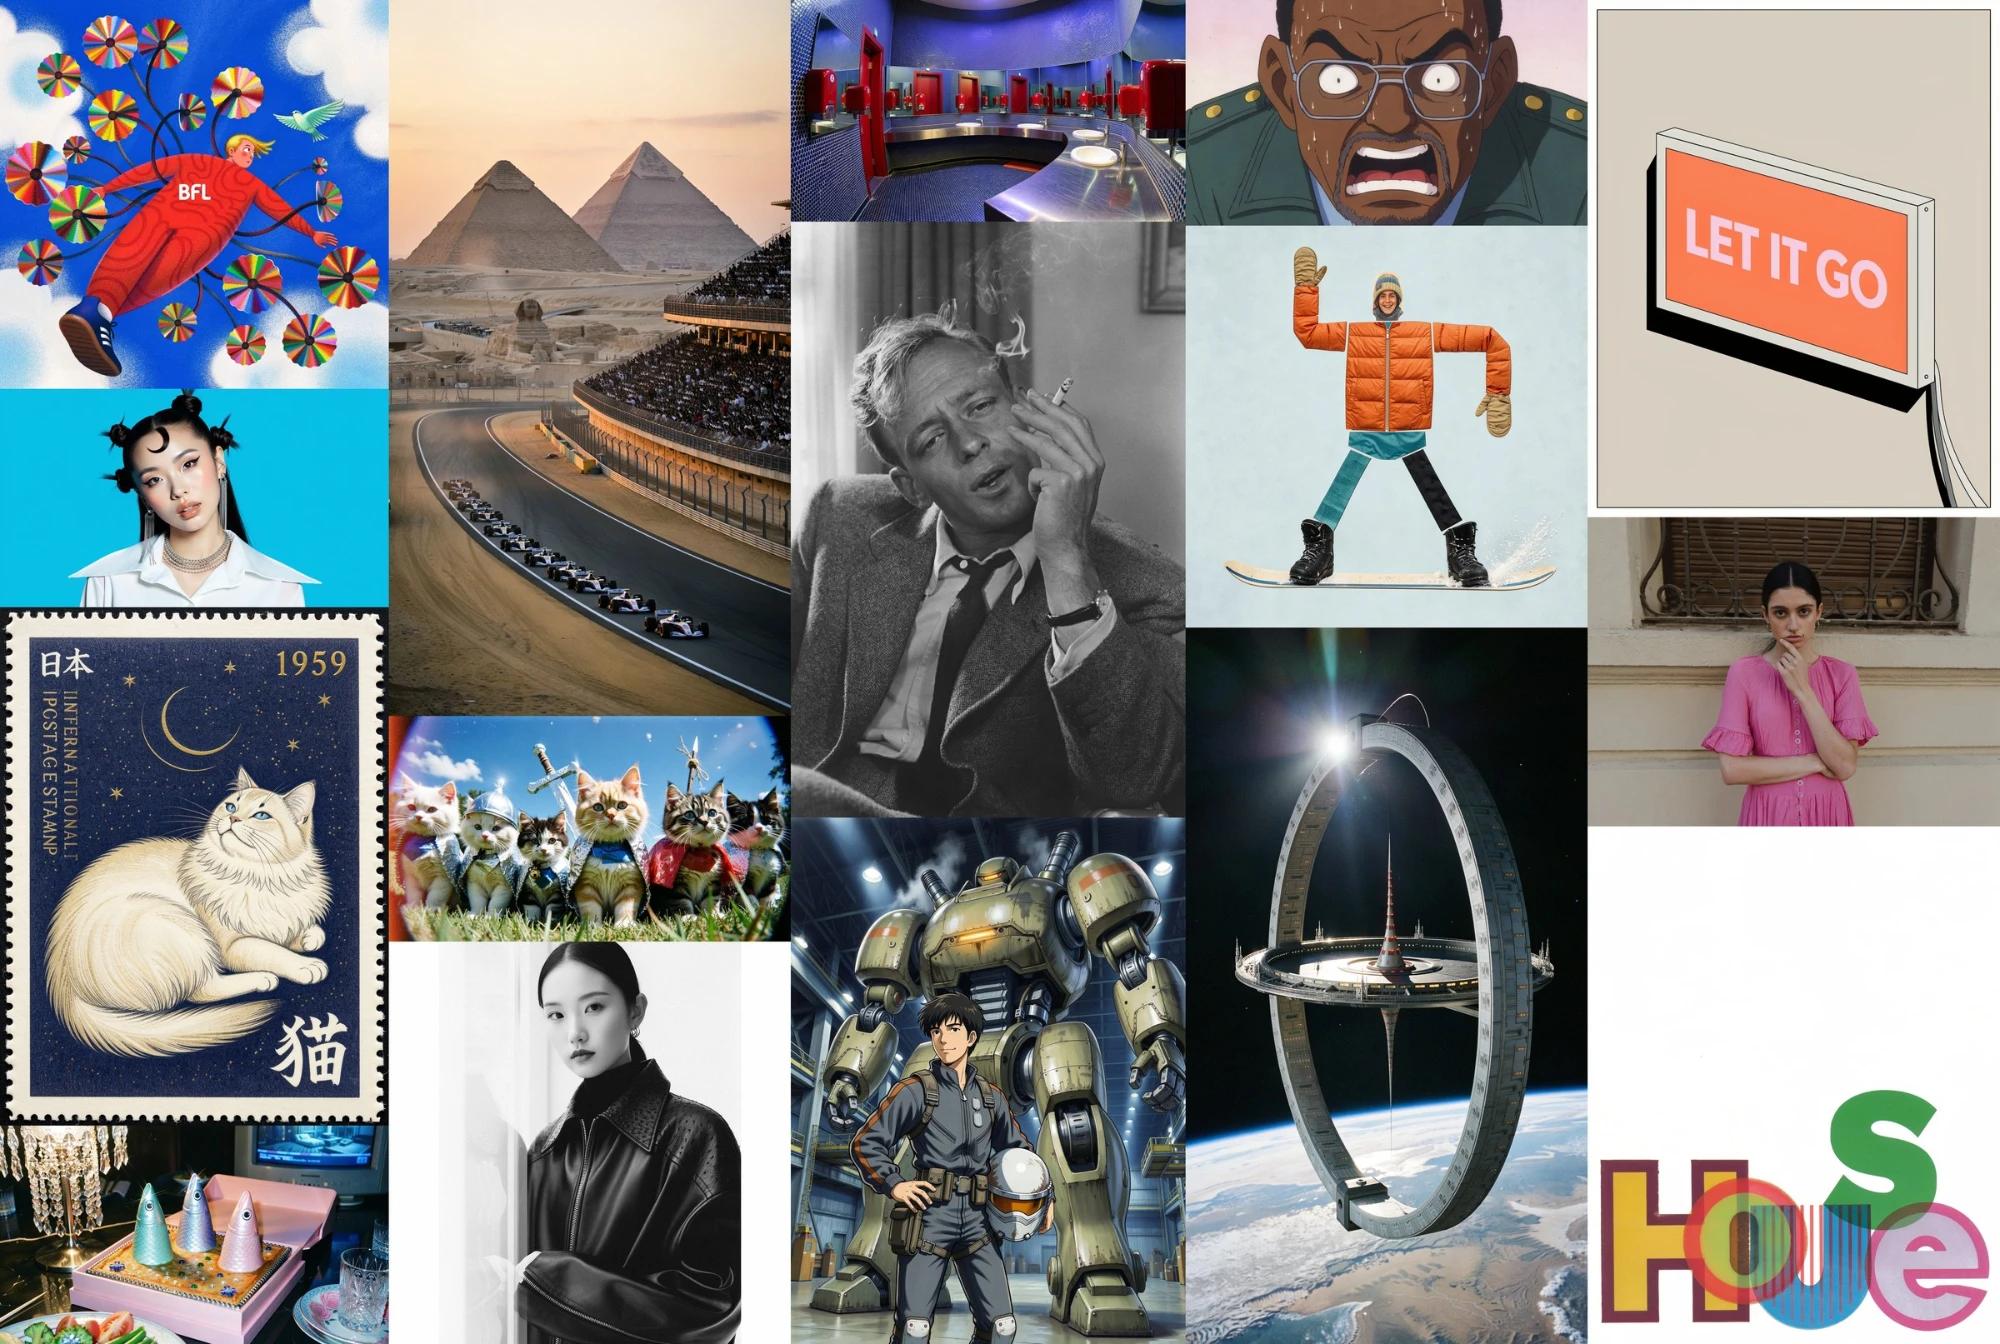
Fuente: Black Forest Labs. Esta es una colección de resultados generados seleccionada por el editor, no una evaluación independiente de calidad.
BFL describe el modelo como basado en aprendizajes compartidos de la investigación de imagen, vídeo y audio de la familia FLUX 3. Para Image Klein en concreto, la interfaz publicada es de generación y edición de imágenes; ese trasfondo de investigación no implica que el checkpoint genere audio o vídeo.
Los cuadros delimitadores guían la ubicación y escala de los elementos. La tarjeta oficial del modelo especifica una cuadrícula de coordenadas de 0 a 1000 y ordena cada cuadro como superior, izquierdo, inferior, derecho. También advierte que los cuadros no son máscaras rígidas de píxeles: los elementos pueden extenderse más allá de ellos, los elementos pequeños pueden desaparecer y las ediciones pueden afectar áreas fuera de la región solicitada.
La API alojada de BFL añade restauración de píxeles, diseñada para conservar exactamente las regiones no editadas. Esta función de servicio no debe tratarse como una propiedad incondicional de la inferencia del checkpoint sin procesar.
Los dos checkpoints principales tienen propósitos distintos:
| Checkpoint | Configuración publicada de pasos | Configuración de guía | Uso previsto |
|---|---|---|---|
| Klein Base | 50 | 3.5 | Ajuste fino, entrenamiento de LoRA e investigación |
| Klein | 16 | Ninguna | Generación, edición e inferencia autoalojada |
Fuente: tarjeta oficial del modelo de BFL. El checkpoint destilado es también el modelo detrás de la API alojada de Image Klein.
El modelo utiliza Qwen3-VL-4B-Instruct como su codificador de texto independiente. El paquete de Hugging Face incluye el transformador de imágenes, el codificador de texto y el autoencoder de imágenes; allí se describen variantes BF16, FP8 y NVFP4, mientras que el anuncio de lanzamiento también identifica compilaciones INT8 compatibles con NVIDIA.
Para la adaptación, BFL dirige a los desarrolladores al modelo base. El lanzamiento indica compatibilidad de Diffusers, AI Toolkit de Ostris y NVIDIA NeMo AutoModel para LoRA y otros flujos de trabajo de entrenamiento.
BFL informa que Image Klein lidera sus comparaciones internas de texto a imagen, edición y múltiples referencias frente a las alternativas seleccionadas. Su artículo de lanzamiento destaca mejoras de 91 Elo en texto a imagen y 70 Elo en edición respecto a FLUX.2 [klein] 9B, utilizando un 38 % menos de parámetros del generador.
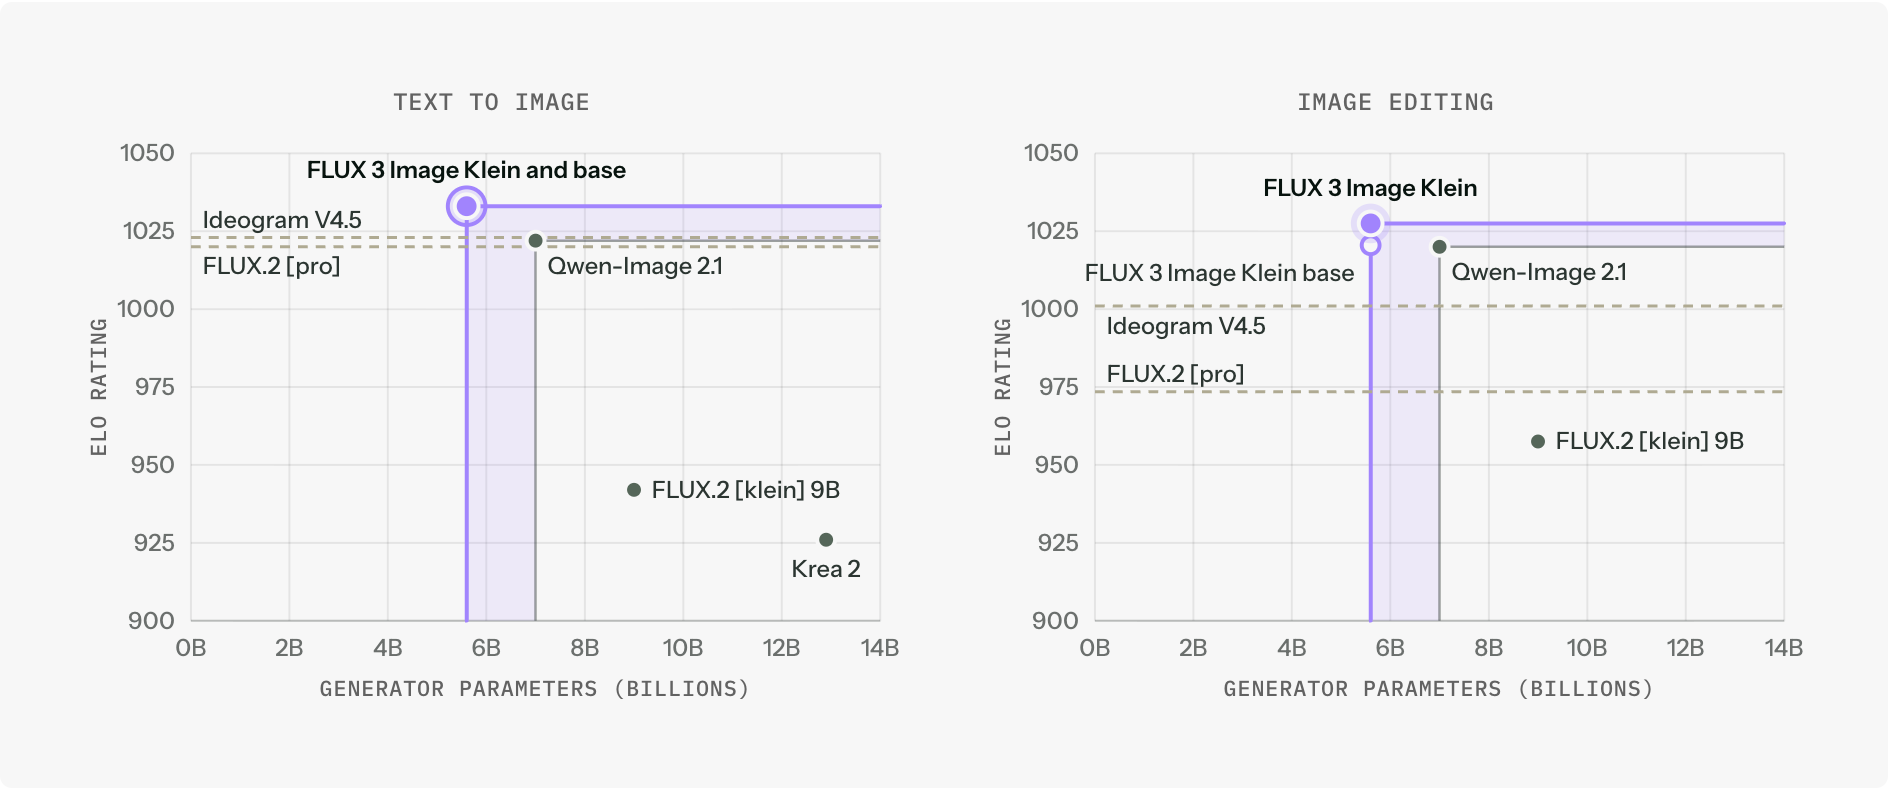
Fuente: Black Forest Labs. Los recuentos de parámetros del generador excluyen los codificadores de texto; Krea 2 se omite de la comparación de edición porque no admite esa tarea.
Estas calificaciones describen el conjunto de comparación y el procedimiento de evaluación de BFL. No establecen que el modelo vaya a producir el mejor resultado para cada prompt, estilo, idioma o restricción de edición. Para un flujo de trabajo de producción, pruebe los tipos de referencias y ediciones que realmente se producen en ese flujo.
El anuncio de lanzamiento indica requisitos de pesos del generador de 11,2 GB en BF16 y 5,6 GB en FP8. Esos son tamaños de pesos, no presupuestos completos de memoria GPU.
BFL afirma que una compilación INT8 optimizada puede ejecutarse en GPU GeForce RTX con tan solo 8 GB de VRAM mediante configuraciones compatibles de ComfyUI o Diffusers. Esta afirmación depende de la compilación y la implementación; no significa que el pipeline de referencia sin modificar quepa en 8 GB.
La tarjeta del modelo informa de los siguientes picos de memoria del código de referencia en una B200 a 1024 por 1024 píxeles, con el mejorador de prompts desactivado:
| Precisión | Pico de memoria GPU informado |
|---|---|
| BF16 | 31 GB |
| FP8 | 26 GB |
| NVFP4 | 25 GB |
La misma tarjeta indica que el mejorador de prompts añade aproximadamente 28 GB en una GPU de 80 GB. La codificación de texto, las activaciones intermedias, la resolución y el procesamiento de referencias ayudan a explicar por qué la memoria total es mayor que los pesos almacenados del generador.
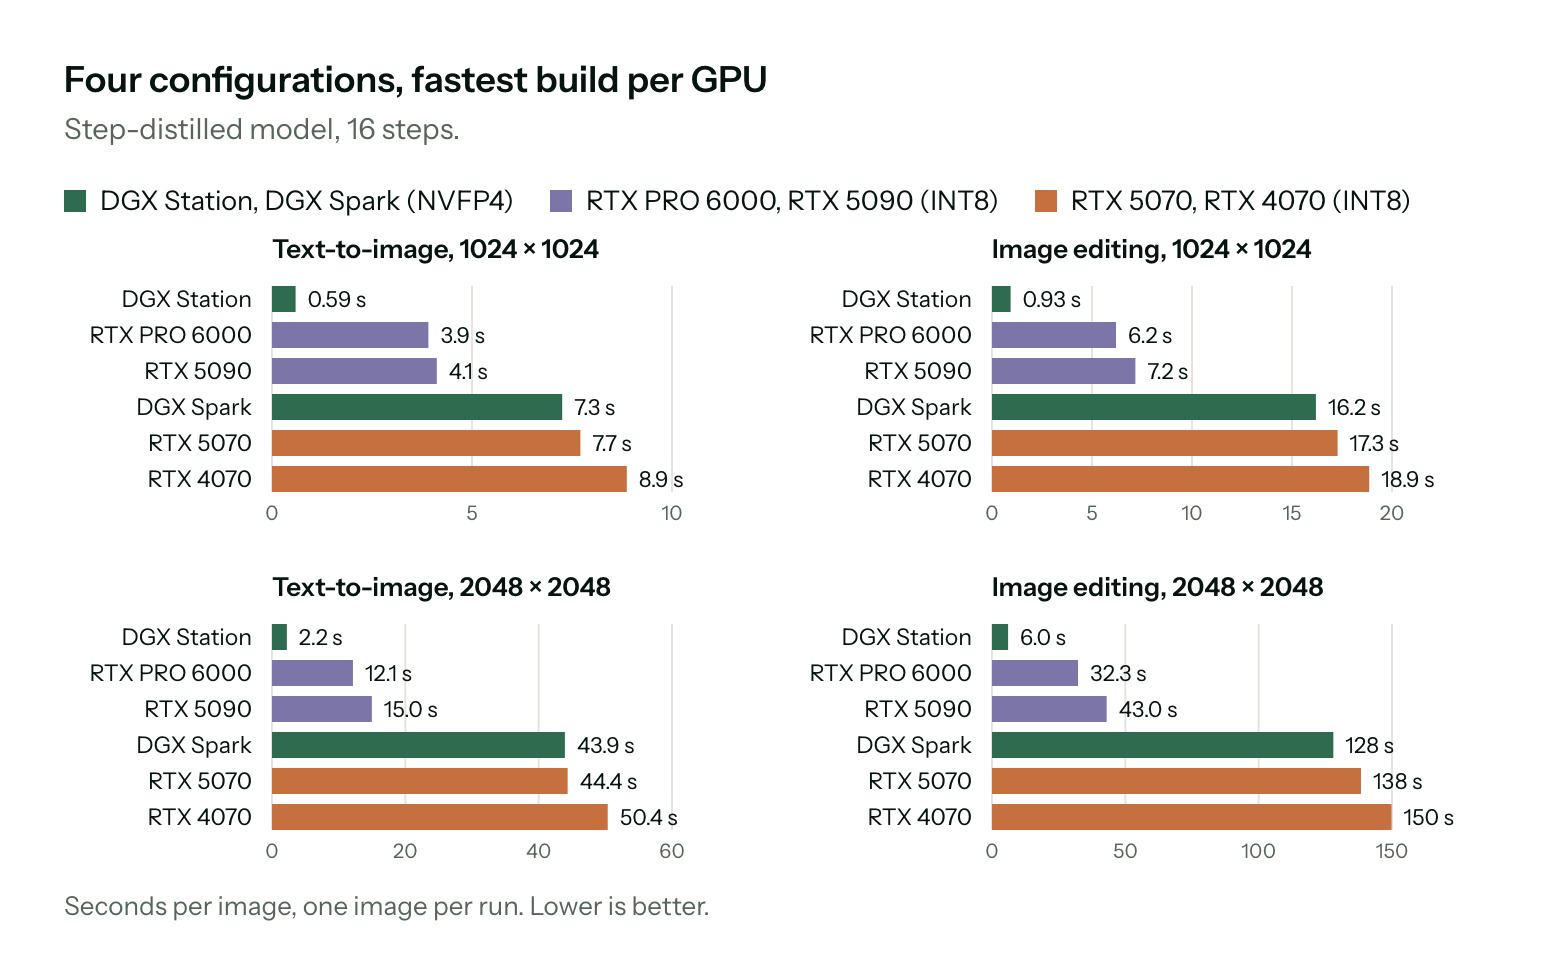
Fuente: BFL, medido por NVIDIA. El gráfico utiliza una imagen por ejecución y la compilación más rápida indicada para cada GPU; las mediciones RTX utilizan ComfyUI. Son tiempos de generación, no tiempos completos de respuesta de la API.
Para el checkpoint destilado de 16 pasos, el gráfico informa de 4,1 segundos para un resultado de texto a imagen de 1024 por 1024 en una RTX 5090 y de 8,9 segundos en una RTX 4070. La edición tarda más en esas mediciones, y las configuraciones más grandes de 2048 por 2048 son sustancialmente más lentas.
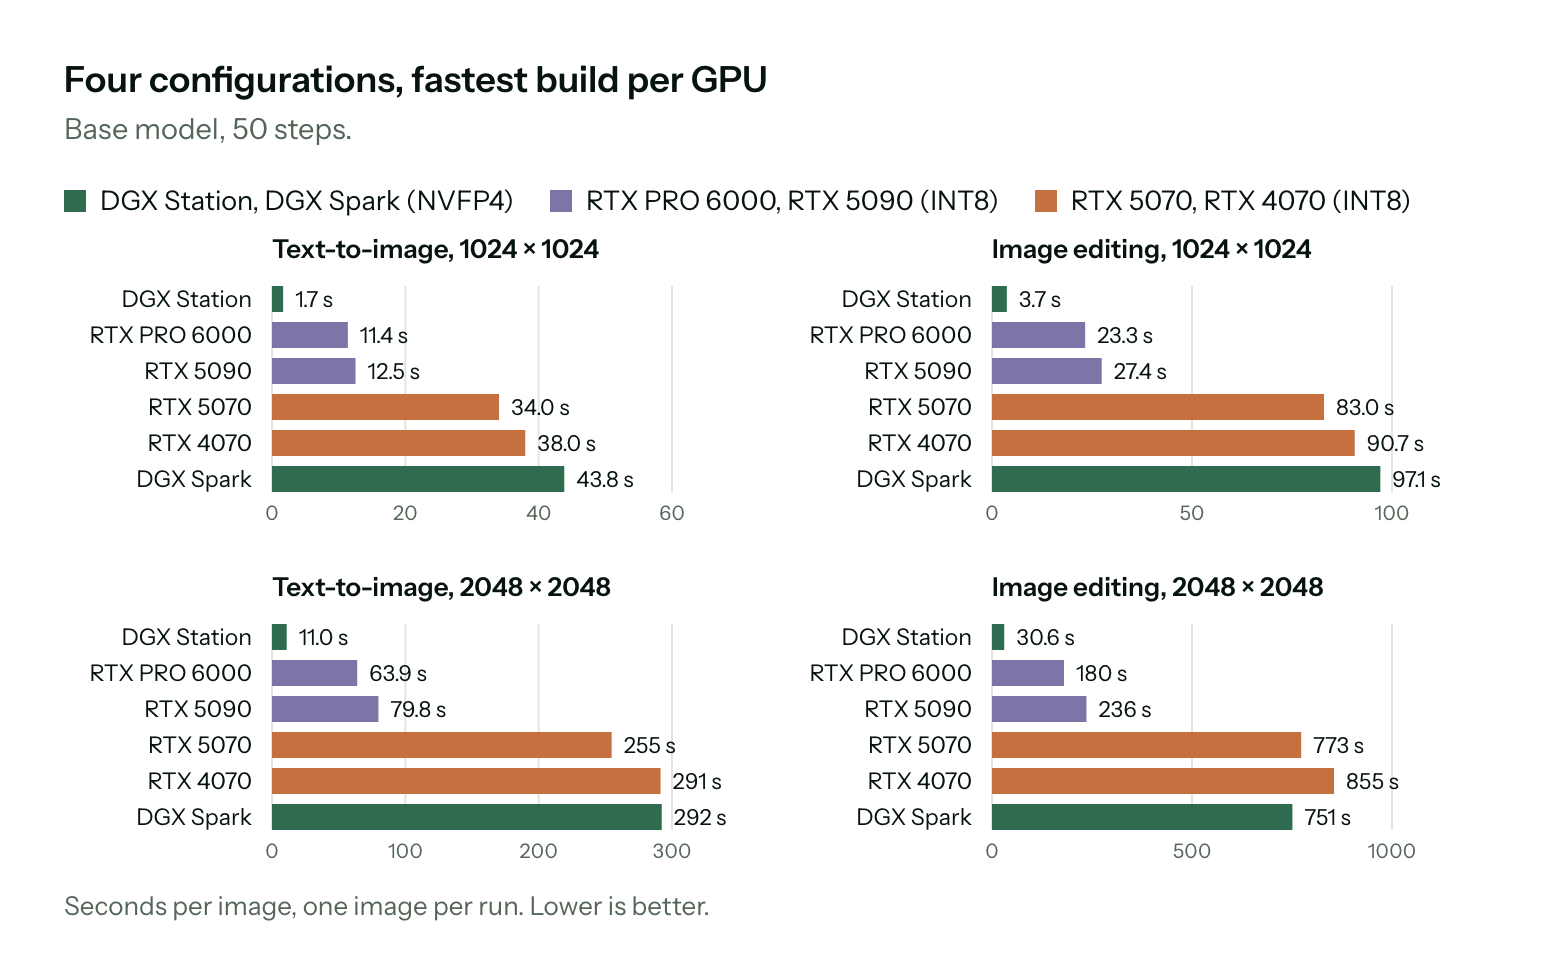
Fuente: BFL, medido por NVIDIA. Este gráfico utiliza el checkpoint base de 50 pasos y la compilación más rápida mostrada para cada GPU.
El modelo base de 50 pasos tiene un perfil de velocidad distinto. Es útil mantener sus resultados separados de los del modelo destilado, especialmente al estimar el tiempo de iteración para entrenamiento o edición de imágenes de referencia.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La API de BFL expone el modelo destilado como flux-3-image-klein. El anuncio de lanzamiento afirma que el precio comienza en 0,009 USD por imagen de 1K e incluye mejora de prompts y restauración de píxeles en la oferta alojada. Consulte la documentación actual de la API y los precios de la cuenta antes de estimar una factura de producción.
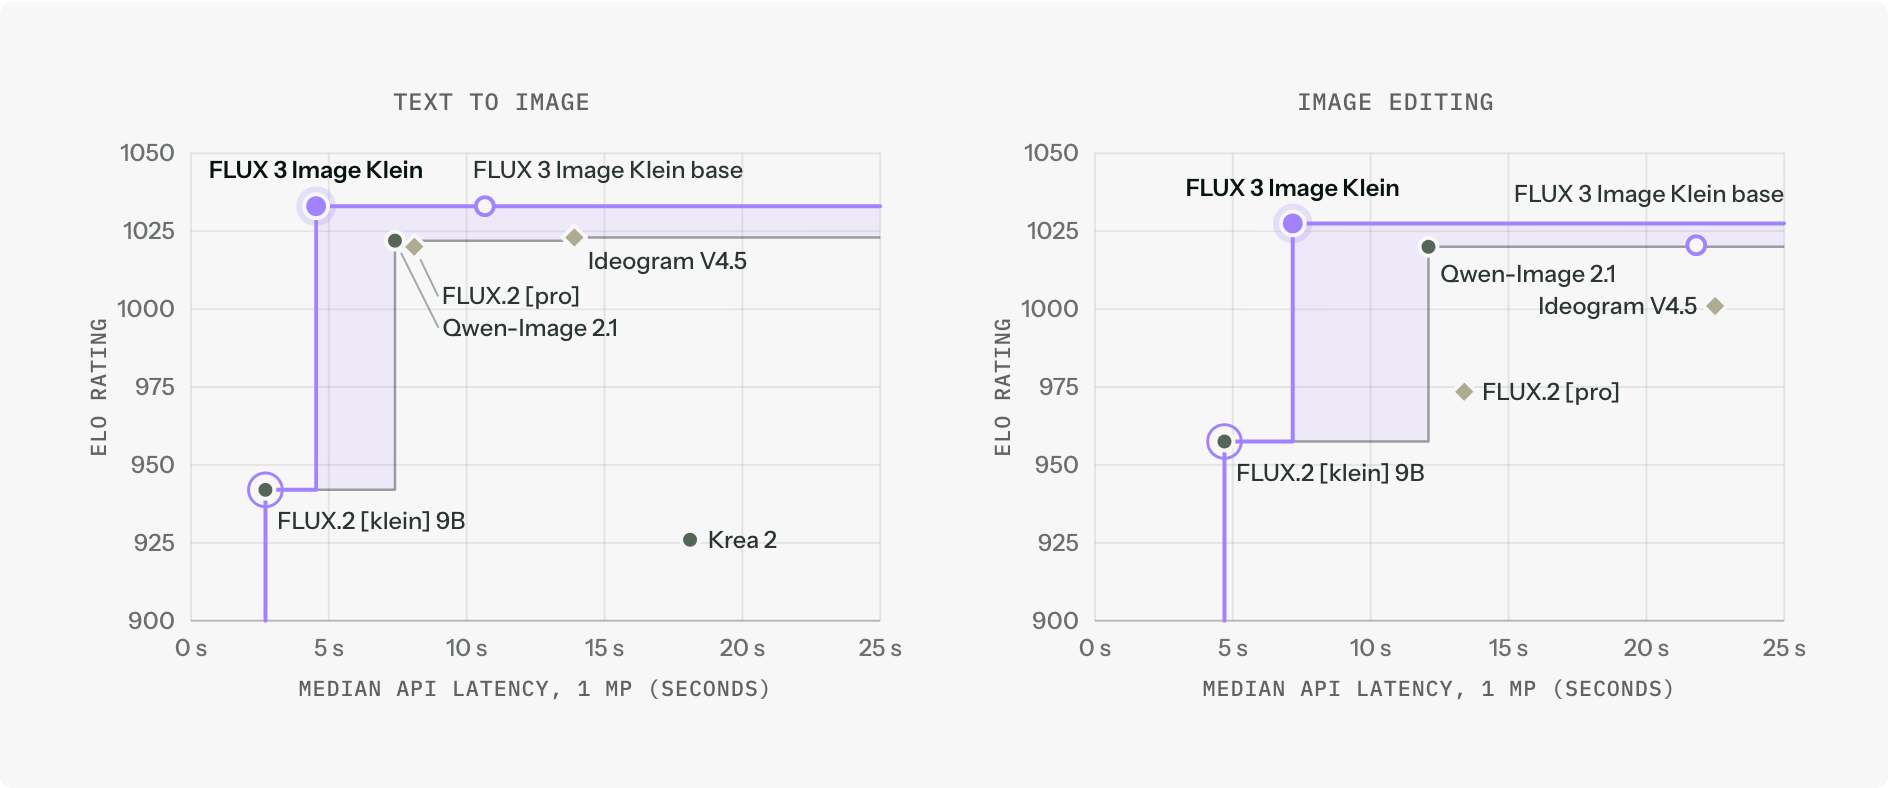
Fuente: Black Forest Labs. La comparación publicada utiliza imágenes finales de 1 MP e incluye tiempo en cola; BFL cronometró su propio modelo en sus servidores, mientras que las mediciones de competidores fueron del lado del cliente e incluyeron sondeo y tiempo de red.
Estas diferencias de medición son importantes al interpretar la clasificación de velocidad. El tiempo de generación local, la medición del lado del servidor y la latencia de API observada por el cliente responden a preguntas relacionadas, pero distintas. Una aplicación debe medir el tiempo desde el envío de su propia solicitud hasta disponer de un resultado utilizable.
La tarjeta oficial del modelo enfatiza las descripciones completas de escena. Las instrucciones breves enviadas directamente al modelo de imágenes pueden producir resultados genéricos o replantear una edición de forma no intencionada.
Una secuencia práctica de evaluación es:
La CLI de referencia carga por defecto el mejorador de prompts de BFL. Diffusers no lo invoca automáticamente, por lo que esa etapa debe gestionarse por separado al utilizar el pipeline modular documentado.
El anuncio de lanzamiento contiene un bloque de cita, reproducido aquí para atribución:
@misc{bfl2026flux3imageklein,
  author       = {{Black Forest Labs}},
  title        = {{FLUX} 3 Image Klein},
  year         = {2026},
  url          = {https://bfl.ai/blog/flux-3-image-klein},
}
Image Klein utiliza la FLUX Kommunity License v1.0. La tarjeta del modelo describe el uso no comercial y una excepción de generación de resultados comerciales para usuarios que cumplan los requisitos y tengan menos de 5 millones de USD de ingresos brutos anualizados, incluidos los afiliados, sujeto al acuerdo.
Esa excepción no es un permiso general para todos los acuerdos comerciales de entrenamiento, redistribución o prestación de servicios. Las organizaciones más grandes y otros usos deben consultar los términos de licencia comercial de BFL o utilizar la API alojada conforme a sus términos aplicables. El codificador de texto Qwen independiente utiliza Apache-2.0.
BFL informa de filtrado de datos de entrenamiento, mitigaciones posteriores al entrenamiento, red teaming interno y evaluación por Cinder. Estas medidas no eliminan las limitaciones indicadas en la tarjeta del modelo: el texto generado puede ser inexacto, el seguimiento de prompts puede fallar, pueden aparecer sesgos y la edición puede alterar regiones no previstas.
Es el modelo de imágenes de pesos abiertos de BFL para generación de texto a imagen, edición de imágenes y composiciones con múltiples referencias. La cifra de 5.600 millones de parámetros describe el transformador de imágenes y excluye su codificador de texto independiente.
BFL afirma que las configuraciones INT8 optimizadas compatibles pueden ejecutarse en GPU con tan solo 8 GB de VRAM. Su implementación de referencia presenta picos de memoria documentados mucho más altos, por lo que la idoneidad del hardware depende de la configuración completa del entorno de ejecución.
Klein Base es el checkpoint no destilado destinado a ajuste fino, LoRA e investigación, con una configuración publicada de 50 pasos. Klein está destilado para generación y edición, con una configuración publicada de 16 pasos y sin guía.
No. La tarjeta oficial del modelo indica que los cuadros guían la ubicación y la escala, en lugar de imponer una máscara rígida. La función de restauración de píxeles de la API alojada es una parte independiente del flujo de servicio.
La licencia incluye una excepción de resultados comerciales para usuarios que cumplan los requisitos y estén por debajo de su umbral de 5 millones de USD de ingresos brutos anualizados, sujeta a todos los términos. El ajuste fino comercial, la distribución y otros acuerdos requieren revisar el acuerdo completo, en lugar de basarse únicamente en el umbral de ingresos.
El pipeline documentado de Diffusers no ejecuta el mejorador de prompts por sí mismo. BFL recomienda ejecutar primero su mejorador u otro modelo de lenguaje adecuado y pasar la descripción completa resultante al pipeline de imágenes.
FLUX 3 Image Klein reúne generación de texto a imagen, edición basada en referencias y guía de diseño en un generador de imágenes de pesos abiertos más pequeño. Los checkpoints base y destilado ofrecen a los desarrolladores rutas distintas para adaptación e inferencia más rápida.
Los principales detalles de implementación van más allá del número de parámetros: uso completo de memoria, mejora de prompts, comportamiento de edición y alcance de la licencia. Elija y evalúe el pipeline completo, en lugar de tratar una cifra de tamaño de pesos o un benchmark de lanzamiento como una especificación completa de implementación.
Empieza con una sola frase y obtén un sitio completo en minutos.
