For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gemini-4-argon-arc-agi-3-97-5-score-cost-f02ba71b.md.
ARC Prize ha anunciado una **puntuación verificada del 97,5 % para Gemini 4 Argon en ARC-AGI-3**, lo que convierte a Google DeepMind en el s...
ARC Prize ha anunciado una puntuación verificada del 97,5 % para Gemini 4 Argon en ARC-AGI-3, lo que convierte a Google DeepMind en el segundo laboratorio de modelos de frontera que supera el 95 % en este benchmark, según el organizador.
El resultado viene acompañado de una comparación igual de importante: la misma familia de modelos obtuvo un 49,8 % con el arnés Standard, frente al 97,5 % con un Provider Adapter. Los costes de evaluación comunicados fueron de aproximadamente 5.800 y 4.800 dólares, respectivamente.
Estos resultados corresponden a sistemas configurados. Antes de extraer conclusiones de la cifra principal, es necesario comprender el benchmark, el nivel de razonamiento, el arnés y las ejecuciones incompletas.
El anuncio de ARC Prize presenta las siguientes cifras:
| Benchmark y configuración | Puntuación comunicada | Coste de evaluación comunicado |
|---|---|---|
| ARC-AGI-1, mejor configuración comunicada | 98,5 % | Aproximadamente 0,16 dólares por tarea |
| ARC-AGI-2, mejor configuración comunicada | 91,3 % | Aproximadamente 0,32 dólares por tarea |
| ARC-AGI-3, Provider Adapter, razonamiento bajo | 97,5 % | Aproximadamente 4.800 dólares por la evaluación |
| ARC-AGI-3, Standard, razonamiento bajo | 49,8 % | Aproximadamente 5.800 dólares por la evaluación |
Las unidades de coste son distintas. Los importes de ARC-AGI-1 y ARC-AGI-2 son por tarea; los de ARC-AGI-3 corresponden a la ejecución de evaluación. No deben compararse en una misma escala de costes sin tener en cuenta esta diferencia.
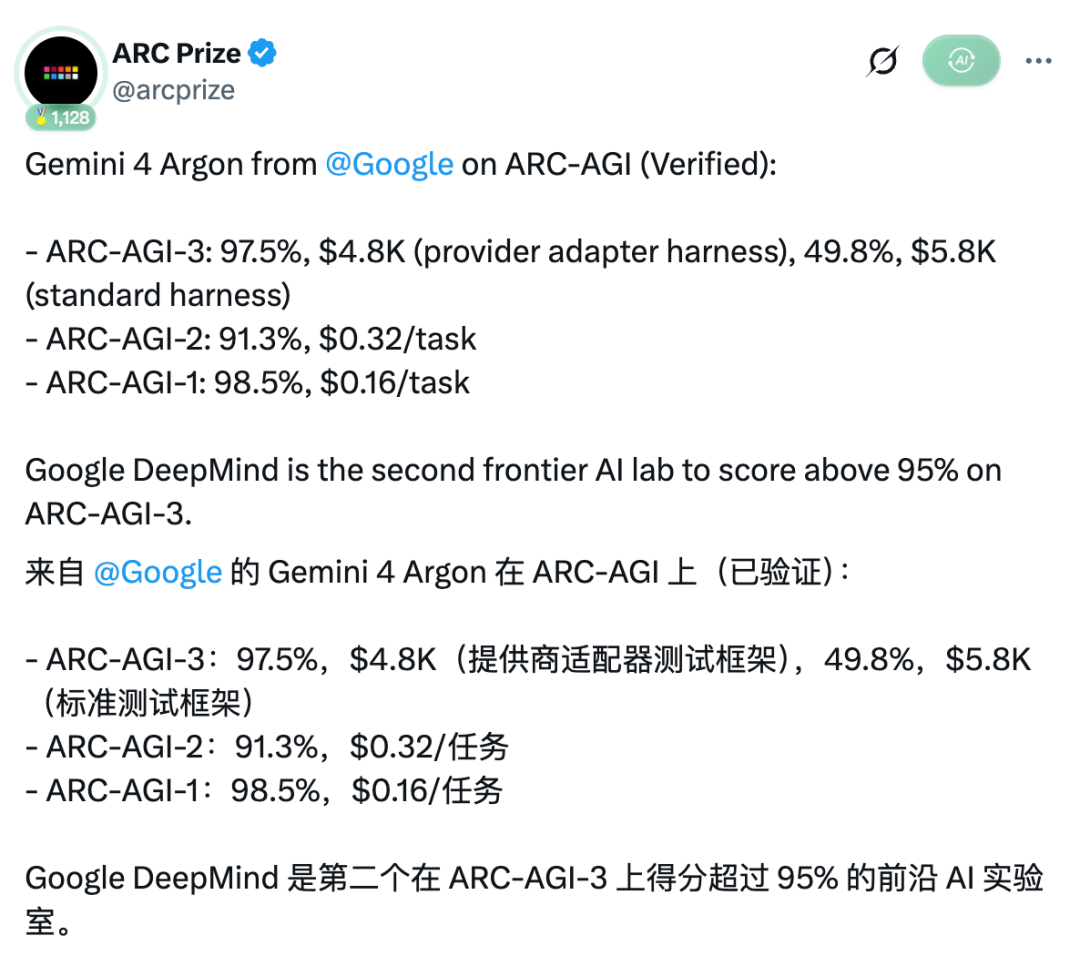
Anuncio de puntuaciones verificadas de ARC Prize, reproducido en el informe de origen.
La tabla en línea muestra costes más precisos para las mejores configuraciones: 0,162 dólares por tarea para ARC-AGI-1 y 0,325 dólares para ARC-AGI-2. Indica un 91,3 % para ARC-AGI-2, en consonancia con el anuncio, aunque el párrafo que acompaña a la página de resultados señala un 91,2 %. Este artículo conserva el valor anunciado y tabulado, y deja constancia de la discrepancia.
ARC-AGI-3 se diferencia de las dos primeras generaciones. En lugar de inferir una cuadrícula de salida a partir de ejemplos estáticos, un agente explora entornos interactivos desconocidos, descubre cómo funcionan las acciones y aprende a alcanzar objetivos sin instrucciones en lenguaje natural que expliquen el juego.
ARC Prize describe la prueba como una medida de la eficiencia de adquisición de habilidades, la adaptación y la planificación a lo largo del tiempo. Por tanto, su puntuación no equivale simplemente al «porcentaje de juegos ganados». Según la explicación del benchmark, una puntuación del 100 % corresponde a completar los juegos con la misma eficiencia que el referente humano.
La fuente describe el cambio desde puntuaciones inferiores al 1 % para los modelos de frontera alrededor del lanzamiento de ARC-AGI-3 en marzo hasta resultados cercanos al máximo más avanzado el año. Destaca el resultado anterior de GPT-6 Astra de OpenAI, seguido de la entrada de Gemini por encima del 95 %.
Se trata de un cambio sustancial en esta evaluación. No significa que el organizador haya probado todas las formas posibles de razonamiento ni que haya demostrado que cualquiera de los sistemas pueda aprender cualquier tarea nueva como lo haría una persona.
El informe también describe una gran eficiencia en el uso de acciones en 25 juegos públicos: un 62 % menos de acciones que el referente humano, tres juegos con resultados que igualaron o superaron récords de speedrun y seis con resultados a menos de un 10 % de esos récords. Estas comparaciones concretas son observaciones comunicadas por la fuente sobre el conjunto público; no deben generalizarse a las 55 tareas de evaluación ni a juegos arbitrarios.
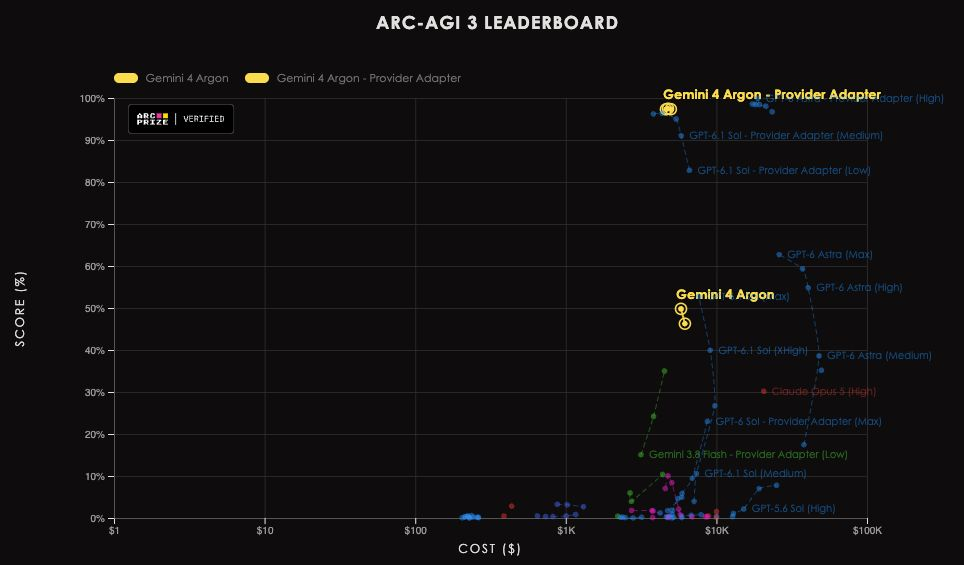
Captura de la clasificación conservada del informe; la página de resultados actual ofrece los detalles de configuración vigentes.
El arnés de un agente controla la interacción con un modelo: cómo recibe observaciones, cómo envía acciones, qué contexto se conserva y qué ocurre cuando una conversación se alarga.
ARC Prize define por separado las dos condiciones:
Para Gemini 4 Argon, los resultados en línea muestran lo siguiente:
| Nivel de razonamiento | Arnés Standard | Arnés Provider Adapter |
|---|---|---|
| Bajo | 49,8 % | 97,5 % |
| Medio | 46,3 % | 97,3 % |
| Alto | No hay un punto de comparación completo comunicado | 97,3 % |
La diferencia con razonamiento bajo es de 47,7 puntos porcentuales. Muestra que el sistema de interacción configurado afecta de forma sustancial al resultado medido, pero no permite aislar un único mecanismo causal. Es necesario considerar la gestión del contexto, las condiciones de ejecución, la fiabilidad de la API y otros ajustes, además de la etiqueta del arnés.
En particular, ARC Prize comunica que hubo problemas con la API que impidieron completar las evaluaciones Standard. Las ejecuciones con niveles bajo, medio y alto se completaron en 42, 46 y 19 de las 55 tareas, respectivamente. Las puntuaciones agregadas comunicadas incluyen las 55 tareas y conservan el crédito parcial de las ejecuciones incompletas; estos recuentos de tareas completadas no significan que se resolvieran por completo 42 o 46 juegos.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El punto incompleto de razonamiento alto con el arnés Standard se excluyó del gráfico. Por tanto, en esta evaluación, un mayor esfuerzo de razonamiento no dio lugar a una secuencia de resultados Standard comparables y completados de forma consistente.
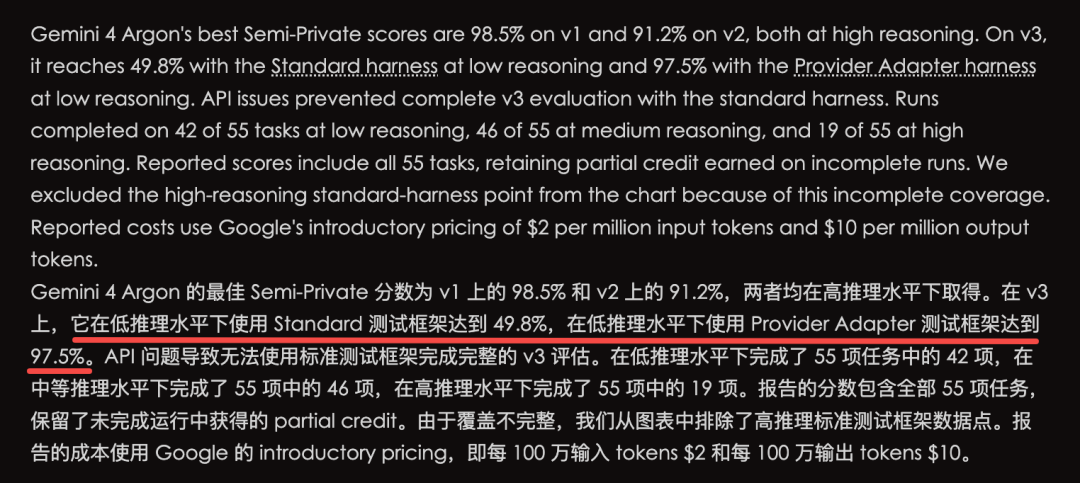
Nota sobre configuración y cobertura reproducida en el informe de origen; consulta la página de resultados en línea para ver las actualizaciones.
Las estimaciones de costes utilizan los precios iniciales de la API de Google, según ARC Prize: 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida. No son un precio fijo para resolver una nueva tarea del mundo real y pueden variar si cambian los precios o la configuración.
La principal lección práctica de la fuente es acertada: el nombre de un modelo y un único porcentaje no describen todo el sistema evaluado. Dos puntuaciones asociadas al mismo nombre de modelo pueden responder a preguntas distintas si sus interfaces de gestión del contexto son diferentes.
La política de ARC Prize indica expresamente que los dos arneses se comunican por separado porque abordan distintas preguntas de evaluación. Sus resultados verificados son evaluaciones realizadas por el organizador con una metodología publicada. Constituyen pruebas más sólidas que una diapositiva de proveedor sin respaldo, pero siguen estando limitados por la distribución de tareas y las condiciones probadas.
Para comparar estos resultados, conviene revisar en este orden la versión del benchmark, la configuración exacta del modelo, el nivel de razonamiento, el arnés, la cobertura de tareas, las reglas de puntuación y la unidad de coste. Así resulta más fácil distinguir una mejora real de una comparación entre experimentos diferentes.
El rendimiento cercano al máximo también plantea una pregunta de investigación: cuánto margen de mejora queda en una prueba. No hace desaparecer las limitaciones restantes ni convierte la expresión «benchmark de AGI» en una prueba de inteligencia general.
ARC Prize comunica un 97,5 % con el arnés Provider Adapter y razonamiento bajo. El resultado con el arnés Standard y razonamiento bajo fue del 49,8 %, bajo una condición de evaluación diferente y con ejecuciones incompletas.
No. ARC-AGI-3 mide el rendimiento mediante un sistema de puntuación basado en la eficiencia y puede otorgar crédito parcial. No debe traducirse directamente en un recuento de juegos completados por completo.
El arnés Standard es una interfaz mínima y neutral respecto al proveedor que conserva las notas seleccionadas por el modelo. Provider Adapter puede utilizar funciones de gestión del contexto específicas del proveedor, como conservar el estado del razonamiento y compactar conversaciones.
Las ejecuciones anunciadas con razonamiento bajo costaron aproximadamente 4.800 dólares con Provider Adapter y 5.800 dólares con el arnés Standard. ARC Prize indica que estas estimaciones utilizan los precios iniciales de los tokens; son costes totales de evaluación, no precios por tarea.
ARC Prize etiqueta los resultados como verificados y publica su política de evaluación y la página de resultados específica del modelo. Este artículo consultó esos registros, pero no volvió a ejecutar la evaluación ni reprodujo las puntuaciones de forma independiente.
Ningún benchmark por sí solo permite establecer esa conclusión. El resultado demuestra un rendimiento sólido en ARC-AGI-3 con la configuración del sistema indicada, pero se necesitan más pruebas para evaluar la fiabilidad y la generalización más allá de esas condiciones.
Los resultados verificados de Gemini 4 Argon en ARC-AGI muestran un rendimiento alto en pruebas estáticas e interactivas. La cifra principal del 97,5 % en ARC-AGI-3 corresponde a una configuración específica con razonamiento bajo y el arnés Provider Adapter, con un coste de evaluación comunicado de aproximadamente 4.800 dólares.
El resultado Standard, las ejecuciones incompletas y las diferencias en la gestión del contexto son esenciales para interpretar la comparación. Considera conjuntamente el modelo, el arnés y las condiciones de evaluación; el porcentaje por sí solo no demuestra una AGI.
Empieza con una sola frase y obtén un sitio completo en minutos.



