For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gemini-4-argon-launch-access-api-pricing-cf4e0dbb.md.
El [anuncio de Gemini 4 Argon de Google](https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-argon/...
El anuncio de Gemini 4 Argon de Google presenta un modelo orientado a trabajos complejos y prolongados: grandes cambios de código, creación visual, razonamiento científico y tareas que continúan más allá de un intercambio breve. El lanzamiento llega tanto a productos para desarrolladores como a experiencias de consumo, aunque las condiciones de acceso difieren entre ambos.
La historia práctica está en esos detalles. Los precios introductorios de la API tienen una fecha de finalización, el límite de un millón de tokens se comparte entre varios tipos de contenido y una mejora destacada de velocidad de software se aplica a una parte concreta de una carga de trabajo. Leer la documentación subyacente facilita mucho la evaluación del anuncio.
Google describe acceso de pago a la API a través de AI Studio y la plataforma Gemini, y la disponibilidad para desarrolladores también se extiende a Android Studio. Los suscriptores de Google AI Ultra reciben acceso a través de Antigravity y AI Studio, mientras que el despliegue en la aplicación Gemini para consumidores y en el modo AI de Search incluye a suscriptores de Google AI Pro y Ultra.
Estos son productos distintos con derechos de acceso diferentes. El acceso de Google AI Pro a una experiencia de consumo no implica automáticamente que el mismo plan incluya acceso para desarrolladores a Argon en AI Studio ni una cuota de API gratuita.
Para una integración, revise los requisitos actuales de acceso para desarrolladores en lugar de basarse en un titular general de lanzamiento. La página de precios de AI Studio identifica el modelo de API como gemini-4-argon y no muestra ningún nivel gratuito para él.
Según se verificó el 15 de octubre, la documentación de precios estándar de la API de Google establece dos períodos para Gemini 4 Argon. Los precios siguientes están expresados en dólares estadounidenses por cada millón de tokens.
| Categoría de tokens | Hasta el 30 de noviembre de 2026 | A partir del 1 de diciembre de 2026 |
|---|---|---|
| Entrada | $2.00 | $4.00 |
| Salida, incluido el razonamiento | $10.00 | $20.00 |
| Entrada almacenada implícitamente en caché | $0.10 | $0.20 |
Por tanto, las tarifas introductorias de entrada y salida del anuncio de lanzamiento son temporales, no precios permanentes. El precio de entrada almacenada en caché representa una reducción del 95 % respecto de la tarifa de entrada correspondiente, pero se aplica a entradas elegibles almacenadas implícitamente en caché; la página no indica que el almacenamiento explícito en caché sea compatible con este modelo.
Los precios por token tampoco describen necesariamente el coste total de una aplicación. Las herramientas con precios independientes y las solicitudes repetidas de un flujo de trabajo pueden añadir cargos, por lo que una estimación de producción debe reflejar el patrón real de solicitudes y la documentación vigente.
La documentación de decodificación larga de Google describe un límite unificado de 1.048.576 tokens compartido entre entrada, razonamiento y salida. No es la promesa de un millón de tokens de entrada más otro millón de tokens de salida generada.
La API de Interactions normalmente limita la salida síncrona o en streaming a 65.536 tokens. Generar más allá de ese límite requiere modo en segundo plano, una configuración más alta de max_output_tokens y almacenamiento habilitado según lo especificado en la documentación. El servidor realiza la generación más larga en saltos de continuación.
Dos detalles son importantes al planificar una tarea de este tipo. Primero, max_output_tokens incluye el razonamiento además de la salida devuelta. Segundo, los saltos de continuación pueden contabilizar nuevamente la entrada, con el descuento de caché implícita documentado cuando corresponda; la decodificación larga no es una extensión ilimitada y gratuita de una solicitud.
Esta capacidad puede ayudar con una implementación extensa o un análisis amplio, pero una gran asignación de salida no garantiza la corrección. El resultado sigue requiriendo revisión, y la entrada consume una parte del mismo presupuesto total.
Google informa haber utilizado Argon en una refactorización que involucraba cientos de archivos en Chrome, cuya base de código describe como de aproximadamente 40 millones de líneas, incluida un área heredada de cerca de seis millones de líneas. La empresa afirma que el trabajo pasó de ser una tarea de varios meses a una de varias semanas. Estos son resultados de proyecto informados por Google, no una promesa general sobre cambios en repositorios arbitrarios.
El artículo de ingeniería de ADK ofrece un caso más examinable. Trata de un repositorio de Python de unas 205.000 líneas distribuidas en aproximadamente 800 archivos fuente, respaldado por una amplia suite pública de pruebas.
El trabajo se llevó a cabo en dos rondas. Un primer intento de dos horas expuso deficiencias; una ejecución posterior durante la noche utilizó habilidades de proyecto y un objetivo de Antigravity. El modelo propuso seis optimizaciones en 32 archivos, pero los mantenedores conservaron dos y rechazaron cuatro. El trabajo final integrado combinó cambios de las rondas en 22 archivos y añadió 17 funciones de prueba.
Las optimizaciones aceptadas abordaron el filtrado antes de copiar datos en el servicio de sesiones en memoria y las importaciones diferidas de paquetes. El commit público integrado permite inspeccionar el código resultante.
El benchmark es útil porque separa varias mediciones de tiempo en vez de presentar una única mejora de velocidad como universal.
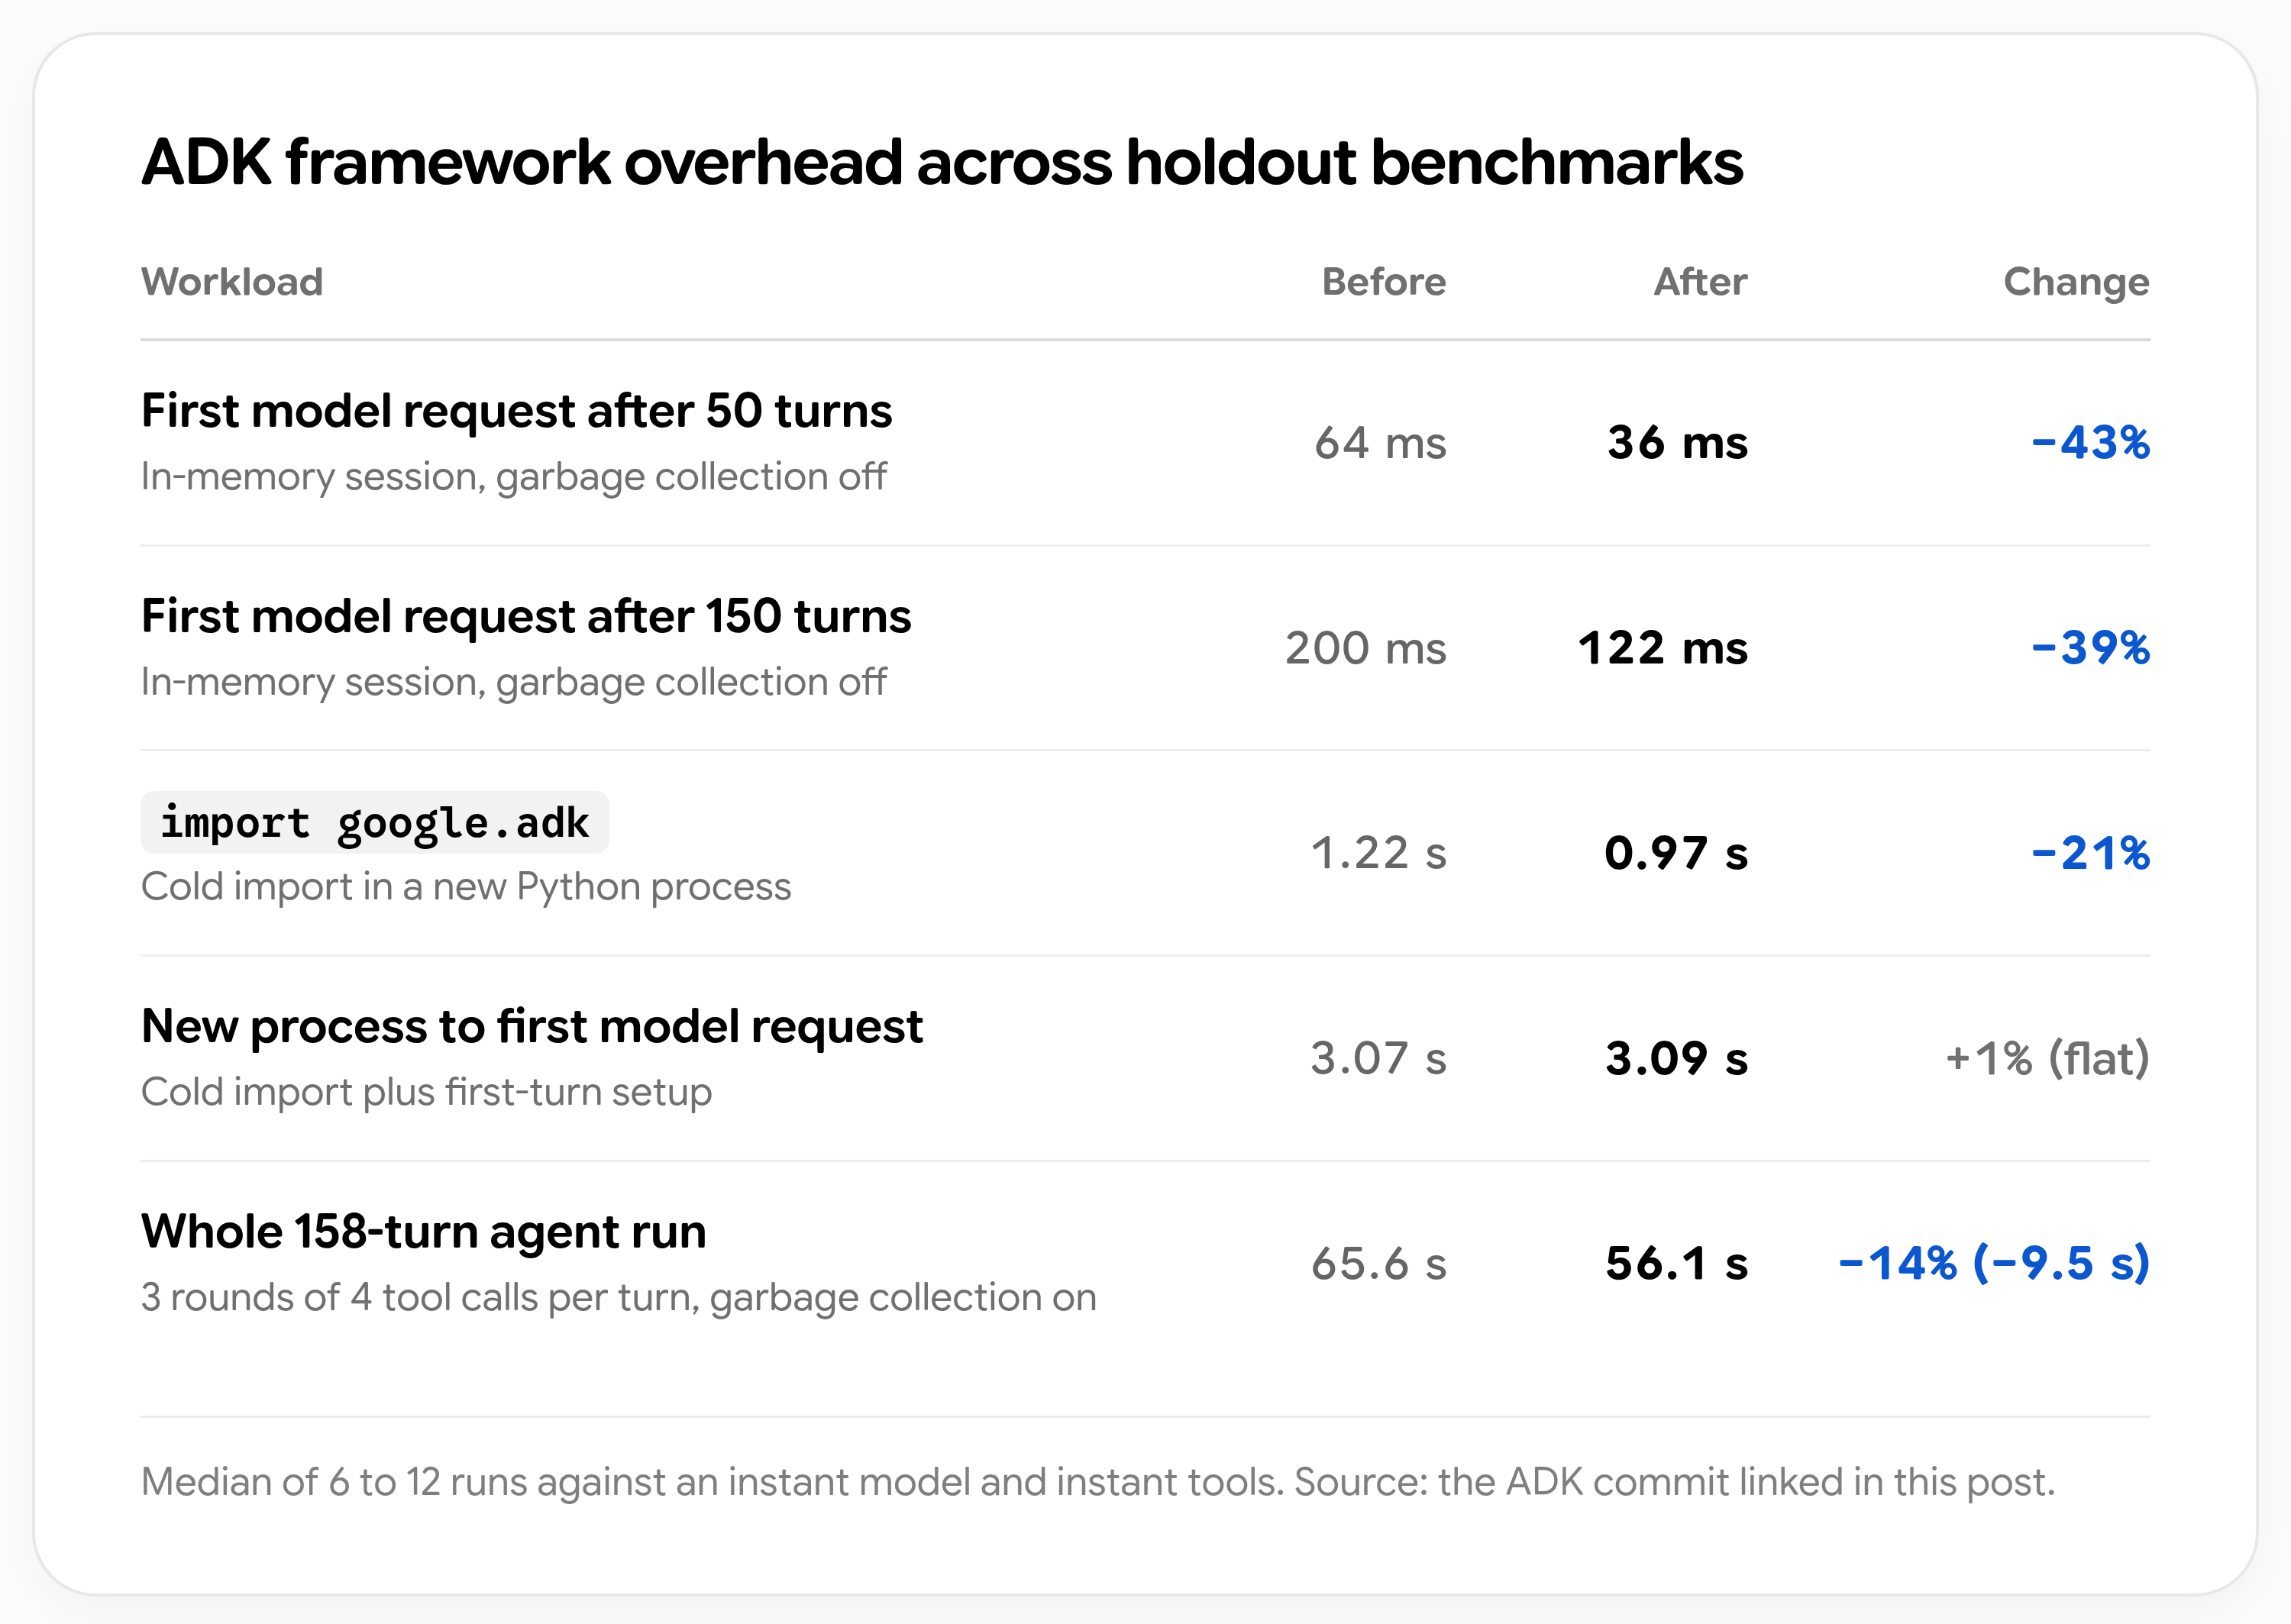
Fuente: Google Developers Blog, estudio de optimización de ADK. Las mediciones utilizan un modelo instantáneo y herramientas para aislar la sobrecarga del framework, con medianas de múltiples ejecuciones.
| Medición | Antes | Después | Cambio informado |
|---|---|---|---|
| Primera solicitud al modelo después de 50 turnos | 64 ms | 36 ms | 43 % más rápido |
| Primera solicitud al modelo después de 150 turnos | 200 ms | 122 ms | 39 % más rápido |
| Importación en frío | 1.22 s | 0.97 s | 21 % más rápido |
| Nuevo proceso hasta la primera solicitud | 3.07 s | 3.09 s | Prácticamente sin cambios |
| Ejecución completa de 158 turnos | 65.6 s | 56.1 s | 14 % más rápido |
La mejora de aproximadamente el 40 % se refiere a una ruta de preparación de sesiones en el servicio en memoria evaluado. No debe describirse como que hace que todas las aplicaciones ADK sean un 40 % más rápidas, especialmente cuando una implementación utiliza otro backend de almacenamiento o pasa la mayor parte del tiempo esperando respuestas del modelo y de las herramientas.
Las importaciones en frío mejoraron, pero el tiempo desde un nuevo proceso hasta la primera solicitud no lo hizo. Es un recordatorio práctico de medir el flujo de trabajo visible para el usuario en lugar de asumir que una optimización local mejora todas las métricas de extremo a extremo.
El cambio propuesto aprobó las 16.892 pruebas unitarias públicas, pero fallaron 25 objetivos de pruebas internas porque se esperaba que las importaciones eliminadas siguieran pudiendo aplicarse mediante parches. Los mantenedores abordaron la compatibilidad con accesores diferidos en lugar de tratar una ejecución exitosa de las pruebas públicas como evidencia suficiente de seguridad.
Se rechazaron otros cambios propuestos por motivos que incluían datos almacenados en caché obsoletos, dependencia de un atributo privado de OpenTelemetry, menor legibilidad sin un beneficio de extremo a extremo y una optimización cuya ganancia aparecía solo en una carga de trabajo sintética.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Esto hace que el ejemplo sea más útil que una historia de éxito de programación sin supervisión. El modelo produjo mejoras candidatas; los mantenedores evaluaron la evidencia, rechazaron parches inadecuados y corrigieron un problema de compatibilidad antes de integrar el trabajo aceptado.
Google también informa de una optimización de la inferencia de Gemma 4 E2B mediante vLLM en una NVIDIA A100. En esa configuración concreta, el rendimiento aumentó de 37.900 a 108.000 tokens por segundo, una mejora informada de 2,85 veces con paridad de tokens.
Se trata de un resultado específico de una configuración. No establece la misma mejora para un modelo, GPU, patrón de lotes o pila de implementación distintos, y no debe confundirse con el precio o la latencia de una solicitud a una API alojada de Argon.
Las demostraciones creativas del lanzamiento incluyen un templo tridimensional creado con Blender y crítica visual, además de una experiencia de carreras inspirada en la foto de un escritorio y ensamblada con varias herramientas. Esta última combina Blender MCP, texturas generadas, Three.js y capacidades multimedia adicionales, por lo que el artefacto terminado es el resultado de un flujo de trabajo y no evidencia de que una sola llamada de texto plano cree todos los recursos sin ayuda.
Estos ejemplos muestran los tipos de proyectos que Google quiere que los desarrolladores intenten. No sustituyen las pruebas directas de código generado, comportamiento físico, licencias de activos o rendimiento en un navegador.
El lanzamiento se extiende más allá de la ingeniería de software a varios dominios de investigación. Cada resultado aborda un problema más acotado de lo que podría sugerir el nombre de su campo.
La demostración de robótica sigue el mismo patrón. El robot Apollo de Google observa a una persona jugar cornhole, construye una simulación y luego logra siete aciertos consecutivos en el mundo real en la demostración informada. Eso es evidencia sobre la ejecución mostrada, no una estimación de fiabilidad para robots, entornos o tareas físicas arbitrarias.
Google afirma que los envíos internos de código aumentaron un 35 % y que las tasas de reversión disminuyeron aproximadamente un tercio. Son cifras internas comunicadas por la empresa; el artículo de lanzamiento no las presenta como una predicción controlada de lo que logrará otra organización.
El caso de ADK ofrece una forma más práctica de evaluar la afirmación más amplia. Comience con una tarea cuya referencia pueda medirse, mantenga pruebas y verificaciones de compatibilidad, y evalúe el parche final aceptado. El tiempo dedicado a revisar y corregir un cambio también forma parte del resultado.
En el trabajo de investigación, la pregunta correspondiente es si la salida supera la validación de dominio pertinente: una demostración, un experimento de laboratorio, un cálculo independiente o una evaluación cuidadosamente diseñada. Una explicación plausible del modelo es solo una etapa de ese proceso.
La página de precios de AI Studio revisada el 15 de octubre de 2026 no muestra ningún nivel gratuito para gemini-4-argon. El acceso mediante suscripción para consumidores y el acceso a la API para desarrolladores tienen condiciones diferentes, por lo que no debe suponerse que una función para consumidores de Google AI Pro incluya el modelo de API.
Las tarifas estándar introductorias documentadas son de $2 por millón de tokens de entrada y $10 por millón de tokens de salida, incluido el razonamiento, hasta el 30 de noviembre de 2026. A partir del 1 de diciembre, la página indica $4 y $20 respectivamente; la entrada elegible de caché implícita tiene un precio independiente y los cargos por herramientas pueden sumarse al total.
No. Google documenta un presupuesto compartido de 1.048.576 tokens para entrada, razonamiento y salida. Por tanto, una entrada más larga deja menos espacio para las demás partes de la interacción.
La documentación de decodificación larga requiere modo en segundo plano, almacenamiento y un valor de max_output_tokens superior al límite habitual. Los saltos de continuación siguen sujetos al presupuesto compartido y al comportamiento de facturación documentado, por lo que las aplicaciones deben seguir las instrucciones vigentes de la API de Interactions.
No. El resultado de aproximadamente el 40 % se refiere a una ruta específica de preparación de sesiones en memoria dentro del benchmark de Google. La ejecución completa de 158 turnos mejoró un 14 %, mientras que el tiempo desde un nuevo proceso hasta la primera solicitud prácticamente no cambió.
No. Los resultados informados se refieren a problemas de investigación y demostraciones definidos. Necesitan validación independiente apropiada, revisión de dominio y pruebas de implementación antes de generalizarse para usos clínicos, industriales o en el mundo físico.
Gemini 4 Argon aporta un amplio conjunto de capacidades comunicadas en código, proyectos visuales e investigación. Sus detalles prácticos inmediatos incluyen acceso de pago para desarrolladores, precios introductorios que terminan después de noviembre y un presupuesto de contexto compartido que incluye razonamiento y salida.
La evidencia de ingeniería más sólida procede de los cambios de ADK aceptados y probados, así como de sus límites medidos; la revisión humana sigue formando parte del resultado.
Empieza con una sola frase y obtén un sitio completo en minutos.



