For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/glm-5-3-highspeed-in-zcode-490-tps-test-1-df8d564e.md.
Un nuevo nombre de modelo de Z.ai ha aparecido discretamente dentro de ZCode: **GLM-5.3 Highspeed**.
Un nuevo nombre de modelo de Z.ai ha aparecido discretamente dentro de ZCode: GLM-5.3 Highspeed.
El modelo apareció en ZCode 3.15.1, donde algunos suscriptores están siendo seleccionados aleatoriamente para una prueba de HighSpeed. Un usuario, @leo114119, publicó una ejecución que mostraba una velocidad de salida cercana a 490 tokens por segundo, y otra captura indicaba aproximadamente 493 tok/s.
Es una cifra llamativa.
Si un modelo pudiera mantener 490 tokens de salida por segundo, generar 10.000 tokens de salida tomaría solo alrededor de:
10.000 / 490 ≈ 20,4 segundos
Ese cálculo solo cubre la fase de generación de tokens. No incluye el tiempo hasta el primer token, el razonamiento previo a la salida visible, las llamadas a herramientas, la sobrecarga de red ni las pausas dentro de un flujo de trabajo con agentes.
Más importante aún, el resultado de 490 TPS es actualmente una observación de la comunidad, no una garantía oficial de rendimiento de Z.ai.
Lo que sí está confirmado es que ZCode 3.15.1 ha introducido una prueba aleatoria de GLM HighSpeed para suscriptores y que el identificador glm-5.3-highspeed ya está presente en el catálogo público de modelos de Pi.
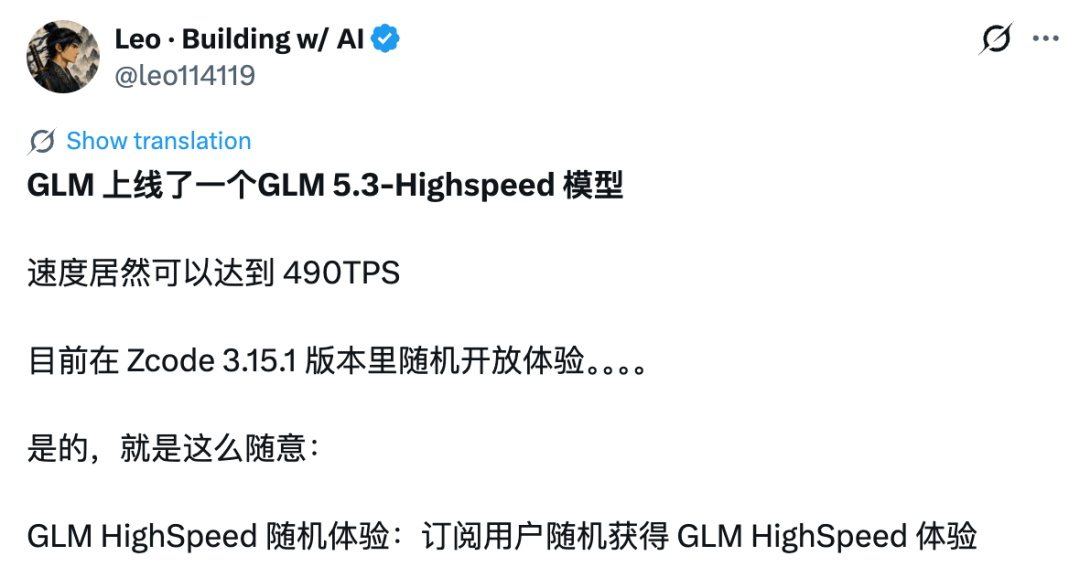
La primera pista no es solo una captura de pantalla de redes sociales.
Las notas oficiales de la versión 3.15.1 de ZCode indican:
Los suscriptores ahora pueden ser seleccionados aleatoriamente para una prueba de GLM HighSpeed.
Esta redacción importa porque explica por qué el acceso no es consistente de una cuenta a otra.
El artículo fuente informa que el autor intentó añadir y cambiar manualmente a GLM-5.3 Highspeed, pero no pudo utilizarlo con una suscripción Lite.
La interfaz mostraba que el modelo existía, pero el plan actual no incluía acceso.
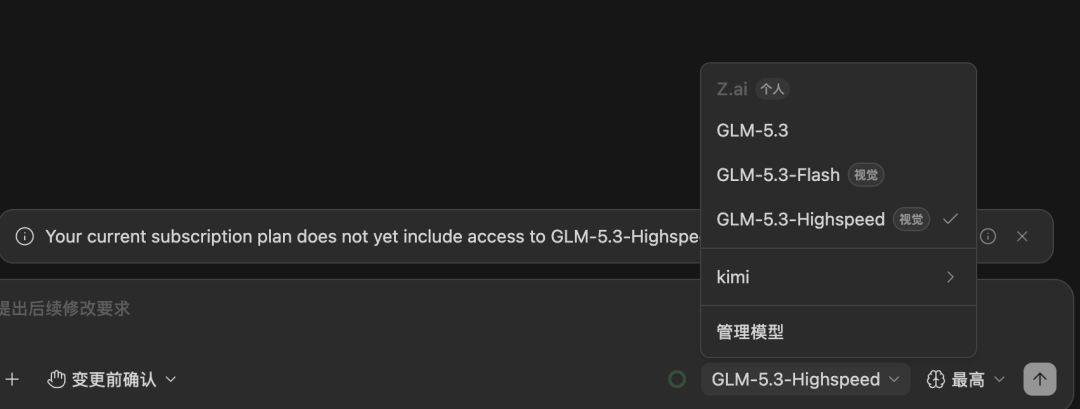
Esto es coherente con la estrategia actual de despliegue de ZCode:
Actualizar a ZCode 3.15.1
        ↓
Cuenta de suscriptor
        ↓
Elegibilidad aleatoria para la prueba HighSpeed
        ↓
El acceso de prueba aparece en el cliente si la cuenta es seleccionada
Actualmente no se describe como una función disponible automáticamente para todos los niveles de pago.
Una captura de la comunidad que resume la propia redacción de ZCode señala lo mismo: la experiencia HighSpeed es un beneficio asignado aleatoriamente a suscriptores, y el cliente es la fuente de referencia para saber si una cuenta concreta ha sido seleccionada.
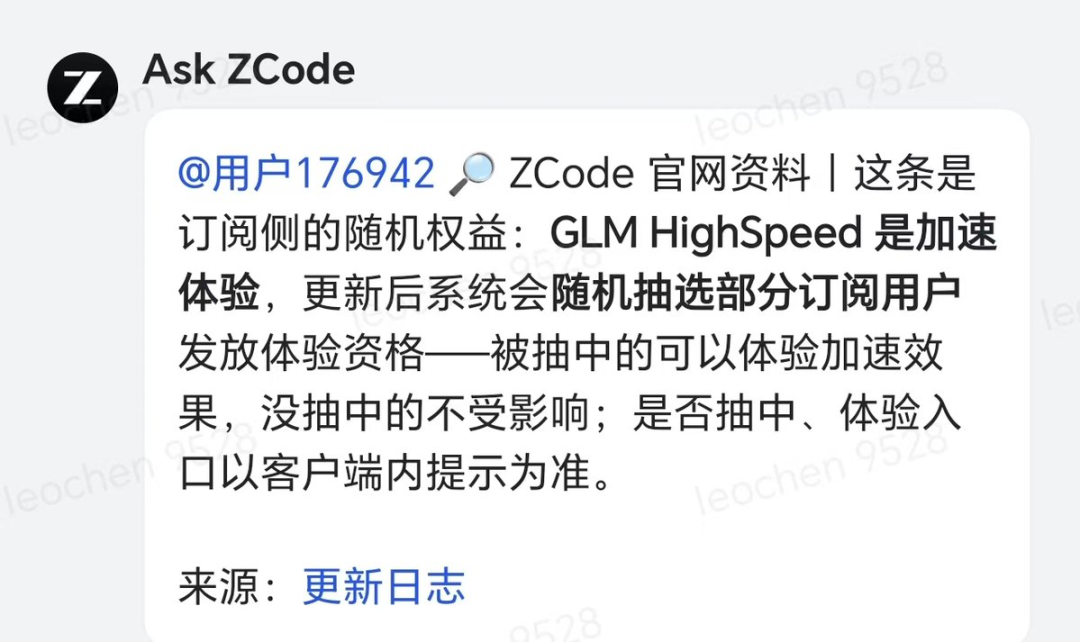
La principal razón por la que el modelo atrajo atención es la captura de velocidad.
El usuario fuente publicó una ejecución que mostraba aproximadamente 493 tok/s.
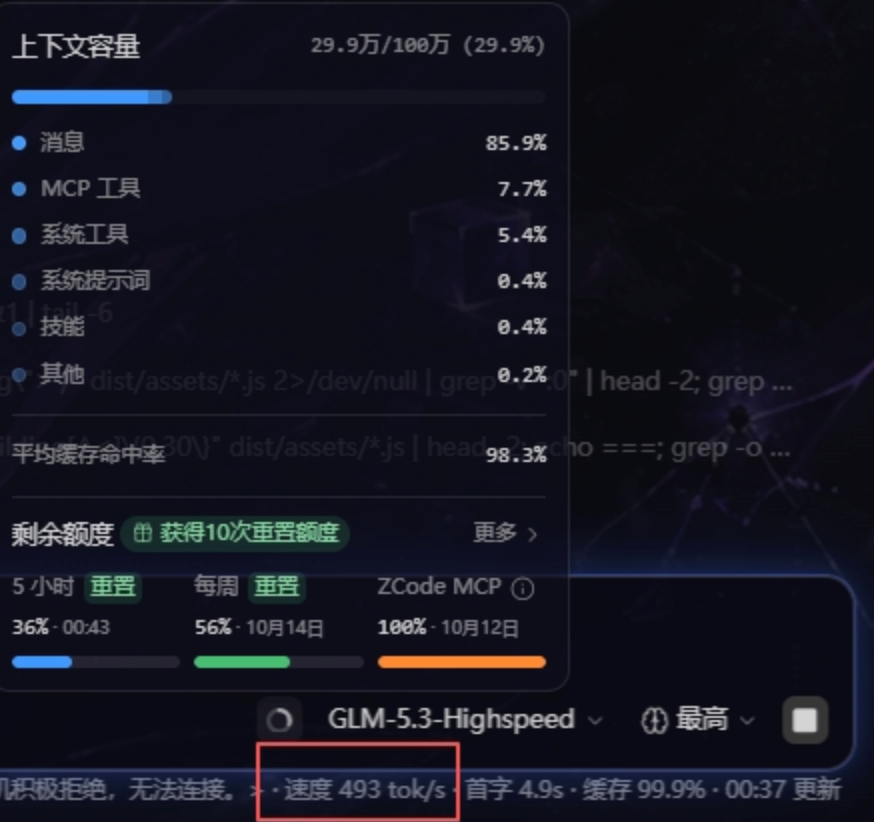
Esta cifra es lo suficientemente cercana a los 490 TPS del titular como para que la diferencia no sea significativa.
Sin embargo, es útil ser precisos sobre lo que esta captura nos dice y lo que no.
GLM-5.3-Highspeed.El rendimiento puede depender en gran medida de:
Por tanto, la conclusión correcta por ahora es:
GLM-5.3 Highspeed ha demostrado un rendimiento de salida muy alto en al menos una prueba pública de ZCode, pero Z.ai aún no ha publicado una especificación formal de 490 TPS.
La cifra destaca porque la familia GLM ya cuenta con varias opciones de servicio orientadas a la velocidad.
La documentación de Z.ai indica que GLM-5.3-FlashX puede alcanzar hasta 200 tokens/s. FlashX es la variante de servicio de alta velocidad de GLM-5.3-Flash.
La documentación de Pi y Z.ai enumera GLM-5.3-Flash con una ventana de contexto de 1M y una salida máxima de clase 128K, mientras que FlashX se centra en una menor latencia de servicio y una generación más rápida.
El artículo original también cita una medición de Artificial Analysis de aproximadamente 60 tokens/s para GLM-5.3-Flash en la API propia de Z.ai en el momento de redactarse.
Las mediciones independientes de rendimiento cambian con el tiempo, y las instantáneas posteriores han variado significativamente según el proveedor y la fecha, por lo que una única cifra no debe considerarse permanente.
Por ello, una comparación útil es la siguiente:
| Modelo / ruta de servicio | Velocidad informada o documentada | Estado |
|---|---|---|
| GLM-5.3 Highspeed en ZCode | ~490–493 tok/s en una captura de un usuario | Observación de la comunidad / prueba aleatoria |
| GLM-5.3-FlashX | Hasta 200 tok/s | Variante pública documentada orientada a la velocidad |
| GLM-5.3-Flash en la API de Z.ai | Mucho menor en instantáneas independientes de primera parte | La medición independiente varía por fecha/proveedor |
La diferencia es suficientemente grande como para que la gente quiera saber naturalmente qué significa realmente “Highspeed”.
glm-5.3-highspeedEl nombre del modelo no apareció solamente en ZCode.
El catálogo público de modelos de Pi ya cuenta con una página para GLM-5.3 Highspeed.
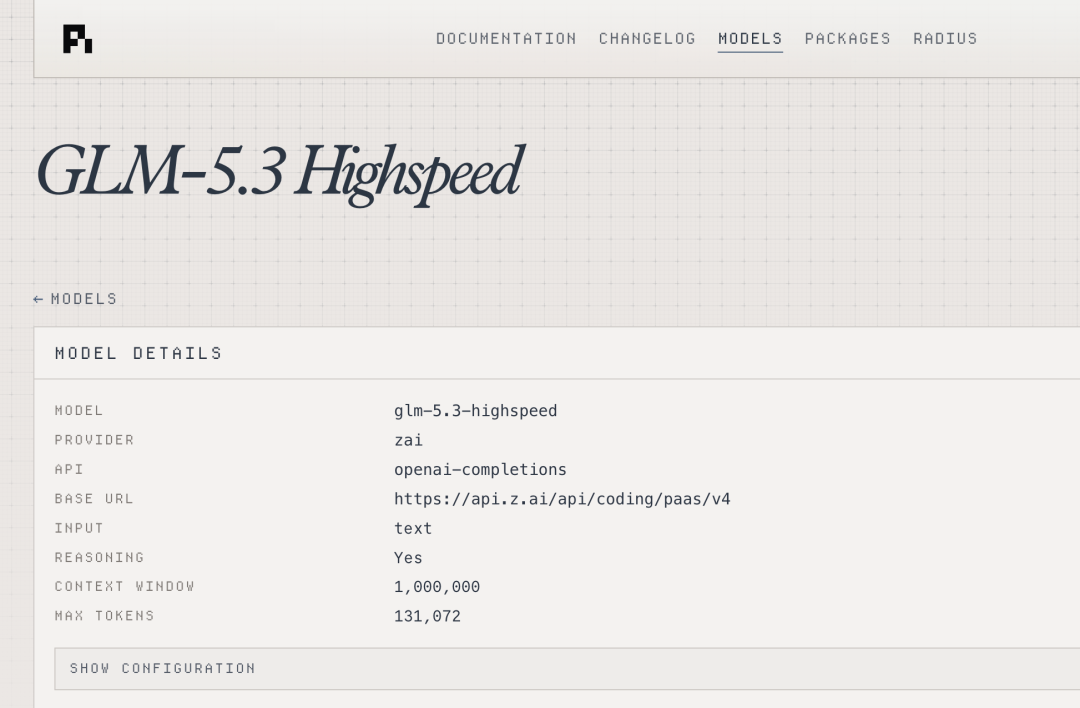
La configuración indicada es:
| Campo | Valor |
|---|---|
| ID de modelo | glm-5.3-highspeed |
| Proveedor | zai |
| Estilo de API | Completados compatibles con OpenAI |
| Entrada | Texto |
| Razonamiento | Sí |
| Ventana de contexto | 1.000.000 de tokens |
| Salida máxima | 131.072 tokens |
| Niveles de razonamiento | bajo / alto / máximo |
El endpoint mostrado por Pi es:
https://api.z.ai/api/coding/paas/v4
Pi también asigna el modelo al formato de API de programación de Z.ai.
Hay dos detalles especialmente destacables.
Esto coincide con la configuración de contexto largo presente en las herramientas actuales de la familia GLM-5.3.
Para agentes de programación, un contexto de 1M de tokens puede ser útil para:
Esto equivale aproximadamente a 128K tokens.
De nuevo, es coherente con la configuración actual de salida larga de varias entradas de la familia GLM-5.3.
Por tanto, el listado de Pi no sugiere una arquitectura de contexto claramente diferente de la línea GLM-5.3 normal.
Principalmente confirma que el identificador Highspeed es suficientemente real como para disponer de una configuración estructurada de proveedor.
Pi asigna tres configuraciones activas de razonamiento:
bajo
alto
máximo
El artículo fuente señala que estas configuraciones también son habituales en la configuración regular de GLM-5.3.
Esto nos da otro motivo para no asumir que Highspeed sea un modelo base completamente nuevo.
Podría ser:
Sin una ficha de modelo de Z.ai, esas posibilidades aún no pueden diferenciarse con confianza.
El nombre por sí solo no es suficiente.
Aquí es donde la historia se vuelve especulativa.
Antes de que aparecieran las capturas de ZCode, usuarios de Reddit ya habían detectado glm-5.3-highspeed en el catálogo de Pi y preguntaron si podría estar relacionado con Omen Alpha.
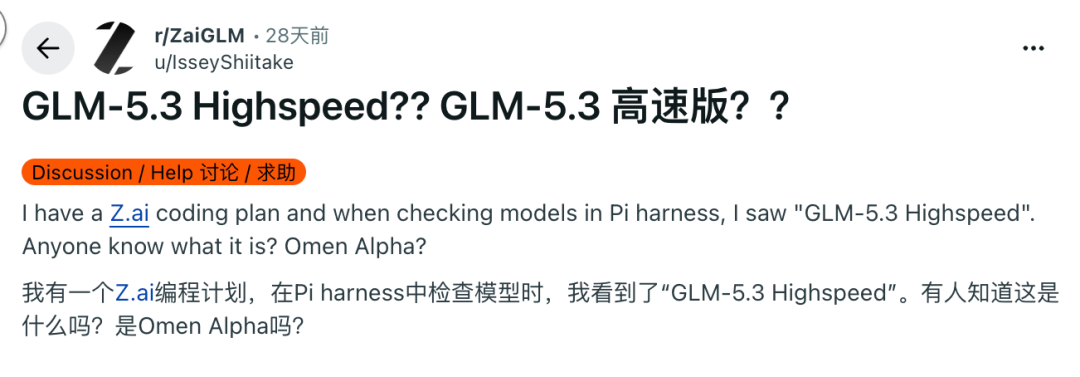
Omen Alpha es un modelo anónimo que apareció en pruebas de OpenCode.
Los miembros de la comunidad ya lo habían asociado con Zhipu/Z.ai basándose en el comportamiento observado y en pistas de infraestructura.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Una respuesta de Reddit especuló que podría ser una nueva variante GLM de alta velocidad, con una calidad cercana a GLM-5.3-Flash pero un rendimiento mucho mayor.
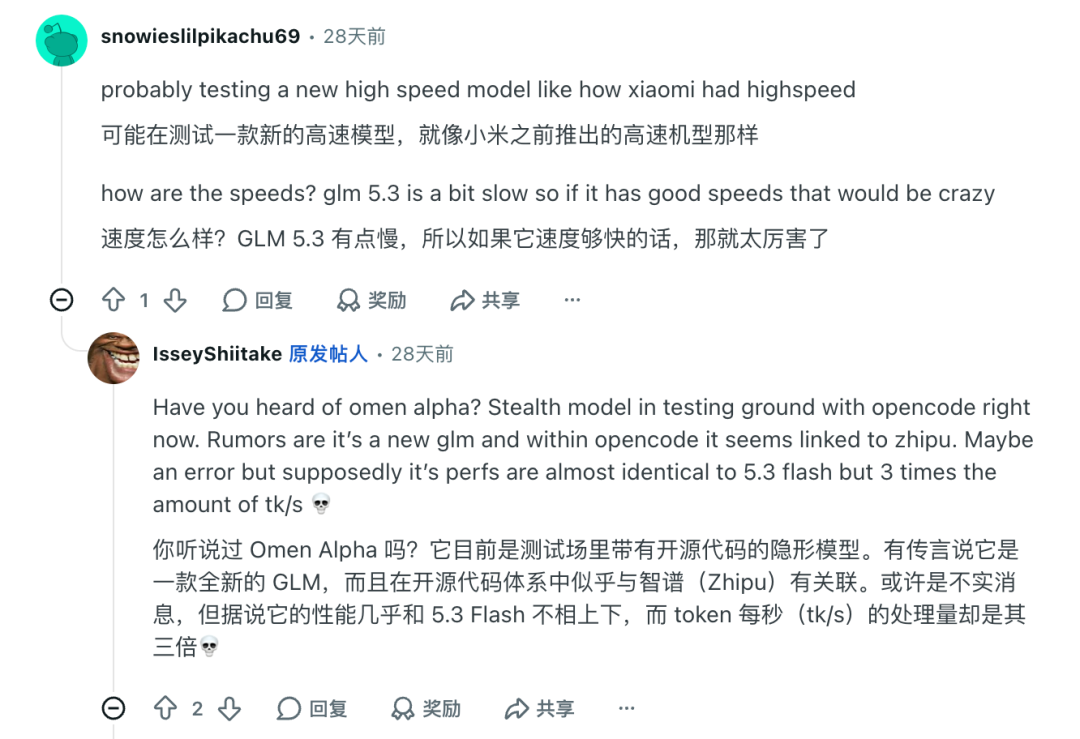
Otra captura de fuente muestra una entrada de modelo omen-alpha conectada a una etiqueta de proveedor relacionada con Zhipu, lo que alimentó la teoría.
Pero nada de esto establece la identidad de forma concluyente.
El artículo original enumera varias hipótesis:
Esos nombres deben permanecer en la categoría de especulación de la comunidad hasta que Z.ai publique una correspondencia oficial.
Dos endpoints pueden parecer muy similares aunque no sean el mismo modelo.
El comportamiento observado puede verse afectado por:
Por tanto, la similitud de comportamiento es evidencia, pero no una prueba.
El nombre en sí no es inusual para Zhipu.
La empresa ya ha lanzado anteriormente versiones de alta velocidad de modelos GLM.
El artículo fuente señala GLM-5.1-highspeed, que fue promocionado con una velocidad de salida cercana a 400 tokens/s en mayo de 2026.
La familia más reciente GLM-5.3 también cuenta con FlashX, una variante pública orientada a la velocidad documentada con hasta 200 tokens/s.
Esto sugiere un patrón de producto más amplio:
Modelo base o insignia
        ↓
Ruta de servicio de alta velocidad
        ↓
Menor latencia / mayor rendimiento para cargas de trabajo interactivas
Este patrón hace que un producto GLM-5.3 Highspeed sea técnicamente plausible, incluso sin asumir pesos de modelo nuevos.
Esto sigue siendo una inferencia, no una descripción oficial del producto.
¿Por qué preocuparse por 490 TPS?
Para una respuesta corta de 200 tokens, la diferencia entre 100 TPS y 500 TPS es de solo unos segundos.
Para salidas largas de agentes, generación de código o razonamiento extenso, la diferencia se vuelve mucho mayor.
Por ejemplo:
| Longitud de salida | 100 tok/s | 200 tok/s | 490 tok/s |
|---|---|---|---|
| 1.000 tokens | 10,0 s | 5,0 s | ~2,0 s |
| 5.000 tokens | 50,0 s | 25,0 s | ~10,2 s |
| 10.000 tokens | 100,0 s | 50,0 s | ~20,4 s |
Estos son cálculos simplificados únicamente del tiempo de decodificación.
Las tareas reales con agentes también incluyen:
Aun así, una decodificación más rápida puede hacer que los flujos de trabajo iterativos largos parezcan mucho más ágiles.
Esto es especialmente relevante en agentes de programación como ZCode, donde una solicitud de usuario puede generar varias llamadas al modelo en lugar de una única respuesta final.
La captura de ~493 tok/s también muestra una tasa de aciertos de caché extremadamente alta.
Vale la pena tenerlo en cuenta.
Una alta tasa de aciertos de caché puede reducir la cantidad de procesamiento repetido del prompt necesario en sesiones largas con agentes.
Una sesión de programación típica puede transportar repetidamente:
instrucciones del sistema
+ contexto del repositorio
+ definiciones de herramientas
+ conversación anterior
+ diferencias recientes
Si gran parte de ese contexto se reutiliza de manera eficiente, el sistema puede dedicar menos tiempo a recalcular el lado de entrada de cada turno.
Sin embargo, la cifra mostrada de tok/s suele referirse al rendimiento de generación de salida, y no únicamente al rendimiento de caché del prompt.
El número de caché sigue siendo importante porque la latencia global de la sesión puede parecer mucho mejor cuando tanto la reutilización de prompts como la decodificación rápida están funcionando adecuadamente.
Esta es otra razón por la que una única captura no puede caracterizar plenamente el modelo.
GLM-5.3-FlashX ofrece la comparación pública más clara porque la documentación de Z.ai ya lo describe como un modelo orientado a la velocidad.
La información publicada actualmente para FlashX incluye:
glm-5.3-flashx.Por tanto, FlashX demuestra que Z.ai ya está dispuesta a crear variantes dedicadas de alto rendimiento sin presentarlas como generaciones de inteligencia completamente nuevas.
GLM-5.3 Highspeed podría seguir la misma lógica de producto en un nivel de servicio aún más rápido.
Eso sigue siendo una inferencia, no una descripción oficial del producto.
La evidencia actual puede separarse en tres niveles de confianza.
glm-5.3-highspeed como un modelo de Z.ai.Esa distinción es la forma más segura de interpretar el despliegue actual.
GLM-5.3 Highspeed es un identificador de modelo de Z.ai que ha aparecido en ZCode y en el catálogo público de modelos de Pi. ZCode 3.15.1 confirma oficialmente una prueba aleatoria de GLM HighSpeed para suscriptores, pero Z.ai aún no ha publicado una ficha de modelo independiente y completa para GLM-5.3 Highspeed en las fuentes revisadas aquí.
Una captura pública de un usuario muestra aproximadamente 493 tok/s en una ejecución de ZCode, que es la base del titular de 490 TPS. Es una observación útil, pero no una garantía oficial de rendimiento sostenido, y puede variar según la carga de trabajo, el comportamiento de la caché, la región y las condiciones del servidor.
Pi lista actualmente una ventana de contexto de 1.000.000 de tokens y una salida máxima de 131.072 tokens para glm-5.3-highspeed. Estos valores son similares a la configuración de contexto largo de otros modelos actuales de la familia GLM-5.3.
No. El registro oficial de cambios de ZCode v3.15.1 indica que los suscriptores son seleccionados aleatoriamente para la prueba de GLM HighSpeed. Si su cuenta no ha sido seleccionada, ver el nombre del modelo no significa necesariamente que pueda ejecutarlo.
No existe confirmación oficial de que sean el mismo producto. FlashX es una variante pública de alta velocidad de GLM-5.3-Flash documentada con hasta 200 tok/s, mientras que GLM-5.3 Highspeed aparece actualmente mediante pruebas de ZCode y el catálogo de proveedores de programación de Pi.
Eso sigue siendo especulación. Usuarios de Reddit y OpenCode han vinculado Omen Alpha con Zhipu/Z.ai, pero no hay una fuente oficial que confirme que Omen Alpha se corresponda con glm-5.3-highspeed.
Los agentes de programación suelen realizar múltiples llamadas largas al modelo mientras leen archivos, escriben parches, ejecutan herramientas y revisan resultados. Un mayor rendimiento de decodificación puede reducir el tiempo de espera entre esos pasos, especialmente cuando el modelo genera miles de tokens por llamada.
Utilice el cliente actual de ZCode después de actualizar a una versión que incluya la prueba. Las propias notas de lanzamiento de ZCode indican que el acceso se asigna aleatoriamente a suscriptores, por lo que la interfaz de cuenta y cliente es la fuente práctica de referencia para la elegibilidad.
glm-5.3-highspeed.GLM-5.3 Highspeed ya no es solo un nombre de modelo aislado: ZCode 3.15.1 confirma oficialmente una prueba aleatoria de GLM HighSpeed para suscriptores, y Pi ya expone una configuración estructurada de glm-5.3-highspeed con una ventana de contexto de 1M de tokens y un límite de salida de 131.072 tokens.
La llamativa cifra de 490–493 tok/s procede de una captura pública real, pero sigue siendo una observación de un usuario en lugar de una garantía formal de rendimiento de Z.ai. La interpretación más prudente es que Z.ai está probando una ruta de servicio de programación muy rápida y aún no ha publicado la especificación completa del producto.
La conexión con Omen Alpha sigue sin resolverse. Podría resultar estar relacionada, pero la evidencia actual es circunstancial e impulsada por la comunidad, no oficial.
Lo que está confirmado hoy es el despliegue y el identificador del modelo; lo que aún no está confirmado es la arquitectura exacta, los precios públicos, el rendimiento sostenido y si Omen Alpha es el mismo modelo.
Empieza con una sola frase y obtén un sitio completo en minutos.



