For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gpt-5-6-sol-cerebras-750-tokens-per-second.md.
El pico reportado de 750 tokens por segundo del GPT-5.6 Sol demuestra cómo la inferencia de baja latencia puede cambiar el comportamiento pr...
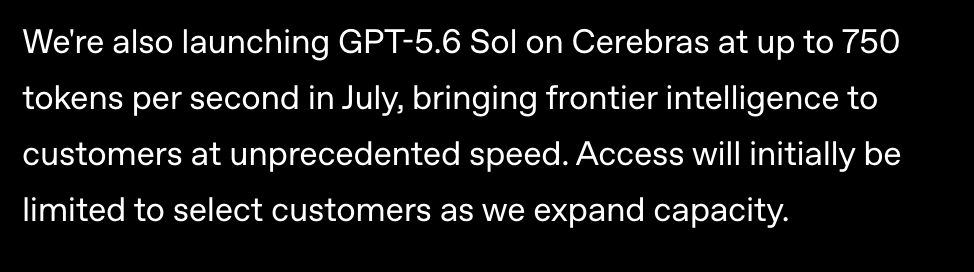
GPT-5.6 Sol está desplazando la conversación sobre los modelos frontera, dejando de centrarse únicamente en la capacidad para enfocarse en algo igualmente importante: la velocidad de respuesta.
OpenAI ha declarado que GPT-5.6 Sol puede ejecutarse en la infraestructura de Cerebras a hasta 750 tokens por segundo. A esa velocidad, un sistema de IA ya no se siente como una herramienta que se detiene tras cada acción. Los agentes de codificación, los operadores de navegadores, los asistentes de investigación y los sistemas de uso informático pueden avanzar a través de flujos de trabajo de múltiples pasos con mucho menos tiempo de espera entre decisiones.
La cifra principal es oficial. Sin embargo, muchos de los detalles arquitectónicos que se discuten a su alrededor no lo son. Las estimaciones de que el modelo contiene aproximadamente tres billones de parámetros, abarca de 70 a 100 sistemas a escala de oblea o asigna una capa de red a cada oblea provienen de análisis técnicos externos, no de una especificación publicada por OpenAI.
Este artículo mantiene clara esa distinción. Explica lo que se ha confirmado, lo que sigue siendo una teoría de ingeniería plausible y por qué la combinación de GPT-5.6 y la inferencia a escala de oblea es importante para la IA en tiempo real.
Un rendimiento de 750 tokens por segundo es difícil de apreciar hasta que se compara con la forma en que las personas usan realmente los sistemas de IA.
Una respuesta larga que antes aparecía línea por línea ahora puede generarse casi de inmediato. Más importante aún, el modelo puede avanzar mucho más rápido a través del razonamiento interno, las llamadas a herramientas, la generación de código, las acciones en la interfaz y las decisiones de seguimiento. El beneficio no es simplemente que el texto llegue antes. Todo el bucle del agente se vuelve más receptivo.
Ese cambio es importante en flujos de trabajo como:
Para el chat convencional, un breve retraso puede ser aceptable. Para un agente que debe hacer clic en un botón, inspeccionar el resultado, revisar su plan y continuar, cada ciclo de ida y vuelta añade fricción. La inferencia de alta velocidad reduce esa latencia acumulada.
El desarrollador Caleb Shepherd destacó esta distinción en el debate en torno a GPT-5.6 Sol. La ganancia más importante no es solo una generación de código más rápida, sino un uso informático más rápido: un agente ya no debería necesitar minutos para completar una secuencia de acciones simples de interfaz.
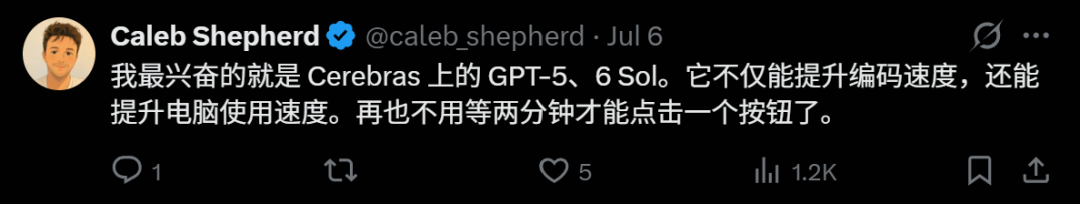
La afirmación sobre la velocidad planteó de inmediato una pregunta técnica: ¿cómo puede un modelo multimodal de frontera ejecutarse tan rápido en hardware a escala de oblea?
La documentación pública de OpenAI describe a GPT-5.6 Sol como el modelo de frontera en la familia GPT-5.6, con entrada de texto e imágenes, una ventana de contexto de 1.050.000 tokens y hasta 128.000 tokens de salida. No publica el número de parámetros del modelo, el número de parámetros activos, el número de capas, el diseño de atención ni la topología de despliegue físico.
Esa falta de información llevó a desarrolladores y especialistas en infraestructura a trabajar hacia atrás a partir de lo que se sabe sobre el hardware de Cerebras.
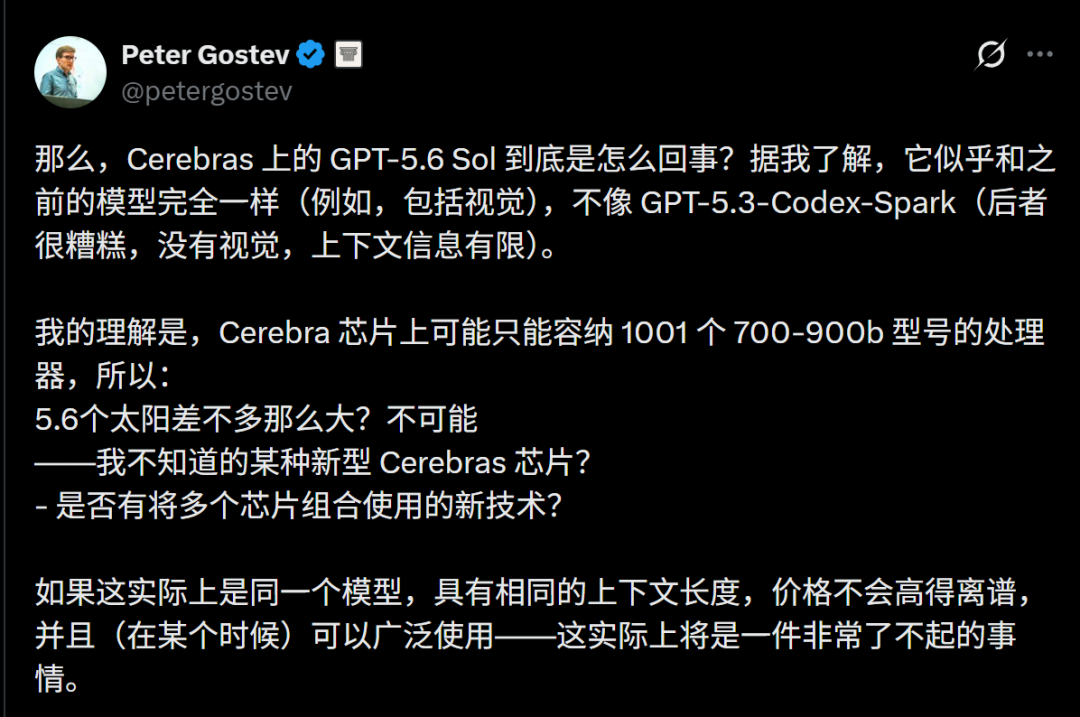
Peter Gostev resumió el problema central: si GPT-5.6 Sol es el modelo multimodal completo y no una variante reducida, podría ser demasiado grande para caber dentro de un solo sistema a escala de oblea. Las posibilidades restantes incluyen un modelo más pequeño de lo esperado, una nueva configuración de hardware o una arquitectura de servicio multisistema.
Una estimación ampliamente discutida provino del experto técnico Bleys Goodson. Su análisis propuso que GPT-5.6 Sol podría tener:
Estas cifras no son una especificación oficial. Son una estimación de ingeniería basada en restricciones de servicio del modelo, requisitos de memoria y la capacidad conocida de los clústeres de Cerebras de distribuir modelos muy grandes en múltiples sistemas.
La parte sorprendente de la teoría no es simplemente el número de obleas. Es la propuesta de mapeo entre la arquitectura del modelo y el hardware.
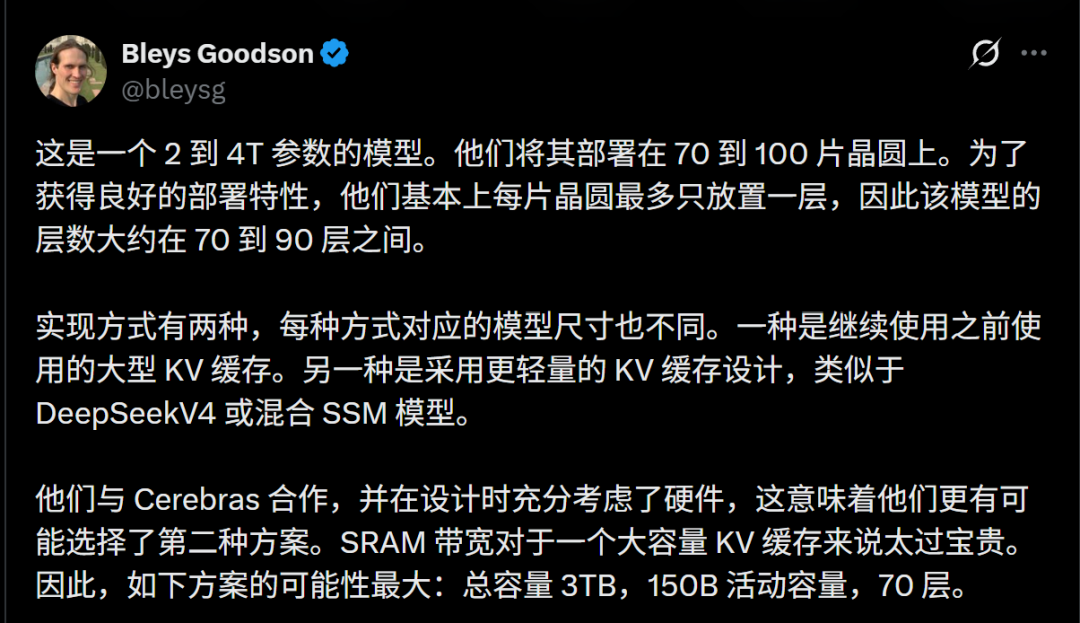
El diseño propuesto asigna a cada capa principal de la red su propio sistema a escala de oblea. Las activaciones se moverían a través de las obleas como un pipeline, mientras cada oblea realiza el cálculo asignado a su capa.
En un despliegue convencional de GPU distribuidas, la ejecución del modelo puede implicar paralelismo tensorial complejo, paralelismo de expertos y comunicación frecuente entre nodos. La sobrecarga de comunicación puede convertirse en un grave cuello de botella, especialmente cuando el modelo es grande y el objetivo es baja latencia en lugar de máximo rendimiento por lotes.
Un pipeline de una capa por oblea adopta un enfoque diferente. Una vez que el pipeline está lleno, se pueden procesar múltiples tokens en diferentes etapas al mismo tiempo. Agregar etapas puede aumentar la
retraso antes de que aparezca el primer token, pero no necesariamente reduce la tasa de transferencia sostenida de tokens en la misma proporción.
Esto ayuda a explicar cómo un modelo extremadamente grande podría mantenerse rápido después de que comience la generación. También explica por qué la implementación puede ser costosa: alcanzar una alta velocidad secuencial podría requerir dedicar una cantidad muy grande de hardware a una sola réplica del modelo.
El artículo fuente cita una estimación externa de tokenómica que modela GPT-5.6 Sol como un sistema de tres billones de parámetros que requiere alrededor de 70 sistemas a escala de oblea bajo un conjunto de supuestos.
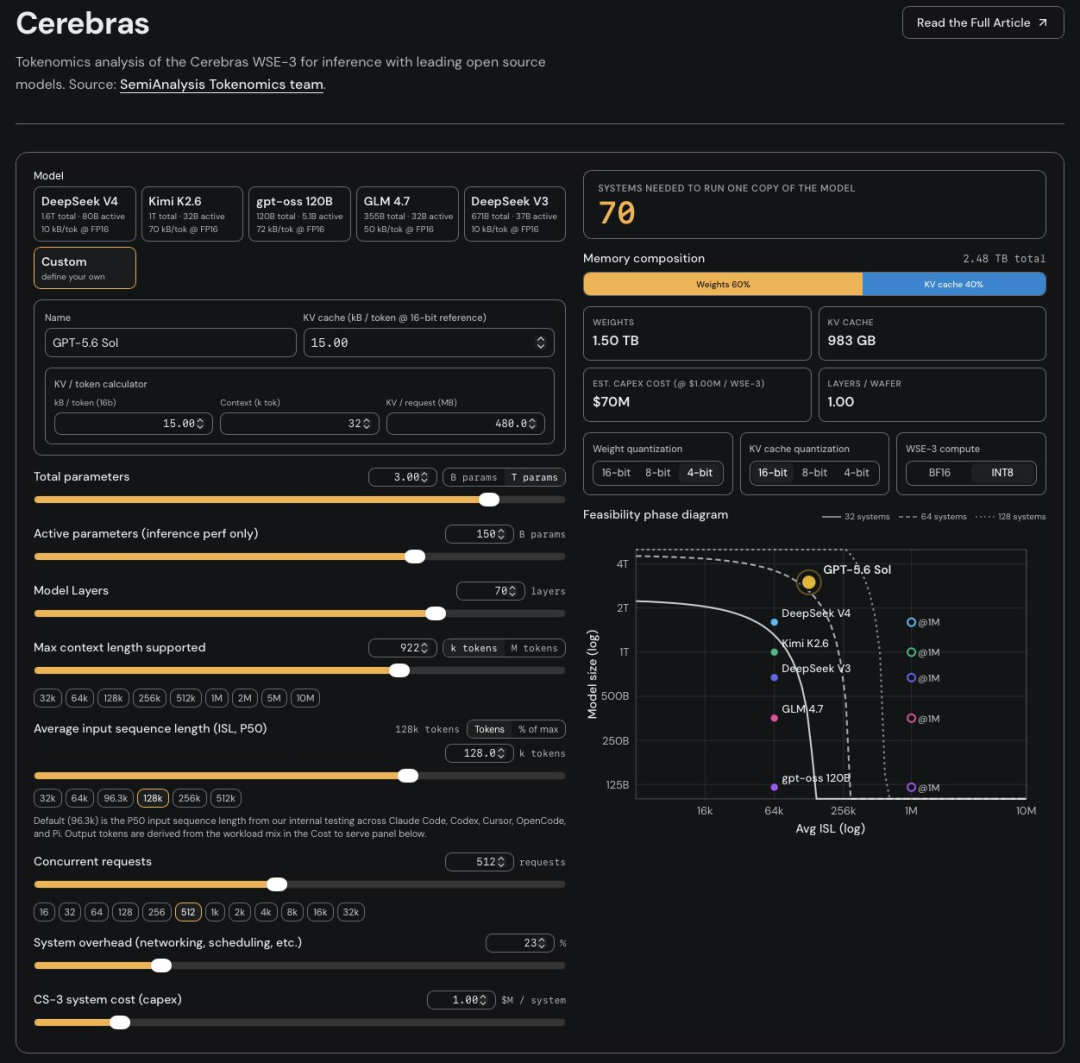
Importante: La estimación de 70 a 100 obleas y la descripción de "una oblea por capa" siguen siendo especulaciones informadas. OpenAI y Cerebras no han confirmado públicamente esta topología física.
La computación es solo parte del problema. Los modelos autorregresivos también mantienen un caché de clave-valor, comúnmente llamado caché KV, para poder reutilizar información de tokens anteriores en lugar de recalcular toda la secuencia.
Para modelos de contexto largo, este caché puede consumir una gran cantidad de memoria. El desafío se vuelve más severo cuando el sistema debe soportar muchas solicitudes concurrentes.
Los procesadores a escala de oblea de Cerebras incluyen grandes cantidades de SRAM rápida en el chip. Esta memoria proporciona un ancho de banda excepcional, pero sigue siendo un recurso limitado y valioso. Una arquitectura de atención convencional con una gran huella de caché KV podría consumir demasiada capacidad y reducir las ventajas de mantener el trabajo cerca del procesador.
Esto lleva a la teoría de que GPT-5.6 Sol podría usar una arquitectura diseñada en torno a requisitos de caché más bajos. Las posibilidades discutidas en la fuente incluyen:
El diseño exacto se desconoce. OpenAI no ha publicado suficientes detalles arquitectónicos para determinar cuál, si es que se usa alguno, de estos métodos.
Lo que se puede decir con confianza es que el co-diseño de hardware y software se vuelve cada vez más importante a esta escala. Un modelo optimizado solo para clústeres de aceleradores genéricos podría dejar un rendimiento significativo sin utilizar en un sistema a escala de oblea.
Otra hipótesis es que diferentes hardwares podrían manejar diferentes partes del modelo.
La inferencia de Transformer está dominada por dos grandes categorías de trabajo:
parámetros
El desarrollador John Lam sugirió que los aceleradores convencionales podrían manejar la atención, mientras que los sistemas Cerebras procesarían las capas de la red feed-forward. Esta descomposición atención-FFN podría asignar cada carga de trabajo a la arquitectura de hardware más adecuada para ella.
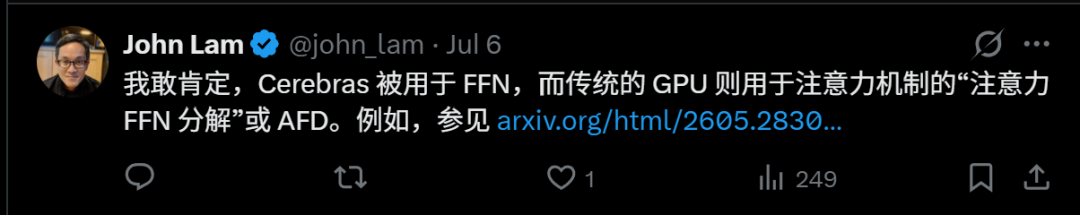
Nuevamente, esto es una hipótesis, no un detalle revelado del despliegue de GPT-5.6. Es técnicamente relevante porque los sistemas de inferencia heterogéneos se están volviendo más prácticos. En lugar de esperar que un acelerador realice todas las operaciones igual de bien, los proveedores pueden dividir un modelo entre sistemas especializados de cómputo, memoria y redes.
El costo es una mayor complejidad del sistema. La programación, la transferencia de activaciones, el manejo de fallos y el control de latencia se vuelven más difíciles cuando una solicitud atraviesa múltiples tipos de hardware.
Cerebras ya ha demostrado que los sistemas a escala de oblea pueden servir modelos de mezcla de expertos muy grandes a una velocidad inusualmente alta.
En su material oficial sobre Kimi K2.6, Cerebras describe un modelo de pesos abiertos de un billón de parámetros servido a cerca de 1,000 tokens por segundo. La empresa afirma que los pesos del modelo pueden distribuirse entre múltiples obleas mientras las activaciones fluyen entre ellas. También describe el almacenamiento de pesos originales con menor precisión mientras se computa con mayor precisión, respaldado por kernels personalizados y decodificación especulativa.
Esta es una evidencia importante de que la inferencia con múltiples obleas es real y operativa. No prueba que GPT-5.6 Sol use la misma configuración, la misma estrategia de precisión o la misma partición del modelo.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
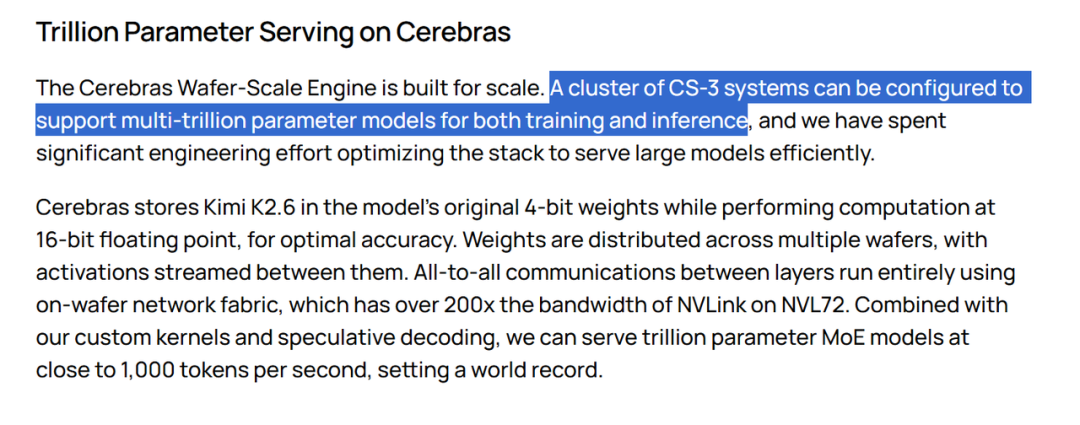
El despliegue de Kimi sí muestra por qué Cerebras es relevante para la estrategia de latencia de OpenAI. Los sistemas a escala de oblea se construyen en torno a un ancho de banda extremadamente alto en el dispositivo y una dependencia reducida de la comunicación entre muchos paquetes de aceleradores separados.
El anuncio de asociación de OpenAI en enero de 2026 indicó que la empresa planeaba agregar 750 MW de cómputo Cerebras de latencia ultrabaja. El objetivo era sencillo: reducir la latencia de inferencia y hacer que la IA interactiva se sintiera más inmediata.
OpenAI inicialmente describió la versión respaldada por Cerebras de GPT-5.6 Sol como un despliegue limitado para clientes seleccionados mientras se expandía la capacidad.
Esa limitación es comprensible. Un despliegue que dedique decenas de sistemas a escala de oblea a cada réplica del modelo sería costoso, con capacidad limitada, y
difícil de escalar instantáneamente. Por lo tanto, el acceso de alta velocidad puede posicionarse primero para cargas de trabajo donde la latencia tiene un valor comercial directo.
Los ejemplos incluyen:
La documentación actual de GPT-5.6 de OpenAI enumera Sol, Terra y Luna en los productos compatibles y el acceso a la API. La configuración especial de 750 tokens por segundo respaldada por Cerebras aún puede tener restricciones de capacidad, elegibilidad o enrutamiento separadas del acceso estándar a GPT-5.6.
La asociación con Cerebras se enmarca dentro de una estrategia de infraestructura más amplia de OpenAI.
En junio de 2026, OpenAI y Broadcom presentaron oficialmente Jalapeño, el primer Procesador de Inteligencia de OpenAI. Es un acelerador personalizado diseñado desde el principio para la inferencia moderna de LLM, en lugar de un procesador de propósito general adaptado de cargas de trabajo más antiguas.
Según OpenAI, el chip se basó en la hoja de ruta de modelos de la empresa, los kernels, los sistemas de servicio, el movimiento de memoria, los requisitos de red y las necesidades del producto. Broadcom contribuye con la implementación del silicio y la experiencia en redes, mientras que Celestica respalda la integración a nivel de placa y rack.
OpenAI también afirma que el primer chip pasó del diseño inicial a la fabricación (tape-out) en nueve meses, con la ayuda de modelos de IA en partes del proceso de diseño y optimización.
Ya se han confirmado varios puntos:
Jalapeño no hace que la asociación con Cerebras sea innecesaria. En cambio, ambos esfuerzos pueden entenderse como complementarios. Cerebras le da a OpenAI acceso a una arquitectura de latencia ultrabaja establecida, mientras que Jalapeño le brinda un mayor control a largo plazo sobre su propia pila de inferencia.
El cambio más amplio es claro: las empresas de IA de frontera ya no tratan el hardware como una capa neutral debajo del modelo.
OpenAI ahora trabaja en:
Esto permite a la empresa optimizar la pila en torno a un objetivo compartido. Un cambio en la arquitectura del modelo puede reducir la presión sobre la memoria. Se puede diseñar un chip en torno a los kernels más comunes del modelo. Se puede elegir la red según los patrones de movimiento de activaciones y parámetros que más importan. Los sistemas de servicio pueden entonces traducir esas ganancias en menor latencia o menor costo.
El resultado es un bucle de retroalimentación:
Los modelos capaces crean mejores productos y más uso.
5. Un mayor uso financia la próxima generación de infraestructura.
Por lo tanto, la configuración de GPT-5.6 Sol a 750 tokens por segundo es más que una demostración de velocidad. Es un ejemplo de modelo, hardware, redes y software de servicio diseñados como un solo sistema.
Es esencial tratar estas categorías por separado. Las ideas especulativas son técnicamente plausibles y útiles para entender el problema de diseño del sistema, pero no deben presentarse como especificaciones oficiales de GPT-5.6.
GPT-5.6 Sol es el modelo frontera de la familia GPT-5.6 de OpenAI. OpenAI lo posiciona para trabajos profesionales complejos en codificación, investigación, uso de computadoras, ciencia, ciberseguridad y otros flujos de trabajo agénticos exigentes.
OpenAI ha anunciado una configuración de GPT-5.6 Sol respaldada por Cerebras capaz de funcionar a hasta 750 tokens por segundo. La velocidad real de la aplicación aún puede variar según el tamaño del prompt, el uso de herramientas, la configuración de razonamiento, la latencia de la red y la capacidad.
Ese número proviene de estimaciones técnicas externas, no de una divulgación oficial de la arquitectura. OpenAI y Cerebras no han confirmado el número de obleas del modelo ni su diseño de despliegue físico exacto.
Describe un pipeline donde cada sistema a escala de oblea contiene y computa una capa principal del modelo, pasando activaciones a la siguiente etapa. El diseño podría mantener un alto rendimiento de tokens después de llenar el pipeline, pero sigue siendo una teoría sobre GPT-5.6 Sol, no un hecho confirmado.
La caché KV crece con la longitud del contexto, la arquitectura del modelo, el tamaño del lote y los usuarios concurrentes. Incluso la memoria en el chip muy rápida tiene capacidad limitada, por lo que reducir el tamaño de la caché y el movimiento de memoria puede ser esencial para un servicio de baja latencia.
Cerebras puede ser sustancialmente más rápido para ciertas cargas de trabajo de inferencia porque su arquitectura a escala de oblea ofrece un alto ancho de banda en el dispositivo y evita parte de la sobrecarga de comunicación.
encontrados en sistemas multi-GPU. El rendimiento sigue dependiendo del modelo, tamaño de lote, precisión, contexto y configuración de servicio.
Jalapeño es el primer procesador de inteligencia personalizado de OpenAI, desarrollado conjuntamente con Broadcom para la inferencia de LLM. OpenAI afirma que forma parte de una plataforma informática completa de múltiples generaciones y está diseñado para mejorar el rendimiento, la eficiencia y la escalabilidad.
Sí. La documentación de la API de OpenAI enumera GPT-5.6 Sol e identifica gpt-5.6 como un alias que dirige al nivel Sol. La disponibilidad, los límites de velocidad, los precios y las funciones compatibles dependen de la cuenta del desarrollador y de los términos actuales de la API.
El pico informado de 750 tokens por segundo de GPT-5.6 Sol muestra cómo la inferencia de baja latencia puede cambiar el comportamiento práctico de los agentes de IA. La mejora más importante no es solo un texto más rápido, sino retrasos más cortos en ciclos repetidos de razonamiento, uso de herramientas, codificación y control de computadora.
Cerebras ya ha demostrado que los sistemas de oblea pueden servir modelos de un billón de parámetros a casi 1000 tokens por segundo. Eso hace que una implementación grande de múltiples obleas de GPT-5.6 sea plausible, pero los recuentos de parámetros, recuentos de obleas, arquitectura de caché y división atención-FFN ampliamente discutidos siguen siendo estimaciones externas.
La asociación de OpenAI con Cerebras y su chip Jalapeño personalizado apuntan en la misma dirección: las próximas ganancias en IA vendrán cada vez más del codiseño de modelos, memoria, redes, aceleradores y servicio.
Sistemas juntos.
El avance confirmado es la inferencia fronteriza de 750 tokens por segundo; la disposición exacta del hardware detrás de esto aún no se ha revelado públicamente.
Empieza con una sola frase y obtén un sitio completo en minutos.



