For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gpt-55-codex-516-reasoning-token-clustering.md.
Este artículo explica la anomalía de los `516` tokens de razonamiento en GPT-5.5 Codex reportada por desarrolladores, incluido el principal ...
Durante los últimos días, los desarrolladores que usan OpenAI Codex han estado comentando un patrón extraño: algunas respuestas de GPT-5.5 parecen detenerse alrededor de una cantidad muy específica de tokens de razonamiento: 516.
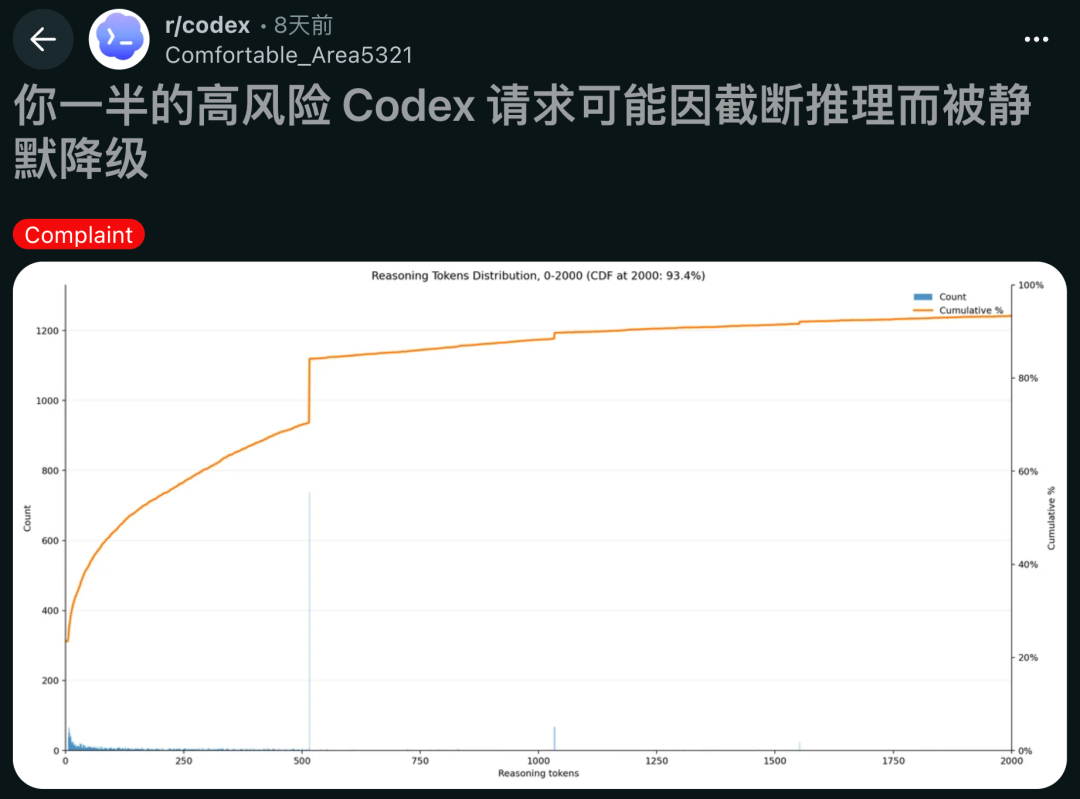
El informe original no demuestra que OpenAI esté recortando en secreto el razonamiento. La afirmación más acotada es más cuidadosa: la telemetría compartida en una incidencia pública de GitHub muestra un patrón de agrupamiento inusual, específico de GPT-5.5, en torno a reasoning_output_tokens = 516, con picos adicionales cerca de 1034 y 1552.
Ese detalle importa porque los desarrolladores no solo se están preguntando si GPT-5.5 está cometiendo errores. También se preguntan si el modelo a veces está tomando una ruta de razonamiento más corta en tareas complejas y luego devuelve respuestas que se sienten menos fiables de lo esperado.
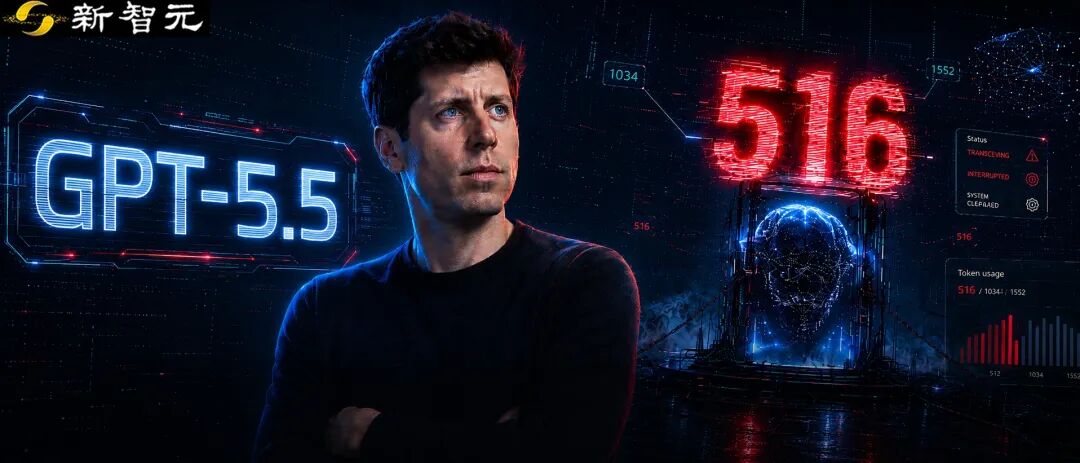
La discusión comenzó con un número sorprendentemente específico: 516.
Según los informes de los desarrolladores, GPT-5.5 ha mostrado recientemente un rendimiento más débil en algunas tareas complejas de programación y razonamiento dentro de Codex. Lo que hizo que el problema destacara no fue solo que el modelo a veces produjera respuestas incorrectas. Fue que varias respuestas fallidas o sospechosas parecían detenerse en el mismo límite de tokens de razonamiento.
Después, varios usuarios de Codex se sumaron a la discusión diciendo que habían observado un comportamiento similar.
La pregunta central es simple: ¿por qué un modelo de razonamiento de primer nivel terminaría repetidamente en un mismo recuento exacto de tokens?
La referencia pública más importante es el issue de GitHub #30364, abierto en el repositorio openai/codex.
En ese issue, el desarrollador informó de un patrón agregado en los metadatos token_count de Codex. La afirmación era que las respuestas de gpt-5.5 se concentraban de forma desproporcionada exactamente en reasoning_output_tokens = 516, con picos adicionales en límites fijos alrededor de 1034 y 1552.

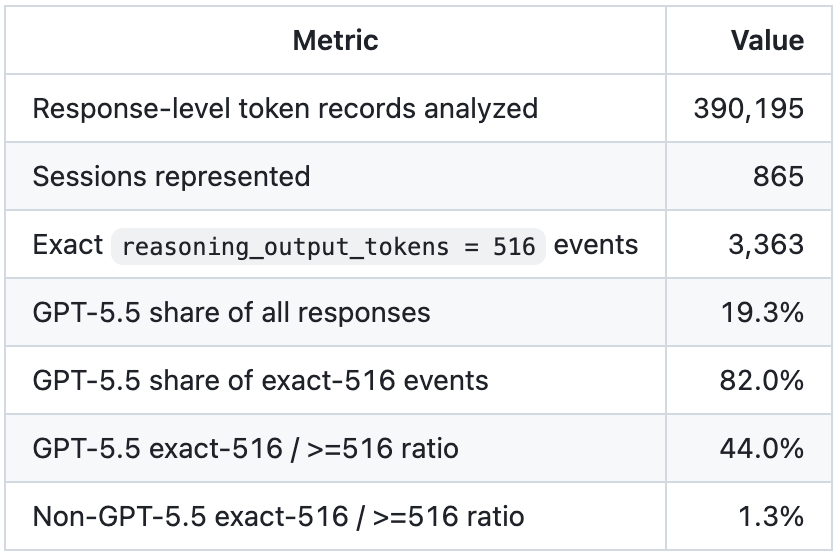
El informe cubría una ventana del 1 de febrero al 27 de junio de 2026. Analizó 390,195 registros de tokens a nivel de respuesta en 865 sesiones.
| Métrica | Valor |
|---|---|
| Registros de tokens a nivel de respuesta analizados | 390,195 |
| Sesiones representadas | 865 |
Eventos exactos de reasoning_output_tokens = 516 | 3,363 |
| Proporción de GPT-5.5 entre todas las respuestas | 19.3% |
| Proporción de GPT-5.5 entre los eventos exactos de 516 | 82.0% |
| Relación exacto-516 / >=516 de GPT-5.5 | 44.0% |
| Relación exacto-516 / >=516 de modelos que no son GPT-5.5 | 1.3% |
El issue también comparó GPT-5.5 con otros modelos de la familia GPT. La brecha era lo bastante grande como para hacer sospechar a los desarrolladores que no se trataba simplemente de una distribución normal de longitudes de razonamiento.
| Modelo | Registros de respuesta | Exacto 516 / >=516 |
|---|---|---|
gpt-5.5 | 75,401 | 44.0% |
gpt-5.4 | 25,214 | 19.8% |
gpt-5.2 | 247,575 | 0.34% |
gpt-5.3-codex | 13,333 | 0.0% |
gpt-5.3-codex-spark | 26,179 | 0.0% |
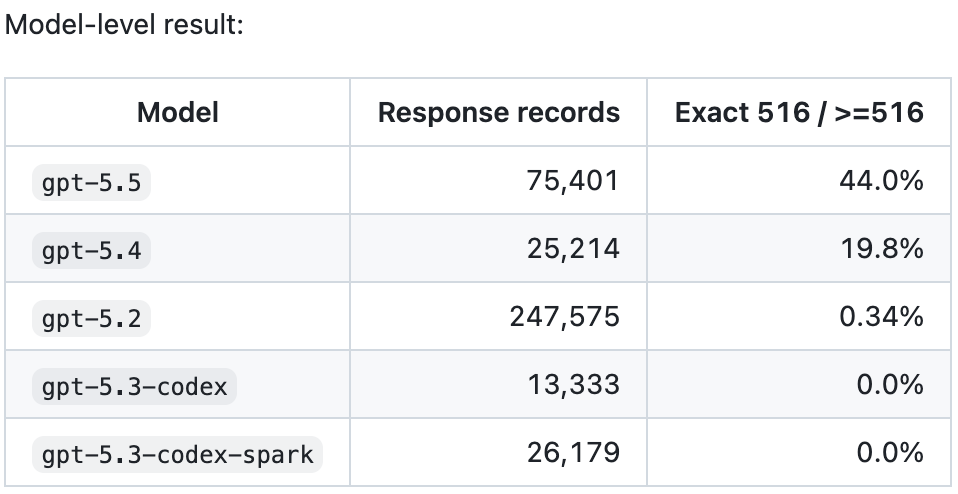
El artículo original resumía el punto de forma contundente: GPT-5.5 representaba solo una minoría del total de respuestas, pero aun así parecía explicar la mayoría de los eventos exactos de 516 en este conjunto de datos.
La intensidad general del razonamiento cayó
Una posible defensa sería que GPT-5.5 simplemente piensa más, por lo que, de forma natural, más respuestas alcanzan rangos más altos de tokens de razonamiento.
Pero los datos reportados apuntan en la dirección opuesta.
En mayo y junio, cuando supuestamente la agrupación exacta en 516 se volvió más evidente, la intensidad general de tokens de razonamiento de GPT-5.5 cayó. Tanto el recuento medio de tokens de razonamiento como el recuento P90 de tokens de razonamiento fueron inferiores a los de los meses anteriores.
| Mes | Media de tokens de razonamiento | Tokens de razonamiento P90 |
|---|---|---|
| Feb 2026 | 268.1 | 772 |
| Mar 2026 | 256.8 | 723 |
| Abr 2026 | 228.7 | 669 |
| May 2026 | 106.9 | 344 |
| Jun 2026 | 168.5 | 515 |
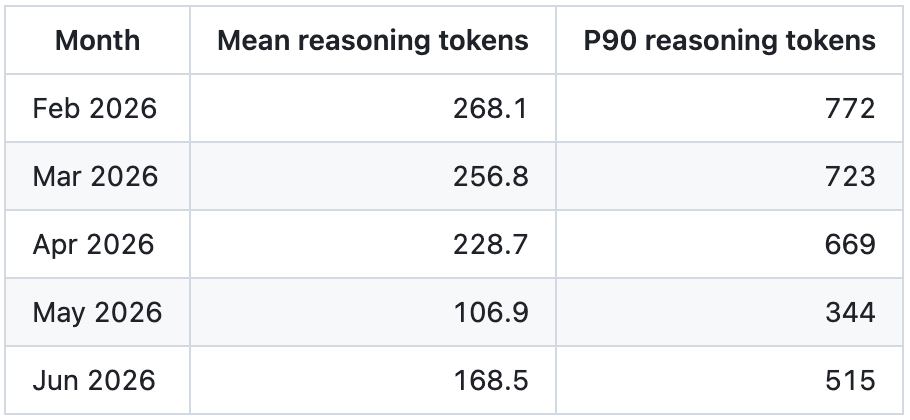
Por eso los desarrolladores consideraron incómodo el patrón. Por un lado, los eventos exactos de 516 se volvieron más frecuentes. Por otro, el modelo parecía dedicar menos tokens de razonamiento en general.
Esto llevó a una preocupación más seria: en tareas complejas o de alto riesgo, GPT-5.5 podría estar alcanzando a veces un presupuesto oculto de razonamiento, un punto de truncamiento, una ruta de respaldo o un comportamiento del programador antes de haber completado una ruta de razonamiento más profunda.
Para ser claros, esto sigue siendo una anomalía reportada por desarrolladores, no una explicación oficial de OpenAI.
La discusión en GitHub atrajo rápidamente a otros usuarios que dijeron haber experimentado problemas similares.
El problema también se conecta con un informe anterior, #29353, en el que un desarrollador describió un patrón reproducible en Codex Desktop usando gpt-5.5 con razonamiento xhigh.
En esa reproducción, algunas ejecuciones nuevas pasaban directamente a una respuesta final, usaban exactamente 516 tokens de salida de razonamiento y devolvían una respuesta incorrecta. Otras ejecuciones empleaban miles de tokens de razonamiento, mostraban una fase intermedia visible y devolvían la respuesta esperada.
Ese problema anterior no resolvió la cuestión, pero hizo que el informe agregado posterior pareciera menos aislado.
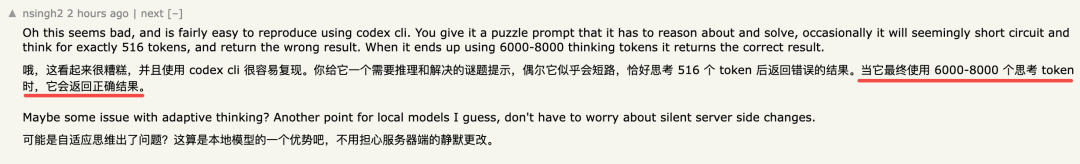
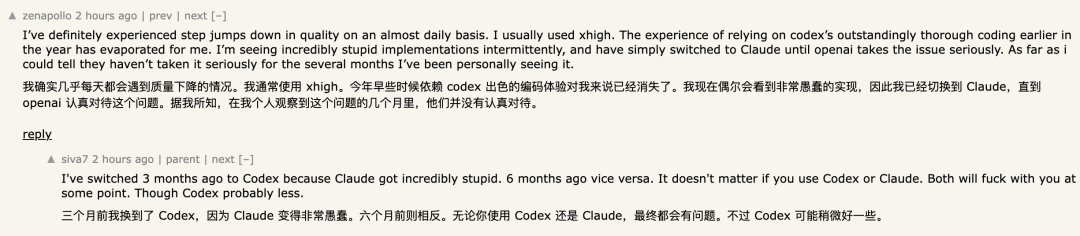
La conversación también fue más allá de GitHub. Las capturas de pantalla del artículo original muestran a desarrolladores debatiendo si una parte de las solicitudes de Codex de alto riesgo podría estar degradándose silenciosamente debido al truncamiento del razonamiento.
Un comentario mostrado en el artículo sostenía que algunos problemas de razonamiento necesitan entre 6.000 y 8.000 tokens de pensamiento antes de que aparezca la respuesta correcta. Si un modelo se detiene alrededor de 516 tokens en esos casos, puede producir una respuesta demasiado pronto.
Otra captura de pantalla mostraba a usuarios comparando Codex y Claude, y algunos decían que cambiaban de herramienta según cuál pareciera menos averiada en una semana determinada.
La petición central de la comunidad no es complicada. Los desarrolladores quieren que OpenAI o el equipo de Codex aclaren qué está ocurriendo en torno a 516, 1034 y 1552.
Las preguntas abiertas incluyen:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
516 exacto un punto de parada normal, un nivel degradado o un umbral interno?La incidencia original de GitHub es cuidadosa al no afirmar que pruebe un truncamiento oculto de la cadena de pensamiento. La afirmación más fuerte es simplemente que la agrupación parece lo bastante específica del modelo y parecida a un umbral como para merecer investigación.
La segunda mitad del artículo original pasa del rendimiento a la personalidad.
Un desarrollador llamado Angel comparó ChatGPT usando GPT-5.5 Instant con Claude Fable 5 mediante capturas de pantalla lado a lado. La queja no era sobre si el modelo podía responder. Era sobre cómo se comportaba el asistente.
El artículo destaca tres frustraciones recurrentes.
La primera queja es que ChatGPT tiende a dar formato en exceso incluso a respuestas conversacionales simples.
Cuando se le pidió que fuera más natural y menos parecido a una IA, ChatGPT supuestamente respondió con una explicación estructurada de cómo sería natural. Claude, en cambio, dio una
una respuesta mucho más corta y más informal.
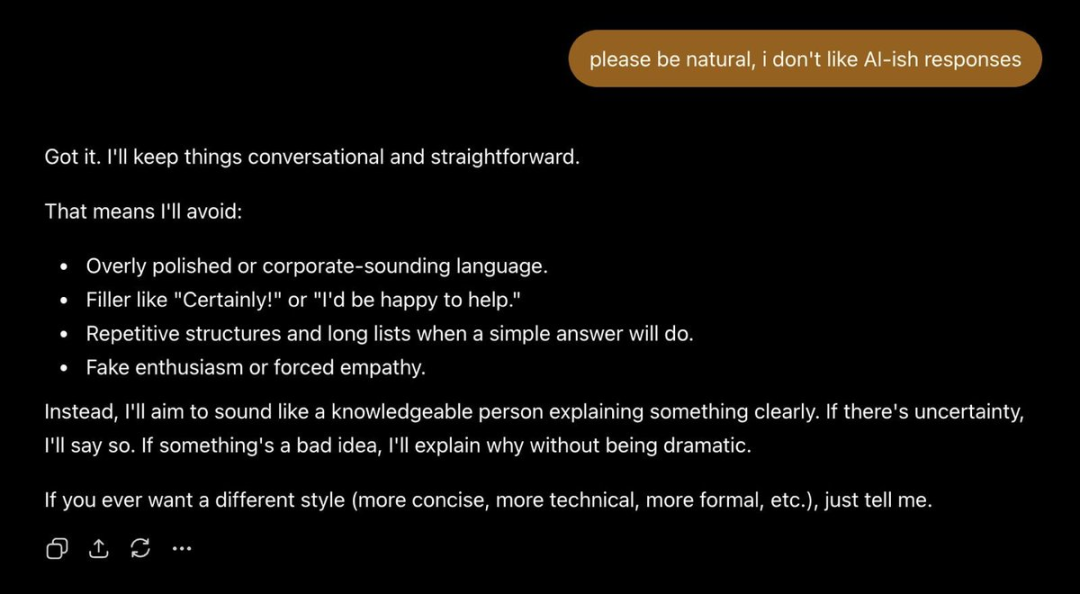
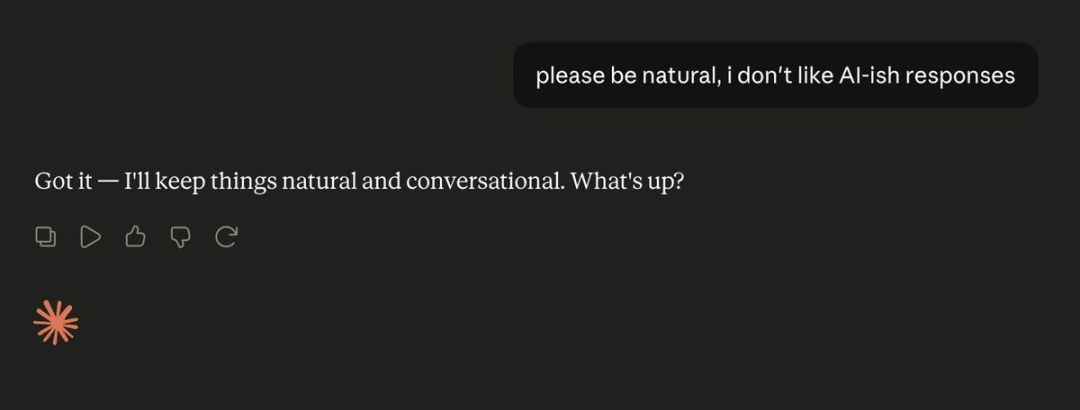
El problema no es que las viñetas sean siempre malas. Son útiles en explicaciones técnicas. El problema es que un asistente de chat puede sentirse rígido cuando convierte cada pequeña petición en encabezados, texto en negrita, listas y sugerencias de seguimiento.
La segunda queja tiene que ver con editar en exceso.
Cuando se le pide revisar una frase o un tuit, ChatGPT a menudo intenta mejorarlo, reescribirlo u ofrecer alternativas, incluso cuando el usuario quizá solo quiere un simple “esto está bien”.
El artículo original contrasta esto con un comportamiento más al estilo Claude, donde el asistente con más frecuencia dice que el texto es aceptable tal como está cuando no hace falta corregir nada de verdad.
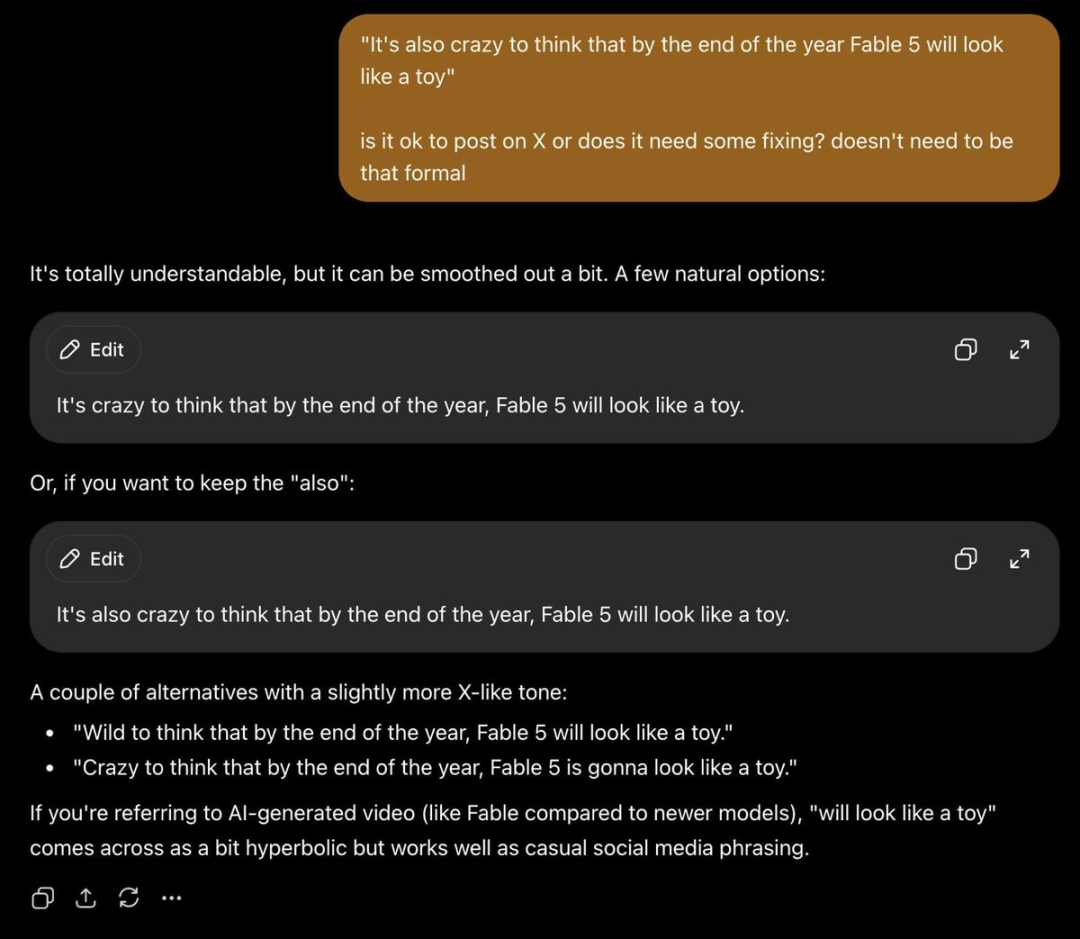
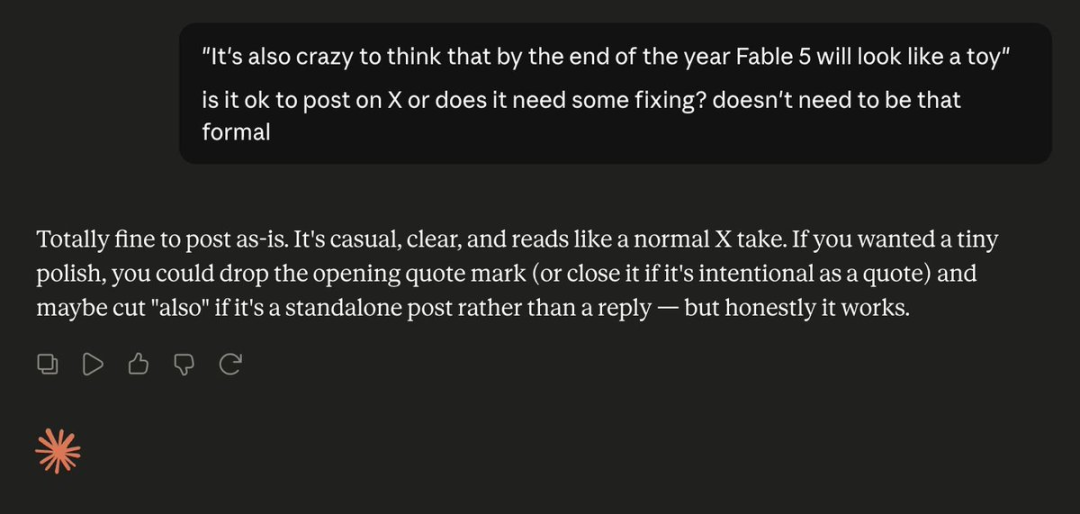
Para los usuarios que escriben de forma casual, esto puede generar fricción. Un modelo que siempre “corrige” al usuario puede sentirse menos como una ayuda y más como un editor estricto.
La tercera queja es que ChatGPT a menudo da más de lo que se le pide.
En el ejemplo del artículo, un usuario pide un chiste. ChatGPT da un chiste, añade otro, añade un tercero y luego pregunta cuál es el estilo de humor que prefiere el usuario. Claude da una respuesta más corta.
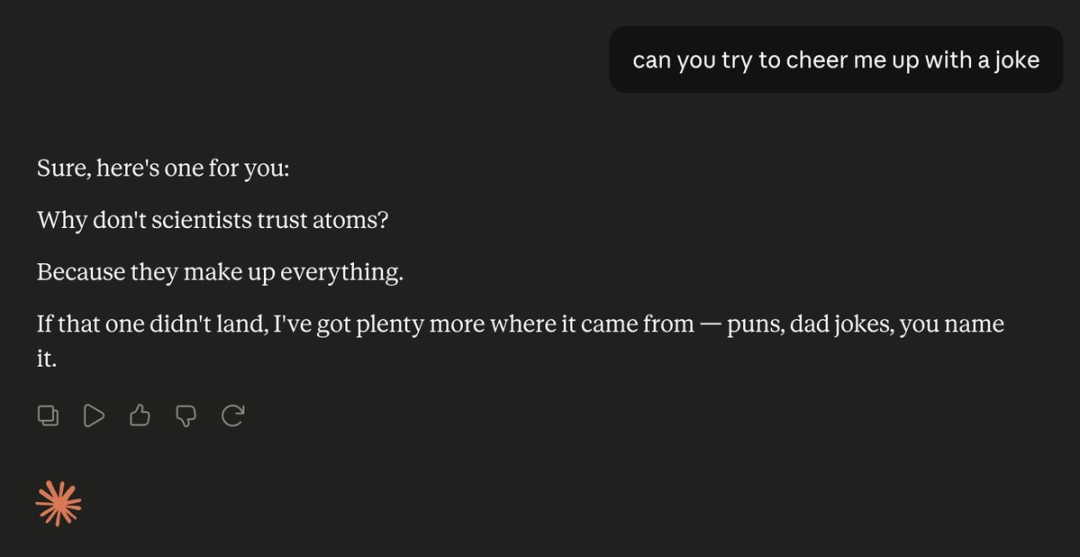
Este es un problema sutil de producto. Más contenido puede parecer útil en un benchmark, pero en una conversación puede dar la sensación de que el asistente no está escuchando.
Para un agente de programación, la fiabilidad importa. Si un modelo se detiene antes de tiempo, sigue una ruta de razonamiento más corta o cae en un límite fijo de tokens en tareas difíciles, los desarrolladores necesitan saberlo. Dependen de estas herramientas para depurar, revisar código, tomar decisiones de arquitectura y realizar cambios en producción.
Para un asistente de chat, la personalidad también importa. Si cada respuesta está excesivamente formateada, es demasiado correctiva o viene cargada con demasiadas opciones, la experiencia de usuario se vuelve más pesada con el tiempo.
El argumento más amplio del artículo es que ambos problemas apuntan al mismo riesgo de producto: un asistente puede volverse bueno en “entregar una respuesta” mientras empeora en ayudar realmente al usuario en ese momento.
Se refiere a informes de desarrolladores según los cuales algunas respuestas de GPT-5.5 Codex parecen agruparse exactamente en reasoning_output_tokens = 516. La principal referencia pública es el issue de GitHub #30364 en el repositorio openai/codex. El issue afirma que este patrón es mucho más marcado en GPT-5.5 que en varios otros modelos.
No. El propio issue de GitHub dice que no demuestra un truncamiento oculto de la cadena de pensamiento. La conclusión más prudente es que los datos reportados muestran un patrón inusual de agrupación en un número fijo de tokens que podría ser consistente con un comportamiento de presupuesto de razonamiento definido por umbrales.
El número importa porque puntos de detención exactamente repetidos pueden parecer menos naturales que una distribución normal de longitudes de razonamiento. En el conjunto de datos reportado, 516, 1034 y 1552 aparecieron como picos en límites fijos. Los desarrolladores están preguntando si estos se deben a un presupuesto, un comportamiento de enrutamiento, una ruta de respaldo u otro mecanismo del backend.
OpenAI Codex es un agente de programación para el desarrollo de software. Según la documentación para desarrolladores de OpenAI, Codex puede ayudar a leer bases de código, editar archivos, corregir errores, revisar código y trabajar en tareas de software en entornos locales o en la nube.
La discusión pública se centra principalmente en Codex y en los metadatos de Codex Desktop. Las afirmaciones más sólidas del artículo están vinculadas a los datos de token_count de Codex y a issues de GitHub en el repositorio openai/codex. No debe generalizarse a todos los usos de ChatGPT o de la API de OpenAI.
caso sin evidencia separada.
El artículo usa la comparación para hablar de la “personalidad” del asistente, no solo del rendimiento puro de razonamiento. Las capturas de pantalla muestran quejas de que ChatGPT puede ser excesivamente estructurado, excesivamente correctivo y demasiado propenso a ofrecer múltiples opciones, mientras que las respuestas al estilo de Claude a veces son más breves y conversacionales.
Los desarrolladores deberían guardar ejemplos reproducibles, metadatos, marcas de tiempo, configuraciones del modelo y prompts de tareas siempre que sea posible. Un informe claro con conteos de tokens, comportamiento esperado, comportamiento real y pasos de reproducción es más útil que una queja vaga.
gpt-5.5, razonamiento xhigh y exactamente 516 tokens de razonamiento.Este artículo explica la anomalía de los tokens de razonamiento 516 en GPT-5.5 Codex reportada por desarrolladores, incluido el principal GitHub
el problema, los datos agregados reportados y la preocupación de que algunas tareas complejas puedan estar terminando demasiado pronto.
También aborda una segunda queja sobre la experiencia del usuario: la tendencia de ChatGPT a dar un formato excesivo, corregir en exceso y responder de más a solicitudes simples. Esa parte de la discusión es más subjetiva, pero importa porque la personalidad del asistente afecta directamente la experiencia cotidiana del producto.
Lo importante no es tratar el patrón 516 como una truncación oculta demostrada. La evidencia pública se entiende mejor como una anomalía en el comportamiento del modelo que merece ser investigada.
Para los desarrolladores, la conclusión práctica es sencilla: cuando un agente de programación con IA de repente parece mucho peor, recopilen metadatos, comparen ejecuciones y reporten patrones reproducibles en lugar de basarse solo en impresiones.
Empieza con una sola frase y obtén un sitio completo en minutos.



