For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gpt-6-1-sol-500k-context-codex-usage-and-f5e586e1.md.
Las sesiones de programación largas acumulan más que mensajes de chat. Un agente también necesita espacio para archivos fuente, resultados d...
Las sesiones de programación largas acumulan más que mensajes de chat. Un agente también necesita espacio para archivos fuente, resultados de comandos, fallos de pruebas y decisiones tomadas antes durante la tarea. Cuando ese contexto de trabajo se llena, el agente tiene que condensarlo antes de continuar.
Un informe del medio chino de noticias sobre IA Xinzhiyuan, republicado en BAAI Hub, describe un aumento del contexto predeterminado de GPT-6.1 Sol en Codex y ChatGPT Work, de 272K a 500K tokens. El informe atribuye el anuncio a Thibault Sottiaux, de OpenAI, y afirma que el cambio elimina un recargo independiente por contexto largo para el uso mediante suscripción. Esta es una afirmación más específica que la sugerencia del titular original de que la actualización es simplemente «gratuita».
La documentación oficial de OpenAI confirma la disponibilidad de GPT-6.1 Sol y explica cómo se contabiliza el uso. El cambio exacto a 500K y el anuncio sobre el recargo que se describen a continuación siguen atribuyéndose al informe citado y a la captura del anuncio; las páginas de documentación oficial consultadas no especificaban de forma independiente ese nuevo valor predeterminado.
Pasar de 272.000 a 500.000 tokens añade aproximadamente un 84 % más de capacidad. La fuente lo redondea a cerca de un 80 %. La captura de su anuncio también describe un contexto máximo de un millón de tokens e indica que los usuarios pueden anular el valor predeterminado.
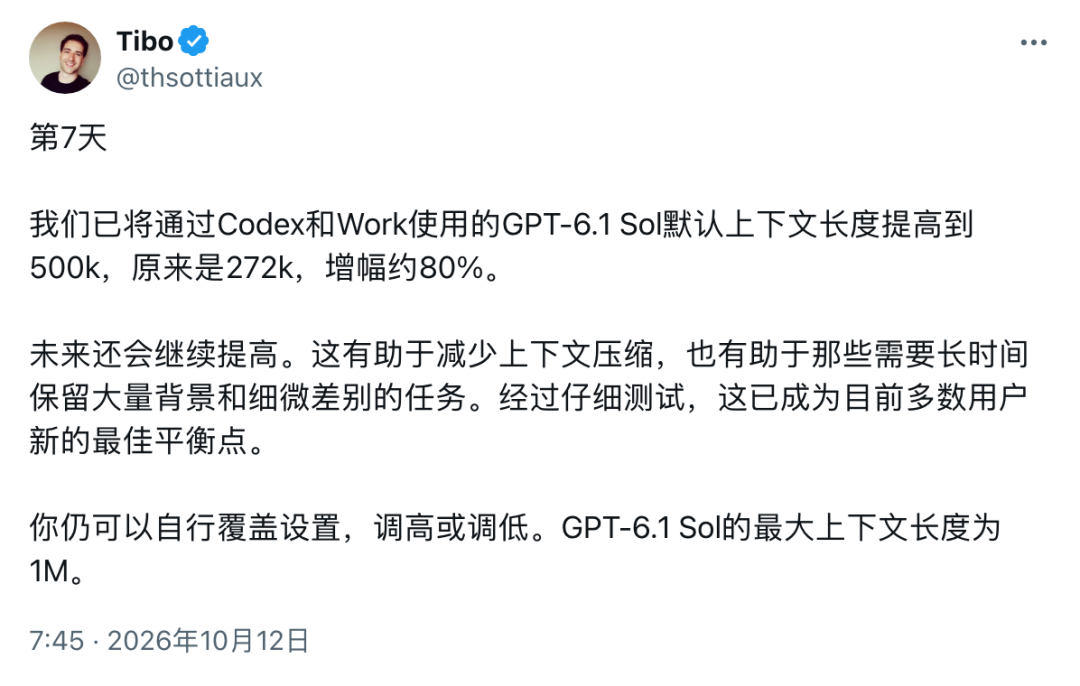
Fuente: una captura en chino del anuncio de Thibault Sottiaux reproducida por Xinzhiyuan en BAAI Hub; la descripción en español es editorial.
El beneficio práctico es disponer de espacio para mantener más historial de la tarea antes de la condensación. En un cambio de repositorio, esto podría incluir el requisito de compatibilidad original, los archivos ya revisados, los enfoques que fallaron y los resultados más recientes de las pruebas.
Una ventana más amplia no garantiza que un agente recuerde todos los requisitos ni que realice cambios correctos. Cambia la cantidad de información que puede permanecer en su contexto activo, mientras que la calidad de sus decisiones sigue requiriendo verificación.
La condensación sustituye parte del historial acumulado por una representación más breve. Esto permite a un agente seguir trabajando sin conservar íntegramente cada línea anterior de salida de herramientas.
La contrapartida es que un historial condensado puede perder detalles útiles. Una tarea de programación puede parecer terminada mientras omite un requisito anterior, como preservar un formato de respuesta de API heredado. Mantener disponible más contexto relevante puede reducir la frecuencia de estas transiciones, aunque no elimina la necesidad de realizar pruebas de regresión.
La referencia de configuración de OpenAI documenta model_context_window y model_auto_compact_token_limit. Son ajustes diferentes: uno describe el contexto disponible para el modelo, mientras que el otro determina cuándo se activa la condensación automática. La existencia de estos ajustes no establece que todos los modelos o cuentas admitan los mismos valores.
La fuente distingue un recargo por contexto largo del consumo ordinario de la suscripción. Una tarea puede seguir consumiendo una asignación incluso cuando no se aplica un multiplicador adicional específicamente porque su contexto es extenso.
La documentación oficial de precios de OpenAI respalda esta distinción más amplia. Indica que el uso depende de la elección del modelo, el contexto, el razonamiento, el uso de herramientas, la recuperación y el almacenamiento en caché. Las tareas largas que conservan más información pueden consumir una asignación sustancialmente mayor que las solicitudes breves y enfocadas.
| Concepto | Qué describe |
|---|---|
| Capacidad de contexto | Cuánta información puede mantener el modelo durante una solicitud o sesión |
| Uso de suscripción | Cómo una tarea consume la asignación o los créditos incluidos |
| Entrada en caché | Entrada procesada previamente que puede reutilizarse con una tarifa diferente |
| Precios de API | Cargos independientes al autenticar y pagar mediante una clave de API |
Un seguimiento breve como «continúa» puede dar lugar a otra solicitud sustancial al modelo. El agente puede necesitar archivos anteriores, requisitos y resultados de herramientas para decidir qué hacer. La entrada en caché puede ser más barata de procesar, pero no necesariamente queda sin medición.
La fuente también describe un aumento anterior a 372K que posteriormente se revirtió tras un consumo de suscripción superior al esperado. Ese relato aporta contexto útil para el anuncio, pero no debe interpretarse como una regla de facturación vigente ni como una promesa sobre cuánto costará una tarea concreta.
La fuente compara el nuevo valor predeterminado reportado con configuraciones de un millón de tokens en Claude Code. Una comparación útil requiere más que el número más alto de una ficha de modelo: los valores predeterminados, los umbrales de condensación, el acceso de la cuenta, los precios y el software de agente circundante pueden diferir.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Los límites específicos de modelos Claude y el umbral de compresión indicados por la fuente no se verificaron de forma independiente frente a la documentación de Anthropic para este artículo. Por ello, no deben tratarse como una recomendación de configuración vigente.
Para el trabajo cotidiano, revise conjuntamente tres elementos:
La guía oficial de modelos de OpenAI también condiciona la disponibilidad al plan, el cliente, el despliegue y los ajustes del espacio de trabajo. Un anuncio de capacidad no concede acceso a un modelo que de otro modo no estuviera disponible.
GPT-6.1 Sol es un modelo de OpenAI documentado para trabajo complejo con código, aplicaciones y documentos. La guía oficial lo describe como una opción que ofrece un rendimiento cercano a Astra a un coste inferior, con disponibilidad dependiente del plan y el cliente del usuario.
Significa que el modelo puede trabajar con un contexto medido en aproximadamente 500.000 tokens bajo esa configuración. Los tokens incluyen más que el último mensaje del usuario, por lo que los archivos, el historial de tareas, la salida de herramientas y las respuestas pueden ser relevantes.
La fuente informa de que no existe un recargo independiente por contexto largo para el uso mediante suscripción, lo cual es diferente del acceso ilimitado. La tarea sigue consumiendo la asignación aplicable, y el acceso a GPT-6.1 Sol depende del plan y del despliegue.
Puede retrasar la condensación al poner más espacio a disposición. Una sesión suficientemente larga aún puede alcanzar su límite, y el umbral de condensación configurado también afecta al momento en que se produce la síntesis.
No. OpenAI afirma explícitamente que los precios por tokens de la API son independientes del uso de la suscripción y no deben utilizarse para estimar el número de tareas incluidas.
No únicamente porque se mencione un ajuste mayor en un informe. Compruebe el modelo y la configuración compatibles y, después, compare la calidad de finalización, la latencia y el uso en una tarea representativa antes de cambiar su configuración habitual.
El valor predeterminado reportado de 500K ofrece a GPT-6.1 Sol más espacio para archivos, requisitos e historial de trabajo en Codex y Work. Su beneficio potencial más claro son menos interrupciones por condensación durante una tarea larga.
Una mayor capacidad de contexto es útil, pero no elimina los límites de suscripción, los cargos de API ni la necesidad de comprobar el resultado final.
Empieza con una sola frase y obtén un sitio completo en minutos.



