For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/gpt-6-speed-boost-astra-and-6-1-sol-gain-90356630.md.
OpenAI ha iniciado una serie de 28 días de mejoras de producto con un cambio que los usuarios pueden percibir de inmediato: **GPT-6 Astra y ...
OpenAI ha iniciado una serie de 28 días de mejoras de producto con un cambio que los usuarios pueden percibir de inmediato: GPT-6 Astra y GPT-6.1 Sol ahora son aproximadamente un 50% más rápidos de forma predeterminada cuando se usan mediante suscripciones elegibles de ChatGPT.
La mejora se aplica en los productos de OpenAI y las herramientas asociadas compatibles con Sign in with ChatGPT, incluidos OpenCode, Pi, Amp y Devin.
No se requiere ningún cambio de código.
El responsable de ingeniería de OpenAI, Thibault “Tibo” Sottiaux, afirmó que la velocidad predeterminada de las suscripciones se había optimizado en aproximadamente un 50%. Las mediciones de la comunidad sitúan el salto práctico en aproximadamente 30 tokens por segundo a unos 50 tokens por segundo, aunque el rendimiento exacto varía según el modelo, la tarea, el producto y las condiciones de ejecución.
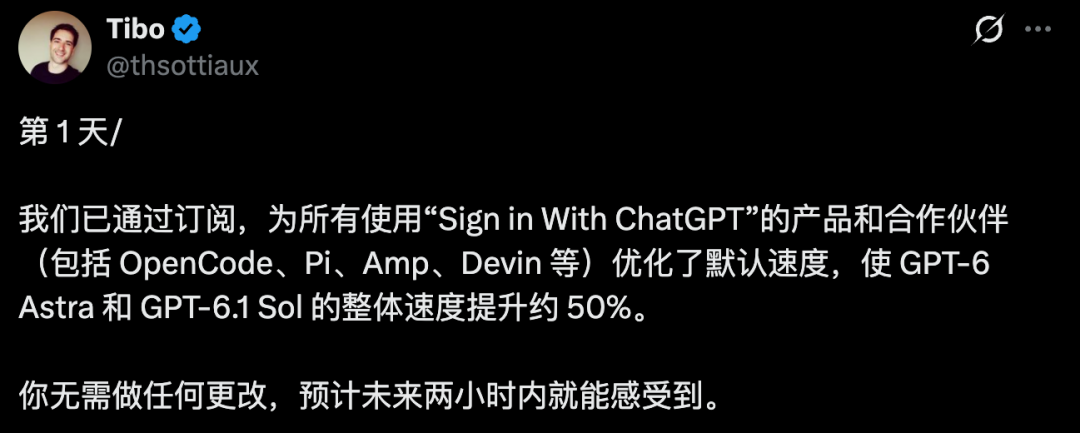
El anuncio de Tibo del Día 1 indica que GPT-6 Astra y GPT-6.1 Sol son alrededor de un 50% más rápidos mediante el acceso por suscripción.
El momento es relevante porque, al mismo tiempo, se está produciendo otro debate.
SemiAnalysis ha publicado un estudio detallado de pruebas de límites que compara suscripciones de IA para consumidores. Bajo sus supuestos de cargas de trabajo agénticas, las suscripciones a Claude Opus 5.5 proporcionan más de cinco veces el valor equivalente de API de los planes GPT-6.1 Sol al mismo precio mensual.
Por tanto, OpenAI ha acelerado los modelos.
La pregunta más difícil es si la economía de las suscripciones sigue siendo competitiva para los usuarios que ejecutan flujos de trabajo de programación y agentes largos y autónomos.
La primera actualización del impulso de lanzamiento de 28 días de OpenAI se dirige a una de las fuentes más evidentes de fricción en el trabajo avanzado de programación y agentes: la latencia de generación.
Tibo escribió que OpenAI había optimizado la velocidad predeterminada de GPT-6 Astra y GPT-6.1 Sol en aproximadamente un 50% mediante acceso por suscripción.
El despliegue se aplica a:
El usuario no necesita cambiar una configuración ni modificar un endpoint de API.
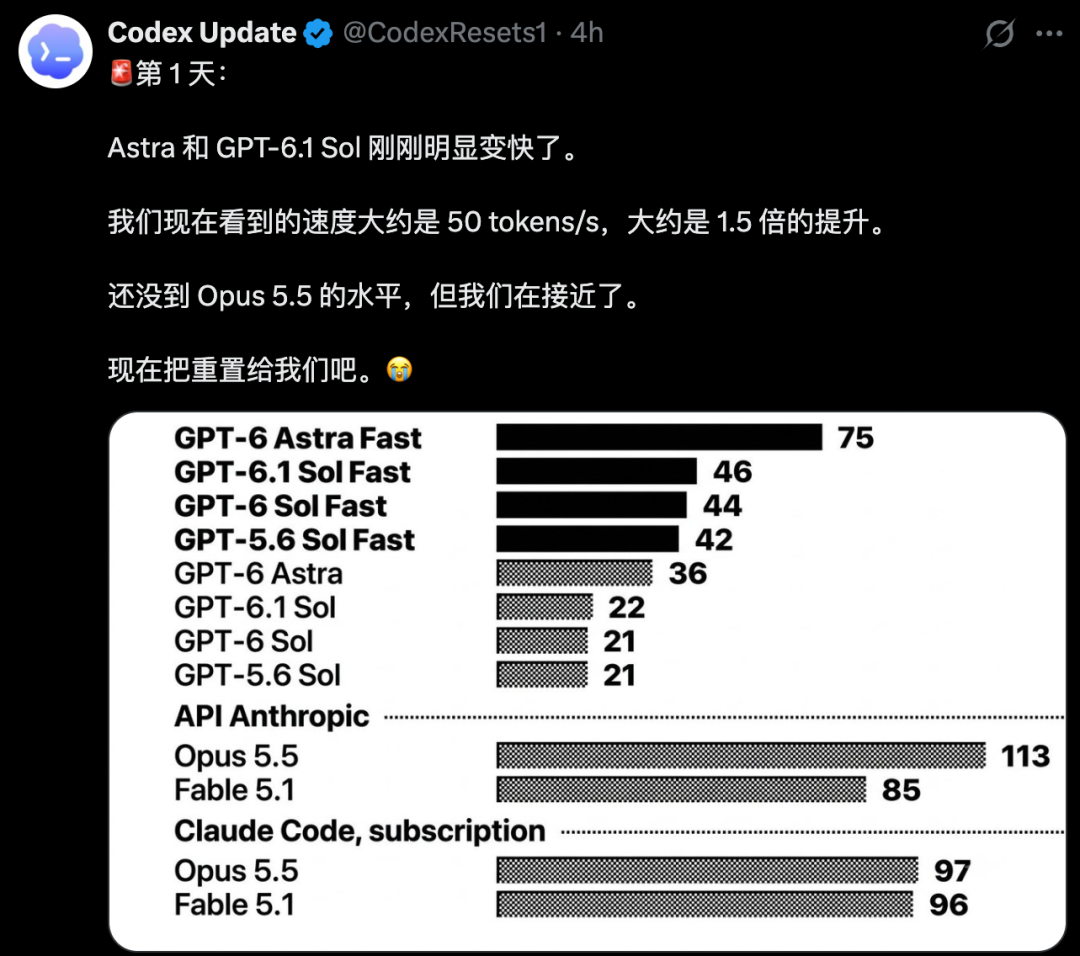
Las mediciones de la comunidad muestran un aumento visible de velocidad, aunque el rendimiento difiere según el modelo y la vía de acceso.
El artículo fuente resume el cambio como una transición aproximada de:
~30 tokens/segundo
        ↓
~50 tokens/segundo
Es una simplificación útil, pero el anuncio oficial se formula como “alrededor de un 50% más rápido”, no como un nivel de servicio garantizado y fijo de 50 TPS.
Distintos evaluadores pueden observar valores diferentes.
La mejora de velocidad es la primera entrada de un impulso más amplio de 28 días.
Tibo afirmó que, durante los próximos 28 días, OpenAI planea lanzar:
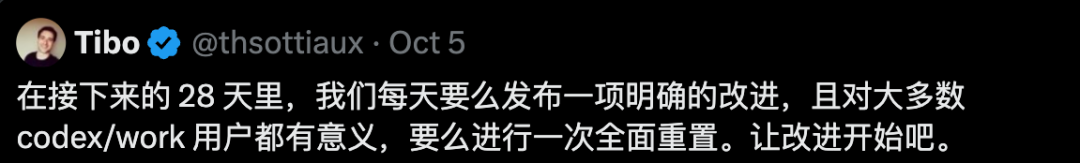
El impulso de 28 días se centra en simplificación, eficiencia, nuevas capacidades y mejoras de modelos.
Las prioridades declaradas son:
El mensaje está dirigido especialmente a los usuarios de Codex y Work, para quienes las tareas de larga duración hacen que la velocidad y los límites de uso sean mucho más visibles que en un chat breve.
El artículo original afirma que el cambio procedía en parte de un tokenizador optimizado “agresivo” que reduce el número de tokens necesarios para la misma tarea.
Esa afirmación específica debe tratarse con cautela.
Las declaraciones públicas del personal de OpenAI revisadas para este artículo describen la actualización del Día 1 como una optimización de inferencia y una mejora de la velocidad predeterminada.
No documentan públicamente el despliegue de un nuevo tokenizador para GPT-6 Astra o GPT-6.1 Sol como el mecanismo detrás de esta ganancia concreta del 50%.
Esta distinción es importante.
Existen varias formas de mejorar el rendimiento percibido:
Sin una nota técnica oficial, es más seguro afirmar que OpenAI optimizó la inferencia que atribuir la mejora a una arquitectura específica de tokenizador.
Una mejora del 50% en la velocidad de generación del modelo no significa que todas las tareas completas terminen un 50% antes.
Los flujos de trabajo con agentes invierten tiempo en más elementos que la generación de tokens.
Una tarea de programación típica puede incluir:
Razonamiento del modelo
      ↓
Llamada a herramienta
      ↓
Comando de shell o acción de navegador
      ↓
Lectura/escritura de archivos
      ↓
Espera de red
      ↓
Otro turno del modelo
Si las herramientas, los sitios web, las compilaciones, las pruebas o las API externas dominan el tiempo total transcurrido, una generación de tokens más rápida puede reducir solo una parte de la duración total de la tarea.
El artículo fuente también señala que algunos desarrolladores no percibieron de inmediato una diferencia drástica.
Esto es plausible.
La velocidad percibida depende de:
La actualización es real, pero no debe interpretarse como una garantía universal de que todas las tareas de extremo a extremo terminarán en dos tercios del tiempo anterior.
Durante la misma semana, SemiAnalysis publicó una comparación detallada de límites de suscripción de IA.
Los investigadores adquirieron planes de suscripción, ejecutaron cargas de trabajo controladas hasta que los medidores de uso se movieron o se alcanzaron los límites, y convirtieron dichos límites en un valor en dólares equivalente de API.
Su metodología mide por separado:
Después combinan estas tarifas mediante una carga de trabajo agéntica representativa.
SemiAnalysis probó límites de suscripción en OpenAI, Anthropic y varios otros proveedores de IA.
La comparación principal del artículo fuente es GPT-6.1 Sol frente a Claude Opus 5.5.
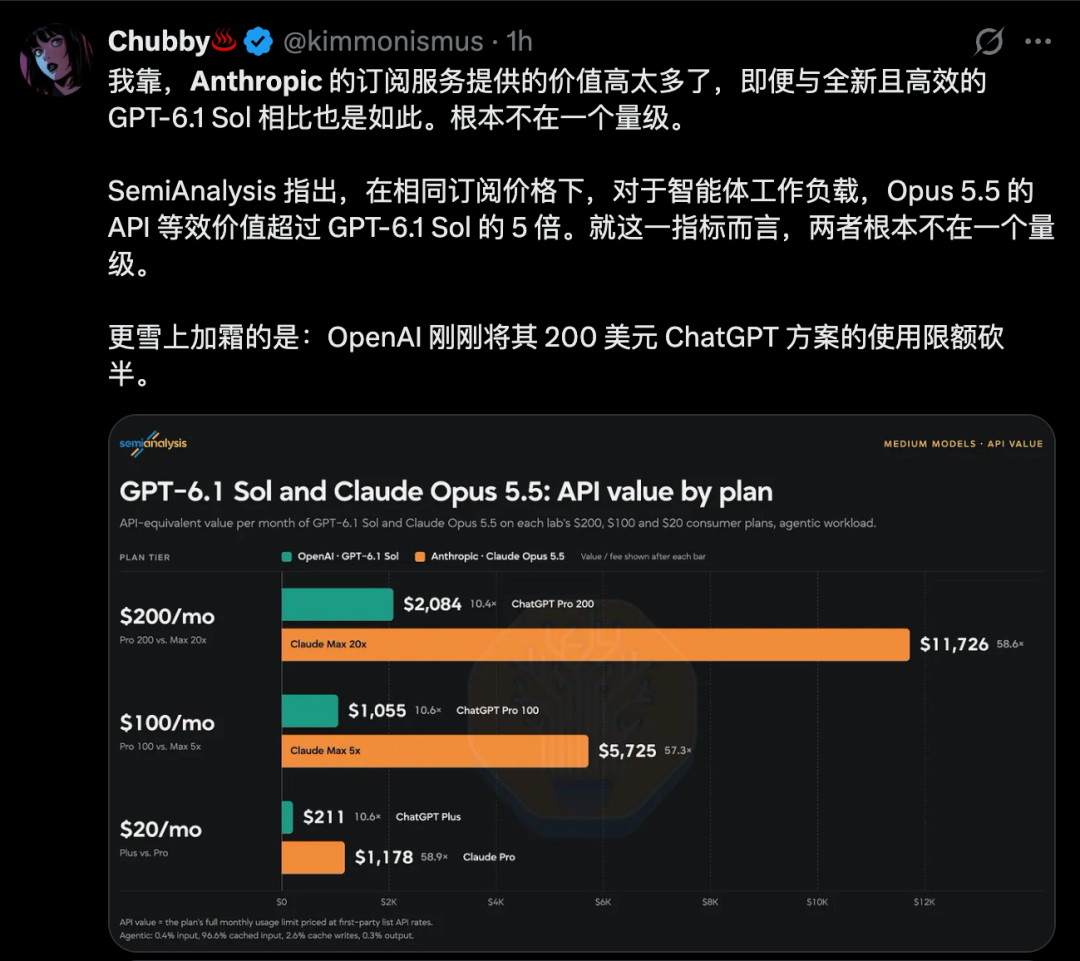
SemiAnalysis estima una ventaja superior a cinco veces para Claude Opus 5.5 bajo sus supuestos de carga de trabajo agéntica.
El gráfico publicado ofrece la siguiente instantánea:
| Plan mensual | OpenAI / GPT-6.1 Sol | Anthropic / Claude Opus 5.5 | Relación aproximada |
|---|---|---|---|
| $200 | $2,084 de valor equivalente de API | $11,726 | 5.6× |
| $100 | $1,055 | $5,725 | 5.4× |
| $20 | $211 | $1,178 | 5.6× |
Estas cifras no significan que una suscripción de Anthropic de $200 pague literalmente $11,726 al cliente.
Significan que, según los límites medidos por SemiAnalysis y la combinación de cargas de trabajo asumida, consumir la misma cantidad mediante precios públicos de API costaría teóricamente aproximadamente esa suma.
Una visualización comunitaria del nivel de $200 facilita ver la diferencia.
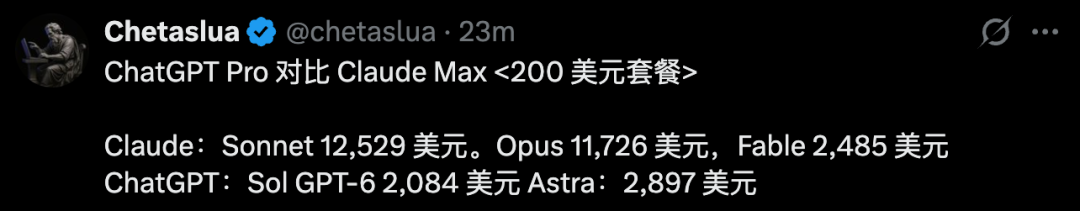
La comparación de $200 varía considerablemente según el modelo utilizado.
El matiz importante es la elección del modelo.
SemiAnalysis advierte explícitamente que el valor de una suscripción no puede resumirse mediante una cifra universal única.
La unidad correcta se aproxima más a:
(plan, modelo, carga de trabajo)
Una suscripción puede parecer extremadamente generosa para un modelo y mucho menos generosa para otro.
SemiAnalysis afirma que OpenAI realizó un cambio importante de suscripción poco antes de publicar el informe.
Las pruebas de la firma confirmaron una reducción de aproximadamente 50% en los límites de tokens del plan de $200 de OpenAI para las suscripciones recién adquiridas.
Los planes antiguos de $200 se mantuvieron temporalmente con los límites previos hasta el 29 de octubre.
SemiAnalysis también señala que OpenAI introdujo un nuevo nivel de $500.
El artículo informa que el nivel de $200 había ofrecido en el pasado un valor inusualmente generoso, especialmente para usuarios intensivos de Codex.
Después de la reducción, la economía de tokens por dólar de los niveles Pro 100, Pro 200 y Pro 500 de OpenAI pasó a ser mucho más similar.
Esta es parte de la razón por la que la comparación con Anthropic parece tan drástica.
El uso tradicional de chat es intermitente.
Una persona formula una pregunta, lee la respuesta, reflexiona y vuelve más tarde.
La programación agéntica puede comportarse de forma muy diferente.
Un solo trabajo puede:
Esto genera mucha más actividad del modelo que un intercambio conversacional corto.
SemiAnalysis sostiene que los planes de suscripción están altamente subvencionados porque la mayoría de los usuarios no consumen su asignación teórica máxima.
Los usuarios intensivos de agentes cuestionan ese supuesto.
El artículo fuente describe esto como un cambio desde “la mayoría de los usuarios no utiliza su cuota completa” hacia flujos de trabajo capaces de consumir cantidades muy grandes de inferencia.
Esto es coherente, en términos generales, con el análisis más amplio de SemiAnalysis, aunque la utilización exacta de equilibrio depende de los supuestos sobre costes de modelo, márgenes de API, combinación de cargas de trabajo y economía interna del proveedor.
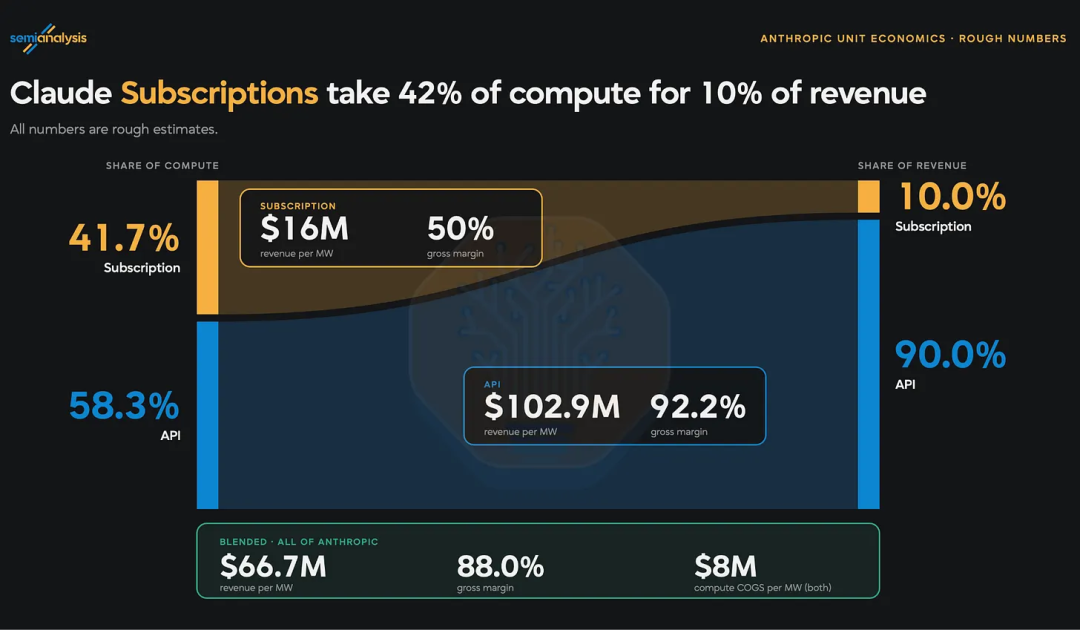
SemiAnalysis también publicó un modelo aproximado de la economía de suscripciones de Anthropic.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
SemiAnalysis estima que las suscripciones pueden consumir una proporción mucho mayor de cómputo de inferencia que su participación en los ingresos.
Sus cifras aproximadas sugieren que las suscripciones pueden representar solo alrededor del 10% de los ingresos mientras consumen más del 40% del cómputo de inferencia.
Son estimaciones de modelización, no estados financieros auditados de Anthropic.
Son útiles porque explican la tensión detrás de los límites de suscripción.
Las empresas de IA quieren que los productos de suscripción sean suficientemente atractivos para captar usuarios, al tiempo que evitan que las cargas de trabajo agénticas más intensivas consuman una cantidad ilimitada de inferencia costosa.
Cuanto más autónomos se vuelven los agentes, más difícil es ese equilibrio.
El artículo original pasa después de la velocidad del modelo y la economía de suscripciones a una historia de producto más amplia.
Cita una publicación de la comunidad que afirma que Chat, Work, Codex y Dots terminarán fusionándose en una única interfaz de superaplicación, donde los selectores de modelo y los controles de razonamiento quedarán ocultos para los usuarios.
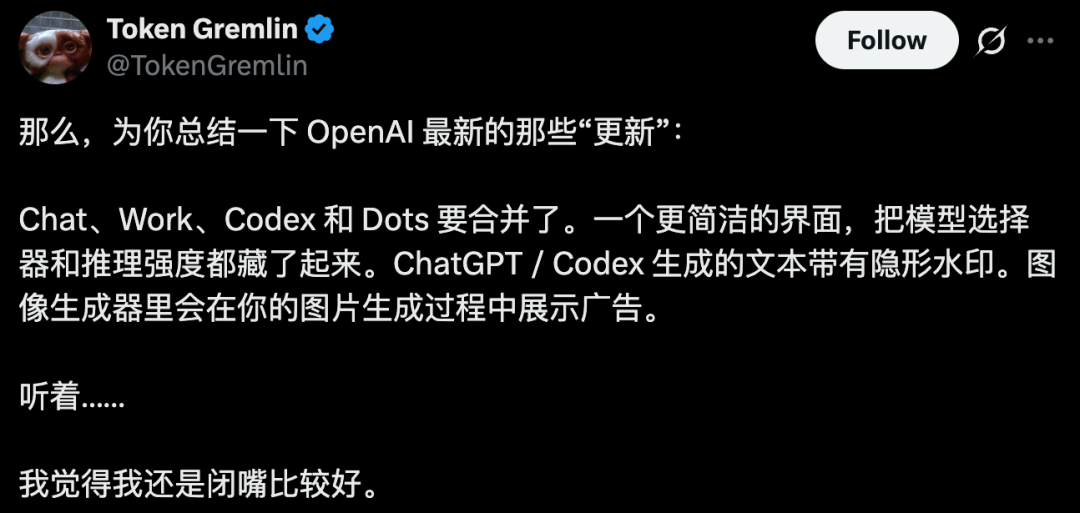
Esta publicación resume afirmaciones de la comunidad sobre una futura convergencia de productos; no todas estas afirmaciones son oficiales.
Esta sección requiere una separación clara entre rumor y realidad actual del producto.
El actual Centro de Ayuda de OpenAI indica que:
Por tanto, la idea de una interfaz completamente fusionada de Chat + Work + Codex + Dots no es un estado de producto actual anunciado.
OpenAI está simplificando claramente la experiencia, pero la afirmación más contundente del artículo fuente de que “todo se está fusionando” procede de una interpretación de la comunidad, no de una hoja de ruta publicada por OpenAI.
La dirección oficial del producto sigue siendo relevante.
OpenAI describe ahora ChatGPT como una plataforma que incluye:
Los proyectos pueden proporcionar contexto compartido para ambos modos.
Work también puede:
Esto significa que el producto ya se está alejando de un mundo en el que cada capacidad reside en una aplicación separada.
La consolidación es real.
La forma final exacta todavía no es pública.
El artículo fuente implica que Codex podría desaparecer dentro de una interfaz unificada.
La documentación actual indica lo contrario.
Codex sigue dedicado al desarrollo de software y al trabajo técnico.
En escritorio, los usuarios cambian entre ChatGPT y Codex desde el menú superior izquierdo.
Codex mantiene sus propios flujos de trabajo e historial centrados en desarrollo.
Esto podría cambiar más adelante, pero ninguna fuente oficial revisada para este artículo afirma que Codex vaya a eliminarse como una experiencia diferenciada.
Dots representan otra parte de la estrategia de producto de OpenAI.
Un dot es un agente siempre activo impulsado por GPT-6 Astra.
Tiene:
Un dot también puede trabajar a través de canales de mensajería y, con permiso, conectarse al ordenador local de un usuario.
Esto acerca a Dots más a un asistente persistente o trabajador delegado que a una sesión de chat normal.
También ayuda a explicar por qué los usuarios y observadores esperan que los límites entre productos se difuminen con el tiempo.
Chat, Work, Codex y Dots comparten cada vez más modelos, herramientas, archivos, permisos e infraestructura de agentes.
Pero una infraestructura compartida no equivale a una fusión confirmada en una sola interfaz.
El artículo fuente también informa que el texto generado por ChatGPT y Codex recibirá marcas de agua invisibles.
La afirmación es parcialmente correcta, pero el alcance es mucho más limitado de lo que sugiere la formulación original.
OpenAI ha anunciado oficialmente un sistema de procedencia de texto denominado textGrain.
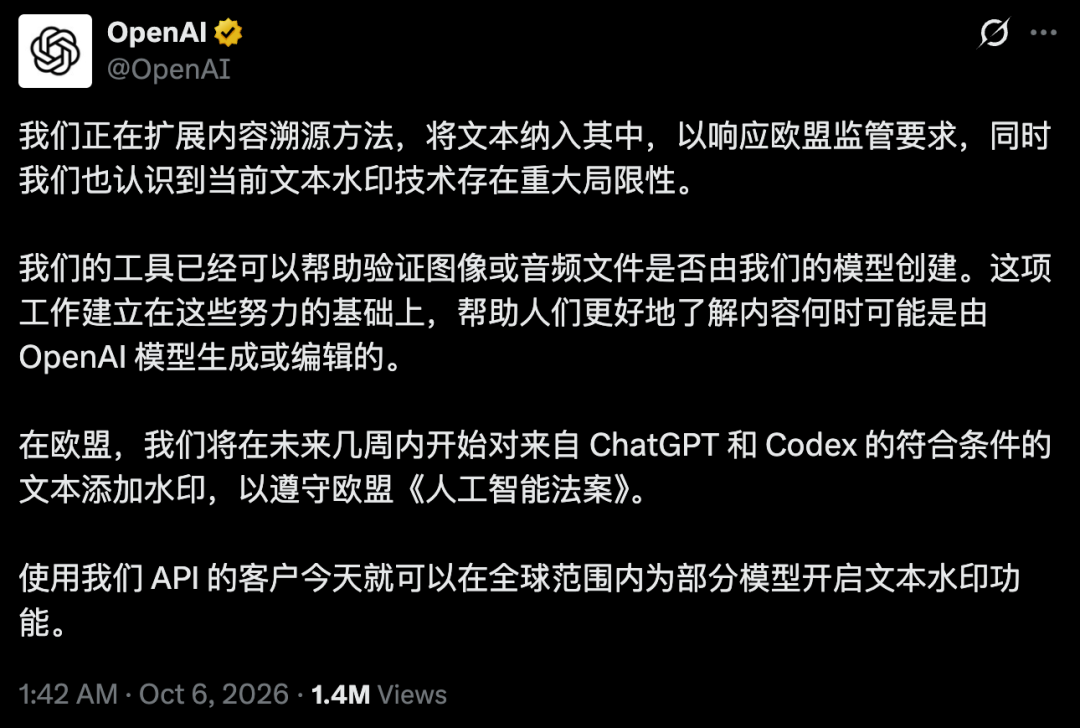
OpenAI está introduciendo el marcado de agua de texto en respuesta a los requisitos de procedencia de la Ley de IA de la UE.
La política actual es:
Por tanto, no es correcto afirmar que todo el texto de ChatGPT y Codex, en cualquier lugar, esté recibiendo obligatoriamente marcas de agua.
OpenAI afirma que textGrain no inserta caracteres ocultos ni espacios invisibles.
En su lugar, modifica sutilmente el patrón de probabilidades utilizado al seleccionar palabras o fragmentos de palabras.
En un pasaje suficientemente largo, un detector puede buscar esa señal estadística.
Este enfoque tiene limitaciones importantes.
La paráfrasis, la traducción, la edición intensa o un texto muy breve pueden debilitar la señal.
La ausencia de una marca de agua tampoco prueba que un humano haya escrito el texto.
La propia OpenAI subraya estas limitaciones.
La publicidad es otra parte del cambio de producto, y esta parte es oficial.
El 5 de octubre, OpenAI anunció un nuevo formato de anuncio visual en ChatGPT.
La compañía afirma que inicialmente probará el formato durante la generación de imágenes.
El primer despliegue se limita a:
Los anuncios están etiquetados y permanecen separados de la imagen generada.
OpenAI también afirma que la publicidad no influye en las respuestas de ChatGPT.
Esto es más específico que afirmar que “los usuarios verán anuncios mientras esperan la generación de imágenes” en todas las circunstancias.
Es una prueba limitada vinculada al plan, la geografía y el estado del despliegue.
El artículo combina varios desarrollos reales que ocurrieron en fechas cercanas.
La forma más clara de separarlos es:
| Afirmación | Estado |
|---|---|
| La velocidad predeterminada de suscripción de GPT-6 Astra y GPT-6.1 Sol mejoró en aproximadamente un 50% | Confirmado |
| La mejora se aplica en productos de OpenAI y socios de Sign in with ChatGPT | Confirmado |
| Los usuarios deben cambiar código o ajustes | No; el anuncio oficial indica que no se necesita ningún cambio |
| El rendimiento predeterminado está garantizado exactamente en 50 TPS | No garantizado; 50 TPS es una cifra observada/de resumen útil |
| La aceleración provino de un nuevo tokenizador agresivo | No confirmado públicamente en el material oficial revisado |
| SemiAnalysis midió más de 5× de valor equivalente de API para Opus 5.5 frente a GPT-6.1 Sol | Confirmado para su metodología de carga de trabajo agéntica declarada |
| OpenAI redujo aproximadamente a la mitad los límites de los planes de $200 recién adquiridos | Confirmado por las pruebas de SemiAnalysis y el anuncio citado |
| Chat, Work, Codex y Dots se están fusionando oficialmente en una interfaz | No confirmado |
| La selección de modelos se está eliminando por completo | No confirmado; la documentación actual de Work/Codex aún describe selección de modelos |
| Todo el texto de ChatGPT/Codex a nivel mundial recibirá marcas de agua | Falso como afirmación global |
| El texto elegible de ChatGPT/Codex en la UE recibirá marcas de agua invisibles | Confirmado |
| Los clientes de API pueden optar por el marcado de agua de texto | Confirmado |
| Se probarán anuncios durante la generación de imágenes | Confirmado |
| Los anuncios de generación de imágenes se dirigen inicialmente a usuarios Free/Go en Estados Unidos | Confirmado |
Esta distinción hace que la historia original sea más útil.
La actualización genuina ya es sustancial sin convertir cada rumor de producto en una hoja de ruta consolidada.
Sí. El responsable de ingeniería de OpenAI, Tibo Sottiaux, afirmó que GPT-6 Astra y GPT-6.1 Sol se optimizaron para ser aproximadamente un 50% más rápidos de forma predeterminada mediante acceso por suscripción elegible.
No se anunció una garantía fija de 50 TPS. Las mediciones y resúmenes de la comunidad usan aproximadamente 30 a 50 TPS para ilustrar el cambio, pero el rendimiento real varía según el modelo, la tarea, el producto y las condiciones de ejecución.
El anuncio del Día 1 describe específicamente el acceso por suscripción en productos de OpenAI y socios que usan Sign in with ChatGPT. No debe generalizarse como una afirmación de que todo el tráfico de API recibió el mismo cambio.
SemiAnalysis midió límites de suscripción y los convirtió en valor teórico equivalente de API usando una carga de trabajo agéntica representativa. Para Claude Opus 5.5 frente a GPT-6.1 Sol, su instantánea de octubre mostró aproximadamente entre 5.4× y 5.6× más valor equivalente de API en niveles equivalentes de $20, $100 y $200.
OpenAI está simplificando y conectando estas experiencias, pero no existe un anuncio oficial de que las cuatro se conviertan en una misma interfaz idéntica. La documentación actual sigue tratando Codex como una vista de desarrollo separada y Dots como una capacidad de agente siempre activo.
No. OpenAI indica que el texto elegible de ChatGPT y Codex en la UE recibirá marcado de agua invisible textGrain, mientras que los clientes de API de todo el mundo pueden optar por usarlo en modelos seleccionados. El marcado de agua de API está desactivado de forma predeterminada.
OpenAI ha anunciado una prueba de anuncios visuales durante la generación de imágenes para usuarios Free y Go en Estados Unidos. La prueba inicial comienza más adelante en octubre de 2026, y los anuncios permanecen etiquetados y separados de las imágenes generadas.
Tibo anunció un periodo de 28 días durante el que el equipo planea lanzar cada día una mejora clara relevante para la mayoría de los usuarios de Codex/Work o un reinicio más amplio. La primera mejora anunciada fue el aumento de velocidad de GPT-6 Astra y GPT-6.1 Sol.
La primera actualización de OpenAI en su impulso de lanzamientos de 28 días es directa: GPT-6 Astra y GPT-6.1 Sol deberían sentirse aproximadamente un 50% más rápidos de forma predeterminada mediante acceso por suscripción elegible, incluidas las herramientas asociadas compatibles que usan Sign in with ChatGPT.
Al mismo tiempo, las pruebas de suscripción de SemiAnalysis muestran por qué la velocidad es solo una parte de la competencia. Bajo sus supuestos de cargas de trabajo agénticas, las suscripciones de Claude Opus 5.5 proporcionan actualmente más de cinco veces el valor equivalente de API de los planes GPT-6.1 Sol a precios mensuales comparables.
La fuente también relaciona este momento con cambios más amplios de producto de OpenAI. Algunos son oficiales —marcado de agua de texto en la UE, anuncios visuales durante pruebas de generación de imágenes, Work, Dots e integración más profunda del producto—. Otros, como una fusión completa de Chat/Work/Codex/Dots y la desaparición de la selección de modelos, siguen siendo especulación de la comunidad en lugar de política de producto anunciada.
GPT-6 es más rápido, pero la competencia más amplia está cambiando hacia la economía total de los agentes: velocidad, límites, eficiencia del modelo, acceso a herramientas y cuánto trabajo real puede completar una suscripción antes de que se agote su cuota.
Empieza con una sola frase y obtén un sitio completo en minutos.



