For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/grok-4-6-released-agentic-performance.md.
SpaceXAI lanzó Grok 4.6 el 12 de agosto de 2026, posicionándolo como un modelo de vanguardia para programación, tareas de agente de larga du...
SpaceXAI lanzó Grok 4.6 el 12 de agosto de 2026, posicionándolo como un modelo de vanguardia orientado a programación, tareas de agente de larga duración y trabajo de conocimiento.
El modelo se construye directamente sobre Grok 4.5, pero con un enfoque más concentrado y pragmático: mantener la eficiencia en trabajos continuos más extensos, utilizar herramientas en múltiples pasos y generar mejores versiones iniciales para aplicaciones interactivas y visuales.
Según SpaceXAI y Cursor, Grok 4.6 ahora está a la par con GPT-5.6 Sol en el Índice de Inteligencia de Artificial Analysis, al tiempo que muestra resultados particularmente destacados en evaluaciones de agentes del mundo real como GDPval-AA v2 y AA-Briefcase.
El artículo original de AIBase también destacó el precio y la velocidad de servicio de Grok 4.6. La ventaja de precio está plenamente respaldada en la documentación oficial. Los datos de velocidad requieren una interpretación más matizada: AIBase reporta 80 TPS, mientras que Artificial Analysis mide actualmente el API de Grok 4.6 de primera parte en aproximadamente 68 tokens de salida por segundo. La velocidad en tiempo de ejecución varía según la infraestructura, la longitud del prompt, la intensidad de razonamiento y la carga del proveedor.
Grok 4.6 es una generación de modelo incremental, no el lanzamiento de una arquitectura completamente nueva.
SpaceXAI afirma que el nuevo modelo recibió entrenamiento complementario más extenso que Grok 4.5. La combinación de contenidos de entrenamiento incluye:
La compañía afirma que Grok 4.5 también se utilizó para regenerar trayectorias de ajuste supervisado para tareas de STEM, ingeniería de software y trabajo de conocimiento, y se emplearon filtros basados en modelos para eliminar rastros problemáticos.
Grok 4.5 ya había completado su entrenamiento a escala masiva.
SpaceXAI declaró oficialmente que el entrenamiento de Grok 4.5 utilizó decenas de miles de GPU NVIDIA GB300. Sus datos de entrenamiento abarcan programación, ciencia, ingeniería y matemáticas, mientras que el aprendizaje por refuerzo se centró principalmente en tareas de ingeniería de software de múltiples pasos y otros trabajos técnicos de larga duración.
Grok 4.6 es una extensión de esta base, no un reemplazo.
El cambio más importante radica en el énfasis en el comportamiento continuo de los agentes: el modelo no debe limitarse a resolver problemas de programación aislados, sino mantener coherencia a lo largo de la investigación, la edición de archivos, el uso de herramientas, la prueba del propio trabajo y los ciclos de iteración con retroalimentación.
SpaceXAI afirma que Grok 4.6 se entrenó en un amplio conjunto de tareas de aprendizaje por refuerzo para agentes.
Estos entornos incluyen:
Esto ayuda a explicar por qué el modelo destaca más en evaluaciones que implican trabajo extendido en lugar de razonamiento de respuestas cortas.
SpaceXAI y Cursor también destacan
la capacidad del modelo para transformar conceptos de producto amplios en versiones iniciales utilizables.
En pruebas internas, Grok 4.6 fue capaz de:
Esto no significa que cada aplicación generada de una sola vez esté lista para producción. Simplemente indica que la compañía descubrió que la calidad de su resultado inicial es superior a la de Grok 4.5, especialmente cuando la tarea requiere combinar código, diseño, interacción y uso iterativo de herramientas.
Artificial Analysis otorga actualmente a Grok 4.6 (versión alta) una puntuación de 61 en el Índice de Inteligencia.
Esto coincide con la puntuación total de GPT-5.6 Sol (versión máxima) en la comparación publicada por SpaceXAI.
El índice es un resultado compuesto de nueve evaluaciones, no una prueba única, por lo que es más apropiado como una señal de comparación amplia que como evidencia de que ambos modelos se desempeñan exactamente igual en todas las cargas de trabajo.
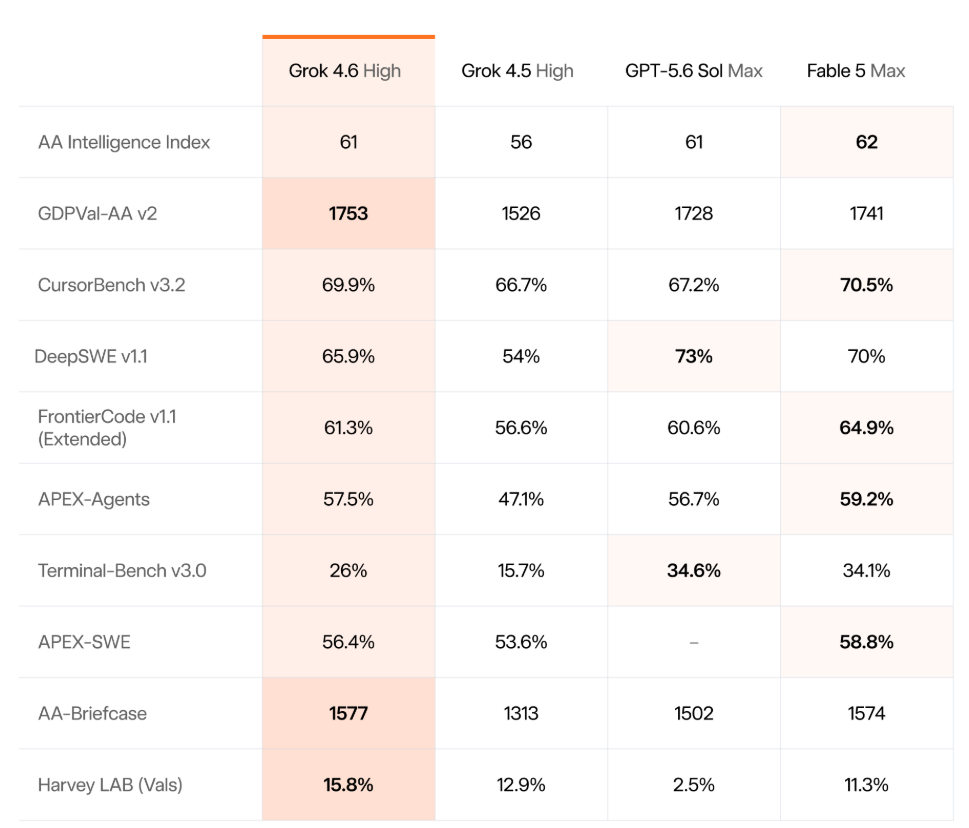
La tabla de puntos de referencia incluida en el lanzamiento contiene los siguientes resultados:
| Punto de referencia | Grok 4.6 versión alta | Grok 4.5 versión alta | GPT-5.6 Sol Max | Fable 5 Max |
|---|---|---|---|---|
| Índice de Inteligencia AA | 61 | 56 | 61 | 62 |
| GDPval-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 Extendido | 61.3% | 56.6% | 60.6% | 63.6% |
| APEX-Agents | 57.5% | 47.1% | 56.7% | 59.2% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
| APEX-SWE | 56.4% | 53.6% | — | 58.8% |
| AA-Briefcase | 1577 | 1313 | 1502 | 1574 |
| Harvey LAB (Vals) | 15.8% | 12.9% | 2.5% | 11.3% |
Las clasificaciones de los puntos de referencia cambian a medida que se actualizan los modelos, los marcos de prueba y las versiones de evaluación. La tabla anterior refleja los resultados comparativos en el momento del lanzamiento, no una clasificación permanente.
En GDPval-AA v2, Grok 4.6 obtuvo una puntuación de 1753 Elo.
Artificial Analysis describe GDPval-AA v2 como una evaluación de trabajo de conocimiento de agentes en el mundo real que abarca múltiples profesiones especializadas.
En el momento del análisis del lanzamiento de Grok 4.6, Artificial Analysis indicó que esta puntuación solo era superada por la serie Claude Opus 5, mientras que los intervalos de confianza se superponían con otros modelos líderes como Claude Fable 5 y Qwen3.8 Max.
Esto es más riguroso que afirmar directamente que Grok 4.6 ocupa claramente el segundo lugar.
Las evaluaciones basadas en Elo conllevan incertidumbre, y puntuaciones cercanas pueden superponerse estadísticamente.
Grok 4.6 también obtuvo 1577 Elo en AA-Briefcase.
La puntuación. Esto es un benchmark privado establecido por Artificial Analysis para trabajo de conocimiento agéntico de ciclo largo.
Esto hace que su puntuación——
En la instantánea publicada, el rendimiento de Grok 4.6 es aproximadamente equivalente al nivel de Fable 5, rezagado respecto a la serie Claude Opus 5.
Su eficiencia también merece atención.
Artificial Analysis informa que Grok 4.6, al completar sus tareas AA-Briefcase, utilizó aproximadamente:
En comparación, se informa que Claude Opus 5 (versión máxima) utilizó aproximadamente:
Esto no significa que Grok 4.6 sea más eficiente que Claude Opus 5 en todos los casos. Es solo una observación para este benchmark específico. Aun así, para agentes inteligentes de larga ejecución, menos turnos y menos contexto acumulado pueden reducir significativamente el costo de las tareas.
El precio estándar de la API pública sigue siendo una de las ventajas competitivas más fuertes de Grok 4.6.
Para avisos por debajo del umbral de precio de contexto largo, la documentación de SpaceXAI indica lo siguiente:
| Tipo de token | Precio por millón de tokens |
|---|---|
| Entrada | 2,00 USD |
| Entrada en caché | 0,50 USD |
| Salida | 6,00 USD |
Artificial Analysis señala que, a pesar de que la puntuación del índice de inteligencia subió de 56 a 61, este precio público se mantiene sin cambios respecto a Grok 4.5.
En comparación, al momento de redactar este artículo:
Esto hace que Grok 4.6 sea especialmente atractivo para bucles de agentes de alto rendimiento, donde los tokens de salida y el contexto repetido tienden a representar la mayor parte del costo total.
Las notas oficiales de lanzamiento de SpaceXAI añaden un detalle importante que el breve artículo de AIBase no menciona.
Para avisos de más de 200 000 tokens, Grok 4.6 utiliza un nivel de precios más alto:
| Tipo de token | Precio por millón de tokens para avisos de más de 200 000 |
|---|---|
| Entrada | 4,00 USD |
| Entrada en caché | 1,00 USD |
| Salida | 12,00 USD |
Por lo tanto, "2 USD de entrada / 6 USD de salida" es el precio inicial, no un precio universal aplicable a todas las solicitudes.
Cursor indica que la variante rápida tiene un precio de el doble del precio estándar.
Esto es independiente de las reglas de precios para avisos largos mencionadas anteriormente. Según la plataforma y la carga de trabajo, los usuarios deben confirmar el nivel de velocidad y el nivel de contexto aplicables antes de estimar los costos de producción.
El artículo de AIBase afirma que Grok 4.6 puede ejecutarse a 80 tokens por segundo.
Esta cifra debe tomarse con cautela.
El anuncio oficial de Grok 4.6 de SpaceXAI no publica una garantía fija de servicio a 80 TPS. Artificial Analysis actualmente mide, en su carga de trabajo de referencia, una velocidad de salida de aproximadamente 67,6 tokens de salida por segundo para Grok 4.6 (alto) en la API de primera parte.
En comparación, la página de lanzamiento oficial de Grok 4.5 de SpaceXAI indica explícitamente que Grok 4.5 se sirve a 80 TPS.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Por lo tanto, el artículo fuente breve probablemente reutilizó la cifra anterior de 80 TPS o citó un nivel de servicio diferente.
El punto práctico es más simple:
Grok 4.6 tiene una velocidad bastante buena para un modelo de razonamiento de vanguardia, pero no existe una cifra fija única de TPS aplicable a todos los avisos, proveedores, niveles de razonamiento o niveles de velocidad.
La documentación de la API de SpaceXAI lista la ventana de contexto de grok-4.6 como 500 000 tokens.
El modelo admite:
La página oficial del modelo también indica una fecha límite de conocimiento del 1 de febrero de 2026.
La documentación del modelo Grok 4.6 de Cursor actualmente lista una ventana de contexto de 256k dentro de Cursor.
Esto no contradice las especificaciones del modelo base. Significa que la integración de la plataforma puede exponer un límite de contexto más pequeño que el de la API de primera parte de SpaceXAI.
Al comparar límites de modelos, verifique siempre el proveedor y la integración exactos utilizados.
El ID oficial del modelo de SpaceXAI es:
grok-4.6
Una solicitud mínima a la API de Responses se ve así:
curl https://api.x.ai/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -d '{
    "model": "grok-4.6",
    "input": "Encuentra y corrige el error, luego explícalo: function median(a){a.sort();return a[a.length/2]}"
  }'
El mismo modelo también está disponible a través del SDK oficial de xAI y de clientes API compatibles con OpenAI.
import os
from xai_sdk import Client
from xai_sdk.chat import user

client = Client(api_key=os.getenv("XAI_API_KEY"))

chat = client.chat.create(model="grok-4.6")
chat.append(
    user(
        "Encuentra y corrige el error, luego explícalo: "
        "function median(a){a.sort();return a[a.length/2]}"
    )
)

response = chat.sample()
print(response.content)
Para bucles de agentes de larga duración, SpaceXAI recomienda usar caché de avisos y compresión de contexto cuando sea apropiado, para reducir los costos de contexto repetido.
Al momento del lanzamiento, Grok 4.6 está disponible en las siguientes plataformas:
SpaceXAI y Cursor también ofrecen el doble de uso incluido durante la primera semana en Cursor y Grok Build.
Esta promoción de lanzamiento es por tiempo limitado y no debe considerarse un precio permanente.
Cursor muestra Grok 4.6 con cuatro niveles de intensidad de razonamiento:
high es la intensidad de razonamiento predeterminada.
En los planes de Cursor elegibles, también está disponible el nivel de velocidad rápida.
Dentro de Cursor, el modelo puede usar las herramientas de agente de la plataforma para:
Esta es una de las razones por las que el lanzamiento de Grok 4.6 da tanta importancia a los benchmarks de agentes: su uso previsto no se limita a completaciones de chat aisladas.
Los resultados del modo de referencia indican que la mayor mejora de Grok 4.6 no reside únicamente en el razonamiento estático.
Sus mejoras son más evidentes cuando las tareas implican lo siguiente:
Esto lo hace especialmente adecuado para:
Tareas de trabajo intensivo en conocimiento de larga duración
Para indicaciones breves y sencillas, esta ventaja puede no ser tan evidente.
Los datos publicados respaldan las siguientes conclusiones claras:
Pero los datos no demuestran que Grok 4.6 sea universalmente superior a GPT-5.6 Sol o Claude en todas las tareas.
Por ejemplo, la misma tabla de resultados muestra que GPT-5.6 Sol lidera en DeepSWE v1.1 y Terminal-Bench v3.0, mientras que Claude Fable 5 destaca en varias otras evaluaciones de programación y agentes.
Por lo tanto, la elección del modelo debe basarse en la carga de trabajo real, no en una única puntuación compuesta.
Grok 4.6 es el modelo de vanguardia de SpaceXAI para programación, tareas de agentes y trabajo de conocimiento. Se basa en Grok 4.5 con entrenamiento adicional, centrado en agentes de larga duración, mayor capacidad para construir aplicaciones en el primer intento y trabajo multi-paso más persistente.
Depende de la tarea. En las comparativas publicadas, Grok 4.6 está a la par con GPT-5.6 Sol en el Índice de Inteligencia de Artificial Analysis y lidera en algunos puntos de referencia de agentes, mientras que GPT-5.6 Sol sigue siendo más fuerte en ciertos puntos de referencia de programación. Ambos modelos también difieren significativamente en precio y longitud de contexto.
El precio estándar es de 2 dólares por millón de tokens de entrada, 0,50 dólares por millón de tokens de entrada en caché y 6 dólares por millón de tokens de salida. Para indicaciones de más de 200.000 tokens, la documentación de SpaceXAI establece niveles de precio más altos: 4 dólares / 1 dólar / 12 dólares por millón para entrada, entrada en caché y salida, respectivamente.
La API de primera parte de SpaceXAI admite una ventana de contexto de 500.000 tokens. Cursor ofrece actualmente una ventana de contexto de 256.000 tokens para su propia integración con Grok 4.6, por lo que el límite real depende de la plataforma.
Sí. SpaceXAI lista a Grok 4.6 como compatible con entrada de texto e imágenes, así como salida de texto. El modelo también admite herramientas como llamadas a funciones, búsqueda web, búsqueda en X y ejecución de código, disponibles a través de la API de xAI.
Sí. Grok 4.6 ya está disponible en Cursor y admite intensidades de razonamiento xhigh, high, medium y low. Cursor también le otorga acceso a su conjunto de herramientas de agente para operaciones de archivos, comandos de shell, navegación y otros flujos de trabajo de programación.
No. Grok 4.6 es un modelo propietario; SpaceXAI no ha publicado sus pesos ni el número de parámetros.
AIBase informa 80 tokens por segundo, pero las mediciones actuales de Artificial Analysis muestran que la API de primera parte de Grok 4.6 produce aproximadamente 68 tokens de salida por segundo en su carga de trabajo de referencia. La velocidad varía según la intensidad de razonamiento, el tamaño de la indicación, la carga de infraestructura y el nivel de plataforma.
Grok 4.6 es una actualización específica de Grok 4.5, centrada en agentes de larga duración, codificación, trabajo de conocimiento y calidad de ejecución en el primer intento en proyectos interactivos. Sus resultados de lanzamiento lo sitúan a la vanguardia de las evaluaciones de modelos actuales, logrando una puntuación de 61 en el Índice de Inteligencia de Artificial Analysis, a la par con GPT-5.6 Sol en las comparativas publicadas.
La mayor fortaleza de este lanzamiento reside en la combinación de rendimiento de agentes y precio. Grok 4.6 parte de 2 dólares por millón de tokens de entrada y 6 dólares por millón de tokens de salida, al tiempo que obtiene puntuaciones altas en GDPval-AA v2 y AA-Briefcase. Las indicaciones largas y los niveles rápidos pueden generar costos más elevados, por lo que las estimaciones de producción deben utilizar la configuración exacta del proveedor.
Los datos publicados de 80 TPS deben tratarse con cautela: las mediciones independientes actuales rondan los 68 tokens de salida por segundo, y la velocidad del servicio varía con el tiempo.
**Grok 4.6
Su principal ventaja no radica en que haya ganado todas las pruebas de referencia, sino en que ahora ofrece un rendimiento de agente de vanguardia a un precio extremadamente competitivo.
Empieza con una sola frase y obtén un sitio completo en minutos.



