For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/grok-45-coding-agent-model-pricing-benchmarks.md.
Grok 4.5 se presenta como un modelo rápido y rentable para codificación, flujos de trabajo de agentes y trabajo de conocimiento. Tiene un re...
Grok 4.5 finalmente ha llegado.
Según el informe original, xAI lanzó Grok 4.5 como su modelo insignia más potente hasta la fecha, con un claro enfoque en programación, tareas de agentes de larga duración y trabajo de conocimiento. El modelo fue entrenado conjuntamente con Cursor, y el titular no es solo el rendimiento bruto en benchmarks. La historia más importante es la combinación de rendimiento, velocidad y costo.
El artículo posiciona a Grok 4.5 como un desafiante práctico frente a modelos de primer nivel como GPT-5.5, Opus 4.8 y Fable 5. No se describe como el modelo más fuerte en todos los aspectos. En cambio, su ventaja se acerca más a esto: lo suficientemente potente para entrar en el primer nivel, mucho más rápido que muchos competidores y mucho más barato de ejecutar en tareas de ingeniería con uso intensivo de tokens.
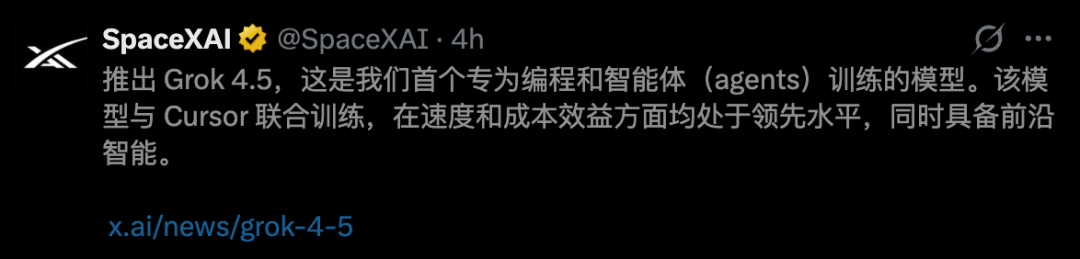
El mensaje del lanzamiento es directo: Grok 4.5 está diseñado para programación, flujos de trabajo de agentes y tareas de conocimiento complejas.
Esto es importante porque el centro de la competencia en IA ha ido más allá de las respuestas cortas. Para desarrolladores y equipos, la verdadera prueba es si un modelo puede seguir trabajando en tareas de ingeniería de múltiples pasos, usar herramientas, recuperarse de errores y producir artefactos útiles sin desperdiciar grandes cantidades de contexto y dinero.
En el artículo original, Grok 4.5 se describe como el primer gran modelo insignia de xAI después del último cambio estratégico de la empresa, y también el primer resultado importante de la colaboración entre xAI y Cursor.
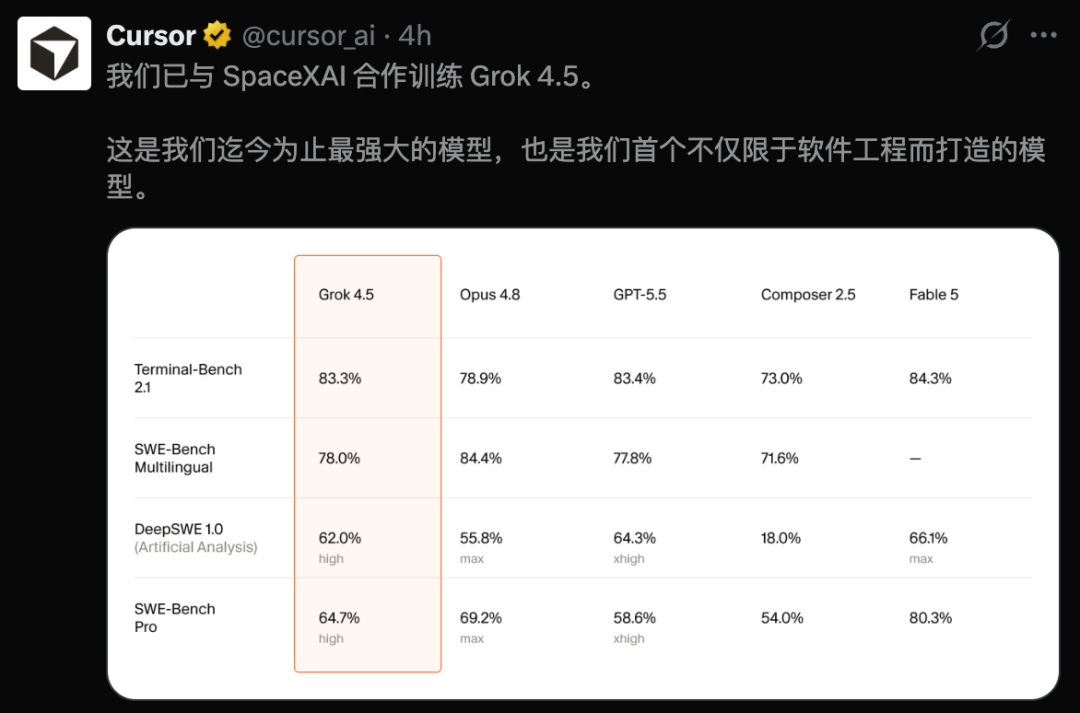
Los resultados reportados en benchmarks son sólidos:
Estas cifras sitúan a Grok 4.5 cerca del grupo superior de los modelos actuales de programación y agentes. No se describe como superior a todos los modelos en todos los aspectos, pero parece competitivo donde los agentes de ingeniería realmente importan.
El artículo original dice que Grok 4.5 fue entrenado con decenas de miles de GPU NVIDIA GB300. Esto le da al modelo una enorme base de cómputo, pero el cómputo por sí solo no lo es todo.
La parte más importante son los datos.
Según se informa, xAI utilizó un filtrado intensivo, deduplicación, puntuación de calidad y selección centrada en dominios para mantener los datos de entrenamiento densos y útiles. En otras palabras, el modelo no solo fue entrenado con grandes cantidades de texto. La mezcla de entrenamiento fue
diseñado para incluir material de mayor señal para codificación, ingeniería, ciencia, matemáticas y trabajo de conocimiento.
Otra idea importante es la inteligencia por token. El artículo describe el enfoque de aprendizaje por refuerzo de xAI como una mejora en la cantidad de razonamiento útil que el modelo puede producir por token. Esta es una métrica práctica porque los flujos de trabajo de agentes a menudo se vuelven costosos cuando un modelo escribe demasiado, reintenta con demasiada frecuencia o toma un camino largo para resolver una tarea.

La colaboración con Cursor es especialmente importante aquí. Los datos de Cursor reflejan cómo los desarrolladores reales interactúan con bases de código, herramientas y agentes. Esto significa que Grok 4.5 no solo está aprendiendo cómo se ve el código. También está aprendiendo cómo los desarrolladores y los agentes de IA trabajan juntos en entornos prácticos.
El artículo también señala que la pila de entrenamiento del modelo fue diseñada para un trabajo altamente asíncrono. Los despliegues de agentes pueden ejecutarse durante horas, mientras que el entrenamiento continúa en todo el clúster de computación. Esta configuración es importante para tareas de largo horizonte, donde el modelo necesita mantenerse coherente a través de múltiples pasos en lugar de solo resolver una instrucción corta.
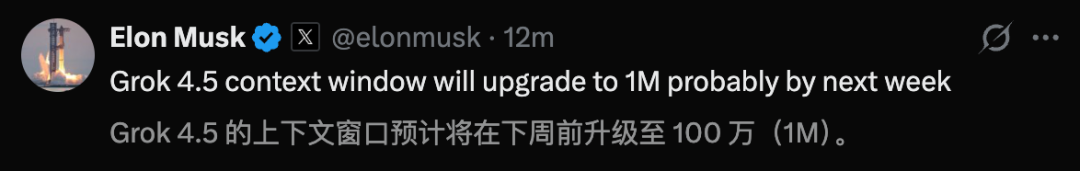
La historia de los puntos de referencia de Grok 4.5 no es una simple historia de "el mejor modelo lo gana todo". Es más matizada.
En varios puntos de referencia de ingeniería centrales, el modelo se desempeña como un competidor de primer nivel:
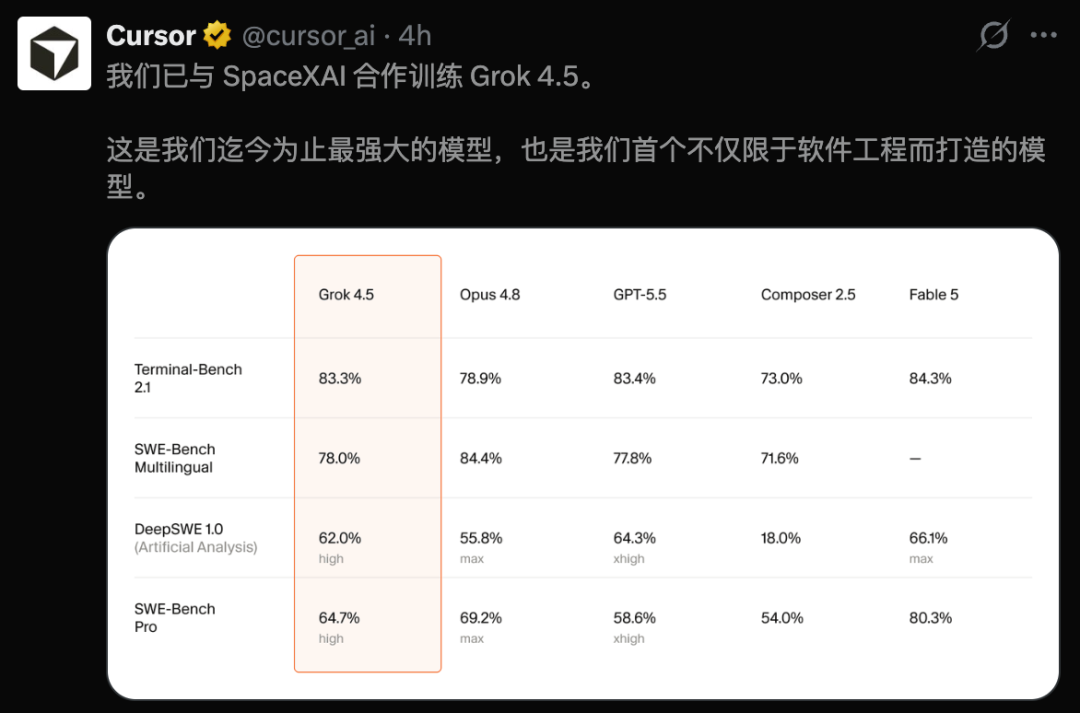
La conclusión del artículo es clara: Grok 4.5 es sólido, pero Claude Fable todavía parece ocupar la primera posición en algunas evaluaciones de gama alta.
Eso hace que Grok 4.5 sea interesante por una razón diferente. Puede que no
ser el modelo de techo absoluto. Pero podría ser uno de los modelos más potentes si comparas rendimiento por dólar, rendimiento por segundo y tokens usados por tarea resuelta.
El punto de venta más fuerte de Grok 4.5 es la eficiencia en costes.
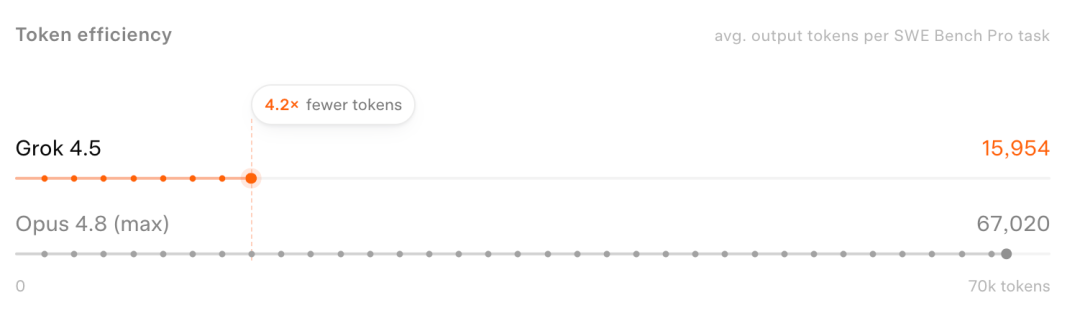
Se informa que el modelo funciona a aproximadamente 80 tokens por segundo, lo que xAI describe como velocidad de modelo rápido. El artículo lo presenta como una diferencia clave frente a los modelos de razonamiento de alta gama más lentos. Si un modelo es capaz y rápido, se vuelve más práctico para el trabajo diario de ingeniería, no solo para tareas difíciles puntuales.
También utiliza menos tokens de salida en tareas de ingeniería comparadas. En SWE Bench Pro, se reporta que Grok 4.5 resuelve tareas con un promedio de 15,954 tokens de salida, mientras que Opus 4.8 utiliza aproximadamente 67,020 tokens de salida en la misma clase de tarea.
Esa es la famosa afirmación de 4,2 veces menos tokens.
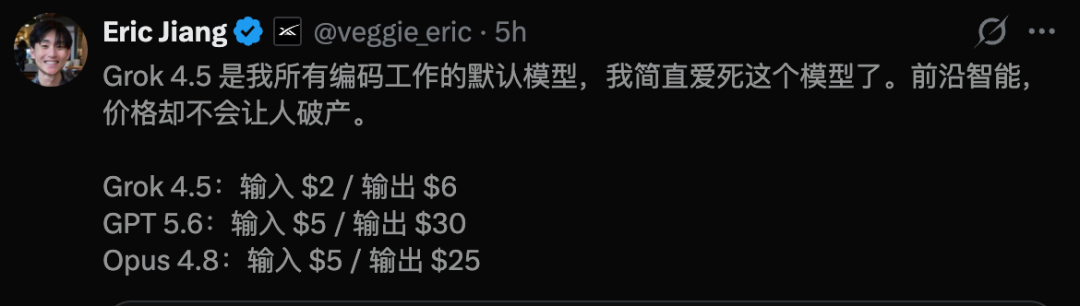
El precio es otra parte importante de la historia:
| Modelo / Variante | Precio de entrada | Precio de salida | Notas |
|---|---|---|---|
| Grok 4.5 | $2 / 1M tokens | $6 / 1M tokens | Versión base descrita en el lanzamiento oficial |
| Variante más rápida de Grok 4.5 | $4 / 1M tokens | $18 / 1M tokens | Variante premium de mayor velocidad mencionada en el artículo |
| Comparación con Opus 4.8 | Más alto en muchas comparaciones | Más alto en muchas comparaciones | Usado como punto de referencia en el artículo |
| Comparación con GPT-5.5 | Más alto en muchas comparaciones | Más alto en muchas comparaciones | Usado como punto de referencia en el artículo |
La conclusión práctica es simple: si un agente de ingeniería necesita leer, escribir, probar e iterar repetidamente, el coste de tokens se convierte en una restricción importante del producto. Grok 4.5 está diseñado para abaratar ese ciclo.
El artículo original destaca una demo de un solo prompt donde Grok 4.5 crea una simulación del sistema solar usando Three.js.
El prompt pide una simulación hermosa del universo y el sistema solar con tiempo ajustable, movimiento realista, órbitas, estrellas y un HUD moderno. La salida incluye una simulación basada en navegador con movimiento de planetas, aceleración temporal, controles, etiquetas y una interfaz estilizada.
aliyuncs.com/cms-assets/image/2026/07/3a876f29-3629-4a70-8d27-339076f464da-09-520ff31e-7006-4e98-bbaf-43a66b9edad1.gif)
Este tipo de demostración importa porque pone a prueba algo más que la sintaxis del código. Un buen modelo de generación front-end debe combinar:
Una sola demostración no prueba que un modelo esté listo para producción, pero sí muestra por qué los desarrolladores están prestando atención. Grok 4.5 parece ser fuerte a la hora de convertir indicaciones amplias de tipo producto en artefactos completos y funcionales.
El artículo también recopiló pruebas tempranas de usuarios de la comunidad.
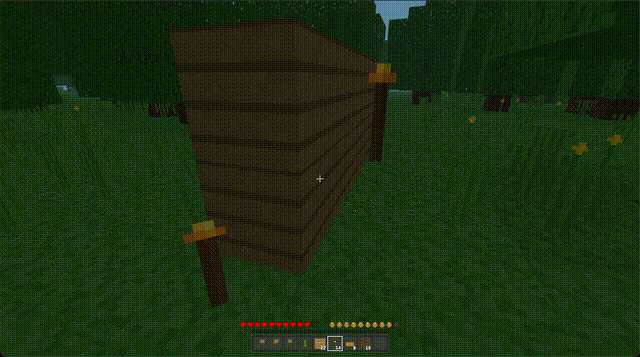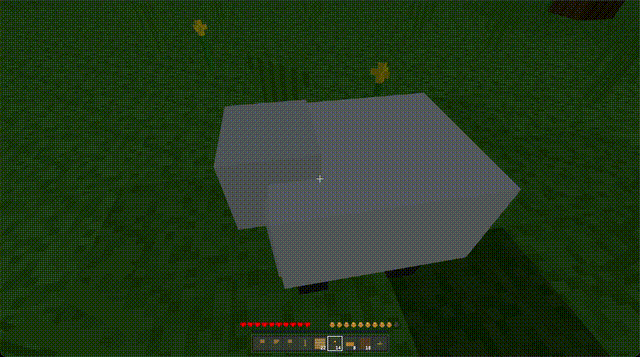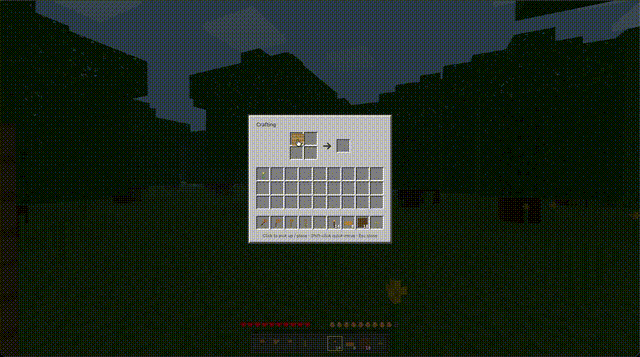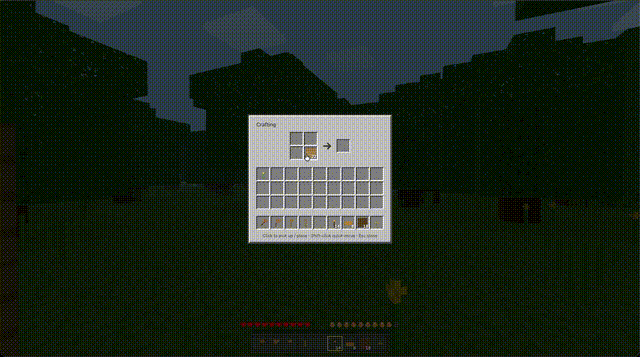
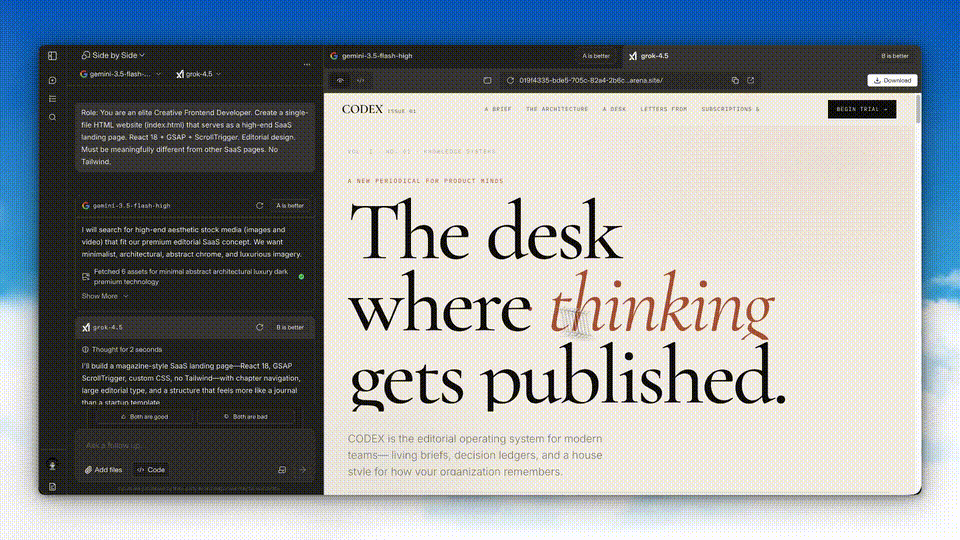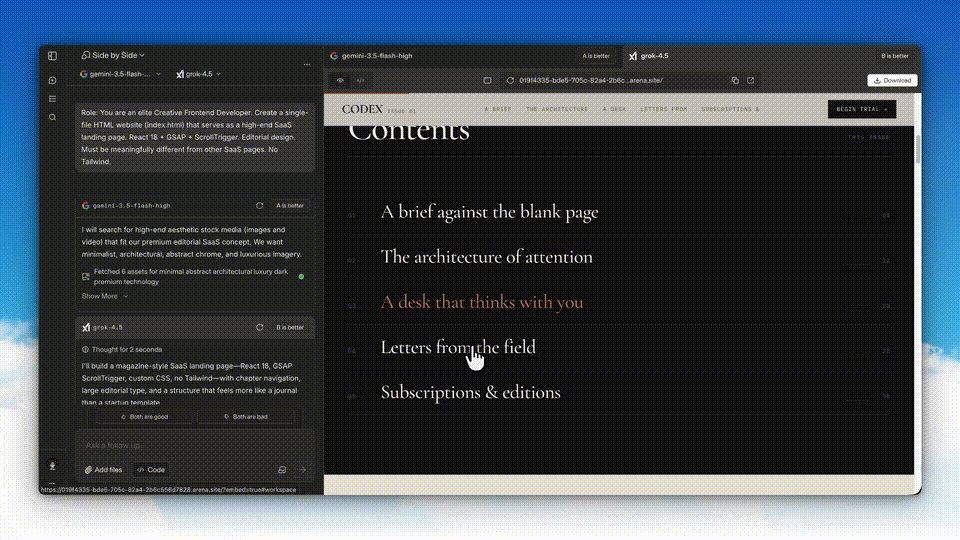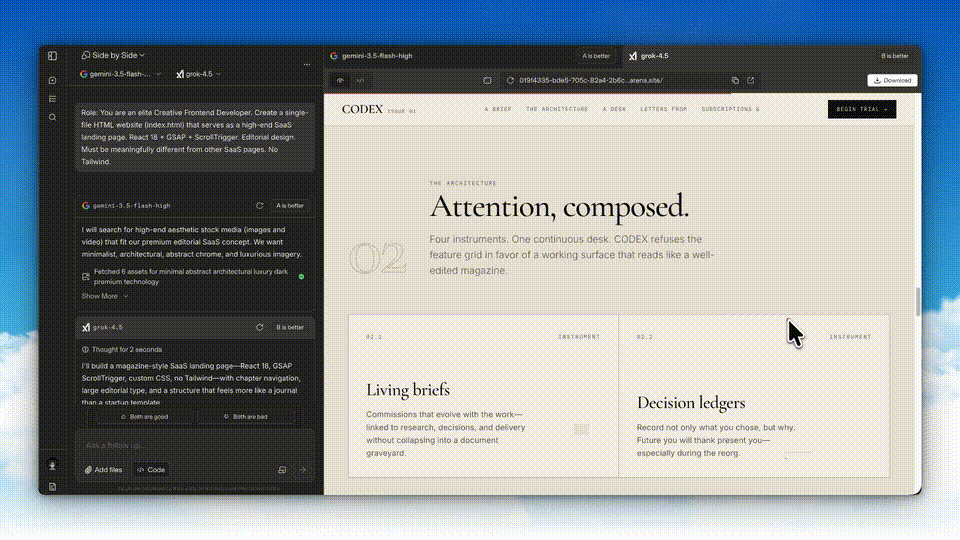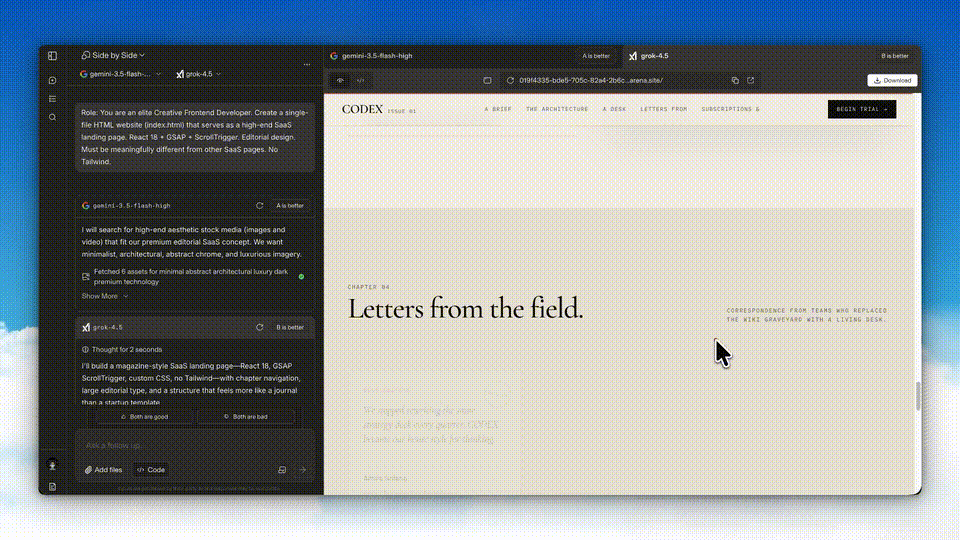
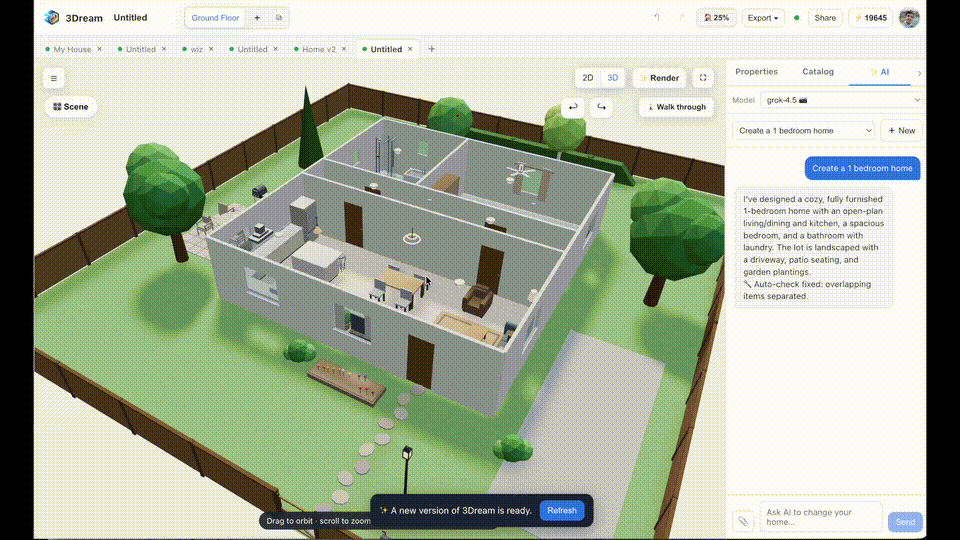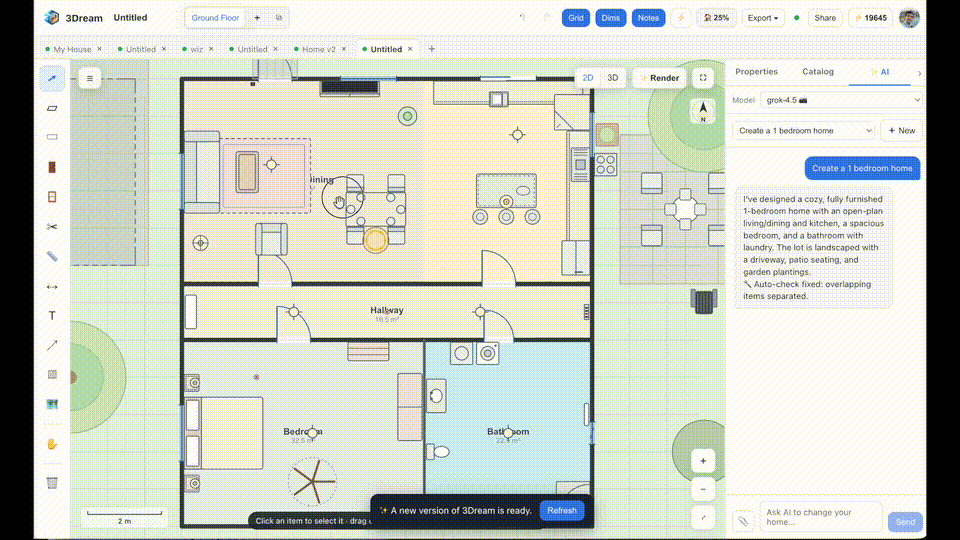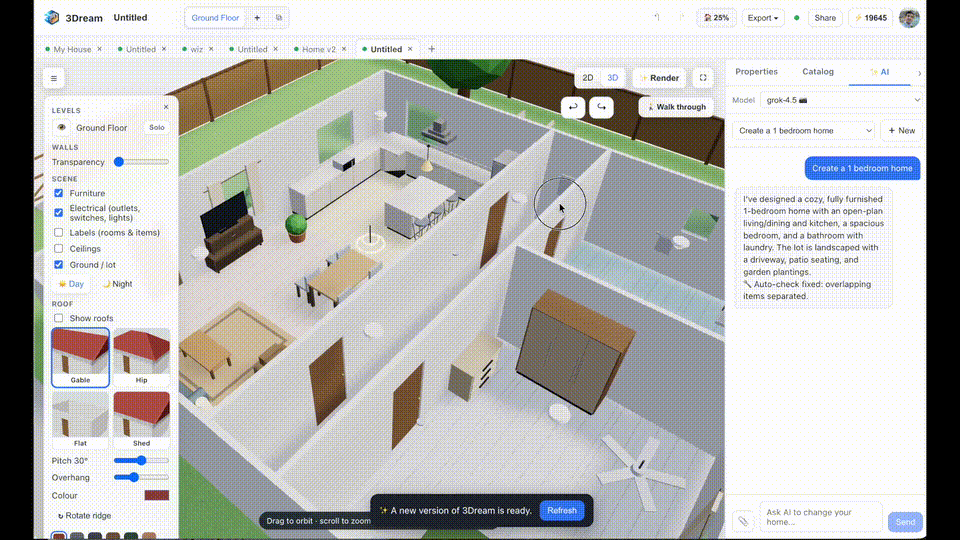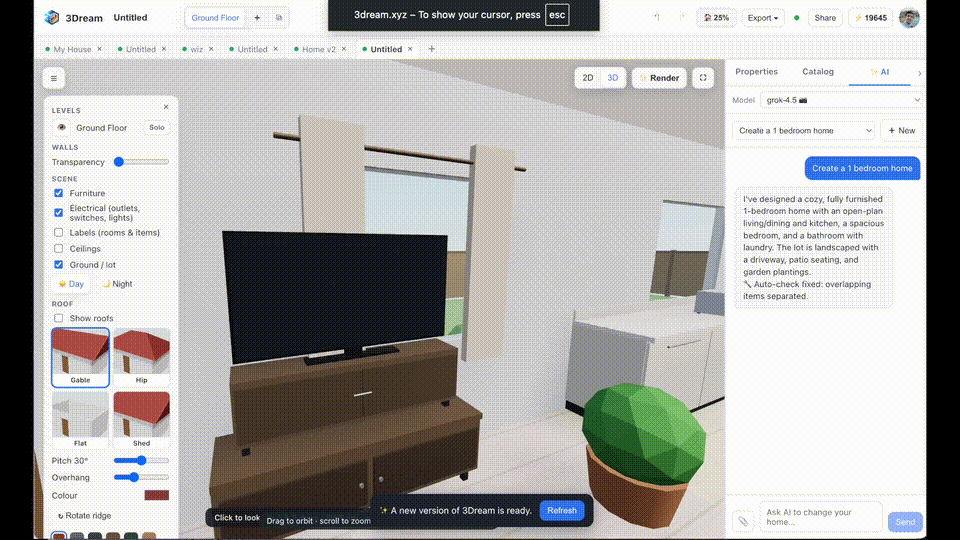
Un ejemplo muestra a Grok 4.5 generando una escena similar a Minecraft. Otro lo muestra creando una página de aterrizaje SaaS refinada en un solo archivo HTML. También hay ejemplos de trabajo de diseño en 2D y 3D, generación de diseños de aplicaciones y flujos de trabajo simples de creación de juegos.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Los resultados no son uniformemente perfectos. El artículo también menciona críticas de algunos desarrolladores que sintieron que Grok 4.5 no igualaba a Opus 4.7 en ciertas pruebas de codificación visual o creativa, incluyendo una tarea de generación al estilo de lámpara de lava que tuvo un rendimiento pobre.
Esa crítica es útil. Mantiene la evaluación con los pies en la tierra. Un modelo puede ser excelente en codificación agente y aún así fallar en algunas tareas estéticas, de simulación física o de detalle visual.
El papel de Cursor en Grok 4.5 es una de las partes más importantes del lanzamiento.
El blog de Cursor describe a Grok 4.5 como un modelo entrenado junto con xAI y diseñado para más que la ingeniería de software. El entrenamiento incluyó billones de tokens de datos de Cursor, capturando cómo los desarrolladores interactúan con bases de código, herramientas y agentes de IA.
Esa es una señal diferente del código estático. El código estático enseña al modelo el resultado final. Los datos de interacción desarrollador-agente enseñan el proceso:
el agente se recupera después de un intento fallido.
7. Cómo se verifica el cambio final.
Para agentes de codificación, esta señal de flujo de trabajo puede ser tan importante como el conocimiento bruto de codificación.
El lanzamiento sugiere que los modelos de codificación de IA se están moviendo hacia tres objetivos prácticos:
Los modelos necesitan manejar tareas que requieren muchos pasos, no solo interacciones breves de pregunta-respuesta. Esto incluye planificar, buscar, editar, probar y corregir errores.
A los equipos les importa el costo final de resolver una tarea, no solo el precio por token del modelo. Si un modelo usa muchos menos tokens para llegar a una solución, puede ser más barato incluso cuando su precio general parezca similar.
Los agentes de codificación modernos viven en entornos de herramientas. Deben comprender terminales, editores, navegadores, rastreadores de incidencias, árboles de archivos y sistemas de compilación. Un modelo entrenado con datos reales de interacción entre desarrolladores y agentes puede tener una ventaja aquí.
El lanzamiento oficial de xAI dice que Grok 4.5 está disponible a través de Grok Build, Cursor y la consola API de xAI. La página oficial también proporciona un ejemplo simple de API.
curl -s https://api.x.ai/v1/responses \
  -H "Authorization: Bearer $XAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "grok-4.5",
    "input": "Encuentra y corrige el error, luego explícalo: function median(a){a.sort();return a[a.length/2]}"
  }'
Las notas de lanzamiento originales también mencionan que Grok 4.5 no estaba disponible en la UE en el momento del lanzamiento, con disponibilidad en la UE prevista para más adelante. Si planeas usarlo a través de la API o en un producto, siempre consulta la documentación actual de xAI y la página de precios antes de desarrollar en torno a él.
Según el artículo y el marco del lanzamiento oficial, Grok 4.5 parece especialmente relevante para:
No es necesariamente la mejor opción para todos los casos. Para cambios de producción de alto riesgo, salidas legales, asesoramiento financiero o trabajo con clientes sensibles, los equipos aún necesitan revisión, validación y aprobación humana.
Si quieres probar Grok 4.5 para tu propio flujo de trabajo, no confíes solo en demostraciones públicas.
Usa tareas reales de tu propio equipo y compáralas con tu configuración de modelo actual. Una evaluación práctica debe incluir:
El mejor modelo no es
siempre aquel con la puntuación de referencia más alta. Para muchos equipos, el mejor modelo es el que logra el trabajo aceptado al menor costo confiable.
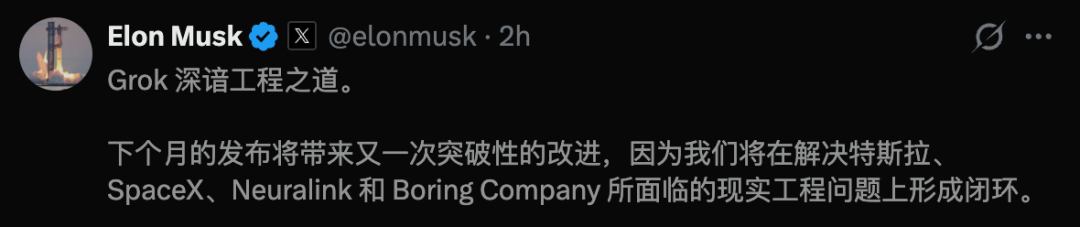
El artículo concluye señalando que Musk insinuó otra mejora transformadora el próximo mes.
El mensaje es que Grok 4.5 puede no ser el modelo definitivo que "da la vuelta a la mesa". Podría ser un movimiento intermedio fuerte: no el modelo más potente en términos absolutos, pero sí uno que hace que la ingeniería de vanguardia sea más barata y rápida de usar.
Eso puede ser suficiente para cambiar la competencia. Cuando la inteligencia se mide como la electricidad, el ganador no es solo el modelo con la puntuación máxima más alta. Puede ser el modelo que puede ofrecer razonamiento sólido de forma barata, rápida y repetida en flujos de trabajo reales.
Grok 4.5 es el modelo insignia de xAI para codificación, tareas agénticas y trabajo de conocimiento. Se presenta como el modelo más potente de la empresa hasta la fecha y se ha entrenado en colaboración con Cursor.
No en todas las métricas. El artículo original informa que Grok 4.5 está cerca de GPT-5.5 y Opus 4.8 en varios puntos de referencia de ingeniería, pero Claude Fable sigue liderando en algunas evaluaciones principales. La principal ventaja de Grok 4.5 es la combinación de velocidad, costo y eficiencia de tokens.
El lanzamiento oficial lista Grok 4.5 a $2 por millón de tokens de entrada y $6 por millón de tokens de salida. También se menciona una variante premium más rápida a $4 por millón de tokens de entrada y $18 por millón de tokens de salida. Siempre verifique la página de precios actual de xAI antes de usarlo en producción.
Está diseñado para codificación, ingeniería de software, tareas agénticas y trabajo de conocimiento. El artículo destaca el rendimiento en los puntos de referencia SWE Bench Pro, Terminal Bench 2.1 y DeepSWE, además de ejemplos que incluyen generación de front-end, demostraciones de Three.js y prototipos similares a juegos.
Cursor colaboró con xAI en Grok 4.5, y el entrenamiento incluyó grandes cantidades de datos de interacción con Cursor. Esos datos reflejan cómo los desarrolladores trabajan con bases de código, herramientas y agentes, lo que puede ayudar al modelo a rendir mejor en flujos de trabajo reales de ingeniería de software.
El artículo informa que Grok 4.5 utilizó un promedio de 15,954 tokens de salida en las tareas de SWE Bench Pro, en comparación con 67,020 tokens de salida para Opus 4.8. Esto significa que se informa que Grok 4.5 resolvió tareas similares con muchos menos tokens generados, reduciendo el costo y la latencia.
Sí. El lanzamiento oficial de xAI dice que Grok 4.5 está disponible a través de la consola API de xAI. El lanzamiento también proporciona un comando curl de muestra usando el endpoint responses y el nombre del modelo grok-4.5.
Sí. El anuncio oficial de Cursor indica que Grok 4.5 está disponible en Cursor para escritorio, web, iOS, CLI y SDK. Cursor también señala que los planes individuales y de equipo incluyen el uso del modelo como parte del grupo de modelos de primera parte.
Grok 4.5 se presenta como un modelo rápido y rentable para codificación, flujos de trabajo agénticos y trabajo de conocimiento. Tiene un rendimiento sólido en puntos de referencia de ingeniería, se beneficia de los datos de colaboración de Cursor y utiliza muchos menos tokens de salida que algunos modelos líderes en tareas de SWE Bench Pro.
Su mayor valor no es que supere a todos los modelos en todos los ámbitos. El punto más importante es que combina inteligencia competitiva con un menor uso de tokens, inferencia más rápida y precios agresivos.
Para los equipos que construyen agentes de codificación con IA, esa combinación es importante. El costo por tarea aceptada, la carga de revisión, el uso de herramientas y la recuperación de fallos pueden ser más importantes que una puntuación única en una tabla de clasificación.
El verdadero mensaje de Grok 4.5 es simple: la próxima carrera de modelos no se trata solo de quién es más inteligente, sino de quién puede ofrecer inteligencia útil de manera más rápida y económica.
Empieza con una sola frase y obtén un sitio completo en minutos.



