For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 es un modelo de frontera orientado a la codificación, agentes y trabajo de conocimiento. Sus ventajas prácticas más destacadas son ...
Grok 4.5 coloca a xAI nuevamente en la primera fila de la competencia de modelos de codificación.
Lanzado el 8 de julio de 2026, el modelo está diseñado para ingeniería de software, tareas agentivas y trabajo de conocimiento más amplio. Fue entrenado con Cursor y ahora está disponible a través de la API de xAI, Grok Build y Cursor. El titular no es solo la calidad del modelo. Grok 4.5 también se posiciona en torno a una entrega más rápida, menos tokens generados y un menor costo por tarea completada.
La documentación oficial del modelo enumera una ventana de contexto de 500,000 tokens, entrada de texto e imágenes, razonamiento configurable, llamada a funciones, soporte de salidas estructuradas y precios de API de $2 por millón de tokens de entrada** y **$6 por millón de tokens de salida.
Este artículo explica dónde se desempeña bien Grok 4.5, cómo deben interpretarse sus afirmaciones de eficiencia, qué cambió en el entrenamiento y por qué el stack de inferencia circundante puede volverse tan importante como el propio modelo.

Grok 4.5 es el modelo insignia de xAI para codificación, trabajo agentivo y tareas generales de conocimiento basadas en computadora. Los materiales de lanzamiento oficiales lo describen como un modelo que puede manejar trabajo de larga duración, usar herramientas, recuperarse de errores y verificar resultados en lugar de detenerse después de una única respuesta.
Esto lo coloca en la misma categoría amplia que los modelos de alta gama utilizados para codificación autónoma, cambios a nivel de repositorio, investigación técnica, análisis de datos y flujos de trabajo de oficina de múltiples pasos.
| Elemento | Grok 4.5 |
|---|---|
| Nombre del modelo | grok-4.5 |
| Casos de uso principales | Codificación, tareas agentivas, trabajo de conocimiento |
| Modalidades de entrada | Texto e imágenes |
| Modalidad de salida | Texto |
| Ventana de contexto | 500,000 tokens |
| Razonamiento | Configurable |
| Llamada a funciones | Soportada |
| Salidas estructuradas | Soportadas |
| Precio de entrada | $2 por 1M de tokens |
| Precio de entrada en caché | $0.50 por 1M de tokens |
| Precio de salida | $6 por 1M de tokens |
| Velocidad de entrega reportada | Hasta 80 tokens por segundo |
| Disponibilidad | API de xAI, Grok Build, Cursor |
La ventana de contexto de 500K es lo suficientemente grande para bases de código sustanciales, documentos técnicos largos, investigaciones de múltiples archivos e historiales de agentes extendidos. Una ventana de contexto grande no garantiza automáticamente mejores resultados, pero le da a las herramientas más espacio para proporcionar material fuente relevante sin truncamiento agresivo.
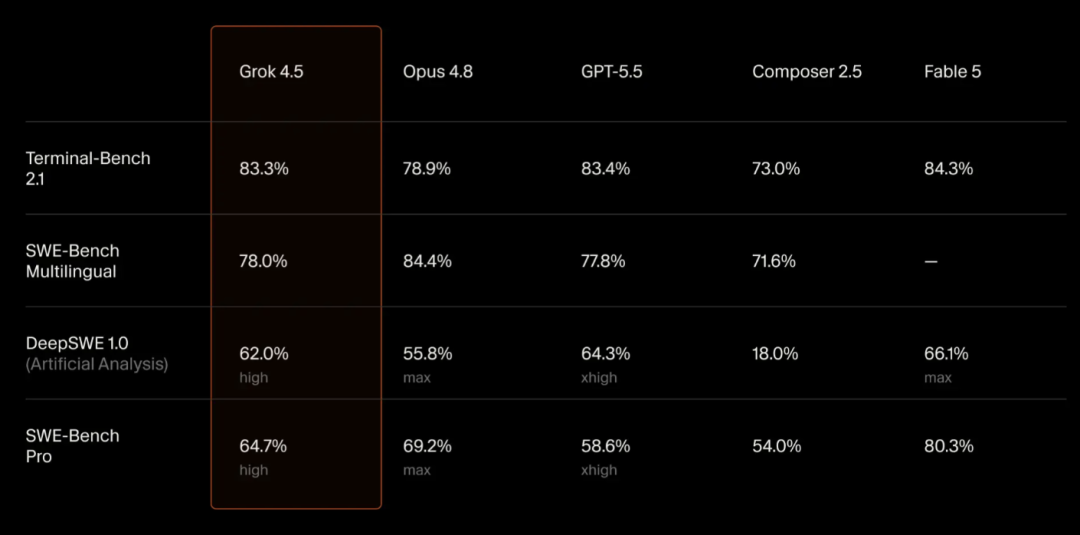
El anuncio oficial de xAI publica resultados a través de varias evaluaciones de ingeniería de software. Grok 4.5 no es el modelo superior en todos los puntos de referencia, pero sigue siendo competitivo con otros sistemas de frontera.
| Punto de Referencia | Grok 4.5 | Resultados de comparación seleccionados |
|---|---|---|
| DeepSWE 1.0 | 62.0% | Fable max 66.1%; GPT-5.5 xhigh 64.31%; Opus 4.8 max 55.75% |
| DeepSWE 1.1 | 53.0% | Fable max 70%; GPT-5.5 xhigh 67%; |
Opus 4.8 máximo 59% |
| Terminal-Bench 2.1 | 83.3% | Fable máximo 84.3%; GPT-5.5 xhigh 83.4%; Opus 4.8 máximo 78.9% |
| SWE-Bench Pro | 64.7% | Fable máximo 80.4%; Opus 4.8 máximo 69.2%; Opus 4.7 máximo 64.3% |
| SWE Marathon | 29.0% | Opus 4.8 máximo 26.0%; Fable máximo 24.0%; Opus 4.7 máximo 16.0% |
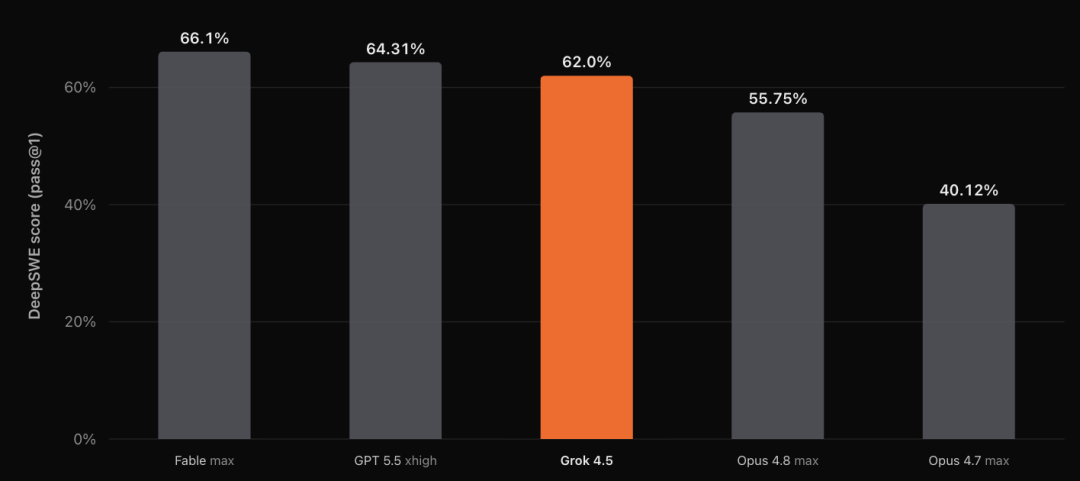
Estas cifras sugieren un modelo que es especialmente sólido en trabajo de terminal, tareas prácticas de ingeniería y flujos de trabajo agentivos más largos. Aún así deben leerse con cuidado. Los entornos de las pruebas de referencia, las configuraciones de razonamiento, el acceso a herramientas y las configuraciones específicas del proveedor pueden afectar el resultado.
Cursor también reveló que una instantánea antigua del repositorio de código de Cursor estuvo presente accidentalmente en los datos de entrenamiento, lo que podría influir en CursorBench. La empresa excluyó esa prueba de referencia de su comparación pública y afirmó que los datos no se utilizarían para modelos futuros.
La afirmación más práctica en torno a Grok 4.5 es la eficiencia.
xAI afirma que el modelo se sirve a hasta 80 tokens por segundo. Esto es lo suficientemente rápido como para que los rastros de razonamiento largos, las ediciones de repositorios y los bucles agentivos iterativos se sientan más receptivos que los modelos premium más lentos.
La compañía también informa que Grok 4.5 utilizó un promedio de 15,954 tokens de salida por tarea de SWE-Bench Pro, en comparación con 67,020 tokens de salida para Opus 4.8 en su configuración máxima. Esto equivale aproximadamente a 4.2 veces menos tokens de salida en la carga de trabajo medida.
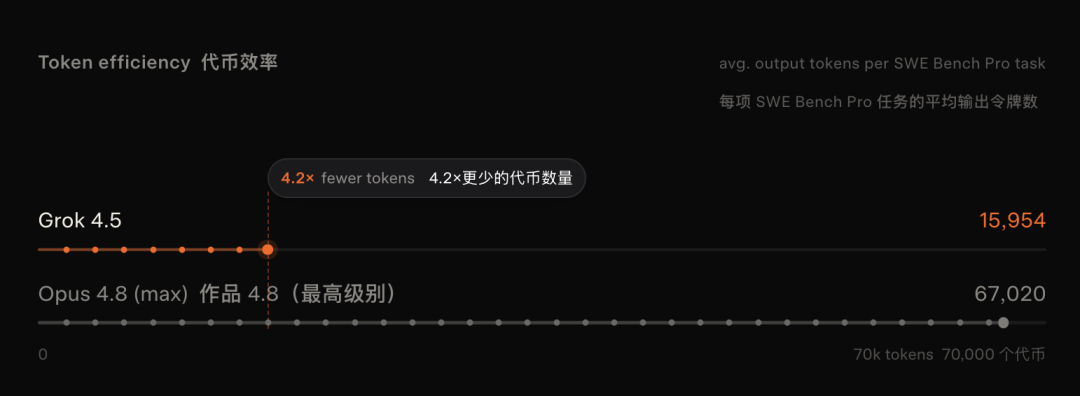
La eficiencia de tokens es importante por tres razones:
La métrica importante no es simplemente el precio por millón de tokens. Los equipos deberían comparar el costo de completar la misma tarea con un nivel de calidad aceptable. Un modelo con un precio de token listado más alto aún puede ser más barato si necesita menos intentos, menos llamadas a herramientas o menos
tokens generados.
El precio base de la API es:
| Tipo de token | Precio |
|---|---|
| Entrada | $2 por 1M tokens |
| Entrada en caché | $0.50 por 1M tokens |
| Salida | $6 por 1M tokens |
Cursor también ofrece una variante más rápida a $4 por millón de tokens de entrada y $18 por millón de tokens de salida dentro de su propia oferta de modelos. Los precios y la disponibilidad pueden variar según la plataforma, por lo que los equipos de producción deben confirmar la tarifa en el entorno que realmente utilizan.
Se espera que Grok 4.5 haga más que completar una función o explicar un error. Los ejemplos oficiales incluyen:
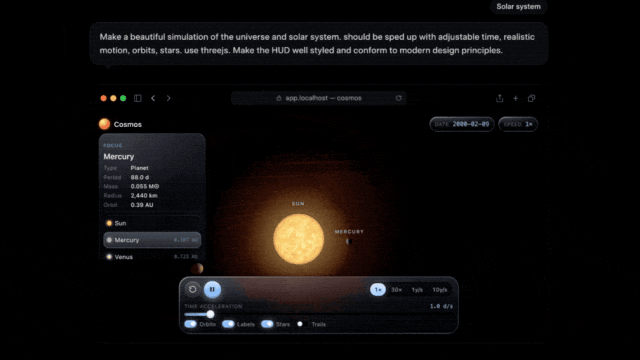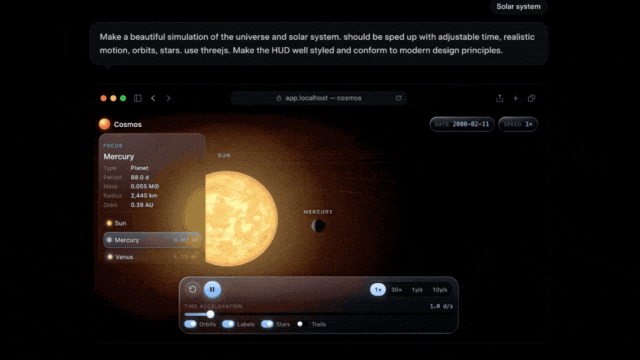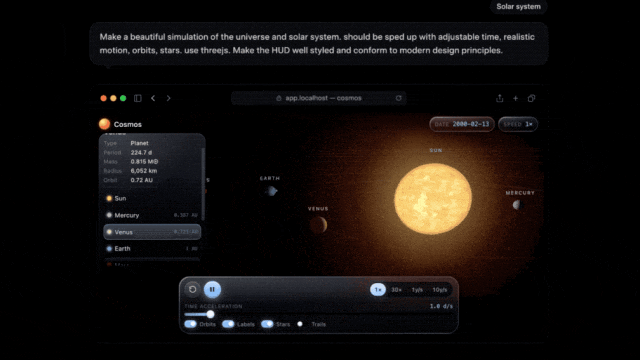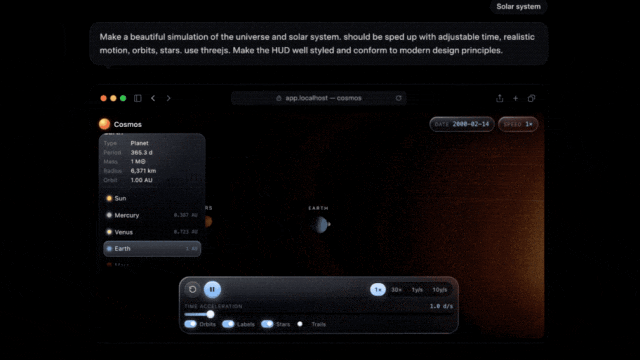
La demostración del sistema solar es útil porque combina diseño, código front-end, renderizado 3D, controles y lógica de interacción. No es prueba de que cada aplicación de un solo prompt esté lista para producción, pero muestra el tipo de tarea integrada para la que el modelo está optimizado.
Grok 4.5 también se extiende al trabajo de oficina. En los materiales de lanzamiento, crea diapositivas estructuradas de revisión de negocios y trabaja con hojas de cálculo que involucran fórmulas, investigación web y múltiples pestañas.

Para los equipos de desarrollo, un flujo de trabajo práctico podría verse así:
Un modelo puede ser rápido y capaz, pero aún así producir suposiciones incorrectas, cambios inseguros o validación incompleta. El mejor uso de los modelos de codificación agente suele ser la automatización estructurada con evidencia visible, no la autonomía sin restricciones.
Las ganancias de eficiencia no se presentan como una simple optimización de servicio. Tanto xAI como Cursor describen cambios en la arquitectura del modelo, la preparación de datos, el aprendizaje por refuerzo y el entrenamiento distribuido.
Cursor describe a Grok 4.5 como un modelo de mezcla de expertos. En un sistema MoE, solo una parte de la red se activa para un token o tarea determinada. Esto puede aumentar la capacidad total del modelo sin requerir que todos los parámetros participen en cada paso de inferencia.
Las fuentes oficiales no publican suficientes detalles de implementación para calcular el cómputo exacto utilizado por token. Por lo tanto, es más preciso centrarse en el comportamiento medido —velocidad, calidad de referencia y consumo de tokens— que inferir el rendimiento a partir de un recuento de parámetros no verificado.
xAI afirma que Grok 4.5 se entrenó en decenas de miles de GPU NVIDIA GB300. El entrenamiento a esta escala requiere más que hardware bruto. Las ejecuciones prolongadas necesitan sistemas distribuidos estables, recuperación de puntos de control, redes, tuberías de datos y monitoreo que puedan mantener productivos a miles de aceleradores.
El anuncio enfatiza las técnicas de estabilidad diseñadas para ejecuciones de entrenamiento muy grandes. Esto es importante porque un fallo en un experimento largo puede desperdiciar una gran cantidad de cómputo si el sistema no puede recuperarse de manera eficiente.
El proceso de entrenamiento incluyó:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El objetivo es mejorar la densidad de las señales de entrenamiento útiles en lugar de depender solo del volumen bruto de tokens. Los datos repetidos, de baja calidad o débilmente relevantes pueden aumentar el costo de entrenamiento sin proporcionar la misma mejora que los ejemplos cuidadosamente seleccionados.
Cursor dice que el modelo se entrenó con billones de tokens de datos de Cursor. Según la empresa, el conjunto de datos captura las interacciones entre usuarios, bases de código, herramientas de software y agentes.
Esta distinción es importante. Un conjunto de datos solo de código enseña sintaxis, patrones, bibliotecas e implementaciones comunes. Los datos de interacción también pueden enseñar la secuencia de trabajo:
Eso ayuda a explicar por qué Grok 4.5 está posicionado en torno a la ingeniería de software en lugar de la finalización de código aislada.
xAI dice que su programa de aprendizaje por refuerzo abarca cientos de miles de tareas, con un enfoque en la ingeniería de software de múltiples pasos y otro trabajo técnico.
Cursor describe entornos que entrenan al modelo para:
Las empresas también construyeron sistemas de agentes distribuidos para generar, probar y refinar estos entornos de entrenamiento a escala. Algunos despliegues de agentes pueden ejecutarse durante horas mientras el proceso de entrenamiento más grande continúa de forma asíncrona.
Este es un cambio significativo respecto a la optimización estrecha de puntos de referencia. El modelo se está entrenando no solo para producir una respuesta final correcta, sino para navegar el proceso que lleva a ella.
a uno.
Los pesos del modelo son solo una parte del producto final.
Una declaración pública de Elon Musk indicó que Grok 4.5 aún no estaba utilizando el software de inferencia en C/C++ desarrollado internamente por xAI, mapeado específicamente para el hardware GB300. Sugirió que la pila optimizada podría duplicar la velocidad de servicio o mejorarla aún más.
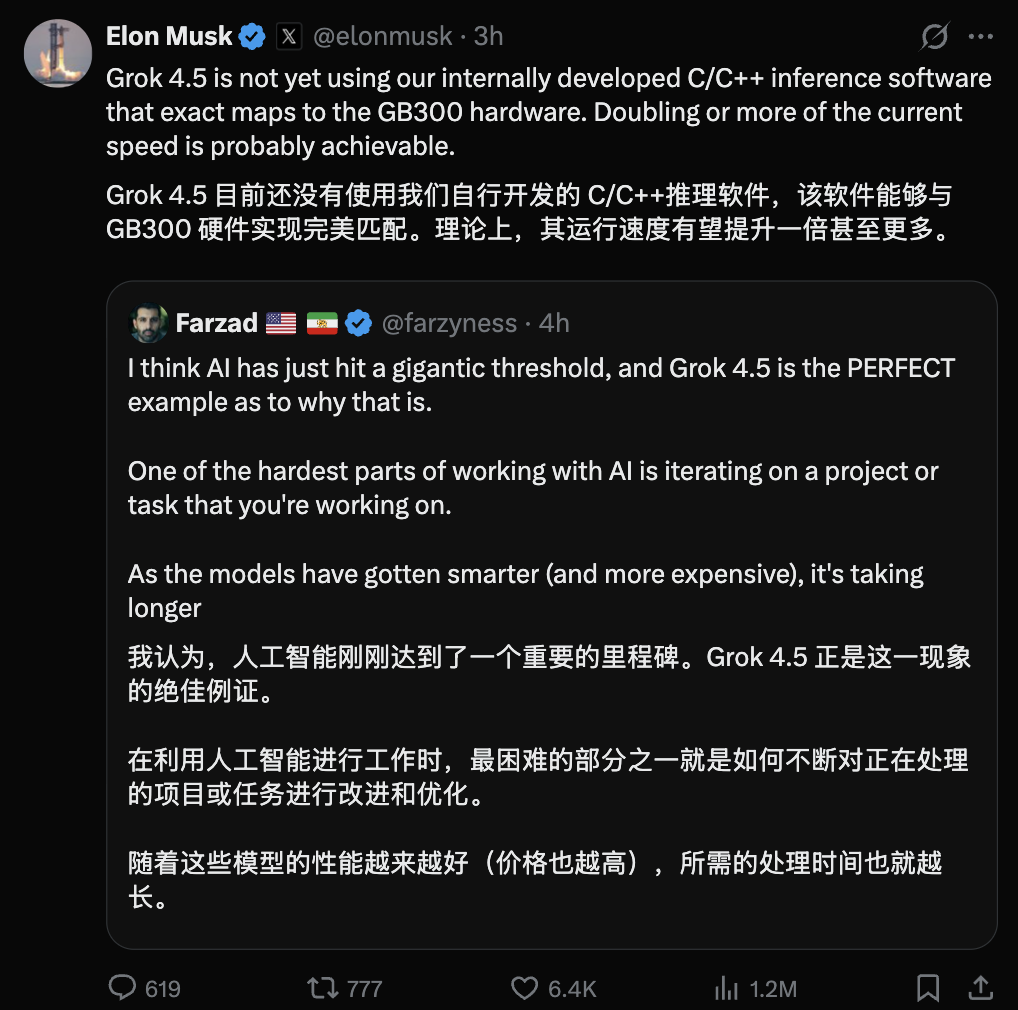
Esta es una afirmación prospectiva más que un resultado de producción medido, por lo que no debe tratarse como un rendimiento garantizado. Aun así, destica hacia dónde se dirige la competencia de modelos.
Cuando los modelos fronterizos se acercan en calidad de referencia, el sistema circundante puede crear la ventaja práctica:
Para los usuarios, esto significa que las comparaciones de modelos deberían incluir más que una única puntuación de inteligencia. Un modelo que responda más rápido, produzca menos tokens, utilice el caché de manera efectiva y complete tareas con menos reintentos puede ofrecer un valor real superior, incluso si otro modelo lidera en un punto de referencia.
Grok 4.5 está disponible a través de la API Responses de xAI. El siguiente ejemplo en Python utiliza la interfaz de cliente compatible con OpenAI:
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("Establece primero la variable de entorno XAI_API_KEY.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "Revisa esta función de JavaScript, corrige el error "
        "y explica el cambio: "
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
Antes de usar el modelo en producción:
Grok 4.5 es el modelo fronterizo de xAI para programación, tareas de agente y trabajo de conocimiento. Admite entrada de texto e imágenes, razonamiento configurable, llamadas a funciones y salidas estructuradas.
La documentación oficial del modelo de xAI indica una ventana de contexto de 500.000 tokens. El contexto utilizable real puede depender del formato de la solicitud, la salida de herramientas y los límites específicos de la plataforma.
El precio base publicado es de $2 por
millones de tokens de entrada, $0.50 por millón de tokens de entrada en caché y $6 por millón de tokens de salida. Las variantes específicas de la plataforma o el servicio prioritario pueden usar tarifas diferentes.
La respuesta depende del punto de referencia y del flujo de trabajo. Grok 4.5 es competitivo en varias pruebas de ingeniería y lidera algunas comparaciones, mientras que otros modelos siguen estando por delante en otras. La velocidad, el uso de tokens, la fiabilidad de las herramientas y el costo de finalización de tareas deben evaluarse junto con las puntuaciones de referencia.
xAI informa que Grok 4.5 utilizó un promedio de 15,954 tokens de salida por tarea de SWE-Bench Pro, en comparación con los 67,020 de Opus 4.8 en su configuración máxima. Esto equivale aproximadamente a 4.2 veces menos tokens de salida para la carga de trabajo medida.
Sí. La página oficial del modelo enumera entrada de texto e imagen con salida de texto. Esto lo hace adecuado para tareas como análisis de capturas de pantalla, revisión de documentos y contexto visual dentro de un flujo de trabajo de agente.
Sí. Cursor afirma que Grok 4.5 está disponible en sus experiencias de escritorio, web, iOS, CLI y SDK. Los límites de uso y los precios dependen del plan de Cursor seleccionado.
Se puede utilizar como modelo de razonamiento dentro de un agente de producción, pero el sistema circundante aún necesita controles de permisos, validación, observabilidad, reintentos y aprobación humana para acciones de alto impacto. La solidez del punto de referencia no elimina la necesidad de salvaguardas operativas.
Grok 4.5 es un modelo de frontera diseñado para programación, agentes y trabajo de conocimiento. Sus ventajas prácticas más sólidas son
la combinación de un rendimiento de ingeniería competitivo, una velocidad de servicio de hasta 80 tokens por segundo, una ventana de contexto de 500K y un menor consumo de tokens en la comparación publicada de SWE-Bench Pro.
El enfoque de entrenamiento combina infraestructura a gran escala, datos seleccionados, trazas de interacción de Cursor y aprendizaje por refuerzo en entornos realistas de uso de herramientas. Esto ayuda a que el modelo pase de la generación aislada de código a flujos de trabajo más largos y de extremo a extremo.
La historia principal no es solo que Grok se haya vuelto más capaz; es que xAI está compitiendo en el costo total y la velocidad para completar trabajos reales.
Empieza con una sola frase y obtén un sitio completo en minutos.



