For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/h-jepa-explained-hierarchical-jepa-world-f7e48311.md.
La startup de modelos del mundo de Yann LeCun, **Advanced Machine Intelligence (AMI)**, ha publicado uno de sus primeros resultados importan...
La startup de modelos del mundo de Yann LeCun, Advanced Machine Intelligence (AMI), ha publicado uno de sus primeros resultados importantes de investigación.
En el artículo H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning, investigadores de AMI, la Universidad de Nueva York, INRIA París y la Universidad Brown presentan un modelo jerárquico del mundo construido a partir de varios JEPA condicionados por acciones.
La idea central es sencilla: en lugar de obligar a una única representación latente a gestionar tanto el control motor inmediato como la planificación a largo plazo, H-JEPA asigna a los distintos niveles de la jerarquía diferentes escalas temporales y espacios de representación.
Los niveles superiores miran más lejos hacia el futuro y planifican a un nivel más general. Sus estados intermedios predichos se convierten en subobjetivos para los niveles inferiores, que los refinan progresivamente hasta que el sistema llega a acciones ejecutables.
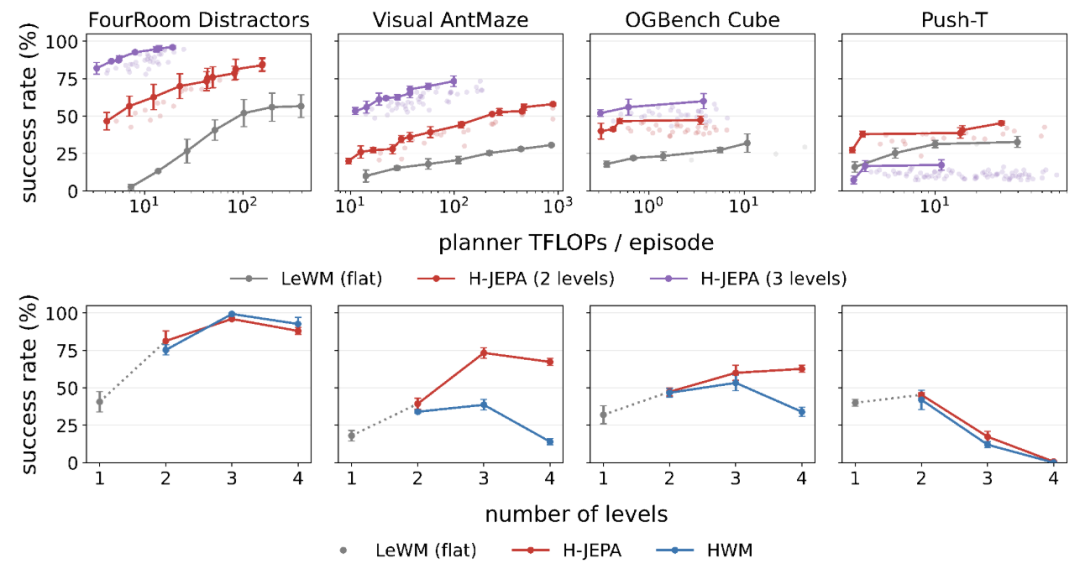
En Visual AntMaze, el H-JEPA de tres niveles alcanza aproximadamente un 73,3 % de éxito en la planificación, frente al 18,0 % del modelo base plano LeWorldModel, y también opera en una frontera más favorable entre éxito y consumo computacional.
El proyecto sigue la orientación de investigación abierta que AMI ha destacado desde su lanzamiento. Los autores han publicado el código de entrenamiento y evaluación, puntos de control preentrenados y conjuntos de datos de apoyo.
El repositorio oficial de GitHub utiliza la licencia MIT. El repositorio de puntos de control de H-JEPA publicado en Hugging Face también está marcado con la licencia MIT, mientras que el repositorio del conjunto de datos asociado se distribuye bajo CC BY 4.0.
LeCun lleva años defendiendo la planificación jerárquica.
La intuición subyacente es similar a la forma en que las personas planifican tareas complejas del mundo real.
Imaginemos que estamos sentados en una oficina de la Universidad de Nueva York y decidimos viajar a París.
En el nivel más alto, la información importante es el destino, el vuelo y el horario. Una vez decidido eso, el siguiente nivel se vuelve más concreto: salir de la oficina, bajar, llegar al aeropuerto y embarcar en el vuelo.
En el nivel más bajo, la atención vuelve a cambiar. Bajar por una escalera requiere información sobre el suelo, el siguiente escalón y el movimiento corporal. Los detalles que eran irrelevantes al elegir un vuelo transatlántico de repente se vuelven fundamentales.
El mismo problema aparece en la robótica.
Un planificador de alto nivel necesita comprender el objetivo de la tarea, las relaciones espaciales y la dirección del desplazamiento a largo plazo. Un controlador de bajo nivel necesita información precisa sobre el movimiento inmediato y la configuración del cuerpo.
Si una única representación tiene que conservar todos los detalles en todas las escalas temporales, la planificación se vuelve innecesariamente difícil.
Por ejemplo, un cuadrúpedo puede encontrarse ya en la ubicación correcta aunque la postura de sus patas difiera de la imagen objetivo. Una representación que dé demasiada importancia a los detalles de las patas que cambian rápidamente podría interpretar de forma incorrecta que el robot está lejos del objetivo, aunque su posición relevante para la tarea ya sea correcta.
El artículo de H-JEPA aborda este problema planteando una pregunta más específica:
¿Puede cada nivel aprender la información relevante para su propia escala temporal y, al mismo tiempo, permitir que el plan de alto nivel se traduzca en acciones de bajo nivel?
H-JEPA asigna tres componentes principales a cada nivel de la jerarquía:
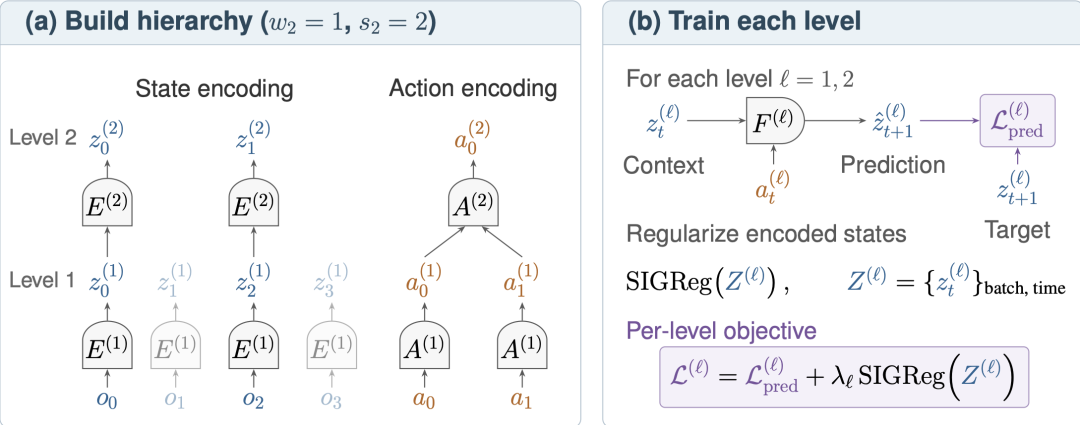
El codificador de estados extrae una representación latente del entorno.
En el nivel más bajo, el codificador opera directamente sobre observaciones visuales. Los niveles superiores reciben representaciones de los niveles inferiores y aprenden versiones progresivamente más abstractas del estado.
Esto permite que los niveles superiores descarten detalles que cambian rápidamente, que son difíciles de predecir en horizontes largos o que resultan irrelevantes para la planificación a largo plazo.
En los experimentos de Visual AntMaze, los niveles superiores suprimen cada vez más la información sobre la postura de las patas de la hormiga, al tiempo que conservan información sobre su posición y la distribución del laberinto.
Ese es exactamente el tipo de abstracción que la jerarquía pretende aprender.
El codificador de acciones describe el efecto de las acciones en cada escala temporal.
En el nivel más bajo, las acciones corresponden a cambios de control relativamente concretos. En los niveles superiores, varias acciones de niveles inferiores se comprimen en una representación más general de cómo cambia el estado durante un periodo más largo.
Esto proporciona a cada capa una resolución temporal diferente.
En la configuración descrita, un paso de predicción de nivel superior abarca más pasos del entorno que el nivel inmediatamente inferior.
El predictor combina el estado latente actual y la acción codificada para estimar el estado latente futuro.
Por tanto, cada nivel aprende su propio modelo del mundo condicionado por acciones.
La diferencia clave respecto a un modelo del mundo plano es que H-JEPA no exige que todos los niveles predigan dentro de un único espacio latente compartido.
En su lugar, cada nivel puede desarrollar una representación adaptada a su propio horizonte temporal.
Durante la inferencia, la planificación avanza desde la parte superior de la jerarquía hacia abajo.
Primero, el nivel superior busca una trayectoria general hacia el objetivo final.
A continuación, su estado intermedio predicho se convierte en un subobjetivo para el nivel inferior. Ese nivel busca un plan más preciso que alcance el subobjetivo asignado, y el proceso continúa hasta que el nivel más bajo produce acciones primitivas.
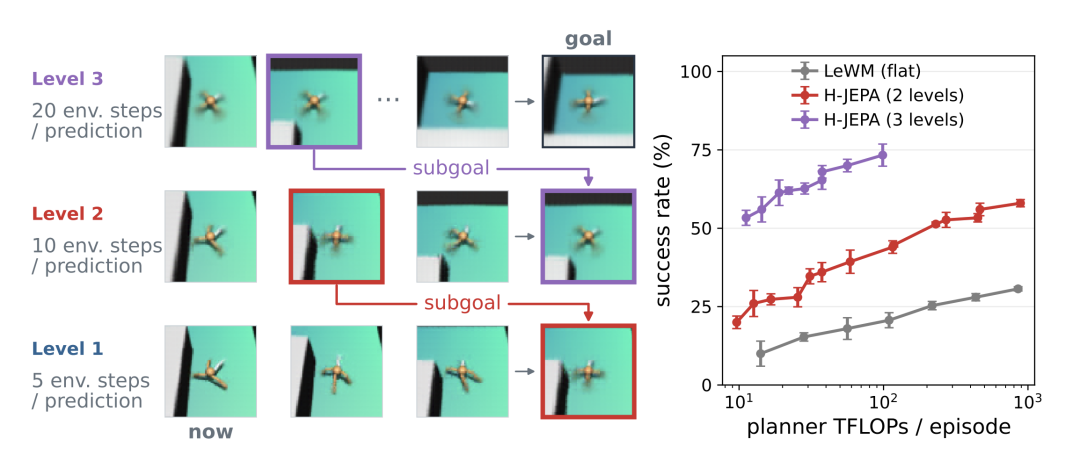
Esto produce un proceso de planificación de lo general a lo específico:
Después de ejecutar un prefijo de acciones, el sistema observa el nuevo estado y vuelve a planificar.
Esta replanificación repetida permite que la jerarquía responda al entorno real en lugar de comprometerse con un único plan de ciclo abierto de larga duración.
La jerarquía se entrena de extremo a extremo.
Esto significa que los niveles no se entrenan como módulos aislados. Los objetivos de nivel superior pueden influir en los codificadores de niveles inferiores, lo que permite desarrollar conjuntamente toda la jerarquía de representaciones.
Sin embargo, el entrenamiento de modelos del mundo tiene un problema clásico: el colapso de la representación.
Si un codificador asigna cada estado de entrada al mismo vector latente, un predictor puede producir trivialmente ese mismo vector y lograr un error de predicción bajo sin aprender nada útil sobre el entorno.
H-JEPA aborda este problema mediante SIGReg, o Regularización Gaussiana Isotrópica Bosquejada, introducida en el trabajo anterior LeJEPA de Randall Balestriero y Yann LeCun.
SIGReg restringe la distribución latente para que distintas observaciones no colapsen en la misma representación.
El trabajo anterior, LeWorldModel, aplicó este tipo de regularización al entrenamiento de extremo a extremo de modelos del mundo a partir de píxeles. H-JEPA utiliza LeWorldModel como base de su nivel inferior y añade después niveles JEPA adicionales por encima.
Esto mantiene intacto el principio básico de JEPA: predecir representaciones útiles del futuro en lugar de reconstruir cada píxel futuro.
El artículo evalúa H-JEPA en cuatro entornos simulados de navegación y manipulación:
También evalúa la planificación fuera de línea con trayectorias de robots reales del conjunto de datos DROID.
Visual AntMaze muestra la ventaja jerárquica más clara.
Según el repositorio oficial, un H-JEPA de tres niveles alcanza un 73,3 % de éxito en la planificación, frente al 18,0 % del modelo base plano LeWorldModel.
La jerarquía también mejora el equilibrio entre la tasa de éxito y el consumo computacional del planificador.
Esto es importante porque un planificador jerárquico solo resulta útil si los niveles adicionales no hacen que la planificación sea excesivamente costosa.
La jerarquía también supera al modelo base plano en otros entornos simulados, pero una mayor profundidad no siempre es mejor.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El artículo fuente destaca Push-T como un contraejemplo importante: el modelo de dos niveles obtiene mejores resultados que el modelo base plano, mientras que añadir un tercer o cuarto nivel puede reducir el rendimiento.
El artículo atribuye esto en parte a la duración de las tareas. Las trayectorias más cortas proporcionan menos muestras significativas para los niveles muy altos que operan sobre horizontes largos.
Esto apunta a una limitación importante:
La jerarquía resulta útil cuando la tarea contiene una estructura real en varias escalas temporales. Añadir niveles mecánicamente no garantiza un mejor rendimiento.
Los datos de robots reales plantean otro problema de representación.
En vídeos diversos, un objetivo puramente predictivo puede centrarse demasiado en la información estable del fondo, porque el fondo es fácil de predecir. El robot en movimiento, que en realidad es importante para el control, puede recibir menos capacidad de representación.
Para abordar esto, los investigadores añaden supervisión de dinámica inversa en los experimentos con DROID.
El modelo se entrena no solo para predecir estados latentes futuros, sino también para inferir la acción que conecta estados latentes consecutivos.
Esto anima a la representación a conservar información sobre el movimiento del robot y su estado controlable.
La página del proyecto H-JEPA informa de que el segundo nivel aprendido mejora la fidelidad de la planificación fuera de línea frente al modelo base plano, al tiempo que reduce el consumo computacional del planificador.
La evaluación con DROID es fuera de línea: el artículo compara trayectorias predichas del efector final con trayectorias de expertos, en lugar de afirmar que se ha logrado éxito en tareas robóticas reales de ciclo cerrado.
Esta distinción es importante al interpretar los resultados.
Los autores han publicado la implementación de H-JEPA en GitHub.
El repositorio oficial incluye código de entrenamiento y planificación para:
También proporciona scripts para reproducir determinadas figuras y tablas del artículo.
El repositorio de puntos de control de Hugging Face incluye actualmente modelos preentrenados para LeWorldModel plano, variantes H-JEPA de dos, tres y cuatro niveles, y modelos base HWM de espacio compartido en las tareas de simulación, además de puntos de control de DROID.
El repositorio del conjunto de datos H-JEPA asociado contiene los datos de simulación, las tareas de evaluación de planificación, los conjuntos de datos de sondeo y los datos relacionados con DROID necesarios para la publicación.
Esto convierte el trabajo en algo más que una demostración basada únicamente en un artículo: los investigadores pueden inspeccionar la implementación, cargar modelos entrenados e intentar reproducir los resultados de planificación publicados.
H-JEPA sigue la misma dirección general de investigación que LeCun ha promovido durante años.
JEPA significa Joint-Embedding Predictive Architecture, o arquitectura predictiva de incrustación conjunta.
Un modelo de lenguaje estándar aprende prediciendo tokens futuros. Un JEPA visual, en cambio, aprende representaciones de las observaciones y predice representaciones objetivo en el espacio latente.
En modelos del mundo como H-JEPA, se añaden acciones al proceso para que el modelo pueda predecir cómo cambia su representación interna del mundo después de ejecutar una acción.
A continuación, un planificador puede comparar las consecuencias predichas de distintas acciones y buscar una trayectoria hacia el objetivo.
Esto refleja la visión de larga data de LeCun de que la inteligencia requiere algo más que generar lenguaje. Según su agenda de investigación, los sistemas deben comprender el mundo, predecir las consecuencias de las acciones, recordar el estado relevante y planificar a lo largo del tiempo.
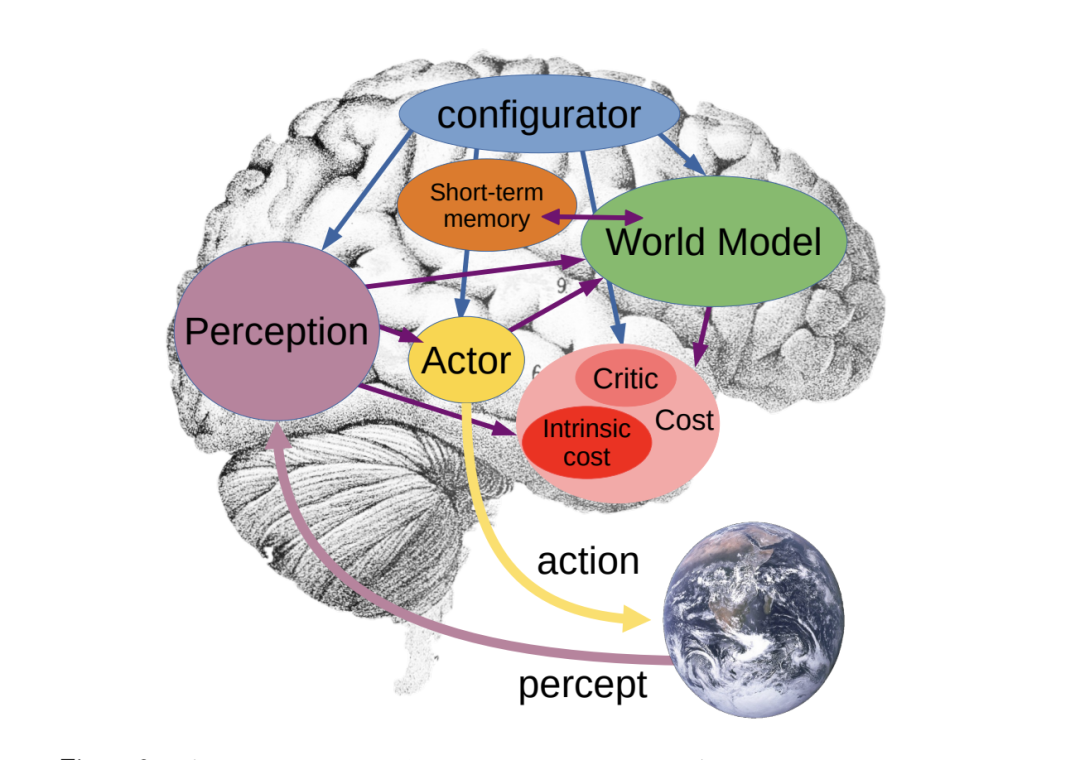
El artículo original también señala las críticas reiteradas de LeCun a la idea de que escalar únicamente los LLM vaya a conducir necesariamente a una inteligencia de nivel humano. Al mismo tiempo, ha reconocido que las herramientas basadas en LLM son extremadamente útiles en la práctica.
Por tanto, H-JEPA se entiende mejor no como un intento de sustituir hoy a todos los modelos de lenguaje, sino como un experimento concreto en la arquitectura alternativa que LeCun ha defendido.
Esa dirección de investigación forma ahora parte de la estrategia empresarial de AMI.
AMI captó 1.030 millones de dólares en marzo de 2026 con una valoración pre-money de 3.500 millones de dólares, según Reuters y otras informaciones contemporáneas.
La empresa está dirigida por un equipo que incluye a:
Michael Rabbat también es uno de los autores del artículo de H-JEPA.
AMI describe su objetivo como la creación de sistemas que comprendan el mundo, mantengan una memoria persistente, razonen y planifiquen, y sigan siendo controlables y seguros.
En el momento del artículo fuente de BAAI, la empresa todavía se presentaba principalmente mediante su investigación, su equipo y sus ofertas de empleo, más que a través de un producto público ampliamente disponible.
Por ello, H-JEPA es significativo en parte porque proporciona un resultado técnico concreto de la tesis de AMI sobre los modelos del mundo.
El artículo fuente termina comparando AMI con otra empresa de modelos del mundo de alto perfil: World Labs, de Fei-Fei Li.
El 28 de septiembre de 2026, AMD anunció un acuerdo definitivo para adquirir World Labs.
La presentación de AMD ante la SEC valora la operación, íntegramente en acciones, en aproximadamente 8.200 millones de dólares, sujeta a los ajustes habituales.
Las dos empresas siguen caminos organizativos diferentes, pero ambas reflejan la creciente importancia de los modelos del mundo, la inteligencia espacial, la robótica, la simulación y la IA física.
AMI continúa desarrollando su propio programa de investigación en torno a modelos predictivos jerárquicos, mientras que World Labs avanza hacia su integración con una importante empresa de computación para IA.
En el caso de H-JEPA, la pregunta inmediata es más técnica que corporativa: ¿hasta dónde puede escalar la planificación jerárquica latente desde el control simulado y el vídeo robótico fuera de línea hacia sistemas más ricos y de ciclo cerrado en el mundo real?
Ese es el próximo desafío de la arquitectura.
H-JEPA es un modelo jerárquico del mundo de extremo a extremo para la planificación visual. Apila varios JEPA condicionados por acciones, de modo que los niveles superiores predicen más lejos en el futuro y transmiten subobjetivos latentes a los niveles inferiores.
Un modelo del mundo plano utiliza una única representación y una única escala temporal de planificación. H-JEPA aprende espacios latentes separados en varias escalas temporales, lo que permite que los niveles superiores se centren en estructuras lentas y relevantes para la tarea, mientras que los niveles inferiores conservan los detalles necesarios para el control.
El repositorio oficial de GitHub informa de aproximadamente un 73,3 % de éxito en la planificación para un H-JEPA de tres niveles, frente al 18,0 % del modelo base plano LeWorldModel. La jerarquía también logra un mejor equilibrio entre éxito y consumo computacional del planificador.
SIGReg significa Regularización Gaussiana Isotrópica Bosquejada. Se introdujo en LeJEPA para restringir las distribuciones latentes y evitar el colapso de la representación, en el que un codificador asigna muchos estados diferentes a incrustaciones prácticamente idénticas.
Sí. El código oficial de GitHub utiliza la licencia MIT y los puntos de control preentrenados están disponibles en Hugging Face. El repositorio del conjunto de datos H-JEPA asociado se publica bajo CC BY 4.0.
El artículo extiende el enfoque a vídeos diversos de robots reales procedentes de DROID mediante supervisión de dinámica inversa. Esos experimentos evalúan la fidelidad de la planificación fuera de línea, no el éxito completo de tareas robóticas de ciclo cerrado, por lo que el resultado no debe presentarse de forma exagerada como un despliegue autónomo en el mundo real.
No. El artículo muestra que las jerarquías más profundas ayudan cuando la tarea contiene una estructura significativa en varias escalas temporales, pero las jerarquías demasiado profundas pueden perjudicar las tareas más cortas, como Push-T, porque los niveles superiores pueden recibir muy poca señal de entrenamiento útil.
Sigue la tesis de LeCun sobre JEPA y los modelos del mundo: aprender representaciones compactas del mundo, predecir estados latentes futuros en lugar de cada píxel y utilizar esas predicciones para planificar. H-JEPA añade una jerarquía explícita para que los distintos niveles operen con diferentes escalas temporales y grados de abstracción.
H-JEPA convierte la idea del modelo del mundo JEPA en una jerarquía explícita de planificación. Los niveles superiores operan sobre horizontes más largos y representaciones más abstractas, mientras que los niveles inferiores traducen esos planes en subobjetivos y acciones cada vez más concretos.
El resultado más sólido aparece en Visual AntMaze, donde un H-JEPA de tres niveles alcanza aproximadamente un 73 % de éxito en la planificación frente al 18 % del modelo base plano LeWorldModel, al tiempo que mejora la eficiencia de planificación. El trabajo también muestra que la jerarquía no es útil automáticamente: la escala temporal de la tarea y la disponibilidad de datos determinan si los niveles adicionales ayudan.
El proyecto ofrece un nivel de reproducibilidad poco habitual para una publicación de investigación reciente, con código, puntos de control y conjuntos de datos ya disponibles públicamente.
La principal contribución de H-JEPA no es simplemente obtener una mejor puntuación en un laberinto; es demostrar de forma concreta que los modelos del mundo pueden beneficiarse de aprender representaciones diferentes para distintos horizontes de planificación.
Empieza con una sola frase y obtén un sitio completo en minutos.



