For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/harness2-explained-recursive-agent-harnes-65188473.md.
Harness², también escrito Harness2, explora una forma práctica de mejora recursiva: modificar el software que rodea a un modelo de lenguaje ...
Harness², también escrito Harness2, explora una forma práctica de mejora recursiva: modificar el software que rodea a un modelo de lenguaje congelado. Su entorno de ejecución editable incluye prompts, guardrails, memoria, habilidades, orientación para herramientas, scripts, subagentes y middleware.
La investigación procede de Google Cloud AI Research y Northwestern University. En lugar de entrenar un modelo nuevo después de cada fallo, el sistema estudia la ejecución de un agente, prueba cambios en su entorno de ejecución y conserva evidencia sobre qué cambios fueron útiles.
Los autores informan que un paso de mejora eleva la puntuación media de GLM-5 en WorkBuddy-Bench de 64,2 a 75,7 con OpenCode. Es una mejora de 11,5 puntos en una evaluación concreta, no una mejora garantizada para cualquier modelo o aplicación.
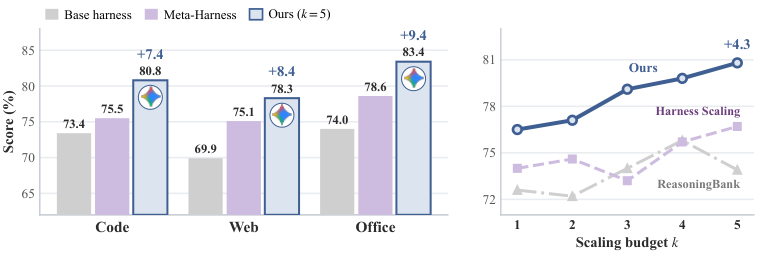
Figura del equipo de investigación, reproducida en el informe de QbitAI/BAAI.
Dos problemas motivan este trabajo.
Harness2 separa el entorno de ejecución de la tarea actual del proceso que lo mejora. Una tarea posterior comienza con el entorno base común; el sistema de mejora selecciona evidencia anterior en lugar de trasladar ciegamente todas las reglas previas.
Primero, el sistema registra una ejecución de referencia utilizando el entorno inicial. Después usa ese registro para identificar debilidades y probar posibles reparaciones.
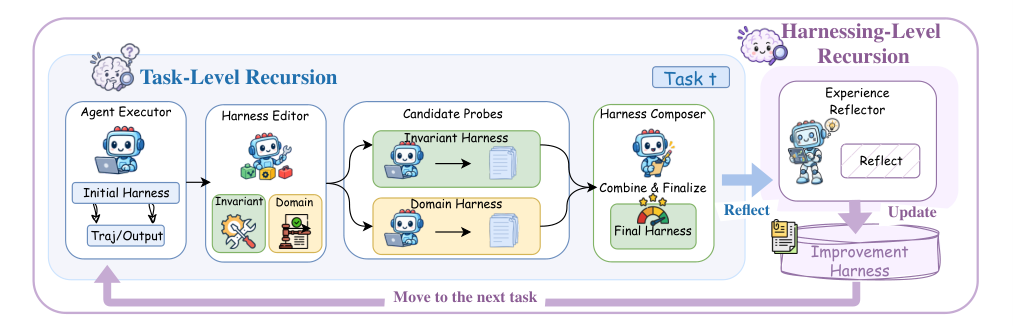
El paso de mejora tiene tres etapas:
La comparación conductual sustituye a la retroalimentación de referencia correcta que no está disponible durante la adaptación. No es un juez infalible de la corrección final. La evaluación externa con benchmarks sigue siendo importante para medir si el método funciona.
El método puede explorar más ampliamente mediante recursividad paralela o realizar revisiones sucesivas mediante recursividad secuencial. Con un presupuesto paralelo k, prueba k candidatos generales y k candidatos de dominio, y después produce k composiciones. Un mayor número de candidatos requiere más computación.
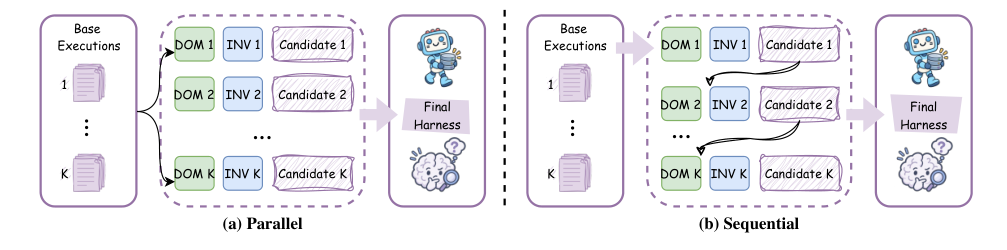
Después de una tarea, un reflector de experiencias examina el registro de referencia, las ediciones propuestas, la evidencia de las pruebas y las decisiones de composición. Registra componentes y lecciones reutilizables, incluidas notas en EXPERIENCE.md.
La tarea siguiente recibe el entorno base de ejecución, pero el proceso de edición puede recuperar estas lecciones anteriores. Lo que persiste es el conocimiento sobre cuándo resulta útil una reparación, no la suposición de que la configuración completa de la última tarea deba convertirse en permanente.
Los parámetros del modelo permanecen fijos. Se trata de adaptación en tiempo de ejecución mediante archivos y evidencia de ejecución, no de una demostración de entrenamiento autónomo de los pesos del modelo.
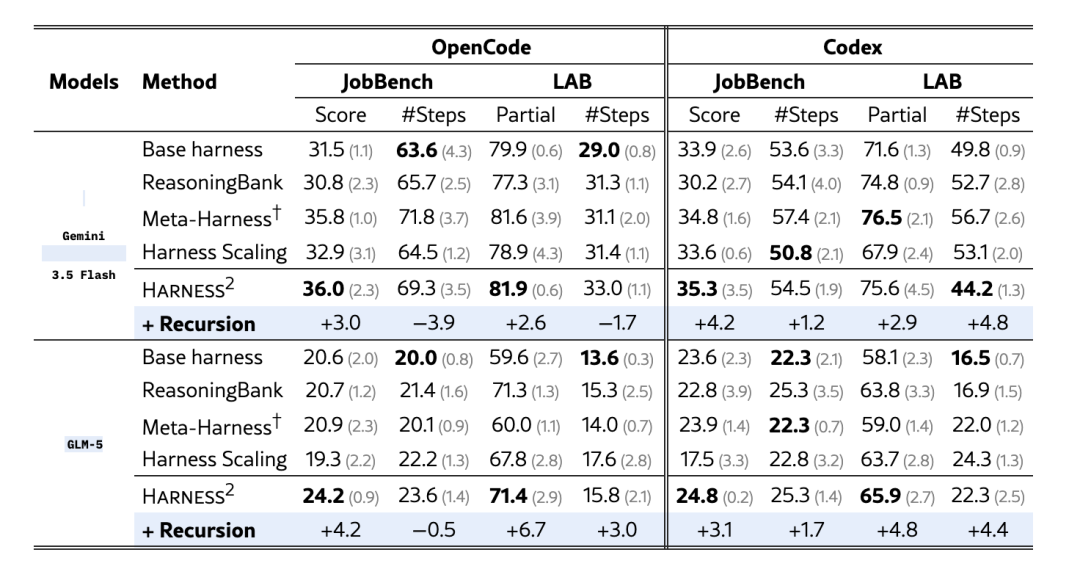
El estudio evalúa los entregables de código, web y oficina de WorkBuddy-Bench, las tareas profesionales de JobBench y el Legal Agent Benchmark de Harvey. Utiliza GLM-5 y Gemini 3.5 Flash con OpenCode y Codex como entornos de ejecución.
El editor predeterminado es Claude Opus 4.8 bajo OpenCode. Por tanto, los resultados principales implican un sistema de mejora alrededor del ejecutor; no deben describirse como un aumento gratuito de capacidades del ejecutor por sí solo.
| Modelo ejecutor | Entorno inicial | Media base de WorkBuddy | Un paso de Harness2 | Mejora |
|---|---|---|---|---|
| GLM-5 | OpenCode | 64,2 | 75,7 | 11,5 puntos |
| GLM-5 | Codex | 64,4 | 75,3 | 10,9 puntos |
| Gemini 3.5 Flash | OpenCode | 72,4 | 77,5 | 5,1 puntos |
| Gemini 3.5 Flash | Codex | 74,5 | 77,5 | 3,0 puntos |
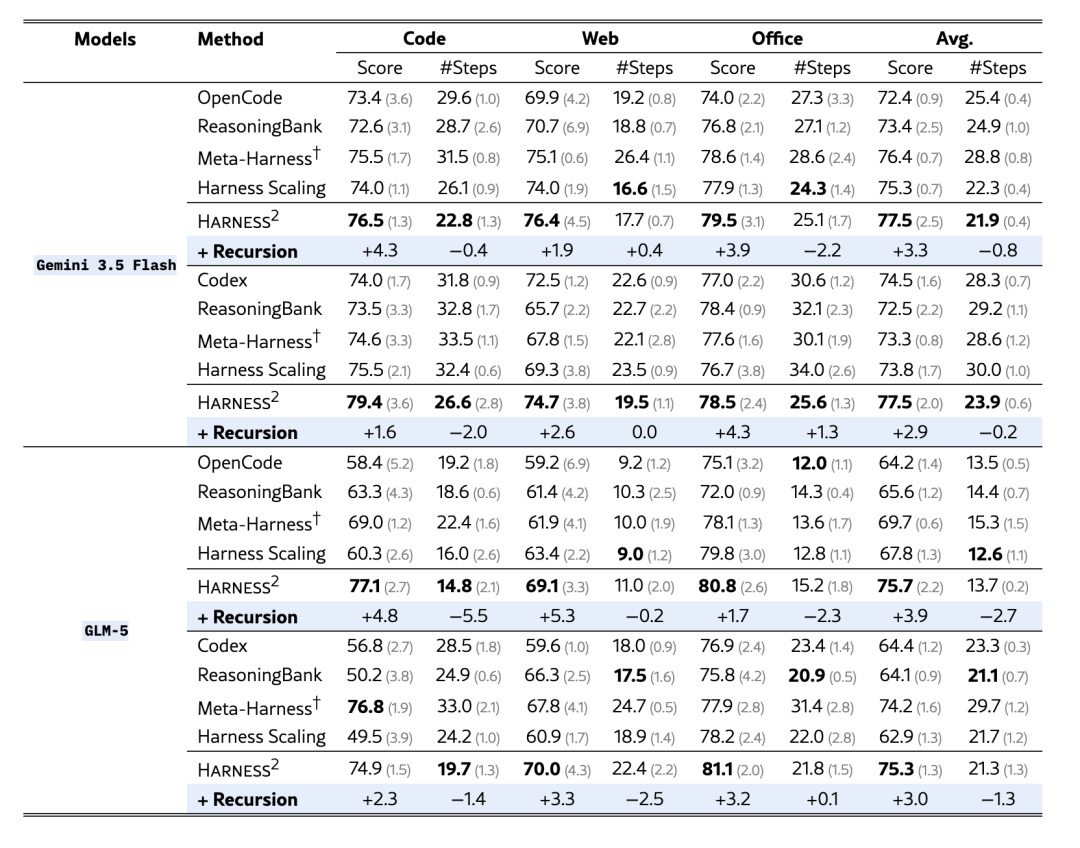
GLM-5 con el entorno mejorado supera la línea base correspondiente de Gemini sin modificar en esta comparación. Esto ilustra cómo el diseño del entorno de ejecución puede afectar al orden de rendimiento de los modelos; no demuestra que GLM-5 sea superior en todas las tareas.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El artículo informa de mejoras de un solo paso de hasta 4,5 puntos en JobBench y de 11,8 puntos porcentuales en LAB Partial, la tasa de aprobación por criterio. Partial es diferente de la proporción de tareas que satisfacen todos los criterios.
Aumentar el presupuesto paralelo a k=5 añade hasta 3,9 puntos de WorkBuddy, 4,2 puntos de JobBench y 6,7 puntos porcentuales de LAB Partial por encima de un paso. Las tablas principales informan de medias y desviaciones estándar de tres ejecuciones con el orden de las tareas barajado.
El experimento de transferencia también resulta útil. Una biblioteca acumulada en JobBench mejora el refinamiento de un paso de WorkBuddy en 0,6 puntos en código, 0,5 en web y 2,9 en oficina, sin pruebas adicionales para esa comparación.
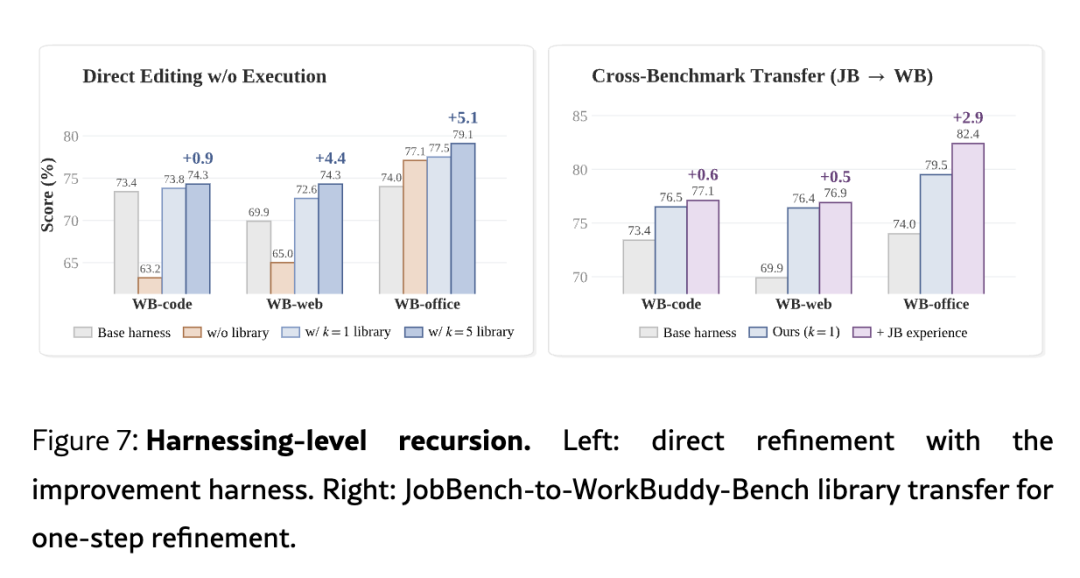
Estos resultados respaldan la reutilización selectiva de la experiencia de mejora. No demuestran que todas las reglas acumuladas se transfieran ni eliminan la necesidad de comprobar el entorno adoptado en la distribución de tareas real.
El artículo enumera nueve autores: Ruiyao Xu, Yanfei Chen, Zhongying CuiZhu, Bhavana Dalvi Mishra, Yifei Ming, Han Yu, Rujun Han, Chen-Yu Lee y Tomas Pfister. Las fuentes presentan a Xu, estudiante de doctorado de Northwestern, y a los investigadores de Google Cloud Chen y CuiZhu.
El repositorio público admite ambos entornos de ejecución y ambos modos de recursividad. Especifica Linux, Python 3.12 y uv; los benchmarks basados en modelos tienen dependencias adicionales y costes de API. WorkBuddy requiere Docker, mientras que LAB necesita herramientas como Pandoc y Poppler.
El README también advierte que el acceso de red del ejecutor no está restringido y que el sandbox de ejecución de Codex está desactivado en esa configuración. Los usuarios de benchmarks deben configurar restricciones para impedir el acceso a las respuestas y las rúbricas antes de evaluar los resultados. Las mejoras del entorno de ejecución descritas en el artículo deben analizarse junto con estas condiciones de ejecución y evaluación.
Modifica el entorno de ejecución alrededor de un modelo de lenguaje, incluidos los prompts, las herramientas, la memoria y las habilidades. Los pesos del modelo subyacente permanecen congelados.
La recursividad a nivel de tarea prueba y compone reparaciones para la tarea actual. La recursividad a nivel de orquestación conserva evidencia y lecciones reutilizables para mejorar decisiones de edición posteriores.
Su método de adaptación utiliza contrastes entre registros de ejecución en lugar de un verificador de referencia correcta. Esto proporciona evidencia cuando no hay etiquetas, pero no garantiza que el artefacto resultante sea correcto.
No. Es la mejora media comunicada para GLM-5/OpenCode en WorkBuddy dentro del estudio. Otras combinaciones de modelo, entorno y benchmark presentan mejoras diferentes.
Añade ejecuciones de candidatos y trabajo de mejora. El artículo analiza el rendimiento junto con la computación total, incluidos los tokens de ejecución y de mejora.
El repositorio indica Docker para WorkBuddy-Bench. Su demostración local determinista y otros benchmarks tienen requisitos diferentes, por lo que deben seguirse las instrucciones del flujo de trabajo seleccionado.
Harness2 combina la experimentación específica de cada tarea con una biblioteca de lecciones sobre la mejora de los entornos de ejecución de agentes. Sus mejoras comunicadas muestran que los prompts, la gestión de herramientas y la estructura de ejecución pueden cambiar materialmente los resultados incluso cuando los pesos del modelo permanecen fijos.
La evidencia respalda una mejor ingeniería del entorno de ejecución bajo condiciones evaluadas, manteniendo visibles los límites de computación, verificación y transferencia.
Empieza con una sola frase y obtén un sitio completo en minutos.