For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/houmo-m50-open-source-software-for-local-1781bd08.md.
Llevar una carga de trabajo de IA a un dispositivo local requiere más que un acelerador capaz. Los desarrolladores necesitan una forma de pr...
Llevar una carga de trabajo de IA a un dispositivo local requiere más que un acelerador capaz. Los desarrolladores necesitan una forma de preparar modelos, ejecutarlos de manera eficiente, conectar múltiples componentes y mantener el producto terminado.
El último anuncio de ecosistema de Houmo aborda esa capa de software. Según el informe proporcionado, la empresa planea lanzar su pila de software de IA por etapas, con 15 proyectos programados para aparecer antes de enero de 2027. Varios repositorios ya son públicos, incluidos ejemplos de modelos, herramientas de cuantización y adaptaciones de marcos de inferencia conocidos.
La distinción entre la hoja de ruta y el código disponible hoy es importante. Un plan para abrir toda la pila no significa que todos los componentes ya estén publicados ni que hayan desaparecido todas las dependencias de tiempo de ejecución.
El informe organiza la pila en cuatro capas:
| Capa | Función en una implementación |
|---|---|
| Preparación del modelo | Cuantización, compilación, comprobaciones de precisión y conversión a un formato compatible |
| Marco de inferencia, operadores y tiempo de ejecución | Ejecución y planificación en hardware de Houmo |
| Kits de dominio, canalizaciones y middleware | Coordinación entre modelos y componentes de la aplicación |
| Implementación y operaciones | Actualizaciones, supervisión y gestión en los dispositivos implementados |
Un asistente de reuniones ilustra por qué estas capas deben funcionar juntas. El reconocimiento de voz debe alimentar a un modelo de lenguaje, el modelo de lenguaje debe producir un registro útil y la aplicación debe guardarlo o mostrarlo. Cada etapa tiene sus propios requisitos de memoria, latencia y compatibilidad.
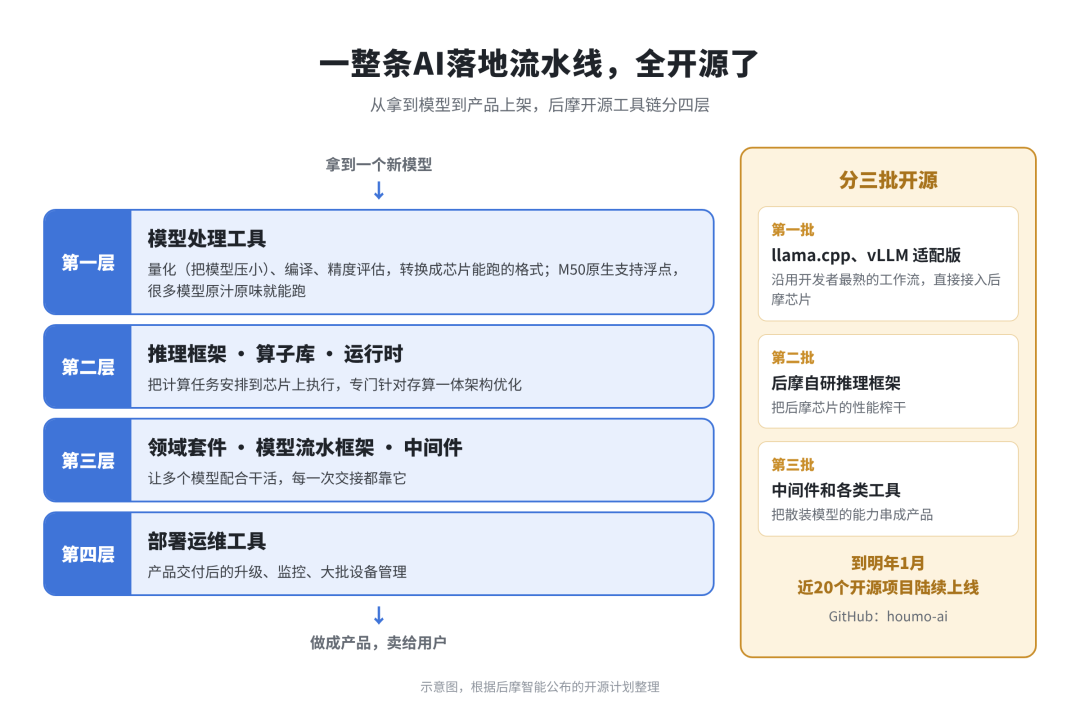
Diagrama de la pila de software del informe de Xinzhiyuan/BAAI; sus etiquetas originales están en chino.
La secuencia de lanzamiento comunicada comienza con adaptaciones de llama.cpp y vLLM, seguida por el propio marco de inferencia de Houmo y, después, middleware y otras herramientas. La hoja de ruta más amplia también incluye infraestructura para la gestión de aceleradores y clústeres.
El repositorio público postmo-modelzoo describe ejemplos que cubren cuantización, compilación, evaluación de precisión, medición de rendimiento e implementación de aplicaciones. Sus categorías de modelos incluyen reconocimiento de voz, generación de voz, modelos de lenguaje, modelos de visión y lenguaje, embeddings, OCR, segmentación y generación de imágenes.
Otros repositorios visibles incluyen postmo-quantflow, postmo-gptqmodel, vllm-postmo y bifurcaciones de Houmo de llama.cpp y vLLM. Los desarrolladores deben consultar el README y la rama actual de cada repositorio, en lugar de asumir procedimientos de instalación o niveles de soporte idénticos.
El README de ejemplos de modelos indica varias restricciones concretas:
houmo-tcim-runtime y houmo-drv.Estos requisitos son importantes para la planificación. Un repositorio abierto de ejemplos proporciona código de integración inspeccionable, pero no es un entorno de ejecución independiente del hardware.
La fuente afirma que más de 100 clientes y más de 150 productos terminales planificados están asociados con el M50. Estas cifras describen la cartera de ecosistema comunicada, no envíos auditados.
El informe describe el P7 de Lenovo como una computadora de IA de aproximadamente 300 gramos, con una potencia máxima del sistema de 30 W. Señala la ejecución local de un modelo de 122.000 millones de parámetros a 50 tokens por segundo, con soporte para un contexto de 128K.
Esos números deben considerarse junto con las condiciones de prueba que no se especifican. El artículo no proporciona suficiente detalle sobre arquitectura del modelo, precisión, carga de trabajo y configuración de medición como para tratarlos como una garantía general de rendimiento. En particular, el número de parámetros por sí solo no indica a un lector cuánta memoria requiere una implementación.
El propio M50 se describe con 160 TOPS de rendimiento INT8, una potencia típica de 10 W y soporte para hasta 48 GB de memoria LPDDR5/5X. La potencia del acelerador, la potencia total del sistema, el rendimiento teórico y la velocidad de generación de tokens miden aspectos diferentes.
Otros productos comunicados incluyen una versión M50 de Truffle 1 de Deepshard, HomeAgent HA100 Pro de Ugreen y ClawHouse X1. Sus ejemplos se centran en memoria local, procesamiento de medios domésticos e interfaces de agentes personales. Los servicios conectados, como el correo electrónico, todavía dependen de autenticación y acceso a red, incluso cuando un modelo se ejecuta localmente.
El informe describe un portátil Great Wall N90 Pro que ejecuta Kylin V11 y un modelo de 35B sin conexión a 30 tokens por segundo. También analiza un robot acompañante que utiliza procesamiento local para percepción y memoria, además de un dispositivo educativo basado en tarjetas aceleradoras LM5040, cada una de las cuales integra cuatro chips M50.
Las cifras de cómputo y memoria comunicadas para el sistema educativo se aplican a la máquina ensamblada, no a un único M50. Los lectores que comparen productos deben solicitar el número real de tarjetas, la topología de memoria, la precisión y la carga de trabajo medida.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El análisis de arquitectura distingue los modelos de mezcla de expertos de los modelos densos. Un modelo MoE puede activar un subconjunto de expertos para un token, al tiempo que requiere almacenamiento para su conjunto más amplio de parámetros. Los modelos densos suelen utilizar una fracción mayor de sus parámetros en cada paso, lo que hace que el tráfico de memoria sea una consideración importante.
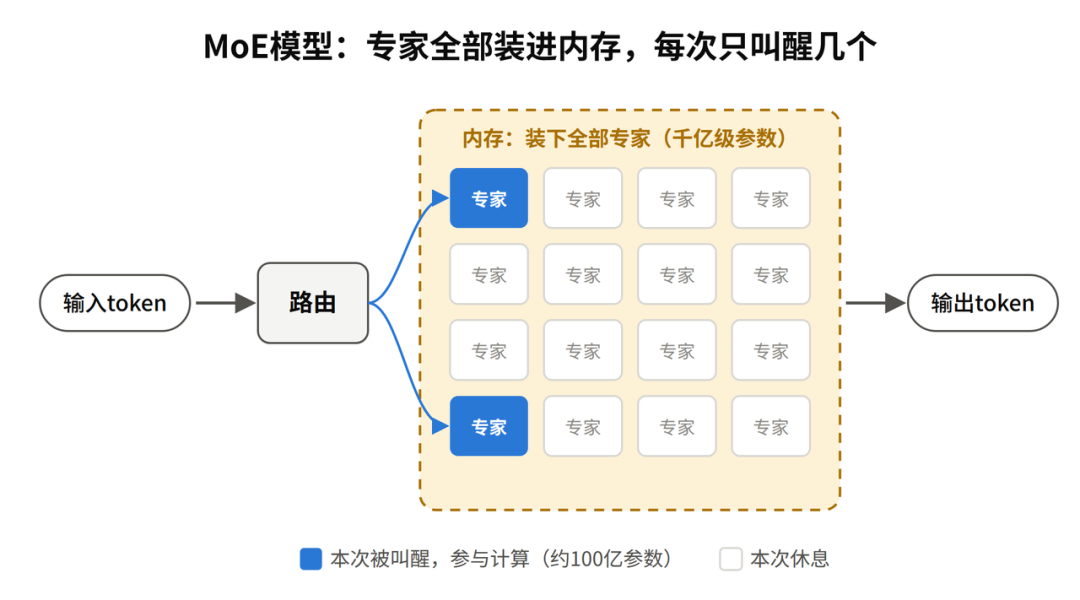
Ilustración de MoE del informe fuente; las etiquetas originales explican los expertos almacenados y activados.
Houmo presenta dos rutas de desarrollo: computación en memoria 2D, que enfatiza la capacidad y el cómputo con memoria externa, y computación en memoria 3D, que enfatiza el ancho de banda mediante un diseño apilado. El informe describe el cómputo basado en SRAM en la capa lógica como una característica distintiva de esta última.
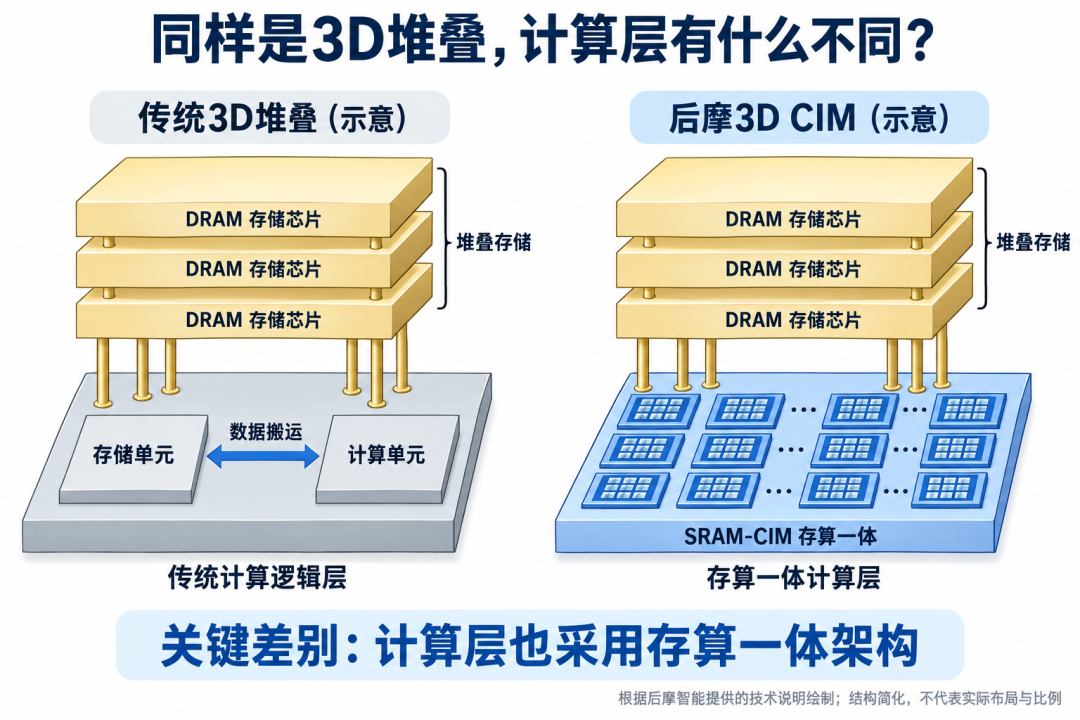
Comparación de arquitectura reproducida en el informe de Xinzhiyuan/BAAI, no es un benchmark independiente.
Las comparaciones de área y potencia de la empresa dependen de aquello con lo que se comparan. No deben aplicarse a todos los chips o modelos sin una configuración de medición divulgada. Las referencias futuras a Flash o RRAM también describen una dirección de desarrollo, no una garantía de disponibilidad actual del producto.
La fuente vincula este anuncio con el trabajo anterior de Qiang Wu, fundador y CEO, en GPGPU y OpenCL. Desde una perspectiva más práctica, publicar herramientas permite a los desarrolladores inspeccionar el comportamiento de integración, adaptar ejemplos y aportar correcciones.
Este acceso puede reducir el trabajo repetido entre fabricantes de dispositivos. No elimina la necesidad de probar la calidad, la temperatura, el uso de memoria, las licencias, el funcionamiento sin conexión y el comportamiento de recuperación en el producto final. Un ejemplo reproducible en el hardware previsto es un mejor punto de partida que un titular sobre el número de parámetros.
M50 es un acelerador de IA de borde utilizado en los escenarios de dispositivos locales descritos por el informe. Los ejemplos incluyen computadoras con agentes, portátiles, sistemas domésticos, robots y dispositivos de inferencia de borde.
El informe describe un plan escalonado que se extiende hasta enero de 2027. Varios repositorios son públicos actualmente, pero los desarrolladores deben comprobar el estado de lanzamiento y la licencia reales de cada componente.
El repositorio incluye herramientas de preparación y evaluación con distintos requisitos de plataforma. Sus ejemplos de inferencia requieren hardware compatible de Houmo y bibliotecas de tiempo de ejecución; la cuantización de modelos grandes también necesita una GPU.
La inferencia local puede funcionar sin un servicio de modelo en la nube cuando los activos necesarios están instalados. Las tareas que implican correo electrónico en tiempo real, mensajería u otros servicios en línea siguen necesitando conectividad y autorización.
No. TOPS es una cifra de rendimiento de operaciones bajo una precisión determinada, mientras que la velocidad de tokens depende de la arquitectura del modelo, el tráfico de memoria, la precisión y el comportamiento del software. Compare resultados medidos para el mismo modelo y carga de trabajo.
No. El README indica que la mayoría de los conjuntos de datos de terceros deben obtenerse por separado y utilizarse conforme a sus propios términos. La licencia del repositorio no concede derechos comerciales sobre todos los datos o activos de modelos mencionados.
El anuncio de Houmo busca hacer más reutilizable el camino desde la preparación del modelo hasta un producto de borde operativo. Los repositorios públicos ya proporcionan ejemplos útiles, mientras que la pila más amplia sigue siendo un plan de lanzamiento escalonado.
Los dispositivos M50 comunicados muestran varios formatos de implementación posibles, pero la decisión práctica sigue dependiendo de los modelos, el hardware y los requisitos de tiempo de ejecución exactos. Comience con un ejemplo compatible y mida la carga de trabajo completa del producto.
Empieza con una sola frase y obtén un sitio completo en minutos.
