For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/infinihand-streaming-3d-hand-motion-from-53c55163.md.
Una cámara montada en la cabeza captura cómo las personas manipulan objetos, pero convertir esa grabación en movimiento 3D útil es difícil. ...
Una cámara montada en la cabeza captura cómo las personas manipulan objetos, pero convertir esa grabación en movimiento 3D útil es difícil. Las manos se mueven, la cámara se mueve, los dedos desaparecen detrás de objetos y dos manos pueden ocultarse mutuamente.
InfiniHand combina localización de manos, reconstrucción detallada de manos y estimación del movimiento de cámara en un marco de streaming. Su objetivo es situar poses sucesivas de las manos en un sistema de coordenadas mundial compartido, haciendo que el movimiento sea más útil para la anotación a gran escala y posibles flujos de trabajo de aprendizaje incorporado.
El trabajo procede de investigadores afiliados al Shanghai Artificial Intelligence Laboratory, la Shanghai Jiao Tong University y varias otras universidades. Su página de proyecto ofrece comparaciones visuales sincronizadas y un visor de movimiento 3D.
Una imagen recortada de una mano resulta útil para identificar la articulación de los dedos, pero contiene información limitada sobre dónde se encuentra la mano dentro de la escena circundante. Del mismo modo, un movimiento en la imagen puede ser consecuencia de una mano que se mueve, una cabeza que gira o ambos factores.
Las canalizaciones tradicionales suelen combinar un detector de manos, un estimador de poses, un sistema de seguimiento de cámara y una fase de alineación. Los errores de una fase pueden propagarse: no detectar una mano modifica la reconstrucción, y una trayectoria de cámara imprecisa cambia el movimiento global aparente.
InfiniHand comparte contexto geométrico entre estas tareas. Un backbone preentrenado de LingBot-Map extrae características de fotograma completo, que respaldan la localización de las manos izquierda y derecha. El componente de reconstrucción de manos combina esas características con información visual centrada en la mano para recuperar una articulación más precisa.
Su representación de manos utiliza parámetros MANO para la pose, la forma y la orientación. La supervisión auxiliar de puntos de referencia 2D ayuda a restringir cómo las manos 3D predichas se reproyectan en la imagen. Las estimaciones de cámara permiten entonces expresar las manos reconstruidas en el mismo marco mundial a lo largo del tiempo.
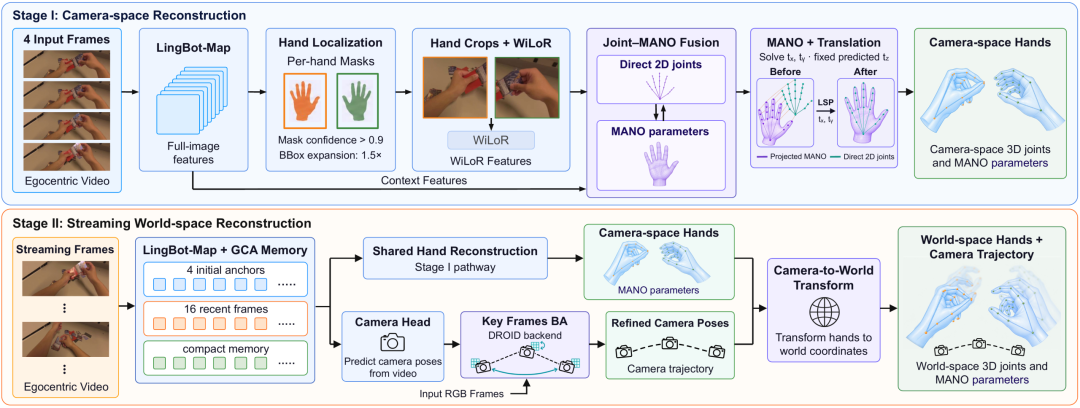
Figura del método InfiniHand, reproducida en el informe de QbitAI/BAAI.
Los investigadores recopilaron aproximadamente 5.000 horas de vídeo egocéntrico público de nueve conjuntos de datos, incluidos ARCTIC, HOT3D y EgoDex. Combinar estas fuentes exige más que concatenar archivos: el orden de las manos, las convenciones de coordenadas y los tipos de anotación pueden diferir.
La canalización de preprocesamiento estandariza las imágenes, los parámetros de manos, las articulaciones, las máscaras y los cuadros delimitadores disponibles. Cuando es posible, ajusta los parámetros MANO faltantes a partir de articulaciones 3D. Las secuencias con trayectorias de cámara también pueden proporcionar supervisión en el espacio mundial.
La calidad de las anotaciones es otra cuestión. El equipo utiliza Sapiens 2 para predecir puntos de referencia 2D de las manos y los compara con las anotaciones originales proyectadas en la imagen. Un desacuerdo persistente puede indicar asociaciones erróneas, proyecciones deficientes o poses inverosímiles.
Según el artículo, este proceso elimina aproximadamente el 30–40 % de los datos de entrenamiento candidatos, mientras que los casos inciertos se reservan para inspección manual. La figura describe el proceso de depuración de candidatos; no debe utilizarse para inferir un total preciso de horas retenidas que los autores no proporcionan aquí.
El entrenamiento continúa entonces en dos etapas:
Esta disposición permite que conjuntos de datos con diferente cobertura de anotaciones contribuyan a las partes del modelo que pueden supervisar.
InfiniHand procesa el vídeo entrante en ventanas mientras conserva memoria geométrica. Su contexto incluye información de referencia inicial, características detalladas recientes e información comprimida de observaciones más antiguas.
La implementación solapa dos tareas de predicción: un trabajador procesa la próxima ventana mediante el backbone, mientras que otro decodifica las predicciones de manos y cámara de la ventana anterior. Reutilizar características y reducir el tiempo inactivo favorece un mayor rendimiento.
El artículo informa de un rendimiento de predicción de 11,19 FPS, frente a 5,48 FPS de HaWoR, una mejora de 2,04 veces bajo la comparación comunicada. Esto no implica operación universal en tiempo real a 30 FPS ni una velocidad garantizada en hardware arbitrario.
Para secuencias más largas, un trabajador independiente realiza ajuste de haces disperso para refinar la trayectoria de la cámara. Un conjunto binario de fotogramas clave conserva observaciones recientes junto con fotogramas anteriores seleccionados. Esa optimización en segundo plano tiene un coste computacional adicional más allá del rendimiento de predicción comunicado.
La evaluación en el espacio de cámara cubre 34 escenas de ARCTIC, 10 escenas de HOT3D, 166 escenas de HOI4D y 100 escenas de EgoDex. Los investigadores comparan el sistema con varios métodos de reconstrucción existentes.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
El informe destaca PA-p, una medida que incorpora el error de pose y una penalización por detecciones omitidas. Los valores más bajos son mejores en la comparación comunicada:
| Conjunto de datos y métrica | Método de comparación | InfiniHand | Reducción comunicada |
|---|---|---|---|
| ARCTIC PA-p | ViDiHand: 9,82 mm | 7,72 mm | 21,4 % |
| EgoDex PA-p | ViDiHand: 17,22 mm | 7,29 mm | 57,7 % |
| EgoDex W-MPJPE en espacio mundial | Dyn-HaMR: 78,41 mm | 28,77 mm | 63,3 % |
Estas filas se refieren a diferentes conjuntos de datos y métricas; no deben promediarse para formar una única afirmación de precisión. InfiniHand también informa del W-MPJPE más bajo entre los métodos comparados en ARCTIC, HOT3D y EgoDex.
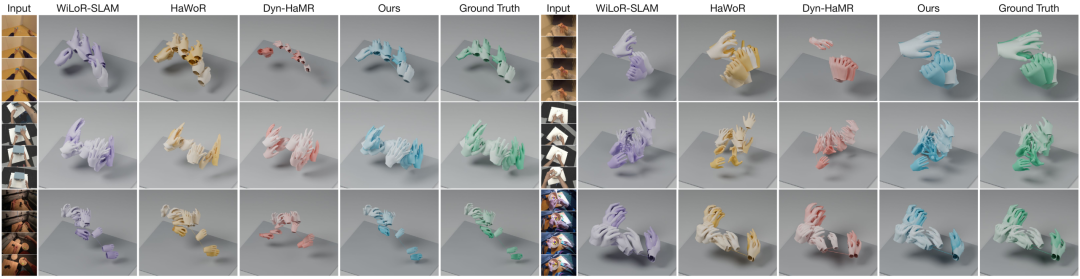
Comparación cualitativa alineada: el azul representa InfiniHand y el verde representa la referencia. La alineación forma parte de la visualización y debe tenerse en cuenta al interpretar la aparente concordancia.
La fuente también analiza ejemplos de Ego4D en escenas naturales que implican oclusión e interacción con objetos. Una comparación offline ilustrada utiliza localización externa de manos para InfiniHand. Los lectores deben distinguir esa configuración de las afirmaciones de localización del modelo unificado; las demostraciones interactivas del proyecto proporcionan el contexto visual pertinente.
Recuperar demostraciones humanas en 3D puede ayudar a preparar datos para la manipulación diestra, la transferencia de movimiento y la investigación en aprendizaje por imitación. Convertir las manos reconstruidas en datos de entrenamiento para robots aún requiere controles de calidad y adaptación a la estructura física del robot.
Los autores identifican varias limitaciones. LingBot-Map no recupera intrínsecamente la escala métrica, por lo que se necesita un modelo auxiliar de alineación que puede introducir errores. Los cambios rápidos de punto de vista, la oclusión severa y la visibilidad intermitente de las manos siguen siendo difíciles porque los datos de entrenamiento adecuados son limitados.
La supervisión monocular también puede trasladar a lo largo del tiempo una deriva de escala variable al entrenamiento. El refinamiento disperso ayuda, pero no convierte cada trayectoria recuperada en una medición física exacta.
Estima ubicaciones de manos, parámetros MANO de las manos y trayectorias de cámara a partir de vídeo egocéntrico. Estas estimaciones permiten representar el movimiento de las manos en un sistema de coordenadas mundial compartido.
El movimiento de las manos en el espacio de cámara cambia con el movimiento de la cámara. Un marco mundial compartido facilita comparar las trayectorias de las manos entre fotogramas teniendo en cuenta el punto de vista móvil.
El marco propuesto incluye su propio componente de localización. Sin embargo, la fuente identifica un ejemplo cualitativo offline que utiliza localización externa de manos, por lo que los lectores deben comprobar la configuración de cada comparación mostrada.
No. Se trata del rendimiento de predicción bajo la evaluación comunicada por los autores. El ajuste de haces disperso en segundo plano genera trabajo adicional, y el rendimiento depende de la configuración de ejecución.
Los investigadores comparan anotaciones proyectadas con predicciones de puntos de referencia 2D de manos basadas en imágenes y rechazan secuencias con inconsistencias persistentes. Informan de la eliminación de aproximadamente el 30–40 % de los datos candidatos y reservan los casos ambiguos para comprobaciones manuales.
El artículo presenta investigación sobre reconstrucción y anotación, no un sistema validado de control directo de robots. El uso con robots requeriría retargeting, restricciones físicas y verificación específica de la tarea.
InfiniHand combina geometría de escena, apariencia detallada de las manos y estimación de cámara para recuperar el movimiento de las manos a partir de vídeo en primera persona. Su diseño de streaming y su canalización de depuración de datos abordan el desafío práctico de anotar grandes colecciones de vídeo.
Las mejoras comunicadas de precisión y rendimiento son resultados de investigación prometedores, con condiciones importantes relacionadas con la recuperación de escala y el refinamiento en segundo plano. La salida es una estimación de reconstrucción útil que aún necesita validación para tareas físicas posteriores.
Empieza con una sola frase y obtén un sitio completo en minutos.
