For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/jev-decision-model-typesafe-ai-870m-serie-7b7d7513.md.
En solo unas semanas, TypeSafe AI pasó de ser una startup de infraestructura relativamente desconocida a una de las empresas emergentes de I...
En solo unas semanas, TypeSafe AI pasó de ser una startup de infraestructura relativamente desconocida a una de las empresas emergentes de IA más observadas.
La empresa ha anunciado una ronda Serie A de 870 millones de dólares, con una valoración posterior a la inversión de 7.500 millones de dólares.
Esto sería notable en cualquier circunstancia. Lo que hace inusual la historia es el producto que impulsa este crecimiento: Jev, un modelo que no intenta ser un chatbot, no genera textos extensos y no está diseñado principalmente para escribir código.
Su función es mucho más concreta.
Toma decisiones.
Una solicitud típica para Jev se parece más a:
Dado este estado,
¿qué opción debería elegir el software?
que a:
Escríbeme una explicación detallada.
TypeSafe denomina a Jev un modelo System One: un modelo diseñado para tomar decisiones rápidas, acotadas y estructuradas que el software puede utilizar directamente.
En lugar de texto libre, Jev devuelve elementos como:
Este enfoque específico ha hecho que Jev sea lo bastante económico y rápido como para ejecutarse dentro de flujos de trabajo de software de gran volumen, en los que un LLM de frontera convencional sería innecesariamente lento o costoso.
Y la reacción del mercado ha sido extrema.
TypeSafe AI se fundó en 2024 en San Francisco.
Antes del lanzamiento de Jev, la empresa pasó aproximadamente dos años operando en modo sigiloso.
Su irrupción pública llegó el 15 de septiembre de 2026, cuando TypeSafe presentó su primer modelo System One y explicó el enfoque de entrenamiento que lo sustenta: Reinforcement Learning for Calibrated Decisions, o RLCD.
La fuente original señala que TypeSafe había anunciado previamente una ronda semilla de 40 millones de dólares alrededor del lanzamiento de Jev. Menos de un mes después, la empresa anunció una ronda Serie A mucho mayor.
La publicación oficial sobre la financiación de TypeSafe confirma:
| Elemento | Detalle confirmado |
|---|---|
| Serie A | 870 millones de dólares |
| Valoración posterior a la inversión | 7.500 millones de dólares |
| Inversor principal | Andreessen Horowitz |
| Otros participantes mencionados | Sequoia Capital, DCVC e inversores ángeles |
| Nuevo miembro del consejo | Martin Casado |
La empresa afirma que utilizará el nuevo capital para:
El punto importante es que los inversores no solo están apostando por otro modelo de frontera de propósito general.
Están apostando por una categoría de modelos diferente.
La idea central de Jev es sencilla: muchos sistemas de software no necesitan párrafos.
Necesitan una decisión.
Algunos ejemplos son:
Los LLM tradicionales pueden responder a estas preguntas, pero normalmente lo hacen mediante la generación autorregresiva de texto.
TypeSafe sostiene que esto resulta ineficiente cuando la aplicación ya conoce la forma que debe tener la respuesta.
El diseño de Jev tiene en cambio este aspecto:
Estado estructurado
      ↓
Preguntas tipadas
      ↓
Cálculo de decisiones en paralelo
      ↓
Probabilidades + resultados acotados
      ↓
La aplicación deriva según el resultado
TypeSafe describe esto como inteligencia “nativa para máquinas”: el modelo está optimizado para integrarse en el código en lugar de producir lenguaje que deba leer una persona.
Actualmente, TypeSafe muestra Jev con estos precios:
Entrada: 0,042 $ / 1 millón de tokens
Salida: gratuita / no contabilizada
Ese precio está muy por debajo del de la mayoría de los modelos de frontera de propósito general.
La razón es arquitectónica.
Jev no genera texto arbitrario token a token. TypeSafe afirma que su muestreador devuelve en paralelo los resultados acotados de una decisión.
La empresa afirma que la latencia integral de su servicio se sitúa aproximadamente entre 70 y 500 ms, y que Jev puede ser entre 40 y 200 veces más rápido en cargas de trabajo comparables con la estructura de System One.
Esas cifras proceden de la evaluación publicada por TypeSafe y deben interpretarse como afirmaciones del proveedor para el tipo de tareas para el que Jev está diseñado.
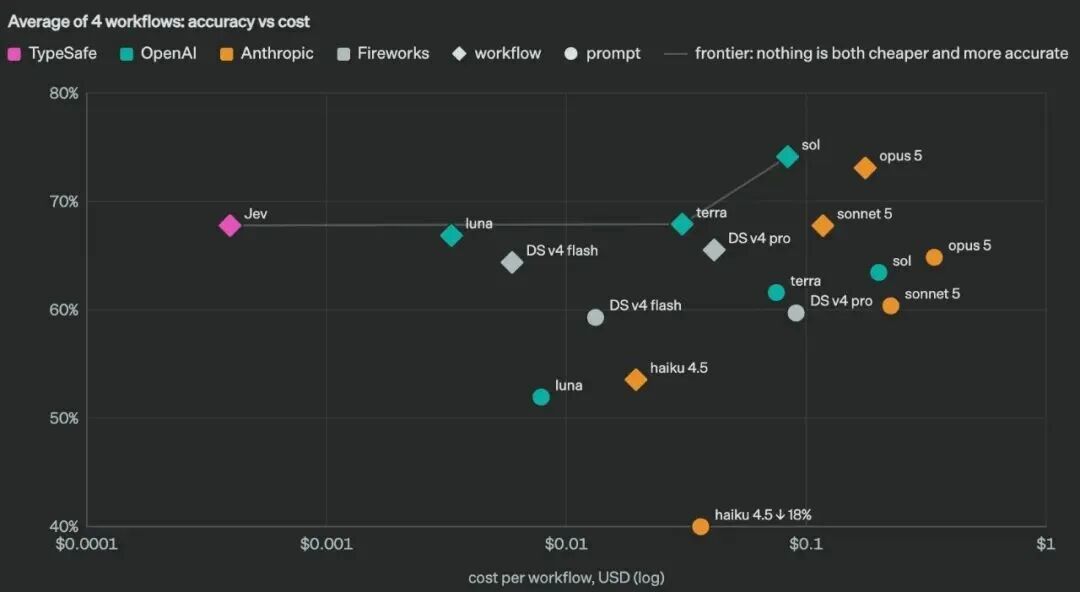
Una de las afirmaciones más contundentes de TypeSafe es que Jev no produce errores de tipo.
Esto requiere una interpretación precisa.
Significa que, si la aplicación declara un esquema de salida acotado, Jev devuelve un valor que cumple ese contrato de salida.
Por ejemplo:
Respuesta permitida:
- aprobar
- revisar
- rechazar
Jev no debería devolver de repente:
Aquí tienes un ensayo de cinco párrafos sobre mi razonamiento...
Esta es una propiedad de fiabilidad importante para el software de producción.
Pero la seguridad de tipos no significa que la decisión semántica sea siempre correcta.
Un modelo puede devolver un valor válido como rechazar y aun así tomar una decisión empresarial equivocada.
Por eso Jev también devuelve probabilidades e información de confianza, lo que permite a la aplicación definir umbrales como:
confianza >= 0,95
→ automatizar

0,70 <= confianza < 0,95
→ comprobación secundaria

confianza < 0,70
→ revisión humana
Por tanto, la utilidad del modelo depende tanto de la calidad de la clasificación como de su calibración.
La señal de adopción independiente más sólida del artículo original procede de Vercel.
Vercel añadió Jev a AI Gateway poco después de su lanzamiento y siguió la velocidad con la que los equipos de pago comenzaron a utilizarlo.
Según Vercel, Jev llegó a casi el 13 % de los equipos de pago en 24 horas.
En ese momento, esto suponía más del doble del alcance de cualquier lanzamiento de modelo anterior en la historia de AI Gateway.
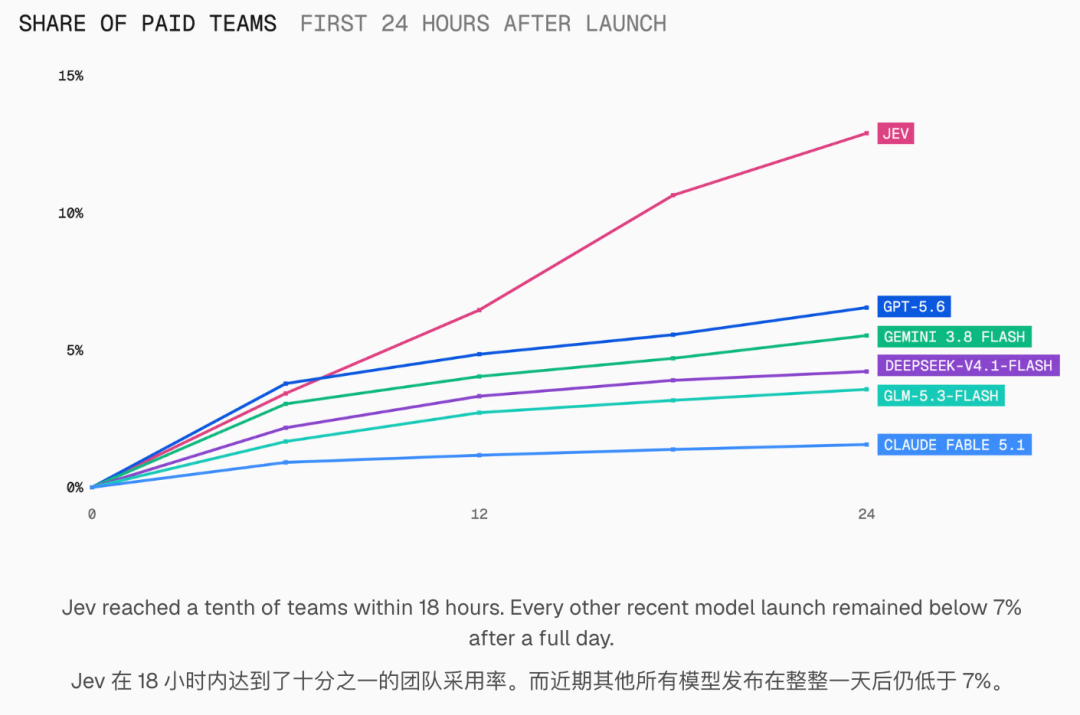
Vercel también señaló que Jev superó a todos los modelos de comparación durante sus primeras 12 horas y continuó ampliando su ventaja durante el primer día.
Esto importa porque el uso de Jev es diferente de la adopción casual de un chatbot.
Una persona puede probar un chatbot nuevo unas pocas veces y después dejar de utilizarlo.
Un modelo integrado en el software puede seguir recibiendo solicitudes de forma continua.
Esto crea un patrón de uso muy diferente:
Chatbot utilizado por una persona:
el usuario abre la aplicación
→ envía un mensaje
→ espera
→ cierra la aplicación

Modelo de decisiones integrado en el software:
llega una solicitud
→ se ejecuta el modelo de decisiones
→ la aplicación deriva según el resultado
→ se repite durante todo el día
El artículo de origen lo resume con una observación sencilla:
Las personas duermen. El código no.
El artículo original también cita a TypeSafe y a inversores que afirman que Jev llegó a procesar aproximadamente un billón de tokens en los tres días posteriores a su lanzamiento.
Más tarde, TypeSafe describió el tráfico como sostenido y no como un pico puntual.
La publicación de la Serie A de la empresa afirma ahora que aproximadamente un tercio de las empresas de Fortune 500 está utilizando o integrando Jev, y sostiene que los clientes ya han ahorrado millones de dólares en costes de producción.
Estas son métricas empresariales propias de TypeSafe y no cifras auditadas de forma independiente, pero ayudan a explicar por qué los inversores trataron a Jev como algo más que una demostración viral para desarrolladores.
El patrón de uso sugiere una demanda de máquina a máquina.
Una vez que Jev se integra en:
puede invocarse cada vez que el software que lo rodea llega a esa rama.
Ese es exactamente el tipo de carga de trabajo para el que TypeSafe lo diseñó.
La historia del origen de Jev es inusualmente simétrica.
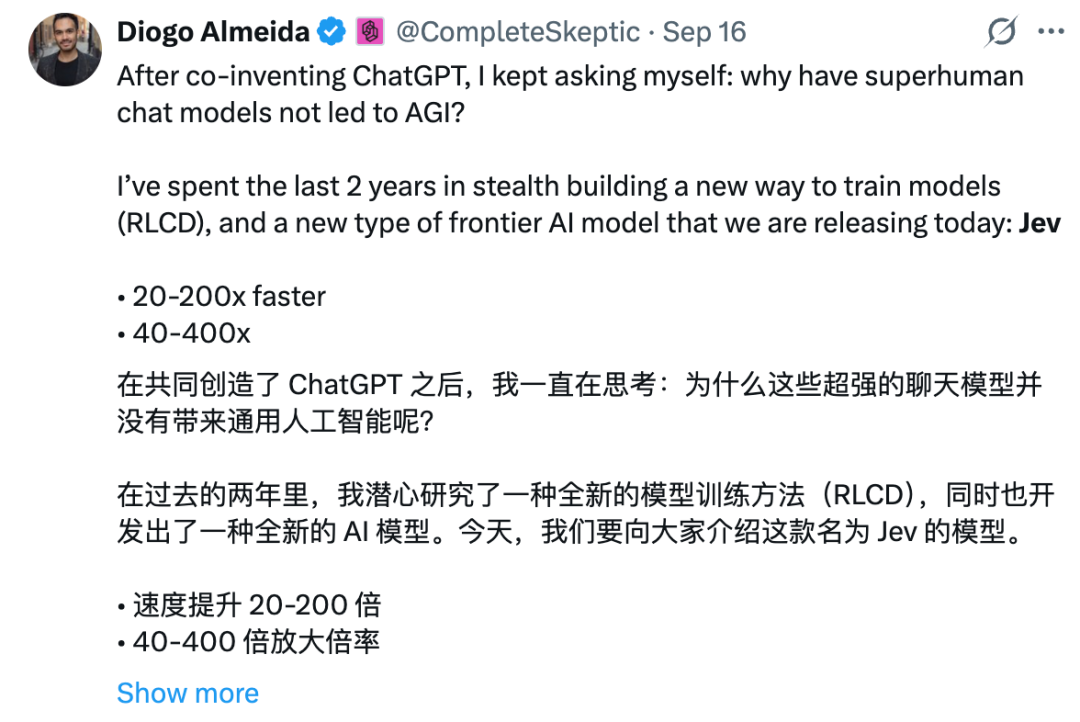
El cofundador y CEO de TypeSafe, Diogo Almeida, trabajó anteriormente en Google Brain y OpenAI.
La propia página del equipo de TypeSafe lo describe como coinventor de RLHF e InstructGPT, trabajos que ayudaron a dar lugar a ChatGPT y GPT-4.
En OpenAI, Almeida trabajó en los métodos que ayudaron a transformar modelos de lenguaje sin ajustar en sistemas capaces de seguir instrucciones e interactuar de forma natural con las personas.
Después de dejar OpenAI, se mostró cada vez más escéptico ante la idea de que el chat debiera ser la interfaz predeterminada para la inteligencia dentro del software.
Resumió ese cambio en la publicación de lanzamiento de Jev de TypeSafe: si los modelos se habían vuelto extremadamente capaces de conversar, ¿por qué la automatización no había avanzado al mismo ritmo?
Un chatbot está optimizado para la flexibilidad.
Esa flexibilidad es valiosa cuando una persona lee el resultado.
Pero el software de producción suele buscar lo contrario:
La posición de TypeSafe es que la generación de lenguaje de propósito general suele ser una abstracción innecesariamente potente para estas tareas.
En lugar de pedir a un modelo de frontera que escriba una respuesta estructurada y después validar el texto, Jev está diseñado para tomar directamente la decisión acotada.
El eslogan de la empresa resume esa filosofía:
Crea para producción, no un dios.
La formulación es deliberadamente provocadora, pero la idea subyacente es práctica: optimizar el software para que funcione de forma fiable en producción en lugar de tratar cada producto de IA como un paso hacia un modelo universal.
TypeSafe denomina a su método de entrenamiento Reinforcement Learning for Calibrated Decisions (RLCD).
La empresa lo contrasta con dos enfoques conocidos:
| Dirección del entrenamiento | Objetivo principal de optimización |
|---|---|
| RLHF | Respuestas que las personas prefieren |
| RLVR | Resultados de razonamiento verificables |
| RLCD | Decisiones estructuradas calibradas |
En el caso de Jev, la calibración es fundamental.
Si un modelo indica 0,90, el objetivo es que los eventos que reciben aproximadamente ese nivel de confianza sean realmente correctos cerca del 90 % de las veces en una distribución de evaluación adecuada.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Esto resulta mucho más útil para diseñar flujos de trabajo automatizados que una etiqueta sin calibrar.
Una aplicación puede convertir entonces la incertidumbre del modelo en una política:
confianza alta
→ automatizar

confianza media
→ consultar otro modelo o aplicar más reglas

confianza baja
→ escalar a una persona
Esta es una de las razones por las que los modelos de decisiones resultan atractivos para sistemas de gran volumen.
No eliminan la incertidumbre.
Hacen que la incertidumbre sea más fácil de consumir para el software.
El artículo original también destaca el escepticismo de Almeida ante la competencia basada en benchmarks públicos.
TypeSafe sí publica evaluaciones, pero sus materiales de lanzamiento dedican un esfuerzo inusual a documentar las salvedades.
Por ejemplo, la empresa señala explícitamente que:
Esta distinción es útil.
TypeSafe sigue promocionando su modelo de forma agresiva, pero no afirma que Jev deba sustituir a los LLM de frontera en todas partes.
Su propia documentación sitúa los productos de manera diferente:
LLM generativo
→ escribir, razonar, explicar, programar y conversar

Modelo de decisiones
→ clasificar, enrutar, puntuar, verificar, autorizar y priorizar
Ambos pueden trabajar juntos dentro del mismo sistema.
El liderazgo de TypeSafe va más allá de Almeida.
La página oficial del equipo enumera a:
El equipo ampliado incluye personas procedentes de empresas como OpenAI, Google Brain, Meta/FAIR, Stripe, Airbnb, Plaid y Docker.
Ese historial ayuda a explicar el énfasis del producto.
Jev tiene menos que ver con crear una nueva interfaz de consumo y más con crear algo que los desarrolladores puedan integrar profundamente en la infraestructura.
La rápida adopción de Jev también tuvo un segundo efecto.
Validó la categoría con suficiente rapidez como para que importantes empresas de infraestructura y modelos comenzaran a lanzar productos competidores en cuestión de semanas.
El artículo original termina precisamente con este cambio.
Microsoft anunció Microsoft-Decision-1, un modelo creado específicamente para la puntuación de decisiones estructuradas.
El modelo se basa en Qwen3.5-9B y está disponible en Microsoft Foundry en versión preliminar pública.
Admite tareas como:
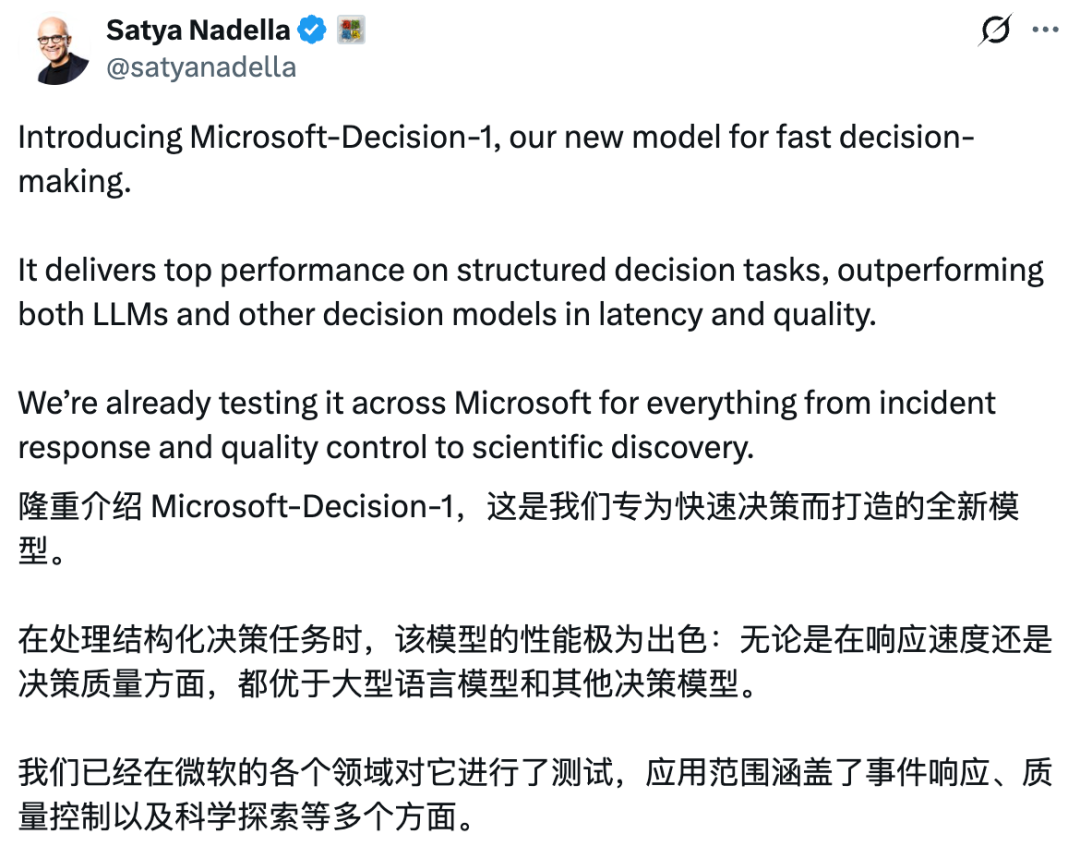
Cuando recibe un conjunto fijo de opciones, Microsoft-Decision-1 devuelve puntuaciones de probabilidad calibradas para esas opciones.
Microsoft afirma que el modelo logró la mayor precisión en su comparación de 36 benchmarks, que abarcó casi 150.000 preguntas, y sostiene que fue considerablemente más rápido que GPT-6 Sol en su evaluación interna.
Estas cifras proceden de los propios benchmarks de Microsoft, por lo que los desarrolladores deberían validar el modelo con sus propias cargas de trabajo antes de tratarlas como clasificaciones universales de rendimiento.
OpenAI avanzó en la misma dirección con su API de Decisions, publicada en beta pública el 6 de octubre de 2026.
La API funciona con GPT-6 Luna y acepta texto, imágenes o ambos.
Admite tres tipos de preguntas estructuradas:
| Tipo | Resultado |
|---|---|
| Predicado | Probabilidad de que una condición sea verdadera |
| Elección | Una selección entre las opciones proporcionadas, junto con probabilidades |
| Puntuación | Puntuación ponderada por probabilidad sobre niveles ordenados |
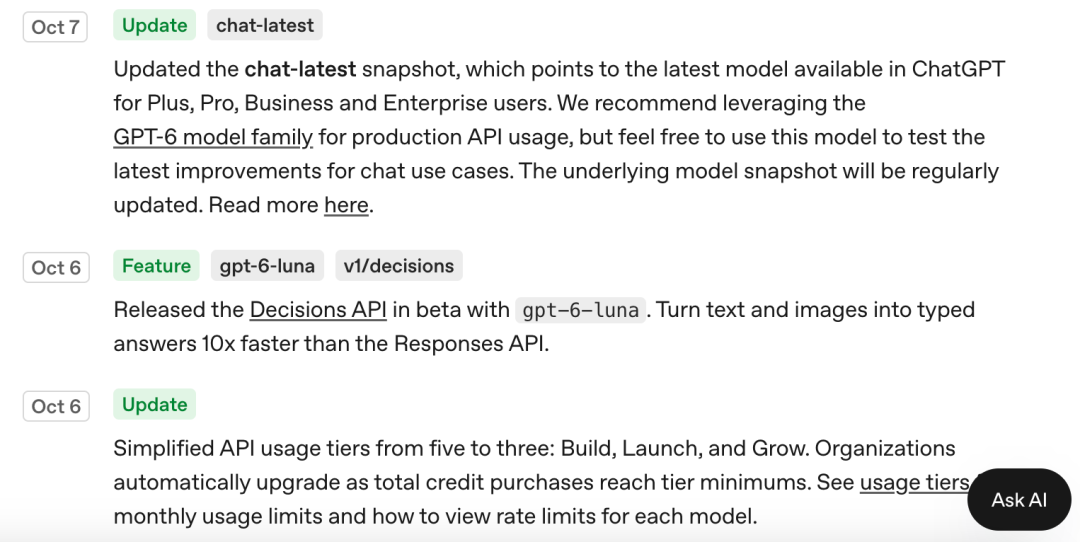
OpenAI afirma que la API especializada puede devolver decisiones aproximadamente 10 veces más rápido que GPT-6 Luna a través de la API de Responses para el tipo de tareas pertinente.
Su precio de beta es inusualmente sencillo:
Entrada: 0,10 $ / 1 millón de tokens
Salida: sin cargo por tokens de salida
Lectura de caché: sin cargo
Escritura de caché: sin cargo
La diferencia clave con Jev es arquitectónica.
Jev es la familia de modelos System One creada específicamente por TypeSafe.
La API de Decisions de OpenAI, en cambio, expone una interfaz especializada de decisiones alrededor de GPT-6 Luna.
Sin embargo, desde la perspectiva del desarrollador de aplicaciones, ambas resuelven una necesidad similar:
entra el estado
→ sale una decisión tipada y acotada
Cloudflare entró incluso antes, al anunciar Clef y Clef-flash el 1 de octubre.
Ambos son modelos de decisiones disponibles en Workers AI, y Cloudflare también publicó sus pesos con la licencia Apache 2.0.
Siguen una forma de API compatible con Jev, lo que facilita incorporarlos en flujos de trabajo creados alrededor de solicitudes de decisiones con estilo System One.
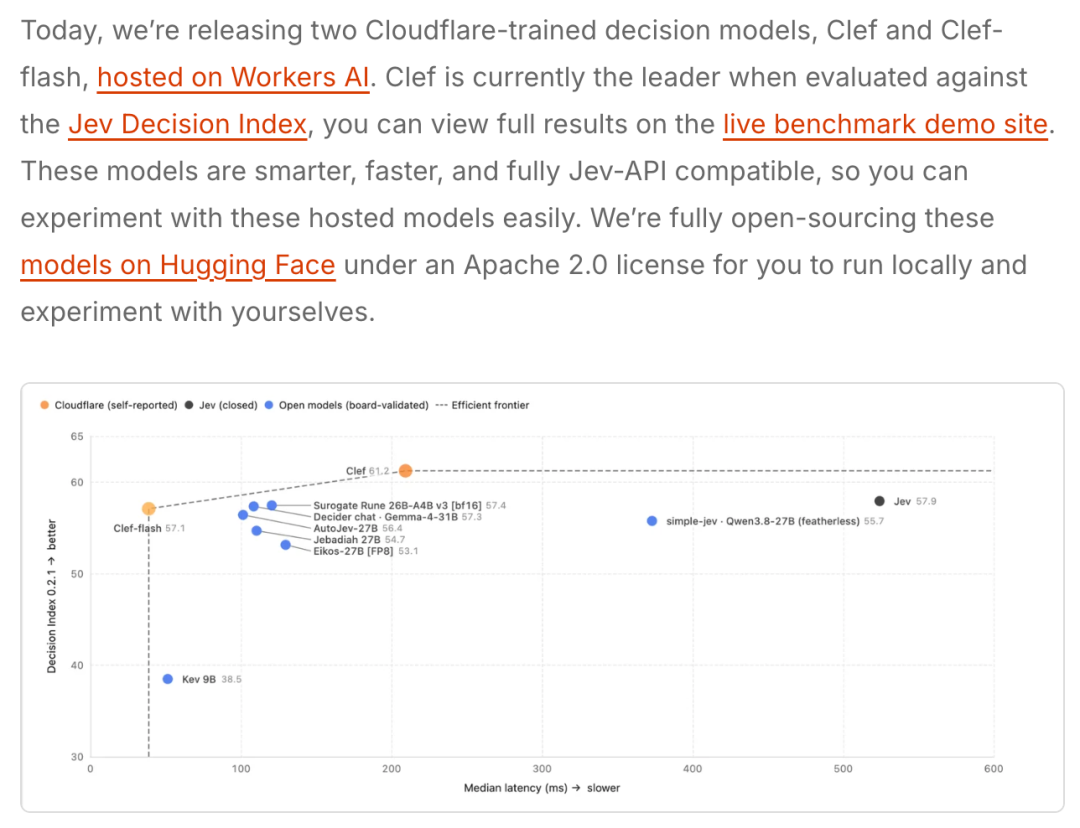
Cloudflare informa de lo siguiente:
| Modelo | Tamaño | Contexto | Enfoque previsto |
|---|---|---|---|
| Clef | 27B | 64K | Mayor calidad de decisión |
| Clef-flash | 9B | 64K | Latencia muy baja |
En el conjunto de pruebas propio de Cloudflare, Clef o Clef-flash lideraron 7 de los 10 benchmarks de decisiones destacados, mientras que Jev siguió siendo más fuerte en algunas tareas concretas, como When2Call y BRIGHT.
Cloudflare también informó de las siguientes latencias medianas:
Clef:       209,3 ms
Clef-flash: 38,8 ms
Jev:        524,1 ms
De nuevo, esas cifras proceden del entorno de evaluación de Cloudflare.
Son pruebas competitivas útiles, pero no una garantía universal de latencia para todas las implementaciones.
El punto central del artículo original no es solo que Jev haya recaudado una ronda enorme.
Es que una categoría de modelos pasó de ser inusual a estar abarrotada casi de inmediato.
En cuestión de semanas, el mercado contaba con:
Cada implementación es diferente, pero todas comparten una idea fundamental:
No todas las solicitudes de IA necesitan texto generativo.
Muchas tareas de producción se parecen más a instrucciones if inteligentes.
Por ejemplo:
si probabilidad_de_fraude > 0,98:
    bloquear()
elif probabilidad_de_fraude > 0,70:
    revisar()
si_no:
    permitir()
La parte difícil no es escribir la rama.
Es producir una probabilidad útil y calibrada a partir de un contexto real desordenado.
Los modelos de decisiones intentan hacer que esta capacidad sea lo bastante económica como para ejecutarse en todas partes.
A primera vista, los modelos de decisiones especializados parecen una amenaza para los LLM de propósito general.
En la práctica, podrían aumentar el consumo total de IA.
Un agente de propósito general puede utilizar un modelo de decisiones en puntos de control de alta frecuencia:
Solicitud del usuario
→ el modelo de decisiones elige la ruta
→ el LLM gestiona el razonamiento complejo solo cuando es necesario
→ el modelo de decisiones evalúa el resultado
→ el flujo de trabajo continúa o escala
Esto permite a los desarrolladores reservar el razonamiento costoso para las partes que realmente lo necesitan.
Todo lo demás puede gestionarse mediante modelos acotados más económicos.
El resultado podría ser un mayor número total de llamadas de IA, no menos.
Esta idea es coherente con el nombre Jev, que, según TypeSafe, hace referencia al economista William Stanley Jevons y a la paradoja de Jevons: mejorar la eficiencia puede aumentar el consumo total porque un coste menor desbloquea nuevos casos de uso.
En la infraestructura de IA, la misma lógica podría expresarse así:
decisiones más económicas
→ más decisiones se vuelven viables económicamente
→ más software incorpora puntos de control de IA
→ aumenta el uso total de inteligencia de máquina
Jev es el primer modelo System One de TypeSafe AI, diseñado para tomar decisiones rápidas y estructuradas en lugar de generar texto libre. Recibe el estado de la aplicación junto con preguntas tipadas y devuelve respuestas acotadas con probabilidades e información de confianza.
Actualmente, TypeSafe ofrece Jev a 0,042 dólares por millón de tokens de entrada y no contabiliza los tokens de salida. Este precio se aplica a la interfaz de decisiones estructuradas de Jev, no a un modelo de generación de texto de propósito general.
La afirmación formal más contundente de TypeSafe se refiere a la seguridad del tipo de salida: un esquema acotado impide que el modelo emita resultados arbitrarios con un formato incorrecto. Esto no significa que todas las decisiones semánticas sean correctas, por lo que la calibración, los umbrales, la evaluación y la revisión humana siguen siendo importantes.
Vercel afirma que casi el 13 % de los equipos de pago utilizó Jev en las 24 horas posteriores a su lanzamiento en AI Gateway. Vercel lo describió como el modelo adoptado más rápidamente en la historia de AI Gateway hasta ese momento.
La API de Decisions es un endpoint de OpenAI en beta pública impulsado por GPT-6 Luna. Acepta evidencias de texto e imagen y devuelve probabilidades de predicados, elecciones o puntuaciones. OpenAI afirma que ofrece una latencia aproximadamente 10 veces menor que el uso de GPT-6 Luna mediante la API de Responses para estas tareas de decisión.
Microsoft-Decision-1 es un modelo de decisiones estructuradas disponible en la versión preliminar pública de Microsoft Foundry. Se basa en Qwen3.5-9B y está diseñado para clasificación, enrutamiento, clasificación por rango, evaluación, verificación y control de flujos de trabajo.
Cloudflare describe Clef y Clef-flash como modelos de decisiones de código abierto o con pesos abiertos, y los ha publicado bajo la licencia Apache 2.0. También están alojados mediante Workers AI y utilizan un estilo de API System One compatible con Jev.
Por lo general, no. Los modelos de decisiones son más adecuados para decisiones acotadas y de gran volumen, mientras que los LLM generales siguen siendo mejores para la generación, la explicación, el razonamiento complejo y el uso abierto de herramientas. Muchos sistemas de producción utilizarán ambos.
La ronda Serie A de 870 millones de dólares de TypeSafe AI importa porque valida algo más que una startup. Valida una categoría de modelos: sistemas de decisiones rápidos, acotados y legibles por máquinas, diseñados para integrarse profundamente en el software de producción.
La rápida adopción de Jev en Vercel, su bajo precio de entrada, sus resultados estructurados y su diseño centrado en la calibración muestran por qué interesa a los desarrolladores. Sin embargo, sus principales afirmaciones de rendimiento aún deben interpretarse en contexto: algunas proceden directamente de TypeSafe, mientras que Vercel, Cloudflare, Microsoft y OpenAI publican sus propias mediciones bajo condiciones diferentes.
La señal de mercado más importante es la rapidez con la que aparecieron los competidores. En cuestión de semanas, Microsoft, OpenAI y Cloudflare ya tenían productos orientados al mismo problema básico.
El mayor logro de Jev quizá no sea un benchmark concreto ni una ronda de financiación, sino demostrar que una gran parte de la IA de producción no necesita hablar en absoluto.
Empieza con una sola frase y obtén un sitio completo en minutos.



