For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/loop-engineering-one-command-tutorial.md.
Esta guía explica cómo la ingeniería de bucles convierte prompts de IA puntuales en flujos de trabajo de agentes repetibles. La idea básica ...
Si has oído a la gente hablar de “Loop Engineering”, pero todavía no tienes claro por dónde empezar, esta guía te ofrece un punto de entrada práctico.
En lugar de escribir prompts repetidamente y revisar cada paso a mano, un bucle permite que un agente de IA trabaje hacia un objetivo pequeño siguiendo una programación. El sistema puede asignar la tarea, leer el estado actual, ejecutar el agente, verificar el resultado y volver a involucrar a una persona cuando se necesita criterio humano.
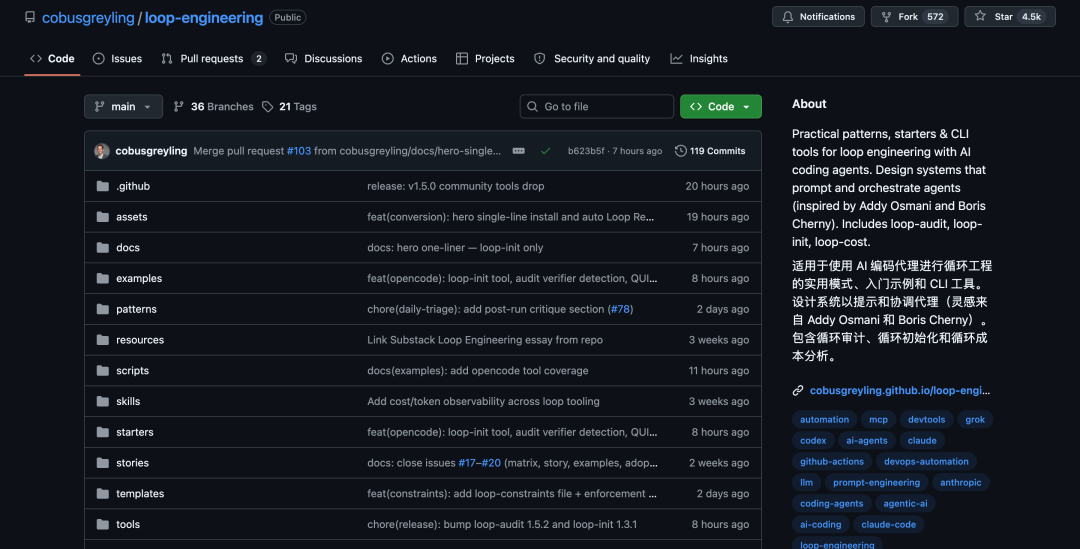
El informe original presentó un framework de Loop Engineering de código abierto creado por Cobus Greyling. En el momento del informe, el proyecto había alcanzado alrededor de 4,5 mil estrellas en GitHub. Es posible que el repositorio muestre ahora una cantidad distinta de estrellas porque ha seguido creciendo.
En resumen: el objetivo ya no es solo escribir mejores prompts. El objetivo es diseñar un bucle fiable que pueda generar prompts, comprobar resultados e iterar con límites claros.
Loop Engineering es una forma de diseñar flujos de trabajo repetibles para agentes de IA. Un bucle no es simplemente un prompt. Es un pequeño sistema operativo alrededor de un agente: define cuándo se ejecuta el agente, qué contexto lee, qué se le permite modificar, cómo se verifica el resultado y cuándo una persona debe revisar el resultado.
Un bucle típico puede utilizarse para tareas como:
Estas tareas no siempre son difíciles, pero sí repetitivas. Requieren atención, contexto y un estándar constante. Ese es exactamente el tipo de trabajo en el que un bucle bien diseñado puede ayudar.
El framework de código abierto descrito en el artículo original reúne patrones prácticos de bucles, plantillas iniciales y herramientas de línea de comandos. Está diseñado para agentes de codificación con IA y admite flujos de trabajo en torno a herramientas como Claude Code, Codex, Grok y OpenCode.
El framework incluye:
loop-init para generar la estructura inicial de un bucle;loop-cost para estimar el coste en tokens;loop-audit para comprobar si el bucle está listo;El mensaje central es sencillo:
Deja de escribir prompts. Diseña el bucle.
Eso no significa que los prompts desaparezcan. Significa que los prompts pasan a formar parte de un sistema más amplio que puede repetir trabajo, hacer seguimiento del estado y verificar resultados.
La forma más rápida de empezar es ejecutar loop-init dentro de un proyecto Git.
Nota: algunas versiones republicadas del artículo original muestran las opciones de línea de comandos con una raya larga. En una terminal real, utiliza el doble guion estándar
--que se muestra a continuación.
npx @cobusgreyling/loop-init . --pattern daily-triage --tool claude
Este comando genera la estructura inicial del bucle en tu proyecto actual. Puedes sustituir claude por otra herramienta compatible, como grok, codex u opencode, según el flujo de trabajo que quieras probar.
El patrón daily-triage es un buen punto de partida para principiantes porque tiene menos riesgo que la automatización de alta frecuencia. Se centra en escanear el estado actual del proyecto y producir un informe antes de permitir cualquier cambio automático.
Loop Engineering puede sonar abstracto al principio, pero el framework lo divide en unos pocos bloques de construcción concretos.
En un nivel básico, un bucle se construye a partir de cinco partes principales, más memoria y estado.
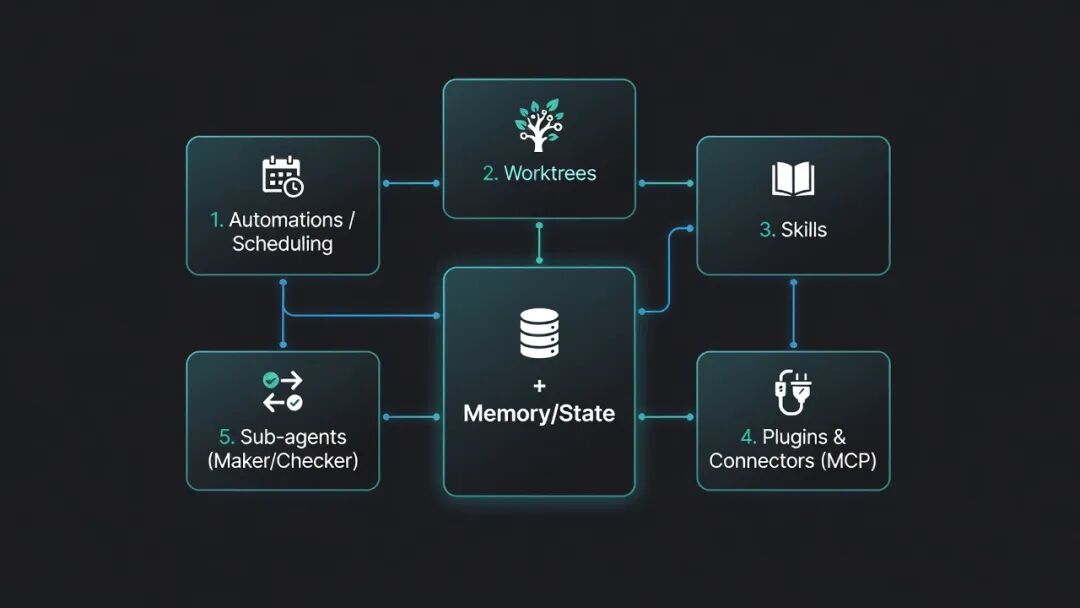
| Bloque de construcción | Qué hace en el bucle |
|---|---|
| Automatización / Programación | Ejecuta el bucle con una cadencia, por ejemplo diaria, horaria o cada pocos minutos. |
| Worktrees | Crea entornos de trabajo aislados para que varios agentes no se sobrescriban entre sí. |
| Habilidades | Almacena conocimiento reutilizable del proyecto, reglas e instrucciones de tareas. |
| Plugins y conectores | Conecta el bucle con herramientas reales mediante sistemas como MCP, GitHub, Linear o Slack. |
| Subagentes | Separa el rol de creador del rol de verificador para que el mismo agente no apruebe su propio trabajo. |
| Memoria / Estado | Mantiene contexto duradero fuera de la |
chat, normalmente a través de archivos como STATE.md. |
Esta estructura hace que el bucle sea más fácil de razonar. No le estás pidiendo al modelo que “simplemente se encargue de todo”. Le estás dando un entorno definido, una programación, un archivo de estado, una ruta de verificación y una regla de derivación a un humano.
El framework también incluye siete patrones orientados a producción. Cada patrón tiene una cadencia, un nivel de riesgo y un caso de uso recomendado diferentes.
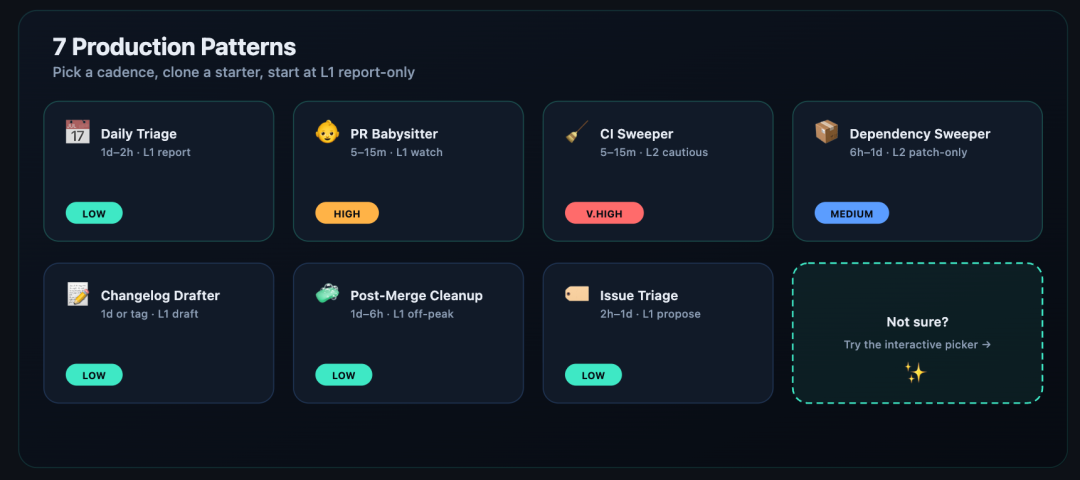
| Patrón | Caso de uso típico | Modo inicial sugerido |
|---|---|---|
| Daily Triage | Analizar el estado del proyecto, incidencias, CI y commits. | L1 solo informe |
| PR Babysitter | Supervisar pull requests durante la revisión, CI, rebase y merge. | L1 supervisión |
| CI Sweeper | Supervisar comprobaciones fallidas y proponer o aplicar pequeñas correcciones. | L2 cauteloso |
| Dependency Sweeper | Revisar dependencias obsoletas y actualizaciones de seguridad. | L2 solo parches |
| Issue Triage | Deduplicar, puntuar y etiquetar incidencias entrantes. | L1 solo propuestas |
| Post-Merge Cleanup | Limpiar TODOs, deuda menor y trabajo de seguimiento después de los merges. | L1 fuera de horas punta |
| Changelog Drafter | Redactar notas de versión a partir de commits y cambios fusionados. | L1 borrador |
El consejo práctico es empezar con un bucle de bajo riesgo. Daily triage suele ser más fácil de confiar porque no necesita cambiar código de inmediato.
El proyecto también ofrece un selector interactivo. En lugar de elegir un patrón manualmente, puedes partir de un punto de dolor como “los PR se quedan bloqueados”, “CI sigue fallando” o “las incidencias generan demasiado ruido”.
Luego, el selector recomienda un patrón de bucle y te da un comando inicial. Esto resulta útil cuando conoces el problema, pero no tienes claro qué bucle debería encargarse de él.
Aquí tienes una forma apta para principiantes de ejecutar el primer bucle manteniendo el riesgo bajo control.
Empieza con daily-triage si es tu primera vez. Es un patrón de bajo riesgo y una buena forma de entender cómo el bucle lee el estado del proyecto, escribe notas y prepara trabajo para un humano.
Ejecuta el comando de inicialización en el directorio raíz de tu proyecto Git.
npx @cobusgreyling/loop-init . --pattern daily-triage --tool claude
Puedes cambiar el nombre de la herramienta si estás usando otro agente de codificación con IA.
npx @cobusgreyling/loop-init . --pattern daily-triage --tool grok
npx @cobusgreyling/loop-init . --pattern daily-triage --tool codex
npx @cobusgreyling/loop-init . --pattern daily-triage --tool opencode
También puedes sustituir daily-triage por otro patrón compatible cuando entiendas el flujo básico.
Los bucles de alta frecuencia pueden consumir muchos tokens, especialmente si usan subagentes, contexto largo o verificación repetida. Estima el coste antes de ejecutar un bucle con demasiada frecuencia.
npx @cobusgreyling/loop-cost --pattern daily-triage --level L1
Para las primeras pruebas, mantén el bucle en L1 y evita programaciones agresivas.
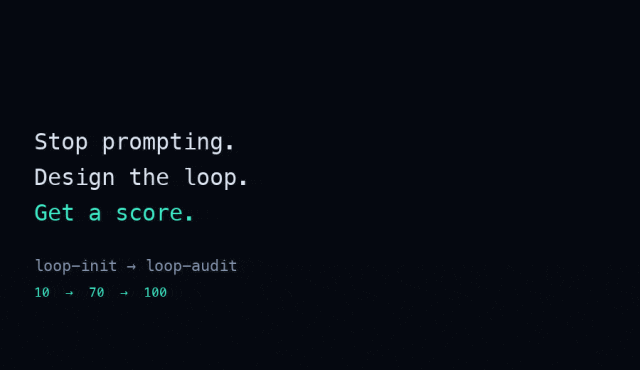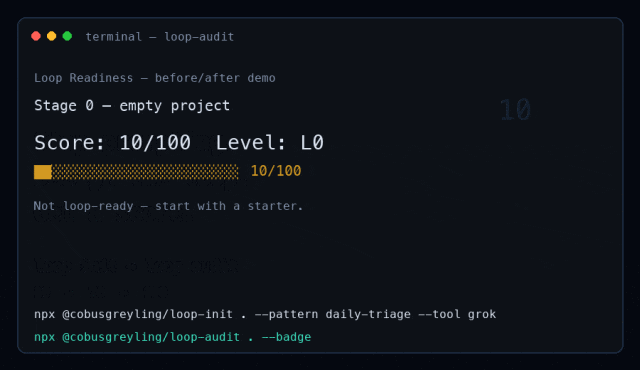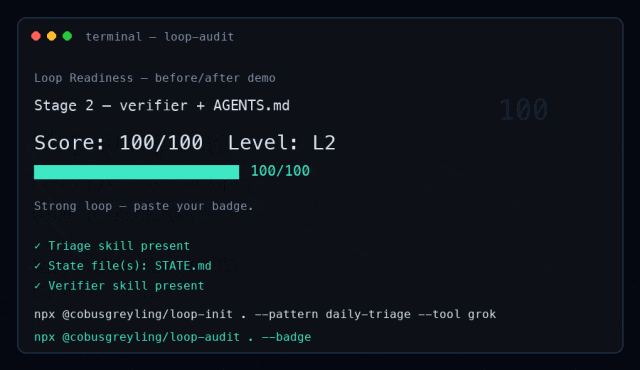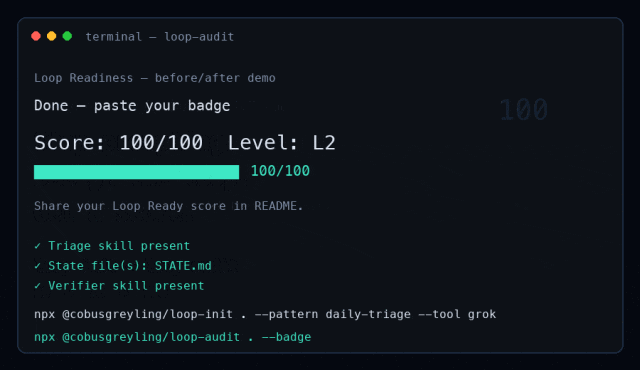
Antes de confiar en el bucle, ejecuta una auditoría. La auditoría da al proyecto una puntuación de preparación de 0 a 100 y sugiere mejoras.
npx @cobusgreyling/loop-audit . --suggest
Si tu proyecto no está listo, corrige primero las piezas que faltan. Las carencias comunes incluyen la ausencia de un archivo de estado, la falta de un paso de verificación, un alcance poco claro, límites de presupuesto inexistentes o reglas débiles de derivación a un humano.
Si el proyecto alcanza un buen nivel de preparación, también puedes generar una insignia Loop Ready para tu README.
npx @cobusgreyling/loop-audit . --badge
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
No permitas que el bucle modifique código de producción el primer día. Empieza con el modo solo informe y luego revisa el resultado manualmente.
Para un comando de bucle al estilo Grok, la primera ejecución podría verse así:
/loop 1d Run loop-triage. Update STATE.md. No auto-fix in week one.
Esto le indica al bucle que realice el triage, escriba el estado y evite correcciones automáticas durante la primera semana.
Abre STATE.md y comprueba qué encontró el bucle. Este archivo actúa como memoria fuera de la conversación. Debería mostrar qué vio el bucle, qué hizo, qué omitió y qué requiere atención humana.
Si el resultado es ruidoso o incorrecto, ajusta el bucle antes de aumentar la autonomía. Un bucle útil debería volverse aburrido, predecible e inspeccionable.
Loop Engineering debería desplegarse de forma gradual. Los niveles de madurez te ayudan a evitar conceder demasiada libertad demasiado pronto.
| Nivel | Significado | Uso recomendado |
|---|---|---|
| L1 | El bucle informa hallazgos y actualiza el estado, pero no cambia código. | Ideal para primeras ejecuciones y adopción de bajo riesgo. |
| L2 | El bucle puede hacer pequeños cambios con un verificador y revisión humana. | Útil cuando el equipo ya confía en el resultado del bucle. |
| L3 | El bucle puede ejecutarse durante periodos más largos con ejecución limitada sin supervisión. | Solo adecuado cuando el alcance, la seguridad, el coste y la verificación están maduros. |
Un buen primer objetivo no es la autonomía total. Un buen primer objetivo es un bucle L1 fiable que te dé información útil sin
creando trabajo adicional de limpieza.
Un loop completo tiene una secuencia clara. El artículo original lo describía como un proceso de ocho pasos:
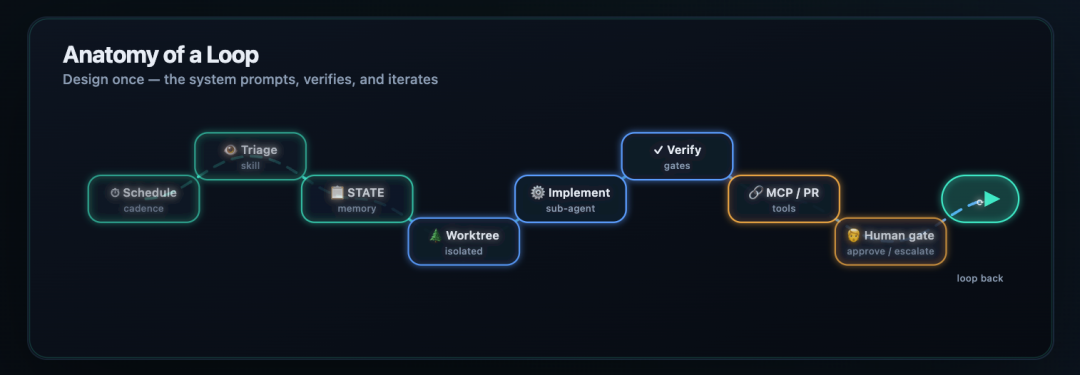
Esta es la principal diferencia entre un prompt informal y un loop real. El agente no está simplemente “haciendo cosas”. Está trabajando dentro de un proceso controlado con estado, aislamiento, comprobaciones y transferencia.
El artículo original también conectaba Loop Engineering con la reflexión de Andrew Ng sobre el desarrollo de productos. La idea clave es que crear software con IA no es solo un loop. Para un producto real, hay varios loops que avanzan a diferentes velocidades.
El loop más interno es el loop de codificación. Una persona entrega al agente una especificación de producto y criterios de evaluación. El agente escribe código, lo prueba, corrige problemas y sigue iterando.
Este loop puede ser rápido. En algunos casos, puede producir una nueva versión cada pocos minutos.
La siguiente capa es el loop de feedback del desarrollador. El agente puede probar y revisar, pero el desarrollador sigue comprobando si el resultado se siente correcto, encaja con la dirección del producto y resuelve el problema real del usuario.
Este loop es más lento. Puede ejecutarse cada algunas decenas de minutos o cada pocas horas, según el producto y la complejidad de los cambios.
La capa externa es el loop de feedback de usuarios. Una vez que el producto llega a amigos, testers alfa o usuarios reales, el equipo empieza a aprender a partir del feedback, los datos de uso y los experimentos.
Este loop vuelve a ser más lento. Puede tardar horas, días o semanas.
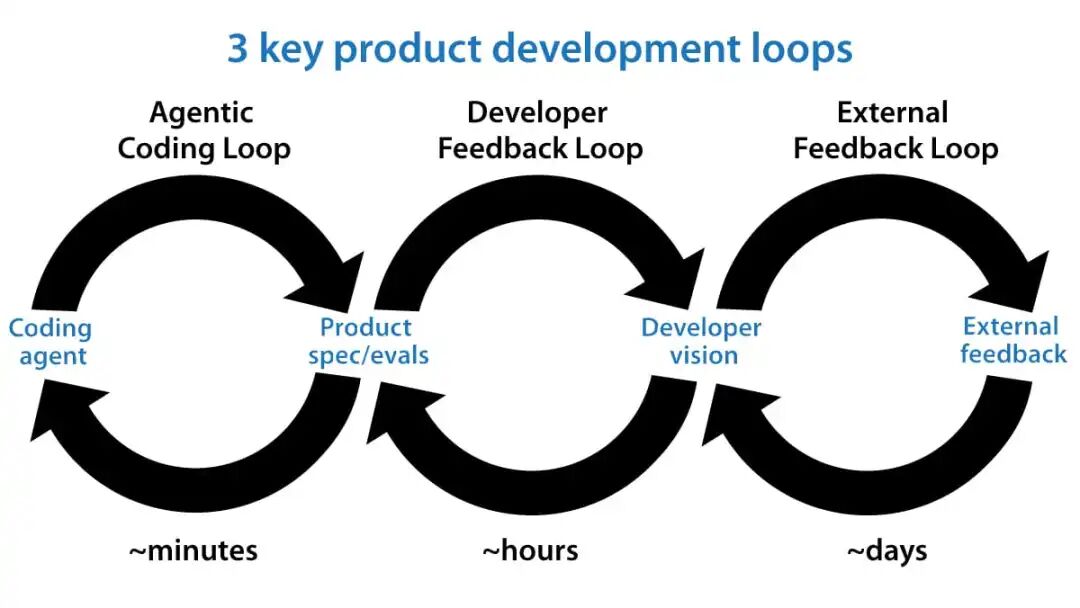
Juntos, los tres loops crean una cadena práctica de construcción de productos: el agente ayuda a producir versiones rápidamente, el desarrollador decide en qué debe convertirse el producto, y los usuarios demuestran si vale la pena seguir esa dirección.
Loop Engineering no elimina a los humanos del desarrollo de software. Cambia el rol humano.
El agente puede encargarse de la ejecución repetida, pero aún necesita límites claros, verificación sólida y juicio de producto. La persona sigue entendiendo el contexto: qué necesitan los usuarios, qué compromisos importan, qué no debería automatizarse y qué significa realmente “suficientemente bueno”.
Por eso un loop puede instalarse con un solo comando, pero la definición de “terminado” sigue perteneciendo a las personas que construyen el producto.
Fuente original: artículo de BAAI Hub, sindicado desde QbitAI / WeChat. El artículo también hacía referencia al repositorio de Loop Engineering en GitHub y a la publicación pública de Andrew Ng en X.
Nota sobre las imágenes: la imagen inicial tipo meme y el banner promocional final con QR/contacto de la página fuente se excluyeron porque no son necesarios para entender el tutorial. Las imágenes restantes se incluyen solo cuando apoyan la explicación técnica.
Loop Engineering es una forma de diseñar flujos de trabajo repetibles para agentes de IA. En lugar de dar prompts manualmente al agente para cada pequeña tarea, defines un loop con programación, estado, herramientas, verificación y transferencia a humanos.
El punto de partida más rápido es ejecutar npx @cobusgreyling/loop-init . --pattern daily-triage --tool claude dentro de un proyecto Git. Para principiantes, daily-triage suele ser más seguro que los loops de alta frecuencia porque puede empezar en modo solo informe.
STATE.md?STATE.md le da al loop una memoria duradera fuera de la sesión de chat. Ayuda al loop a recordar hallazgos anteriores, últimas acciones, elementos sin resolver y anulaciones humanas.
La puntuación Loop Ready es un resultado de auditoría producido por loop-audit. Comprueba si el proyecto tiene suficiente estructura, estado, verificación, límites de coste y controles de seguridad para ejecutar un loop de forma responsable.
Puede
puede, pero no debería empezar así. Un camino más seguro es comenzar con L1 en modo solo informe, luego pasar a L2 con correcciones asistidas y verificación, y solo más adelante ejecutar L3 sin supervisión cuando el alcance, la seguridad y los controles de coste estén maduros.
Los bucles pueden volverse costosos si se ejecutan con frecuencia, usan contextos largos o generan varios subagentes. loop-cost te ayuda a estimar el uso antes de que un flujo de trabajo de alta frecuencia consuma el presupuesto.
El bucle de ingeniería ayuda a los agentes a crear y revisar software rápidamente. La retroalimentación de los desarrolladores y la retroalimentación de los usuarios son bucles más lentos que determinan si el producto es útil, usable y si vale la pena seguir desarrollándolo.
npx.npx.Esta guía explica cómo Loop Engineering convierte prompts de IA puntuales en flujos de trabajo de agentes repetibles. La idea básica es definir la programación, el estado, las herramientas, la verificación y el proceso de revisión humana antes de confiar en que un agente actúe repetidamente.
Para una primera ejecución, daily-triage es el punto de partida más seguro. Genera la estructura del bucle, estima el coste en tokens, audita la preparación y mantén la primera semana en modo solo informe.
La lección más amplia no es que los humanos desaparezcan del desarrollo. Los agentes pueden avanzar más rápido dentro de los bucles, pero el criterio de producto, los límites de seguridad y la definición de “terminado” siguen dependiendo de las personas.
El mejor primer bucle no es el más autónomo. Es el que puedes inspeccionar, en el que puedes confiar y que puedes mejorar.
Empieza con una sola frase y obtén un sitio completo en minutos.



