For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/matrix-game-4-0-rtx-5090-neural-rendering-59d3cc6b.md.
Matrix-Game 4.0 de Skywork AI separa dos tareas que es fácil confundir en un juego generado por IA. Un motor ejecutable mantiene las reglas ...
Matrix-Game 4.0 de Skywork AI separa dos tareas que es fácil confundir en un juego generado por IA. Un motor ejecutable mantiene las reglas y el estado físico; un modelo de vídeo causal convierte las imágenes de baja poligonización del motor en fotogramas más detallados.
Esta separación es la idea central del proyecto. Si un personaje recoge un escudo, recibe daño o completa una misión, el motor decide lo que ocurrió. El renderizador neuronal se encarga de cómo se ve, en lugar de convertir los píxeles generados en la autoridad final sobre la puntuación o la salud del jugador.
El lanzamiento también incluye una ruta de inferencia con una única GPU RTX 5090. Las preguntas importantes son qué miden las demostraciones, qué capacidades están realmente presentes en el código publicado y hasta qué punto siguen siendo especializados los modelos descargables.
Un modelo de vídeo puede generar movimiento convincente sin proporcionar una representación fiable de cada regla del juego. Un fotograma visualmente plausible no establece necesariamente dónde está un enemigo, quién posee un objeto o si una colisión debería terminar la partida.
Matrix-Game 4.0 mantiene esos hechos en el código. El motor procesa la entrada, evoluciona el mundo y produce una vista RGB de baja poligonización comparativamente económica. A continuación, el modelo de vídeo genera la presentación visual final a partir de esa entrada estructurada.
El repositorio oficial denomina a este enfoque jugabilidad basada en el motor y renderizado neuronal en streaming. Es un sistema híbrido, no una afirmación de que el modelo haya aprendido y ejecute de forma fiable todos los aspectos de un motor de juego general internamente.
Por tanto, un error visual no cambia directamente la colisión subyacente ni el estado de juego. Aun así, puede confundir al jugador, de modo que esta arquitectura separa dos modos de fallo en lugar de eliminar todos los errores.
La página del proyecto presenta un marco que combina un agente de programación y un motor de juego. Las instrucciones del usuario pueden convertirse en nuevas reglas o indicaciones, mientras que el motor proporciona el estado necesario para mantener la coherencia del mundo.
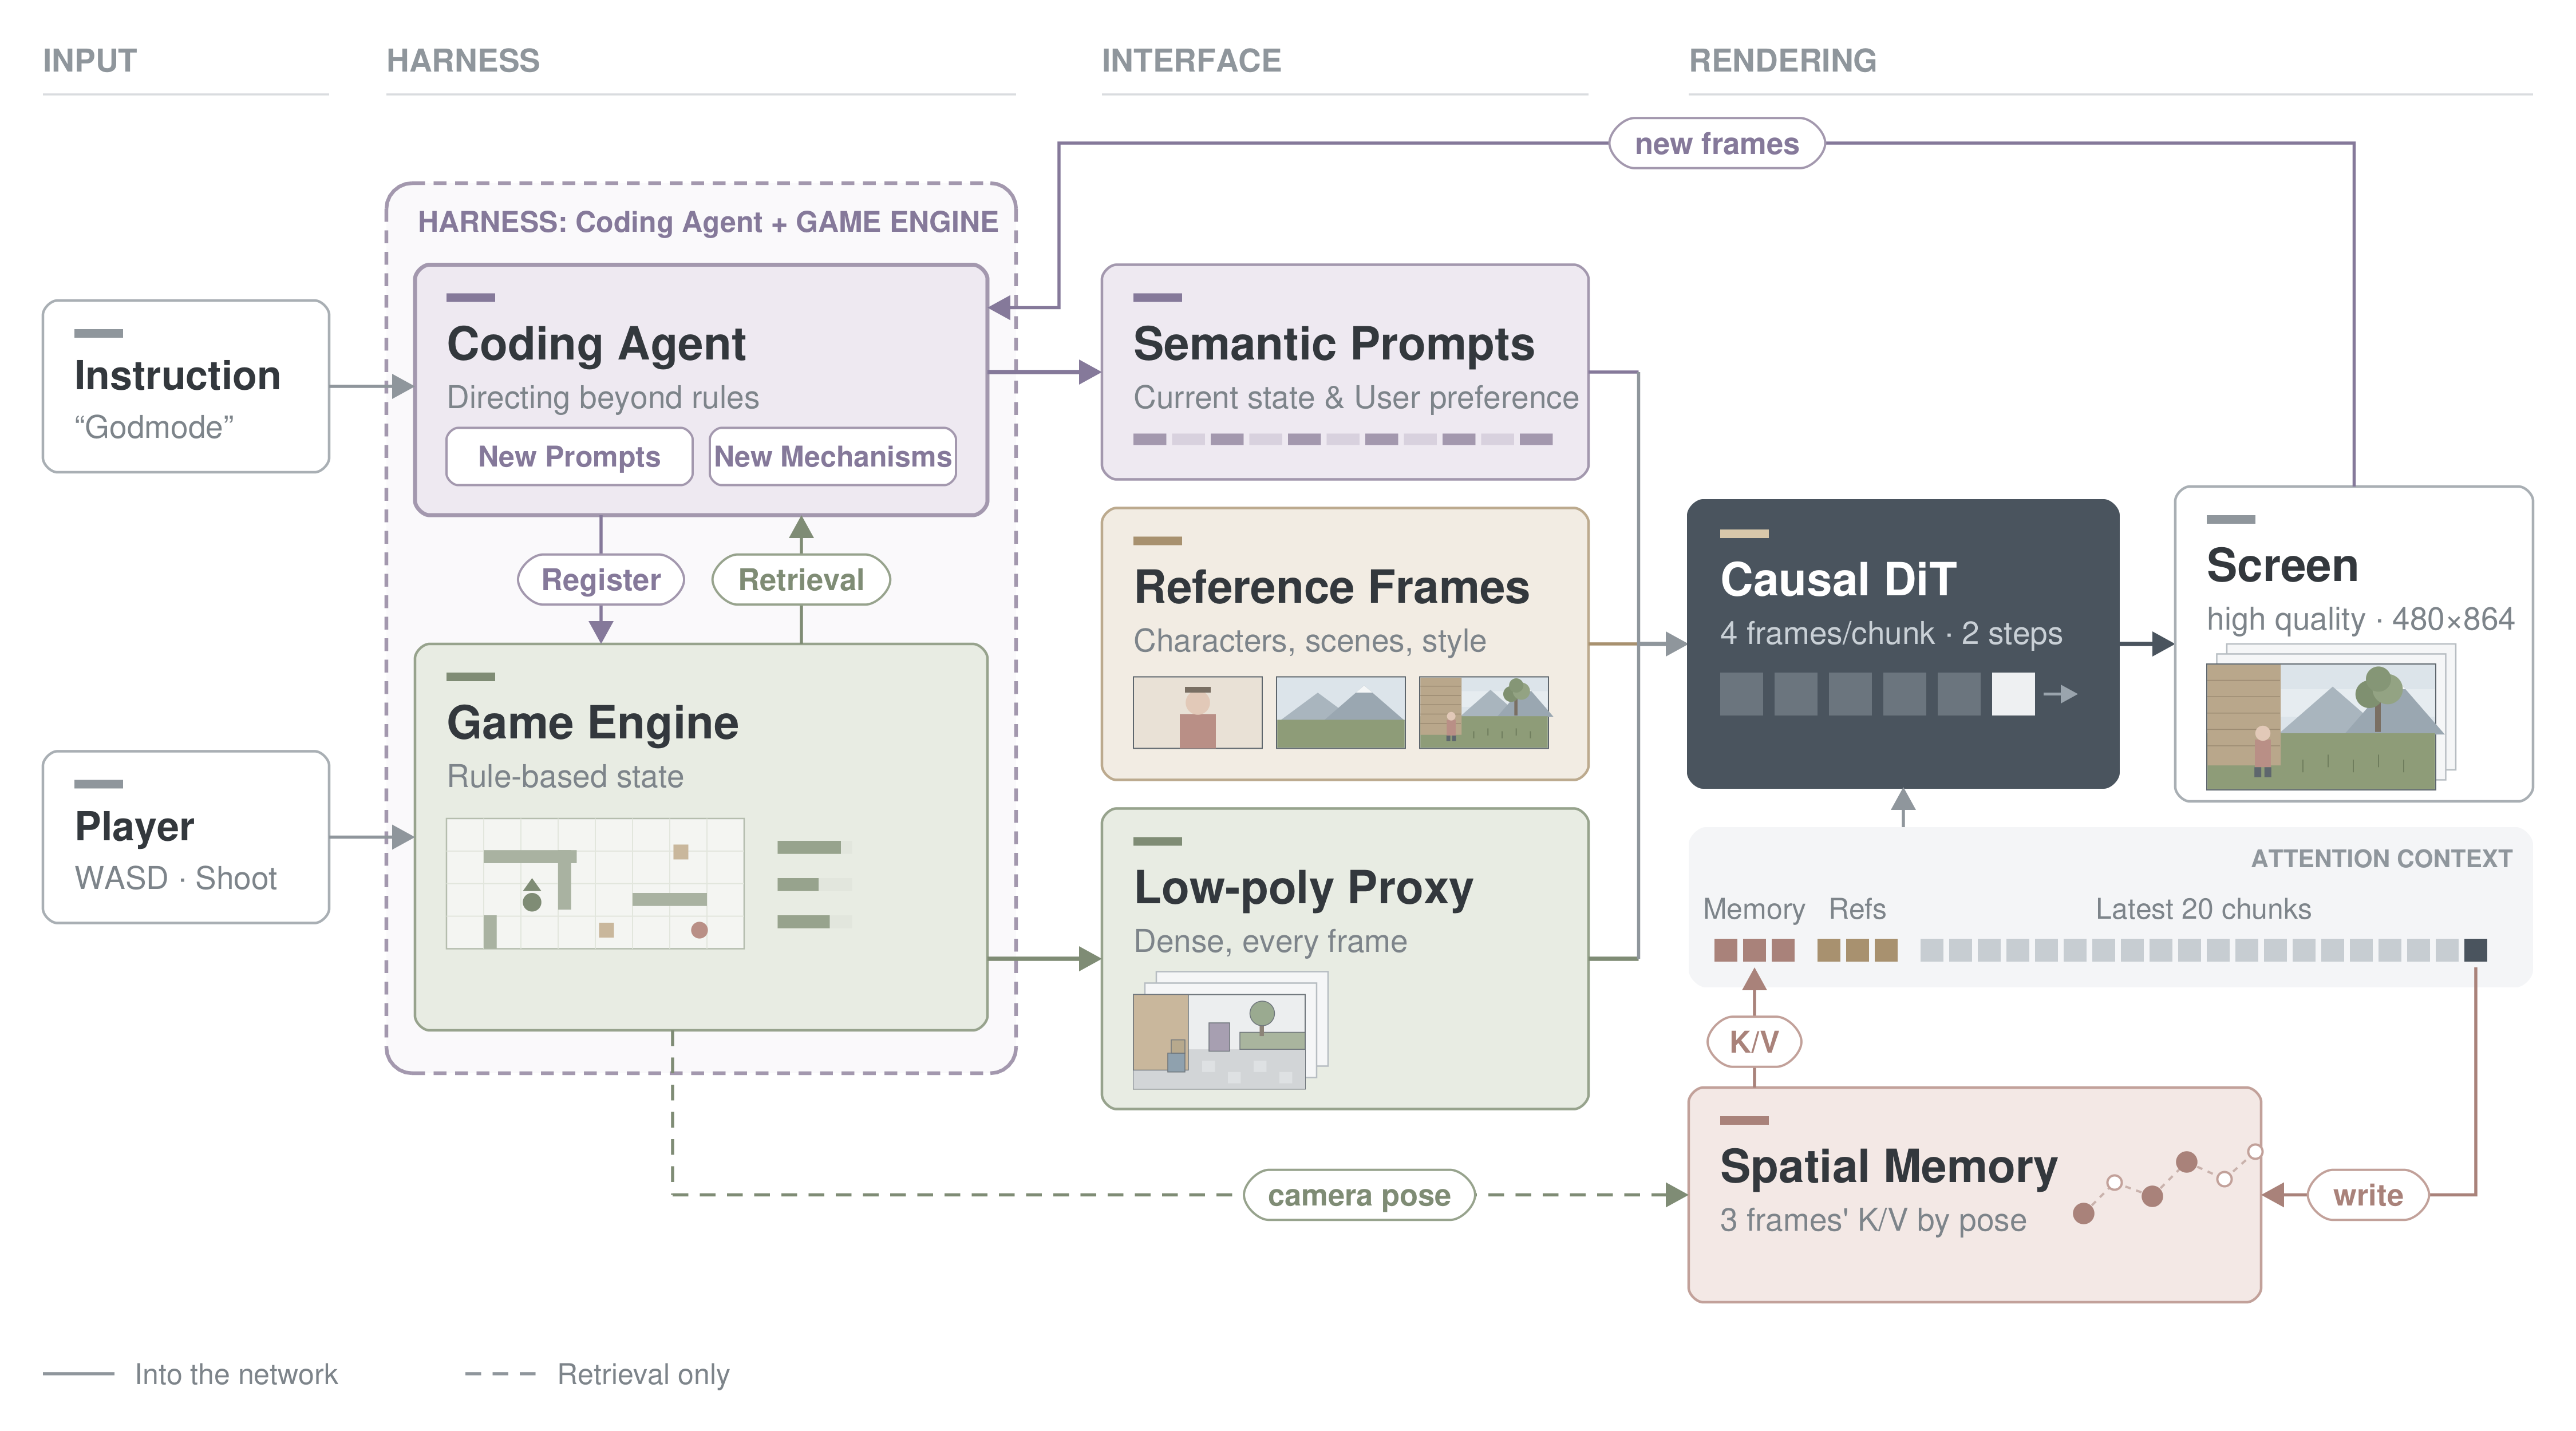
Fuente: página del proyecto Matrix-Game 4.0, Skywork AI. Esta figura conceptual incluye recuperación de memoria espacial; el tiempo de ejecución del shooter publicado tiene un comportamiento más limitado, descrito a continuación.
En términos generales, el flujo de trabajo es el siguiente:
Los ejemplos de QbitAI incluyen la durabilidad del escudo antes de la pérdida de salud y una tarea de carreras modificada de contrarreloj a persecución. Estos casos ilustran el beneficio de las reglas explícitas: modificar la jugabilidad significa cambiar y probar el código, no simplemente pedir al modelo de vídeo que represente un resultado diferente.
La tarjeta del modelo en Hugging Face describe tres renderizadores especializados por escena: Castillo medieval, Antiguo Egipto y Carreras urbanas. Cada punto de control tiene aproximadamente cinco mil millones de parámetros BF16 y requiere el código fuente de inferencia de Matrix-Game 4.0.
Estos pesos no son canalizaciones de Diffusers listas para usar. El lanzamiento proporciona código de inferencia, una demostración en navegador, código fuente del juego nativo, modelos y recursos del juego, mientras que la tarjeta del modelo indica explícitamente que no se incluyen ni el código de entrenamiento ni los datos de entrenamiento.
La salida es RGB de 480 por 864. Tras el inicio, un fragmento latente corresponde a cuatro fotogramas RGB; el fragmento de inicio contiene un fotograma. Los recursos compartidos suministrados y las políticas específicas de cada escena son importantes, por lo que los códecs arbitrarios o la configuración de referencia de otra escena no son sustitutos equivalentes.
Los elementos del HUD y el audio siguen siendo capas de presentación independientes y alineadas por fotogramas. El modelo no genera todos esos componentes simplemente porque aparezcan juntos en una demostración terminada.
La ilustración del proyecto incluye memoria espacial recuperada mediante la pose de cámara y descripciones semánticas dinámicas. El contrato de tiempo de ejecución actual es más específico: la configuración del shooter publicada utiliza una indicación de escena fija y una caché limitada, y enumera explícitamente que no hay memoria recuperada ni generación dinámica de indicaciones en esa configuración.
Las carreras admiten subtítulos dinámicos fijos o alineados por fragmentos suministrados por el motor. El condicionamiento dinámico conserva el codificador de texto y actualiza las entradas de caché relacionadas con texto cuando cambia el subtítulo, lo que tiene un coste de rendimiento.
Esta distinción evita que un atractivo diagrama de investigación se convierta en una lista inexacta de funciones para la demostración descargable. Compruebe la escena y el preajuste utilizados antes de asumir que un mecanismo mostrado se ejecuta en esa ruta.
El informe de origen agrupa la ingeniería en la reducción de lo que el modelo debe inferir, recordar y calcular. El material oficial respalda los mecanismos principales: condicionamiento visual de baja poligonización, información de referencia, una caché limitada de historial reciente y generación causal con pocos pasos.
En lugar de sintetizar una escena solo a partir de texto, el modelo recibe una estructura renderizada por el motor. Los objetos y el movimiento de cámara llegan, por tanto, como restricciones visuales. El condicionamiento de texto añade semántica de la escena, y el modo publicado varía según la escena.
Para la inferencia, la ruta en tiempo real utiliza el códec TAEHV, un paso de eliminación de ruido, ejecución DiT optimizada y gráficos CUDA. El preajuste de calidad utiliza codificación y decodificación Wan, dos pasos de eliminación de ruido y DiT nativo. La documentación advierte que estos modos tienen costes de calidad y computación diferentes.
En RTX 5090, los preajustes dedicados convierten los pesos lineales de los bloques DiT a FP8 durante la carga y cuantizan las activaciones durante la inferencia. Las incrustaciones y la cabeza de salida se mantienen en BF16. El modo rtx5090 simple utiliza PyTorch SDPA; rtx5090-sage requiere una compilación adicional modificada de SageAttention.
La página del proyecto presenta una demostración de un paso en RTX 5090 con las siguientes cifras. Estas describen la configuración mostrada, no una garantía de frecuencia de fotogramas para todas las escenas o todos los equipos.
| Cifra de la página del proyecto | Qué mide o describe |
|---|---|
| 83 FPS | Demostración de eliminación de ruido en un paso en RTX 5090. |
| 48 ms | Eliminación de ruido de un fragmento, correspondiente a cuatro fotogramas RGB tras el inicio. |
| 112 ms | Desde la pulsación de una tecla hasta el primer fotograma que reacciona en la demostración reportada. |
| 480p | Categoría de resolución de salida en streaming. |
| Una GPU | Codificador de texto, DiT y VAE residentes en la configuración mostrada. |
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
QbitAI también informa de aproximadamente 57 FPS con eliminación de ruido de dos pasos, cerca de 18,5 GiB de memoria máxima de GPU y jugabilidad presentada a 60 FPS. Son cifras reportadas por la fuente; no deben combinarse como si todos los modos lograran simultáneamente todas ellas.
Los ejemplos de navegador del README actual utilizan --fps 40, pero indican explícitamente que se trata de una cadencia objetivo de captura del juego, no de una garantía medida de rendimiento de renderizado o latencia. El inicio y el calentamiento también difieren de la inferencia en estado estable.
La codificación de vídeo, el almacenamiento en búfer, el transporte y la decodificación del navegador añaden trabajo más allá del tiempo de eliminación de ruido del modelo. Por esa razón, una cifra de inferencia por fragmento, el rendimiento de la canalización del servidor y la latencia desde la acción hasta el fotón son métricas diferentes.
La fuente también compara el sistema con una configuración de investigación distinta de NVIDIA. Sin igualar hardware, resolución, calidad y definiciones de latencia, esas cifras no establecen una clasificación universal justa.
El README de v4 documenta Linux con una GPU NVIDIA y Python 3.12 para inferencia, además del entorno correspondiente de PyTorch, CUDA y controladores. Una demostración en navegador también necesita el juego nativo y las dependencias multimedia en el host. El cliente de navegador no necesita su propia GPU de inferencia.
Antes de la primera ejecución:
Matrix-Game-4/, no desde el directorio principal.El descargador asigna las carpetas de escena del Hub a rutas de tiempo de ejecución, por lo que un nombre de carpeta en Hugging Face no basta para inferir la estructura de directorios local. Los manifiestos oficiales verifican el tamaño de archivo y SHA256 antes de instalar un recurso.
El lanzamiento espera una sola sesión activa y un modelo de escena por proceso de servidor. Su README lo denomina una demostración confiable para un solo usuario, con valores predeterminados de bucle local, en lugar de un servicio público de juegos en la nube autenticado. No exponga directamente a internet sus servicios HTTP, RTSP y WebRTC.
El código fuente de v4 tiene licencia Apache-2.0. La tarjeta del modelo también identifica los pesos de escena del proyecto, las imágenes sink y los recursos del juego como Apache-2.0, mientras que los recursos compartidos y el material de terceros conservan sus propios términos. TAEHV incluye un aviso MIT, y el audio de carreras incluye requisitos de atribución para algunos recursos.
Se trata de una cantidad considerable de material descargable, pero no es un lanzamiento completo de entrenamiento. Mantenga las licencias aplicables y los créditos de audio al redistribuir trabajos basados en el proyecto.
Los modelos están especializados para las escenas y perfiles de cámara suministrados. La tarjeta del modelo enumera desviaciones de apariencia y errores geométricos con geometría no vista, movimiento rápido, oclusión y sesiones largas, y evita explícitamente garantizar la frecuencia de fotogramas, el ajuste en memoria o la reconstrucción exacta de escenas.
Por tanto, Matrix-Game 4.0 es una plataforma concreta para probar el renderizado neuronal basado en motor. No debe describirse como un generador universal de juegos, un servicio multijugador probado o un sistema que elimina la necesidad del desarrollo convencional de videojuegos.
El lanzamiento oficial incluye una ruta de inferencia optimizada para RTX 5090 e informa de demostraciones con una sola GPU. El rendimiento y el ajuste en memoria dependen de la configuración documentada, y la tarjeta del modelo no los garantiza para todas las cargas de trabajo.
No. El motor de juego ejecutable controla la jugabilidad y el estado físico. La salida neuronal puede contener errores visuales sin cambiar directamente los cálculos de colisiones o reglas del motor.
La tarjeta del modelo indica explícitamente que no. Incluye puntos de control de escena y recursos utilizados con la inferencia publicada y el código fuente del juego, lo cual tiene un alcance diferente de reproducir el entrenamiento del modelo.
--fps 40 garantiza 40 fotogramas mostrados por segundo?No. El README lo define como una cadencia objetivo de captura. La codificación, el transporte, el almacenamiento en búfer, la decodificación del navegador y la inferencia pueden afectar a la presentación final y a la latencia.
El diagrama conceptual del proyecto incluye ese mecanismo, pero el contrato de tiempo de ejecución actual indica que la configuración del shooter publicada no utiliza memoria recuperada. El modo de subtítulos dinámicos de carreras también es independiente de la ruta de indicación fija del shooter.
El lanzamiento documenta una sesión activa por proceso de servidor y describe una demostración confiable para un solo usuario. Sus servicios no deben exponerse directamente a internet como si ya proporcionaran autenticación y protecciones de servicio público.
Matrix-Game 4.0 utiliza un motor ejecutable para mantener el juego mientras un modelo de vídeo causal renderiza su apariencia. El lanzamiento con una sola GPU ofrece una forma práctica de examinar esa división, con escenas descargables, código de inferencia y recursos.
Sus demostraciones son prometedoras, pero la configuración publicada, la especialización por escena y las métricas de rendimiento independientes importan tanto como los FPS del titular.
Empieza con una sola frase y obtén un sitio completo en minutos.
