For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/meta-muse-wonder-and-full-benchmarks-memo-741b367d.md.
Meta presentó **Muse Wonder** y **Muse Wonder Full** el 12 de octubre de 2026. El lanzamiento está dirigido a agentes personales y profesion...
Meta presentó Muse Wonder y Muse Wonder Full el 12 de octubre de 2026. El lanzamiento está dirigido a agentes personales y profesionales: sistemas que se espera que recuerden contexto útil, superen obstáculos y completen proyectos que requieren más de una respuesta.
El anuncio oficial confirma que Wonder está disponible a través de la API de modelos de Meta y Muse Code, mientras que Full está disponible para suscriptores de Muse Code. Meta también planea incorporar Wonder a su asistente Muse, comenzando por los suscriptores.
La tarjeta del modelo enumera un contexto de inferencia de un millón de tokens y entradas que abarcan texto, imágenes, vídeo y audio. La modalidad de salida indicada es texto. Por tanto, la comprensión multimodal no debe confundirse con la promesa de que el propio modelo genere todos los medios de entrada.
Meta afirma que los modelos se entrenaron en su centro de datos Prometheus a escala de gigavatios, tras una reconstrucción más amplia de su infraestructura de IA. La infraestructura de entrenamiento explica el contexto del lanzamiento; no demuestra que todas las aplicaciones vayan a rendir tan bien como una demostración de benchmark.
El informe proporcionado describe que Wonder Full obtuvo 56 en el Artificial Analysis Intelligence Index, frente a 52 de Wonder y 48 de Muse Spark 1.3. La evaluación propia de Artificial Analysis corrobora estas cifras con el máximo nivel de esfuerzo de razonamiento. Se refieren a la instantánea de evaluación comunicada, y no a una clasificación permanente.
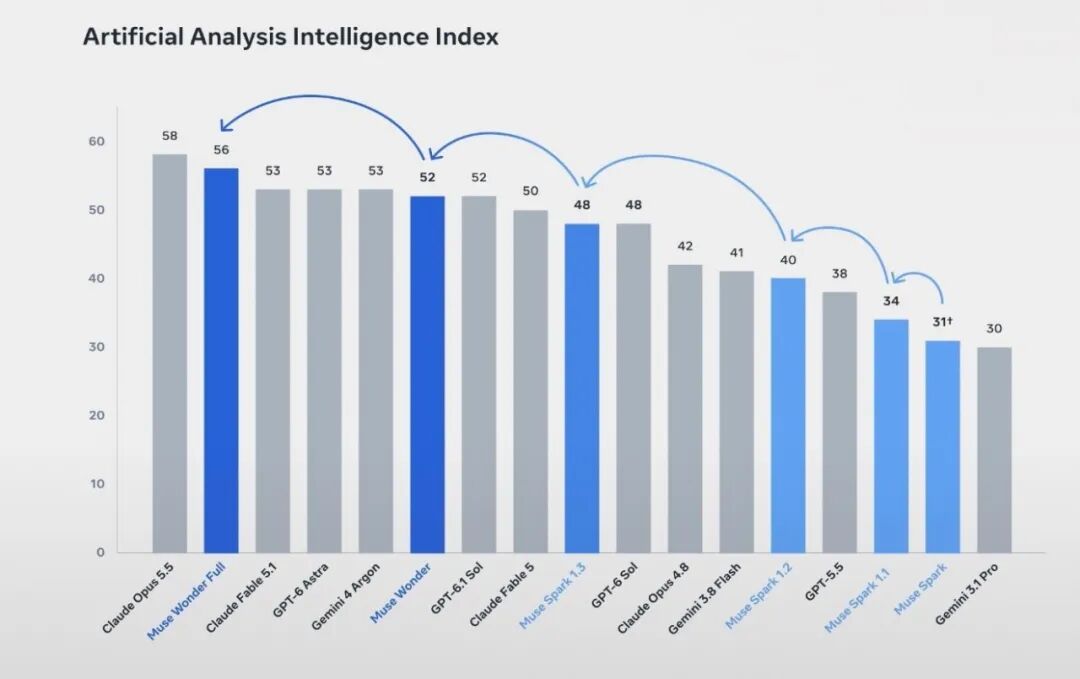
Gráfico reproducido en el informe de Xinzhiyuan en BAAI; la evaluación se atribuye allí a Artificial Analysis.
Para el trabajo de software sostenido, la fuente informa de lo siguiente:
| Evaluación | Wonder Full | Wonder | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| SWE-Marathon | 57,5 % | 53,1 % | 46,3 % | 42,5 % |
| DeepSWE v1.1 | 79,0 % | 78,8 % | 74,2 % | 74,1 % |
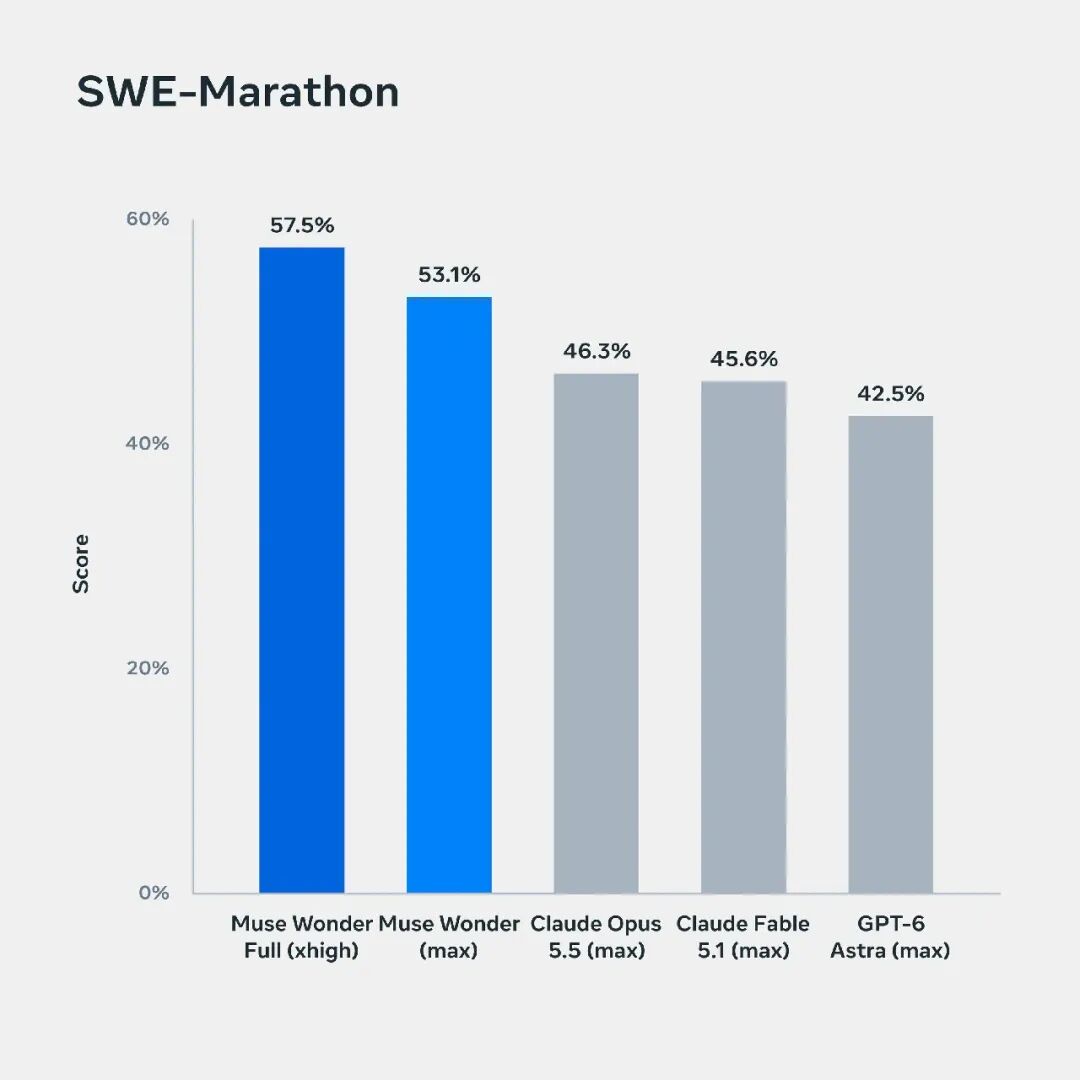
Gráfico de benchmark de Meta, reproducido por la fuente.
La tarjeta del modelo aporta una salvedad útil: SWE-Marathon no es una comparación controlada que use un arnés común. Algunos resultados de competidores utilizan Codex o Claude Code, y el resultado comunicado de Wonder Full utiliza un esfuerzo de razonamiento xhigh. DeepSWE también combina resultados especificados de terceros y resultados comunicados por proveedores, por lo que los lectores deberían consultar la metodología de cada benchmark.
La visión general es heterogénea, en lugar de una victoria completa. El artículo informa de que Full supera a GPT-6 Astra en ProgramBench, pero queda por detrás de Opus 5.5 y por detrás de ambos en la comparación de programación en terminal indicada. La selección del modelo sigue dependiendo del trabajo real, el entorno de herramientas, el presupuesto y la tasa de fallos aceptable.
Meta utiliza Active Memory para conservar contexto importante entre conversaciones y recuperar detalles relevantes cuando se necesitan. Utiliza Active Focus para el trabajo sostenido: probar otro enfoque, adaptarse a información nueva y continuar ante bloqueos.
Estas capacidades resuelven problemas diferentes. Recordar un requisito no garantiza por sí solo que un agente pueda terminar una implementación difícil; la persistencia no sirve de ayuda si el agente ha perdido una restricción crucial.
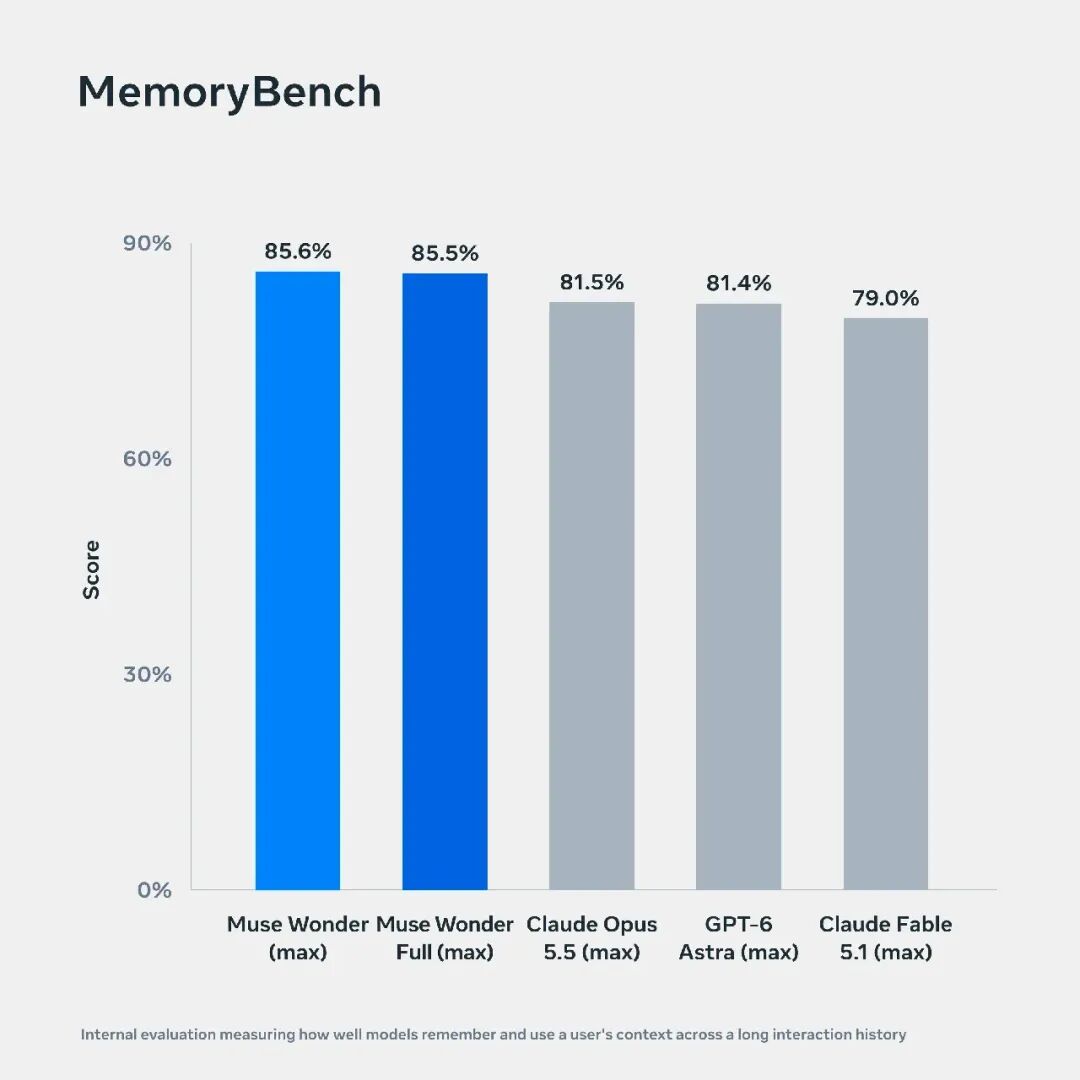
Gráfico de evaluación de Meta, reproducido a través del informe fuente.
La tarjeta del modelo describe MemoryBench como una evaluación interna que utiliza conversaciones de entre 64.000 y 100.000 tokens, incluida información distractora o contradictoria. FocusBench también es una evaluación interna. Son descripciones útiles de lo que se probó, pero no garantizan una recuperación impecable ni una autonomía ininterrumpida en un servicio desplegado.
Meta evalúa los modelos en tareas relacionadas con derecho, finanzas, salud y documentos profesionales, además de programación. Estas pruebas se refieren a productos de trabajo y reglas de calificación específicos; una puntuación no debe considerarse una cualificación profesional.
El informe chino también destaca una distinción entre responder de forma selectiva y saber más. Informa de una medida de alucinación menor para Full junto con un índice de conocimiento menor que el de los modelos comparados Opus y Astra. En ese análisis, el porcentaje de alucinación está condicionado a elementos de pruebas de conocimiento respondidos de forma incorrecta o sin responder; no es el porcentaje de todas las respuestas del mundo real que son falsas.
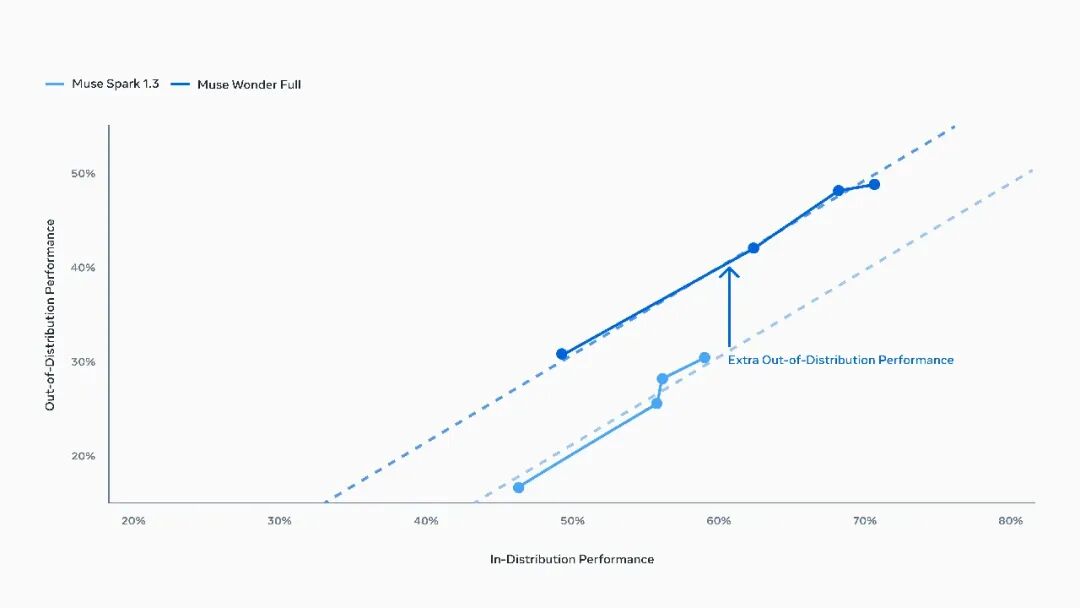
Para tareas desconocidas, Meta presenta evidencia de que Full generaliza mejor que el modelo Spark anterior con un rendimiento comparable dentro de la distribución. La conclusión se refiere a la configuración de evaluación medida, no es una prueba de mejora autónoma sin restricciones.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Gráfico de generalización de Meta, reproducido en la fuente.
La fuente enumera los siguientes precios en el momento de su informe:
| Producto | Precio comunicado | Acceso comunicado |
|---|---|---|
| Entrada de la API de Wonder | 4 USD por millón de tokens | API basada en uso |
| Salida de la API de Wonder | 20 USD por millón de tokens | API basada en uso |
| Entrada en caché de Wonder | 0,20 USD por millón de tokens | Entrada en caché |
| Full: Power Usage | 50 USD al mes | Suscripción a Muse Code |
| Full: Maximum Usage | 200 USD al mes | Suscripción a Muse Code |
El informe describe que las dos suscripciones Full ofrecen 20 y 80 veces el uso básico, respectivamente. Estos multiplicadores no equivalen a un uso ilimitado, y la fuente no establece una cantidad universal de tareas al mes.
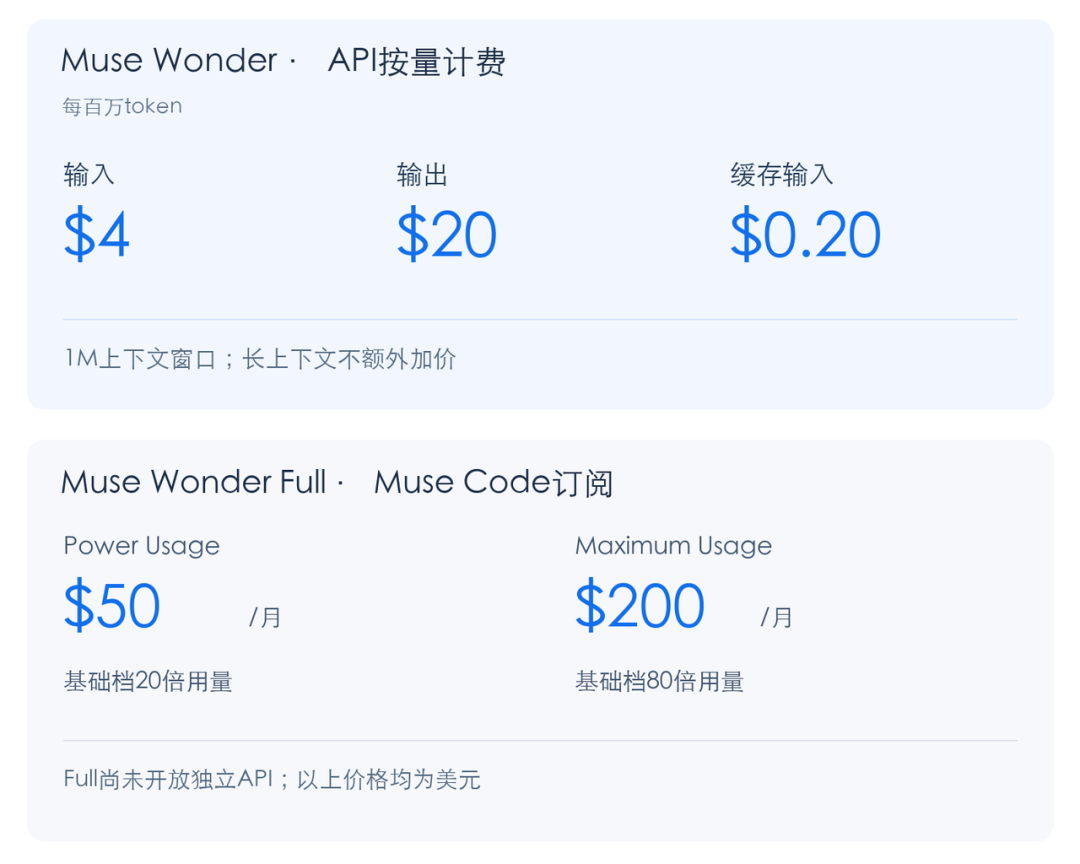
Gráfico de precios acreditado al informe fuente; las condiciones de facturación actuales no estaban accesibles de forma independiente.
En el momento del anuncio, Full se ofrecía a través de suscripciones a Muse Code en lugar de mediante una API pública independiente anunciada. Los equipos que consideren cualquiera de los dos productos deberían comprobar el acceso y los precios actuales de su cuenta antes de comprometerlos a una carga de trabajo.
Muse Wonder es un modelo de Meta lanzado el 12 de octubre de 2026 para tareas de agentes personales y profesionales. Meta describe fortalezas en memoria, ejecución sostenida de tareas, programación y trabajo específico de dominio.
Full es la variante de mayor rendimiento en muchas de las evaluaciones comunicadas. El anuncio oficial ofrece Wonder a través de la API y Muse Code, mientras que Full está disponible para suscriptores de Muse Code.
La tarjeta del modelo de Meta indica un millón de tokens en inferencia. La capacidad de contexto es distinta de la recuperación fiable, los límites de salida y la cantidad de material utilizable que puede proporcionar una aplicación concreta.
La tarjeta del modelo enumera entradas de texto, imagen, vídeo y audio. Indica salida de texto, por lo que la compatibilidad con entradas multimodales no debe interpretarse como generación nativa de audio o vídeo.
No; las puntuaciones comunicadas se aplican a tareas, configuraciones de agente y ajustes de razonamiento concretos. Meta señala expresamente que los resultados de SWE-Marathon no utilizan un arnés común controlado para todos los sistemas comparados.
Active Memory se ocupa de conservar y recuperar contexto relevante entre conversaciones. Active Focus se ocupa de persistir ante obstáculos y adaptarse durante una tarea, con aclaración o confirmación cuando corresponda.
El anuncio del 12 de octubre describe Full como disponible para suscriptores de Muse Code. No anuncia una API pública independiente para Full, y la disponibilidad debería comprobarse en avisos oficiales posteriores.
Muse Wonder y Full amplían la oferta de agentes de Meta con un contexto de un millón de tokens, entradas multimodales, memoria y capacidades de programación sostenida. El anuncio confirma rutas de acceso diferenciadas mediante API y suscripción, mientras que la fuente informa de mejoras sustanciales respecto a Muse Spark 1.3.
La comparación más útil combina las puntuaciones de los benchmarks con sus arneses, el acceso de la cuenta y el coste de completar las tareas propias.
Empieza con una sola frase y obtén un sitio completo en minutos.



