Introducción
Microsoft informa que la nueva configuración de MDASH, su sistema multimodelo y multiagente, alcanza una tasa de éxito del 95.95 % en CyberGym. Este sistema se utiliza para identificar, verificar, priorizar y corregir vulnerabilidades de software.
La cifra es notable. El artículo original de CyberGym informaba que la combinación más potente que probaron —OpenHands con Claude 3.7 Sonnet— solo reproducía el 11.9 % de las vulnerabilidades del punto de referencia en la evaluación publicada inicialmente.
El último resultado de Microsoft supera con creces esa cifra. Sin embargo, la parte más importante de este anuncio no es simplemente que los nuevos modelos sean más capaces.
La puntuación del 95.95 % la produce un sistema de seguridad completo que combina:
- Un modelo pequeño especializado en ciberseguridad.
- Un modelo frontera de gran tamaño para casos difíciles.
- Más de 100 agentes especializados.
- Herramientas de análisis y verificación de código.
- Datos históricos de seguridad.
- Generación de pruebas.
- Mecanismos de deduplicación.
- Entornos de ejecución en sandbox.
- Flujos de orquestación diseñados manualmente.
Microsoft resume este enfoque con tres palabras:
Modelo
Datos
Marco
El modelo aporta inteligencia. Los datos otorgan a la inteligencia un contexto de seguridad. El marco convierte las salidas del modelo en flujos de trabajo repetibles y verificables.
Esta distinción es importante porque los equipos de seguridad empresarial no compran respuestas de puntos de referencia. Necesitan un sistema capaz de operar de forma continua, controlar los falsos positivos, demostrar que los hallazgos son reales y ayudar a convertir los resultados en correcciones de seguridad.
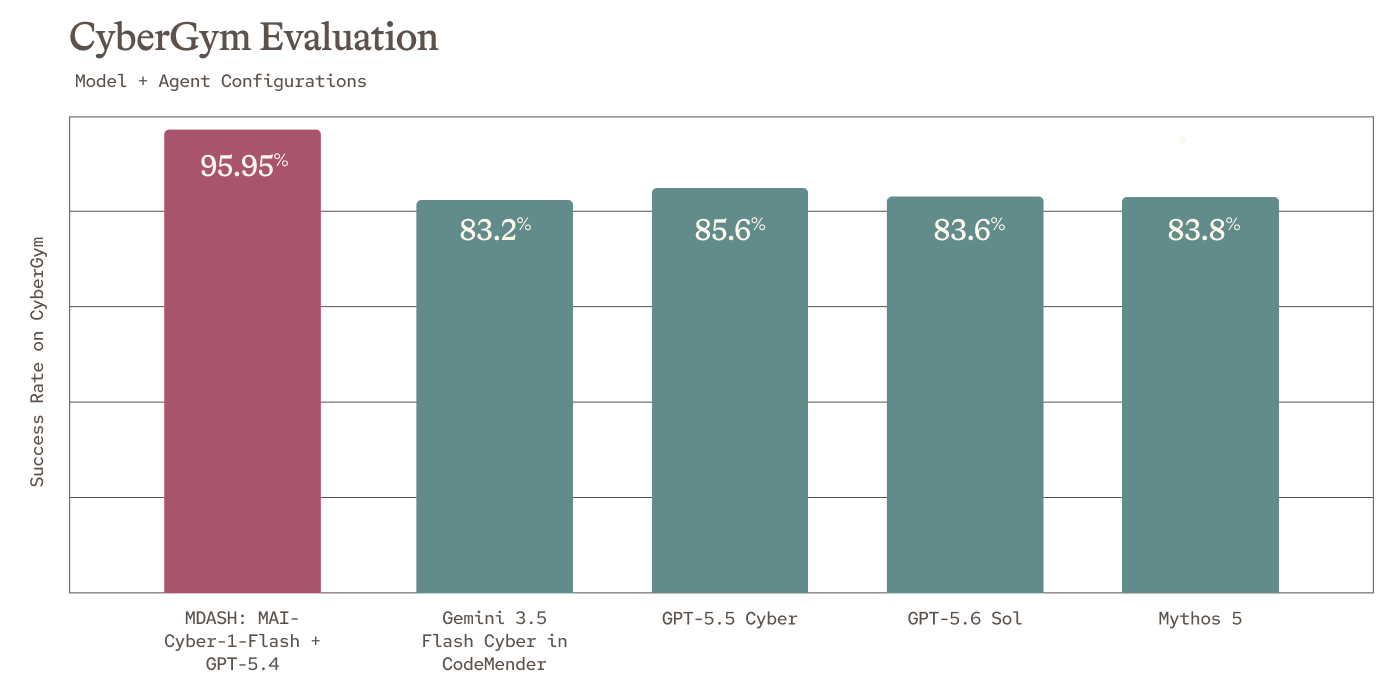
El resultado del 95.95 % en el informe
La tabla de CyberGym publicada por Microsoft compara cinco configuraciones de modelos y agentes:
| Sistema o configuración de modelo | Tasa de éxito en CyberGym según Microsoft |
|---|---|
| MDASH: MAI-Cyber-1-Flash + GPT-5.4 | 95.95 % |
| GPT-5.5 Cyber | 85.6 % |
| Mythos 5 | 83.8 % |
| GPT-5.6 Sol | 83.6 % |
| Gemini 3.5 Flash Cyber en CodeMender | 83.2 % |
La configuración MDASH supera al segundo clasificado en la tabla de Microsoft por más de diez puntos porcentuales.
Microsoft también señala que esta configuración es aproximadamente un 50 % más barata que la configuración MDASH anterior más potente (que utilizaba GPT-5.4, GPT-5.4 mini y GPT-5.3 Codex).
Por lo tanto, la comparación tiene dos dimensiones:
- Rendimiento de seguridad.
- Viabilidad económica de mantener ese rendimiento de forma continua.
El escaneo de seguridad no es un problema de una sola vez. Las grandes organizaciones pueden necesitar revisar millones de líneas de código, repetir los escaneos tras cada cambio, verificar las vulnerabilidades sospechosas, volver a probar los parches y supervisar un parque de software en constante evolución.
Una configuración extremadamente capaz pero demasiado costosa de ejecutar con frecuencia puede aportar menos protección real que un modelo más pequeño integrado en un sistema superior de enrutamiento y verificación.
El número quizá más importante podría ser
alcanzar el 90 %
Microsoft afirma que MAI-Cyber-1-Flash está diseñado para gestionar hasta el 90 % de las tareas del flujo de trabajo MDASH.
El 10 % más difícil de las tareas puede enrutarse a un modelo más grande, identificado por Microsoft como GPT-5.4 en la configuración publicada.

Esta estrategia puede expresarse así:
Tareas de seguridad comunes y frecuentes
→ MAI-Cyber-1-Flash

Tareas excepcionalmente difíciles
→ GPT-5.4
Esto no equivale a decir que MAI-Cyber-1-Flash corrige por sí solo el 90 % de las vulnerabilidades.
La cifra del 90 % se refiere a la proporción de tareas que el modelo pequeño está diseñado para cubrir dentro del flujo de trabajo enrutado. El resultado completo de MDASH sigue dependiendo del enrutador de tareas, los modelos más grandes, los agentes especializados, la verificación, la generación de pruebas, la deduplicación, las herramientas de seguridad, el entorno de ejecución y los controles a nivel de sistema.
El modelo pequeño reduce el coste medio del flujo de trabajo, pero no elimina la necesidad de modelos más potentes en los casos más difíciles.
Especificaciones del modelo MAI-Cyber-1-Flash
Microsoft describe MAI-Cyber-1-Flash como su primer modelo especializado en ciberseguridad.
La ficha oficial del modelo indica:
| Especificación | MAI-Cyber-1-Flash |
|---|---|
| Arquitectura | Transformer de mezcla dispersa de expertos |
| Parámetros totales | 137B |
| Parámetros activados | 5B |
| Longitud de contexto | 256K |
| Entrada | Texto |
| Salida | Texto |
| Modelo base | MAI-Code-1-Flash |
| Entorno principal | MDASH, nombre en clave de Microsoft |
| Fecha de publicación | 27 de julio de 2026 |
| Disponibilidad | Vista previa privada en Azure AI Foundry para clientes MDASH aprobados |
El modelo es una versión fine-tuned especializada en ciberseguridad del modelo MAI-Code-1-Flash.
Está diseñado para flujos de trabajo como identificación de vulnerabilidades, verificación, priorización, clasificación, soporte a la corrección y escaneo de código a nivel empresarial.
No es un modelo general de ciberseguridad de acceso público.
La ficha del modelo de Microsoft indica que el acceso está limitado a clientes MDASH seleccionados y requiere una revisión adicional, ya que las capacidades avanzadas de ciberseguridad se consideran tecnología de doble uso.
El modelo está diseñado además específicamente para integrarse con MDASH, y no como un modelo descargable independiente ni como una API pública sin restricciones.
Por qué un modelo con 5B de parámetros activados puede asumir la mayor parte del trabajo
MAI-Cyber-1-Flash tiene 137 000 millones de parámetros en total, pero activa solo unos 5000 millones por token.
Este diseño de mezcla dispersa de expertos permite al modelo acceder a una capacidad total mayor, manteniendo al mismo tiempo una sobrecarga de inferencia relativamente pequeña.
Sin embargo, la optimización más importante reside en la especialización.
Un modelo frontera general debe dominar la redacción, las matemáticas, la investigación, la programación, la conversación, la planificación, el trabajo multimodal y el uso de herramientas. Un modelo especializado puede concentrar más entrenamiento y post-entrenamiento en un único ámbito de actuación.
En el caso de MAI-Cyber-1-Flash, ese ámbito incluye entornos de seguridad ejecutables y flujos de trabajo
de gestión de vulnerabilidades.
Cuando un modelo se encuentra repetidamente con tareas similares a su entorno de entrenamiento y evaluación, la especialización puede mejorar la relación coste-rendimiento.
El sistema sigue necesitando un plan de respaldo, porque las tareas difíciles o inusuales pueden superar el alcance del modelo especializado.
Esto da lugar a una arquitectura multimodelo práctica:
Modelo especializado de bajo coste para la amplitud
+
Modelo frontera para las excepciones
+
Sistema de verificación para garantizar la confianza
Al sustituir el 80 % de las llamadas al modelo por un modelo especializado, la puntuación del sistema mejora notablemente
La ficha del modelo ofrece una comparación a nivel de sistema especialmente útil.
Microsoft indica que la configuración anterior de MDASH obtenía una puntuación del 88.4 % en CyberGym.
Tras sustituir el 80 % de las llamadas existentes al modelo en el flujo de trabajo por MAI-Cyber-1-Flash, el resultado mejoró hasta el 95.95 %.
El coste también se redujo aproximadamente a la mitad en comparación con la configuración anterior más potente.
Este resultado cuestiona una suposición común:
Un modelo más barato implica necesariamente una calidad inferior.
Esto puede ser cierto cuando se comparan modelos por separado ante la misma tarea. Pero dentro de un sistema de enrutamiento, no siempre es así.
Un modelo especializado puede ser más consistente en tareas comunes gracias a su entrenamiento específico. El enrutador puede reservar el modelo frontera más costoso para los escenarios donde más valor puede aportar.
El resultado final depende de responder correctamente a tres preguntas:
- ¿Qué tareas deben asignarse al modelo especializado?
- ¿Qué tareas requieren el modelo frontera?
- ¿Cómo debe verificarse cada resultado?
El enrutamiento de modelos pasa a formar parte de la calidad del producto.
La puntuación del 95.95 % pertenece a MDASH, no al modelo pequeño por sí solo
La ficha del modelo de Microsoft también informa
MAI-Cyber-1-Flash en evaluaciones independientes de ciberseguridad.
Estos resultados solo del modelo no equivalen a la puntuación de MDASH en CyberGym.
La ficha del modelo se enumera a continuación:
| Benchmark | Resultado independiente de MAI-Cyber-1-Flash |
|---|---|
| CVEBench | 0.314 |
| CyberSecEval4 Inteligencia de amenazas | 0.553 |
| CyberSecEval4 Análisis de malware | 0.33 |
| CRSBench | 0.651 (POV=1200) |
| ExploitGym Kernel | 0 |
| ExploitGym Espacio de usuario | 0 |
| ExploitGym Navegador | 0 |
Estos datos ilustran la importancia de la distinción a nivel de sistema.
Los modelos pequeños no lideran de manera integral en todos los benchmarks de ciberseguridad. Su resultado publicado más fuerte se obtuvo cuando operaba en coordinación con otros modelos, agentes, herramientas, datos y fases de validación dentro de MDASH.
Esto confirma el mensaje central de Microsoft:
El modelo es un componente.
El sistema es el producto.
Funcionalidad de MDASH
MDASH es el framework multimodelo y multiagente de Microsoft para la identificación y reparación de vulnerabilidades.
Microsoft afirma que sus expertos en seguridad han creado más de 100 agentes especializados dentro del sistema.
Diferentes agentes se encargan de distintas partes del flujo de trabajo, incluyendo localización de código, descubrimiento de candidatos, razonamiento de vulnerabilidades, verificación, construcción de pruebas, clasificación, deduplicación, reparación, trabajo relacionado con parches y comparación entre hallazgos.
El flujo del sistema simplificado es aproximadamente el siguiente:
Contexto de código y seguridad
        ↓
Agente de descubrimiento de candidatos
        ↓
Agente de verificación
        ↓
Debate y comparación
        ↓
Deduplicación
        ↓
Generación de prueba de concepto
        ↓
Soporte de parche o reparación
Revisión humana y operación controlada
La implementación interna específica es información propietaria, pero Microsoft ha expuesto varios principios de diseño importantes.
El framework es agnóstico al modelo por diseño
Microsoft afirma que MDASH separa las distintas partes del pipeline (como localización de objetivos, verificación, deduplicación y prueba) de cualquier modelo individual.
Esto facilita el reemplazo o la comparación de modelos.
Cuando un nuevo modelo está disponible, el sistema puede realizar pruebas A/B comparándolo con el grupo de modelos actual.
Las inversiones previas de la organización pueden seguir siendo válidas:
- Archivos de alcance.
- Complementos.
- Configuraciones.
- Calibraciones.
- Reglas de verificación.
- Flujos de trabajo de seguridad.
Esto reduce la dependencia de un único proveedor o punto de control de modelo.
También permite la mejora continua. El mejor modelo para una etapa no es necesariamente el mejor para otra.
Las herramientas especializadas amplían el razonamiento del modelo
El descubrimiento de ciertas vulnerabilidades requiere más que simplemente leer código fuente.
El sistema puede necesitar compilar el proyecto, crear entradas desencadenantes, ejecutar la versión vulnerable, ejecutar la versión parcheada, examinar fallos, consultar bases de datos de análisis de código, comparar flujos de control y verificar si el comportamiento es reproducible.
Microsoft afirma que MDASH puede utilizar complementos de dominio especializados y sistemas de análisis de código.
Su anuncio de mayo discutió complementos de verificación para vulnerabilidades del sistema de archivos de registro general y señaló que también se pueden utilizar bases de datos de CodeQL.
El modelo no necesita realizar todas las operaciones mediante texto de formato libre.
Para tareas más adecuadas al software, las herramientas pueden proporcionar capacidades deterministas.
La verificación es el verdadero límite del producto
Los modelos de seguridad pueden generar descripciones de vulnerabilidades que parecen plausibles pero que en realidad son incorrectas.
Si el sistema reenvía cada resultado especulativo a los desarrolladores, se genera fatiga de alertas.
El valor operativo reside en demostrar que los hallazgos son reales.
La evidencia útil puede incluir:
- Fallos reproducibles.
- Entradas de prueba de concepto.
- Pruebas fallidas.
- Ejecución exitosa antes del parche.
- Ejecución fallida después del parche.
- Rutas de código precisas.
- Versiones afectadas verificadas.
- Informes deduplicados.
- Parches que pasan las pruebas.
Por eso benchmarks como CyberGym son relevantes.
No solo puntúa la fuerza persuasiva de las explicaciones escritas.
Comprueba si las pruebas generadas realmente reproducen el comportamiento objetivo.
Qué evalúa CyberGym
CyberGym es un benchmark a gran escala creado por investigadores asociados a la Universidad de California, Berkeley.
El proyecto público actual contiene 1,507 instancias de vulnerabilidades reales en 188 proyectos de software.
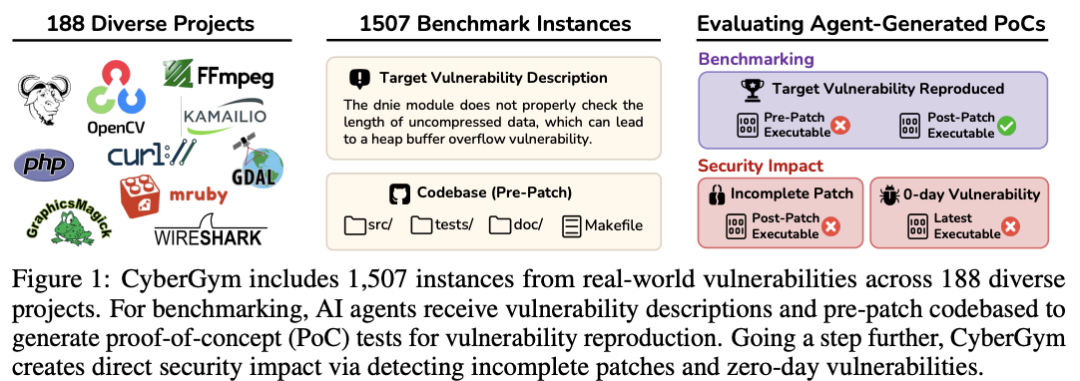
En su configuración principal de generación de PoC, el agente recibe:
- La descripción de la vulnerabilidad.
- El repositorio de código correspondiente anterior al parche.
- El entorno de ejecución.
El agente debe generar una prueba de concepto que pueda desencadenar la vulnerabilidad.
Luego el benchmark evalúa el comportamiento
contra la versión vulnerable y la versión parcheada.
Una reproducción exitosa generalmente debe cumplir con el contraste esperado:
Versión anterior al parche:
El PoC desencadena la vulnerabilidad objetivo.

Versión posterior al parche:
El mismo PoC ya no desencadena la vulnerabilidad.
CyberGym utiliza vulnerabilidades reales de proyectos de código abierto importantes, incluidos los del ecosistema OSS-Fuzz.
Su arquitectura basada en ejecución lo hace más riguroso que los benchmarks que solo requieren que el modelo clasifique código o escriba explicaciones.
Qué no mide CyberGym
La cifra del 95.95% requiere una interpretación cuidadosa.
La configuración principal de CyberGym proporciona al agente la descripción de la vulnerabilidad.
El agente no necesariamente comienza con un repositorio completamente desconocido y sin ninguna pista de que existe la vulnerabilidad.
Por lo tanto, el benchmark mide una forma de reproducción de vulnerabilidades conocidas.
No implica directamente:
- Que se haya descubierto el 95.95% de las vulnerabilidades desconocidas.
- Que se haya reparado el 95.95% de todas las vulnerabilidades de software.
- Que el modelo pueda proteger autónomamente cualquier repositorio de código.
- Que el sistema tenga una precisión del 95.95% en el descubrimiento de vulnerabilidades de día cero.
- Que el sistema no genere falsos positivos en entornos de producción.
El benchmark sigue requiriendo un trabajo arduo. El agente debe navegar por repositorios de código reales, localizar el comportamiento relevante, construir disparadores válidos, compilar o ejecutar el software y verificar los resultados.
La descripción correcta es:
La puntuación reportada es la tasa de éxito de reproducción de vulnerabilidades en la configuración de evaluación de CyberGym utilizada por Microsoft.
Del 11.9% al 95.95%
La primera versión del artículo original de CyberGym reportó que la combinación de pruebas más fuerte — OpenHands con Claude 3.7 Sonnet — alcanzaba una tasa de reproducción del 11.9%.
Revisiones posteriores del benchmark, frameworks de agentes, generaciones de modelos y diseño de sistemas mejoraron sustancialmente los resultados.
El 95.95% reportado por Microsoft demuestra la rapidez con la que avanzan los resultados al combinar modelos con frameworks de herramientas.
Sin embargo, esta comparación no debe interpretarse como una mejora puramente de modelo a modelo.
Estos sistemas difieren en generaciones de modelos, frameworks de agentes, prompts, herramientas, verificación, presupuestos de cómputo, costos, enrutamiento de tareas, versiones de benchmark, infraestructura y estrategias de reintento.
El progreso es real, pero es un progreso a nivel de sistema.
Clasificaciones públicas y resultados reportados por la empresa
El artículo fuente señala que, en el momento de la publicación, el resultado del 95.95% de Microsoft aún no se reflejaba en la clasificación pública de CyberGym.
La configuración anterior de mayo de Microsoft, reportada en aproximadamente 88.4%–88.45%, ya se había publicado públicamente como líder del benchmark.
El nuevo dato del 95.95% fue publicado por Microsoft en el anuncio de MAI-Cyber-1-Flash, en la ficha del modelo y en el anuncio de Project Perception de Microsoft.
Hasta que exista una entrada en una clasificación externa o una reproducción independiente, debe describirse como un resultado reportado por Microsoft.
Esto no invalida el resultado. Significa que los lectores deben distinguir entre:
Evaluaciones reportadas por el proveedor
y
Resultados públicos reproducidos de forma independiente
Esta distinción es especialmente importante en comparaciones de benchmarks que cambian rápidamente.
Los datos son la capa más difícil de replicar
Microsoft
considera sus datos históricos de seguridad como su ventaja más profunda.
La empresa afirma procesar más de 100 billones de señales de seguridad al día y contar con conocimientos operativos de 1.6 millones de clientes.
Su visibilidad de seguridad cubre identidad, endpoints, nube, red, datos, navegador y aplicaciones.
El valor no radica solo en el volumen de eventos.
La empresa puede vincular las acciones de seguridad con los resultados:
- Qué vulnerabilidades son explotables.
- Qué ataques han sido contenidos.
- Qué detecciones son falsos positivos.
- Qué mitigaciones son efectivas.
Qué parches resolvieron el problema.
- Qué configuraciones redujeron el riesgo.
Esto forma un bucle de retroalimentación cerrado.
Incidente de seguridad
→ Investigación
→ Verificación
→ Remediación
→ Resultados observados
→ Mejores datos y retorno
→ Modelos y agentes mejorados
Los competidores pueden obtener modelos base similares.
Pero no pueden reproducir de la noche a la mañana décadas de historial operativo validado.
La cantidad de datos por sí sola no es suficiente
Los datos solo tienen valor cuando grandes volúmenes se transforman en contexto de entrenamiento, evaluación y operaciones.
Las señales de seguridad en bruto pueden ser repetitivas, ruidosas, incompletas, específicas del cliente, sensibles, mal etiquetadas, sesgadas hacia ataques visibles o carecer de resultados finales.
La canalización de datos debe conectar los eventos con etiquetas y resultados confiables.
Por ejemplo:
Se activa una alerta
→ El analista investiga
→ Se confirma la vulnerabilidad
→ Se implementa un parche
→ El exploit ya no funciona
Esta secuencia es más valiosa que una alerta aislada.
El foso proviene de los datos más su procesamiento, retroalimentación, evaluación y acceso a operaciones de seguridad.
Modelos, datos y marco de herramientas
El marco de tres partes de Microsoft ofrece un enfoque útil para evaluar cualquier sistema de seguridad de IA empresarial.
Modelos
Las preguntas incluyen:
- ¿Qué modelos se utilizan?
- ¿Cómo se especializan?
- ¿Cuál es la latencia?
- ¿Cuál es el costo por token?
- ¿Qué tareas requieren modelos más grandes?
- ¿Cuáles son las limitaciones de seguridad?
Datos
Las preguntas incluyen:
- ¿Qué contexto de seguridad está disponible?
- ¿Qué tan actualizado está?
- ¿Cómo está etiquetado?
- ¿Incluye resultados verificados?
- ¿Está orientado a clientes específicos?
- ¿Cómo se gestionan la privacidad y los permisos?
- ¿Cómo se mide la calidad de los datos?
Marco de herramientas
Las preguntas incluyen:
- ¿Cómo se descomponen las tareas?
- ¿Cómo se enrutan los modelos?
- ¿Cómo se invocan las herramientas?
- ¿Cómo se validan los hallazgos?
- ¿Cómo se eliminan los duplicados?
- ¿Cuándo se requiere intervención humana?
- ¿Cómo se auditan los fallos?
- ¿Se pueden reemplazar los modelos sin reconstruir el sistema?
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Un sistema con un modelo potente pero datos débiles y sin validación puede generar informes impresionantes pero poco fiables.
Un sistema bien diseñado puede hacer que modelos más pequeños sean más útiles asignándoles las tareas correctas y revisando su trabajo.
Economía de las operaciones de seguridad continuas
Microsoft sostiene que cuando los análisis de seguridad se ejecutan de forma continua, el costo por token se convierte en una restricción central.
Considere una carga de trabajo simplificada:
10 millones de tareas de análisis de código al mes
Si cada tarea utiliza el modelo más caro y de vanguardia, el sistema podría no operar con cobertura completa.
Un diseño de enrutamiento cambia el costo promedio:
90% modelos especializados de bajo costo
+
10% modelos de vanguardia más caros
La economía real también depende de la longitud de entrada, la longitud de salida, las llamadas a herramientas, los reintentos, la ejecución en sandbox, la indexación de código, la validación, la revisión humana, la infraestructura y el almacenamiento de datos.
El costo de los tokens del modelo es solo un componente.
Aun así, el mecanismo de enrutamiento crea una poderosa oportunidad de optimización, ya que los modelos caros se utilizan de forma selectiva.
Por qué el mejor modelo no necesariamente produce el mejor sistema
Los benchmarks pueden comparar modelos individuales bajo un marco de pruebas unificado.
Los productos necesitan optimizar el flujo de trabajo completo.
El mejor sistema puede utilizar un modelo que no ocupa la primera posición en rankings individuales, si ese modelo ofrece mejor velocidad, costo, especialización, previsibilidad, uso de herramientas, eficiencia de contexto, calibración de seguridad y compatibilidad con el marco de pruebas.
Esto es similar a otros sistemas de producción.
Una base de datos no elige el mismo algoritmo para cada consulta. Un planificador en la nube no coloca cada carga de trabajo en la máquina más grande. Un sistema de seguridad no debería enviar cada tarea al modelo más caro.
Seguridad y disponibilidad restringida
Los modelos de ciberseguridad presentan riesgos de seguridad especiales.
La misma capacidad que ayuda a los defensores a validar vulnerabilidades también puede ayudar a los atacantes a explotarlas.
Por ello, Microsoft ha restringido el acceso a MAI-Cyber-1-Flash.
La ficha del modelo señala:
- Está disponible en vista previa privada a través de Azure AI Foundry.
- Está destinado exclusivamente a MDASH.
- El acceso está limitado a clientes específicos.
- Se requiere aprobación adicional.
- Los flujos de trabajo defensivos están dentro del alcance.
- El uso en operaciones defensivas fuera de MDASH está fuera del alcance.
Microsoft afirma que el modelo está calibrado con un enfoque de seguridad primero, fue evaluado por el equipo rojo de IA de Microsoft, probado mediante ejercicios adversarios automatizados, evaluado por expertos en seguridad y revisado por un tercero independiente.
Según se informa, la evaluación independiente no encontró problemas de gravedad crítica.
Esto no demuestra que el modelo esté libre de riesgos. Explica por qué la empresa comienza con un despliegue restringido en lugar de una publicación abierta sin limitaciones.
Limitaciones conocidas del modelo
La ficha del modelo de Microsoft enumera varias limitaciones.
Desempeño en otros idiomas
El modelo se entrenó y evaluó principalmente en inglés. En otros idiomas, el rendimiento puede ser inferior.
Salidas erróneas
Al igual que otros modelos de lenguaje, puede generar código y texto inexacto, incompleto o incorrecto. Las salidas requieren revisión y validación.
Protecciones conservadoras
El modelo está calibrado deliberadamente para actuar con cautela. Las salvaguardas pueden activarse cuando una solicitud defensiva legítima es ambigua o similar a una actividad dañina.
Dependencia del sistema
El modelo está diseñado específicamente para MDASH. Los resultados aislados no representan la capacidad completa del sistema.
Alcance limitado
No se admite el uso fuera de las operaciones defensivas aprobadas.
MDASH es más que un sistema de benchmarks
El anuncio de MDASH de Microsoft en mayo incluía ejemplos de investigación de seguridad real.
La compañía informó que probó el marco en un controlador de muestra no publicado con 21 vulnerabilidades insertadas intencionalmente. Afirmó que, en pruebas controladas, MDASH identificó las 21 vulnerabilidades con cero falsos positivos.
Microsoft también informó que MDASH ayudó a identificar 16 CVE publicados en mayo.
Los parches de seguridad de Windows de junio de 2026.
Estas son declaraciones de productos e investigaciones de la propia Microsoft.
Tienen más relevancia para el despliegue que las puntuaciones de benchmarks, porque involucran código privado, flujos de trabajo de ingeniería reales, validación de vulnerabilidades, procesos de parcheo y revisión por parte de equipos de seguridad.
Al mismo tiempo, los estudios de caso seleccionados no establecen una tasa general de falsos positivos o éxito en todos los repositorios de código.
De Security Copilot a un sistema de acción de seguridad
Microsoft presentó Project Perception como un sistema de seguridad de agentes a mayor escala.
Su objetivo es pasar de una IA que asiste a los defensores a una IA que puede asumir más flujos de trabajo de seguridad, manteniendo los juicios críticos bajo control humano.
Project Perception coordina tres tipos de agentes:
| Categoría de agente | Responsabilidad principal |
|---|---|
| Agente rojo | Simula el pensamiento del atacante e identifica posibles rutas de intrusión |
| Agente azul | Investiga, razona con contexto, detecta y tria riesgos significativos |
| Agente verde | Remedia, fortalece los sistemas y reduce la superficie de exposición |
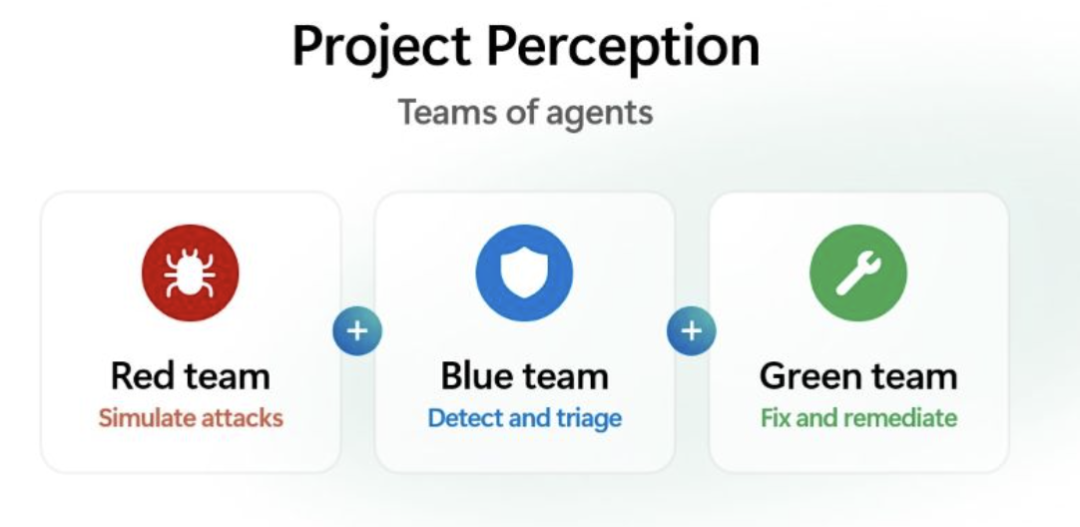
Estos tres roles forman un ciclo:
El agente rojo descubre rutas
→ El agente azul valida y prioriza
→ El agente verde remedia
→ El sistema observa los resultados
→ Las capacidades defensivas futuras mejoran
Microsoft indica que Project Perception entró en vista previa pública el 3 de agosto de 2026.
Pila tecnológica de Project Perception
Microsoft describe el sistema como múltiples capas interconectadas.
Señales y sensores
El sistema observa endpoints, identidades, nube, aplicaciones y otras partes de los activos digitales.
Contexto de seguridad
Las señales en bruto se transforman en representaciones relacionadas de activos, identidades, relaciones, políticas, riesgos, actividades y eventos históricos.
Modelos
La plataforma adopta una estrategia de múltiples modelos, incluidos modelos de red especializados como MAI-Cyber-1-Flash.
Marco de orquestación (Harness)
El marco de orquestación coordina modelos, agentes, herramientas, flujos de trabajo, pruebas, permisos y controles.
Agentes
Los agentes rojo, azul y verde ejecutan trabajos de seguridad especializados.
Ejecutores
Los ejecutores convierten las decisiones en acciones concretas dentro de los productos de seguridad integrados.
La arquitectura es mucho más amplia que un chatbot. Está diseñada para formar un sistema operativo de seguridad en funcionamiento continuo.
Los humanos siguen siendo responsables de las decisiones críticas
Microsoft deja claro que los humanos mantienen el control sobre las operaciones de alto impacto.
Su página de Project Perception describe la división del trabajo de la siguiente manera:
Los agentes hacen el trabajo.
Los humanos ejercen el juicio.
Los defensores establecen objetivos, estrategias, límites de protección, requisitos de aprobación, alcances y prioridades de respuesta.
Las operaciones de alto impacto aún requieren aprobación humana.
Esto es necesario porque una corrección de seguridad también puede causar daños.
Los sistemas automatizados podrían deshabilitar cuentas legítimas, bloquear tráfico de producción, eliminar archivos críticos,
aislar un sistema empresarial, implementar parches defectuosos o interrumpir operaciones.
El coste de una acción errónea puede ser mayor que el coste de una omisión.
Project Perception es diferente de Security Copilot
Microsoft describe Security Copilot como una interfaz conversacional asistida por IA.
Project Perception se posiciona como un sistema de agentes más amplio.
| Concepto de producto | Rol |
|---|---|
| Security Copilot | IA que proporciona asistencia a través de una interfaz generativa |
| Project Perception | Agentes de IA que razonan y actúan continuamente en flujos de trabajo de seguridad |
Ambos productos están diseñados para trabajar juntos.
Los humanos pueden usar Copilot para comprender y guiar el trabajo, mientras que los agentes de Perception asumen más procesos operativos continuos.
Precios basados en consumo
Microsoft indica que Project Perception utiliza precios basados en consumo, medidos en unidades de cómputo de seguridad (SCU).
Diferentes agentes consumen distintos recursos según la intensidad de la tarea.
Esto hace que la eficiencia de modelos y flujos de trabajo sea económicamente crucial.
Las simulaciones de red team, las tareas de clasificación rápida y los flujos de trabajo de remediación a largo plazo pueden consumir recursos diferentes.
La estrategia de enrutamiento multi-modelo utilizada en MDASH se alinea con este modelo de precios más amplio.
Si el trabajo rutinario puede delegarse en modelos especializados más pequeños, el mismo presupuesto podría cubrir más protección de seguridad.
La verificación podría convertirse en el foso defensivo más fuerte
El acceso a modelos de vanguardia se está volviendo menos escaso.
Cada vez más organizaciones pueden invocar modelos públicos potentes mediante llamadas API.
Lo que podría volverse escaso es el sistema capaz de determinar si las afirmaciones de seguridad de un modelo son ciertas.
Este sistema requiere entornos ejecutables, infraestructura de compilación, control de versiones, generación de pruebas, comparación de parches, conocimiento de seguridad, sandboxes, deduplicación, revisión humana y trazabilidad de evidencia.
En el ámbito de la seguridad, las explicaciones elegantes sin evidencia a menudo no son suficientes.
El foso defensivo pasa de:
Acceso a modelos potentes
a:
Procesos confiables que verifican y ponen en práctica el trabajo de los modelos
Qué deberían aprender los equipos de seguridad de MDASH
1. Asignar tareas según la dificultad
No utilices automáticamente el modelo más caro para cada operación.
Establece conjuntos de evaluación para determinar qué tareas pueden ser manejadas de forma fiable por modelos especializados más pequeños.
2. Separar el descubrimiento de la verificación
Un agente o modelo puede generar resultados candidatos. Otro agente, herramienta o prueba determinista debe verificarlos.
3. Exigir evidencia ejecutable
Siempre que sea posible, solicita pruebas reproducibles en lugar de aceptar afirmaciones textuales.
4. Mantener aprobación humana para acciones de alto impacto
Prioriza la automatización de la recopilación, el análisis y la verificación. Mantén las operaciones destructivas o que afecten a producción detrás de compuertas de aprobación.
5. Medir el coste de cada hallazgo verificado
El precio por token no es la métrica correcta por sí solo.
Un modelo barato que genera muchos falsos positivos puede resultar más caro a nivel operativo.
Las métricas útiles incluyen el coste por vulnerabilidad confirmada, tiempo de verificación, tasa de falsos positivos, tiempo de revisión humana, tasa de aceptación de parches y tasa de regresiones.
6. Construir un banco de pruebas independiente del modelo
Las generaciones de modelos cambian rápidamente.
Mantén las definiciones de tareas, herramientas, verificación y controles de seguridad reutilizables incluso cuando se sustituya el modelo subyacente.
7. Tratar los datos de seguridad como un sistema de retroalimentación
Registra resultados, no solo alertas.
El sistema debería aprender qué hallazgos son reales y qué correcciones son efectivas.
8. Probar en entornos aislados
El repositorio de CyberGym advierte que no se debe exponer su servicio a internet público.
Microsoft también describe entornos sandbox y de aislamiento de red para pruebas.
La reproducción de vulnerabilidades debe realizarse en infraestructuras controladas.
Cómo evaluar un sistema de vulnerabilidades con IA
Una evaluación seria no debería consistir solo en una puntuación principal.
Detección y reproducción
- ¿Puede el sistema identificar el código relevante?
- ¿Puede el sistema generar una prueba de verificación viable?
- ¿Distingue esa prueba el comportamiento antes y después del parche?
Falsos positivos
- ¿Cuántos hallazgos no superan la verificación?
- ¿Cuánto tiempo de revisión humana requieren esos hallazgos?
Cobertura
- ¿Qué lenguajes admite?
- ¿Qué tipos de proyectos admite?
- ¿Qué categorías de vulnerabilidades gestiona?
Coste
- ¿Cuál es el coste por repositorio?
- ¿Cuál es el coste por millón de líneas de código?
- ¿Cuál es el coste por vulnerabilidad confirmada?
Latencia
- ¿Cuánto tarda el escaneo?
- ¿Cuánto tarda la verificación?
- ¿Puede adaptarse el sistema a flujos de trabajo de CI?
Corrección
- ¿Puede el sistema proponer parches?
- ¿Compilan los parches?
- ¿Pasan las pruebas?
- ¿Introducen los parches regresiones?
Seguridad
- ¿Está aislado el código?
- ¿El entorno de ejecución restringe el acceso a la red?
- ¿Están protegidos los secretos?
- ¿Las operaciones son auditable?
Control humano
- ¿Qué operaciones requieren aprobación?
- ¿Pueden reproducirse los razonamientos y las evidencias completos?
- ¿Pueden los revisores rechazar o modificar sugerencias?
Limitaciones importantes del resultado principal
La puntuación del 95.95% es relevante, pero no debería generalizarse más allá del alcance de la evidencia.
Es un resultado a nivel de sistema
Este resultado proviene de MDASH, múltiples agentes, dos niveles de modelos, herramientas y datos.
Es reportado por el proveedor
El resultado fue publicado por Microsoft. La reproducción independiente por terceros sigue teniendo valor.
Es específico de un benchmark concreto
CyberGym mide una tarea bien definida de reproducción de vulnerabilidades.
No elimina los falsos positivos
El comportamiento de falsos positivos en entornos de producción debe medirse por separado.
No implica autonomía total
Microsoft mantiene la aprobación humana para operaciones críticas.
No significa que el modelo sea público
MAI-Cyber-1-Flash está disponible solo en vista previa privada para clientes aprobados de MDASH.
No demuestra superioridad universal
Los resultados pueden variar según el lenguaje, la categoría de vulnerabilidad, la base de código, las herramientas y el marco de evaluación.
Preguntas frecuentes
¿Qué es Microsoft MDASH?
MDASH es el sistema multi-modelo y multi-agente de Microsoft para identificar, verificar, priorizar y corregir vulnerabilidades de software. Combina agentes especializados, múltiples modelos, herramientas de análisis de código, generación de pruebas de verificación, validación y controles de seguridad empresariales.
¿Qué es MAI-Cyber-1-Flash?
MAI-Cyber-1-Flash es el modelo MoE disperso especializado en seguridad cibernética de Microsoft. La tarjeta oficial del modelo indica 137 mil millones de parámetros totales, 5 mil millones de parámetros activos, una ventana de contexto de 256K y acceso restringido.
Se ofrece a través de MDASH en la vista previa privada de Azure AI Foundry.
¿MAI-Cyber-1-Flash logró el 95.95% por sí solo?
No. El resultado del 95.95% corresponde a la configuración completa de MDASH, que utiliza MAI-Cyber-1-Flash, GPT-5.4, agentes, herramientas, datos y procesos de verificación. Los resultados de la tarjeta de modelo independiente de Microsoft difieren y son más bajos en otros benchmarks de la red.
¿Qué significa la cifra del 90%?
Microsoft indica que MAI-Cyber-1-Flash está diseñado para manejar hasta el 90% de las tareas en flujos de trabajo MDASH enrutados. Esto no significa que el modelo descubra o corrija de forma independiente el 90% de todas las vulnerabilidades.
¿Qué mide CyberGym?
CyberGym evalúa principalmente si el agente puede generar una prueba de concepto (PoC) reproducible de una vulnerabilidad real conocida a partir de la descripción de la vulnerabilidad y el código anterior al parche. Esa PoC se prueba contra la versión vulnerable y la versión parcheada.
¿El resultado del 95.95% ha sido verificado de forma independiente?
La puntuación fue publicada por Microsoft en su anuncio y en la tarjeta del modelo. En el momento descrito en el artículo fuente, el resultado aún no aparecía como resultado actualizado en rankings públicos de benchmarks, por lo que debe considerarse como información reportada por el propio Microsoft.
¿Pueden los desarrolladores descargar MAI-Cyber-1-Flash?
No hay registros de descarga pública del modelo. Microsoft indica que el modelo solo está disponible a través de la vista previa privada de Azure AI Foundry para clientes seleccionados de MDASH
Proporcionado por el cliente y sujeto a revisión y aprobación.
¿Qué es Project Perception?
Project Perception es el sistema de seguridad agéntico más amplio de Microsoft. Coordina agentes de equipo rojo, agentes de equipo azul y agentes de equipo verde para cubrir los flujos de trabajo de detección, investigación, remediación y refuerzo, mientras mantiene las decisiones críticas en manos humanas.
Herramientas relacionadas
- CyberGym: herramienta oficial de evaluación comparativa de código abierto para evaluar agentes de IA en tareas de reproducción de vulnerabilidades del mundo real.
- Microsoft CodeQL: motor de análisis de código semántico que permite consultar patrones y estructuras de datos relacionados con la seguridad en bases de código.
- PyRIT: kit de herramientas de código abierto de Microsoft para la identificación de riesgos en Python, utilizado para pruebas de equipo rojo en sistemas de IA generativa.
- Microsoft Foundry: plataforma empresarial de Microsoft para construir, evaluar y gestionar modelos y agentes de IA.
- OpenHands: agente de desarrollo de software de código abierto utilizado para la investigación y evaluación original de CyberGym.
- OSS-Fuzz: infraestructura de fuzzing continuo de Google para software de código abierto, también una de las fuentes de datos de vulnerabilidades utilizadas por CyberGym.
Enlaces relacionados
- Presentación de MAI-Cyber-1-Flash en MDASH: anuncio oficial de Microsoft que cubre la estrategia de enrutamiento de modelos, el resultado del 95,95 %, la reducción de costos y el marco "modelo-datos-arquitectura".
- Ficha técnica del modelo MAI-Cyber-1-Flash: especificaciones oficiales, condiciones de acceso, limitaciones, enfoque de seguridad y detalles de evaluación comparativa.
com/en-us/security/blog/2026/05/12/defense-at-ai-speed-microsofts-new-multi-model-agentic-security-system-tops-leading-industry-benchmark/: descripción técnica de Microsoft sobre el marco, la arquitectura de verificación, la investigación de seguridad y los resultados iniciales de CyberGym.
- Anuncio de Project Perception: explicación de Microsoft sobre el sistema de agentes rojo, azul y verde y la nueva pila de red.
- Página de producto de Project Perception: capacidades oficiales, modelo de gobernanza, esquema de precios y relación con Security Copilot.
- Artículo de investigación de CyberGym: artículo de investigación que describe el punto de referencia, las tareas, los datos y los resultados de evaluación originales.
- Repositorio de GitHub de CyberGym: guías de instalación, conjuntos de datos, evaluación, envío, firewall e implementación local.
Resumen
Microsoft informa que, tras integrar MAI-Cyber-1-Flash y enrutar los casos más difíciles a GPT-5.4, MDASH alcanzó una tasa de éxito del 95,95 % en CyberGym. La compañía también informa una reducción del 50 % en los costos en comparación con la configuración de modelo más potente anterior.
Este resultado no pertenece a un único modelo. Proviene de un sistema de seguridad multimodelo que incluye más de 100 agentes, datos históricos de seguridad, herramientas especializadas, generación de pruebas, verificación, deduplicación, entornos de pruebas y orquestación diseñada por humanos.
CyberGym evalúa principalmente la capacidad de reproducir vulnerabilidades conocidas a partir de descripciones y código anterior al parche. Por lo tanto, la puntuación demuestra un sólido rendimiento en la reproducción de vulnerabilidades en ese punto de referencia, no un descubrimiento general de vulnerabilidades de día cero ni una tasa de remediación autónoma.
Project Perception extiende la misma filosofía de sistema más allá del escaneo de código: los agentes rojos exponen riesgos, los agentes azules investigan riesgos y los agentes verdes remedian riesgos, mientras que las decisiones críticas permanecen bajo control humano.
La conclusión clave es que la ventaja en ciberseguridad de vanguardia está pasando de obtener un único modelo potente a la capacidad de enrutar, verificar y operar múltiples modelos dentro de un sistema de seguridad confiable.