For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/minicpm-v-4-7-35b-moe-on-iphone-les-and-l-9db57311.md.
MiniCPM-V 4.7 lleva un modelo de mezcla de expertos de 35 mil millones de parámetros a dispositivos locales, incluidos teléfonos. ModelBest ...

MiniCPM-V 4.7 lleva un modelo de mezcla de expertos de 35 mil millones de parámetros a dispositivos locales, incluidos teléfonos. ModelBest y OpenBMB informan más de 13 tokens generados por segundo con alrededor de 3 GB de memoria en un iPhone 17 Pro Max, mediante una pila de despliegue optimizada.
La cifra necesita contexto. No significa que el modelo completo de 35B quepa en una descarga de 3 GB, ni que cualquier teléfono con 3 GB de RAM pueda ejecutarlo a la velocidad anunciada. El modelo transmite los pesos de los expertos desde el almacenamiento y utiliza programación, cuantización y optimizaciones de inferencia para mantener pequeño el conjunto de trabajo activo.
La versión cuenta con dos variantes principales:
| Variante | Diseño | Uso previsto |
|---|---|---|
| MiniCPM-V 4.7 35B-A3B | MoE con 35B de parámetros totales y aproximadamente 3B activos por token | Comprensión local más sólida de imágenes, documentos, múltiples imágenes y vídeo |
| MiniCPM-V 4.7 1B | Modelo denso pequeño; QbitAI describe aproximadamente 1,3B de parámetros | Tareas visuales con menos recursos, OCR y extracción de documentos |
El modelo 35B-A3B es el primer MoE de la serie MiniCPM-V. El proyecto anunció la versión 4.7 el 12 de octubre de 2026, seguido de cabezales de decodificación especulativa DSpark para ambas variantes el 15 de octubre.
El repositorio indica compatibilidad de despliegue para iOS, Android y HarmonyOS. También describe soporte en plataformas Intel, AMD, Arm, Rockchip y Houmo. El rendimiento real depende del dispositivo, el formato del modelo, el backend de inferencia y la configuración, por lo que la compatibilidad de plataforma no debe interpretarse como velocidad idéntica en todo el hardware.
La tabla de evaluación oficial de 35B-A3B informa los siguientes resultados en modo Instruct:
| Benchmark | Compresión visual de 4× | Compresión visual de 16× |
|---|---|---|
| MMBench | 91,72 | 90,87 |
| MMStar | 80,67 | 80,13 |
| MMMU | 80,22 | 80,00 |
| MathVista | 88,00 | 87,30 |
| OCRBench | 91,20 | 90,40 |
| OmniDocBench v1.6 | 94,24 | 93,25 |
| Video-MME, sin subtítulos | 76,40 | 74,70 |
| LongVideoBench | 68,90 | 67,60 |

Fuente: OpenBMB, repositorio MiniCPM-V. Su tabla combina informes públicos con las evaluaciones locales del equipo mediante checkpoints oficiales en modo Instruct.
La tabla muestra descensos relativamente pequeños en varias tareas al pasar a una compresión visual más fuerte. MMBench cae 0,85 puntos, por ejemplo, mientras que OCRBench baja 0,80. Otras tareas pierden más, por lo que los desarrolladores aún deben comprobar si el texto pequeño, los gráficos o el detalle visual son importantes para su propia carga de trabajo.
Estos son resultados de evaluación del modelo, no una prueba de que la configuración móvil reproduzca todas las puntuaciones ni de que cada imagen de usuario se interprete correctamente. Son puntos de referencia útiles para decidir qué probar.
MoE reduce el cómputo al activar solo expertos seleccionados para un token. No elimina la necesidad de almacenar los demás expertos, ya que tokens y capas posteriores pueden elegir otros distintos.
En un teléfono con memoria limitada, almacenar esos pesos en memoria flash hace que el modelo esté disponible, pero esperar repetidamente al almacenamiento puede ralentizar la decodificación. Restringir el enrutamiento a un subconjunto fijo de expertos reduce las cargas, pero cambia qué expertos puede utilizar el modelo. En cambio, MiniCPM-V 4.7 intenta solapar la carga con el cómputo mientras conserva las decisiones reales del enrutador.
Lookahead Expert Scheduling, o LES, predice qué expertos probablemente necesitará la siguiente capa y precarga sus pesos. Cuando el enrutador real selecciona expertos, el motor primero calcula los expertos seleccionados que ya están disponibles mientras carga los restantes necesarios.
La predicción cambia el orden de preparación y ejecución. No sustituye la decisión de enrutamiento del modelo: los expertos que no hayan sido previstos se cargan y evalúan igualmente. Esta distinción explica por qué la técnica puede mejorar la velocidad sin depender de un conjunto de expertos reducido permanentemente.
La guía oficial combina LES con cuantización detallada por capas. Los pesos de expertos más pequeños reducen el tráfico entre el almacenamiento y la memoria, mientras que un diseño optimizado hace más eficiente la carga. El equipo informa una mejora de decodificación de cinco veces en dispositivos reales gracias a su trabajo de optimización en el dispositivo; es un resultado de su configuración probada, no un multiplicador universal.
DSpark añade un modelo borrador que propone tokens para que el modelo principal los verifique. La versión proporciona cabezales de borrador específicos para ambos tamaños. Este es otro componente de la pila optimizada, por lo que no debe asumirse que un checkpoint estándar que se ejecute en un backend genérico logrará la misma velocidad.
En el lado visual, el modelo utiliza compresión temprana dentro del codificador de visión, basada en LLaVA-UHD v4. La fusión temprana de tokens visuales reduce el trabajo en las capas posteriores del codificador. Las configuraciones seleccionables de 4× y 16× exponen un equilibrio entre detalle visual y coste de inferencia.
La documentación oficial de la aplicación móvil ofrece una imagen mucho más clara del despliegue completo:
| Elemento de despliegue móvil | Requisito o tamaño documentado |
|---|---|
| Teléfono validado para 35B-A3B | iPhone 17 Pro Max con 12 GB de RAM |
| RAM de dispositivo recomendada para la demo 35B-A3B | Al menos 12 GB |
| Descarga total del modelo 35B-A3B | Aproximadamente 16,6 GB |
| Almacenamiento libre recomendado | Aproximadamente 17 GB para los archivos del modelo |
| Almacenamiento de expertos | Directorio independiente experts/ con 40 fragmentos y un manifiesto |
| Ventana de contexto predeterminada de la demo | 4K tokens |
El paquete móvil dividido difiere de un GGUF estándar de modelo completo. Su archivo principal -les depende del directorio de expertos correspondiente, y la aplicación comprueba que los archivos sean coherentes. Las ventanas de contexto más grandes incrementan la memoria de caché KV, mientras que una caché de expertos más pequeña en dispositivos con menos RAM puede ralentizar considerablemente la generación.
Una cifra pequeña de memoria de trabajo no elimina la necesidad de un almacenamiento local rápido y sustancial.
El artículo de QbitAI muestra ejemplos locales en teléfonos y tabletas, y después pruebas de API independientes. Mantener esta distinción es importante: un resultado de API no demuestra que la misma tarea se ejecutara sin conexión en el teléfono.
En la demostración inicial en iPhone, el modelo examina el gráfico de Minard sobre la campaña rusa de Napoleón. Al preguntársele por la temperatura más baja y su fecha, identifica −30° Réaumur el 6 de diciembre de 1812 y lo convierte a −37,5 °C mediante °C = °Ré × 1.25.
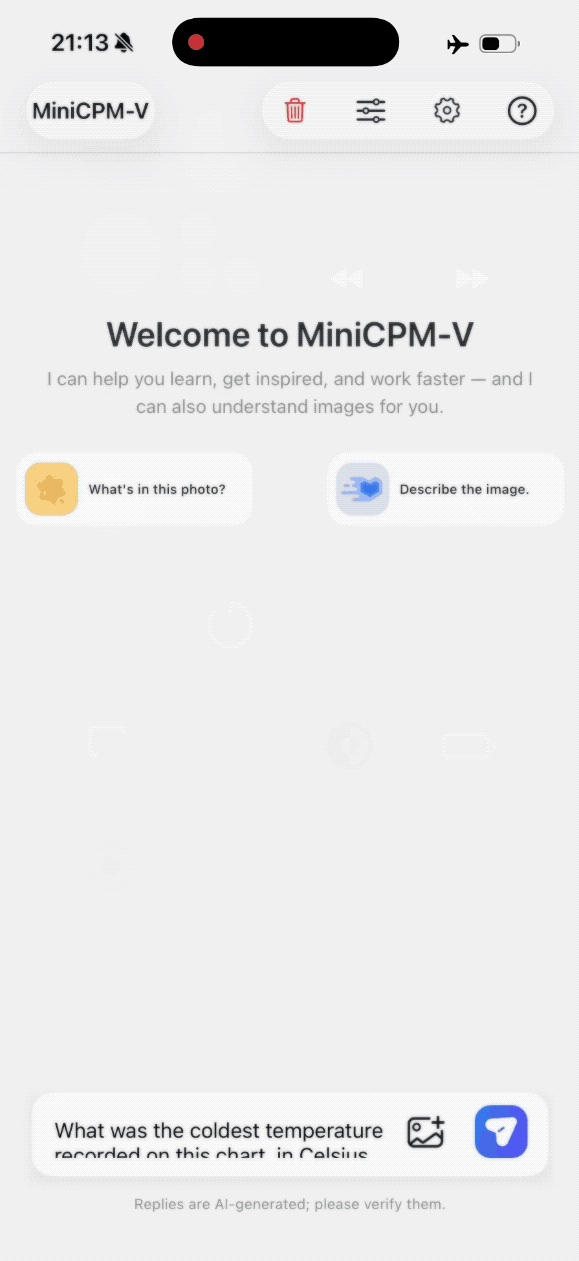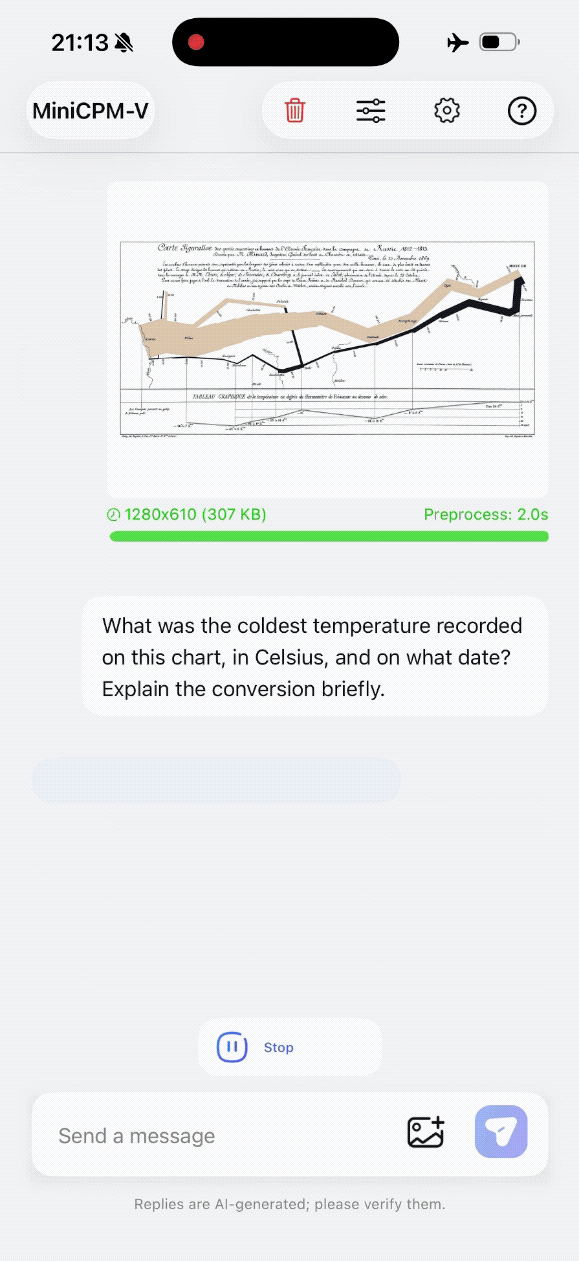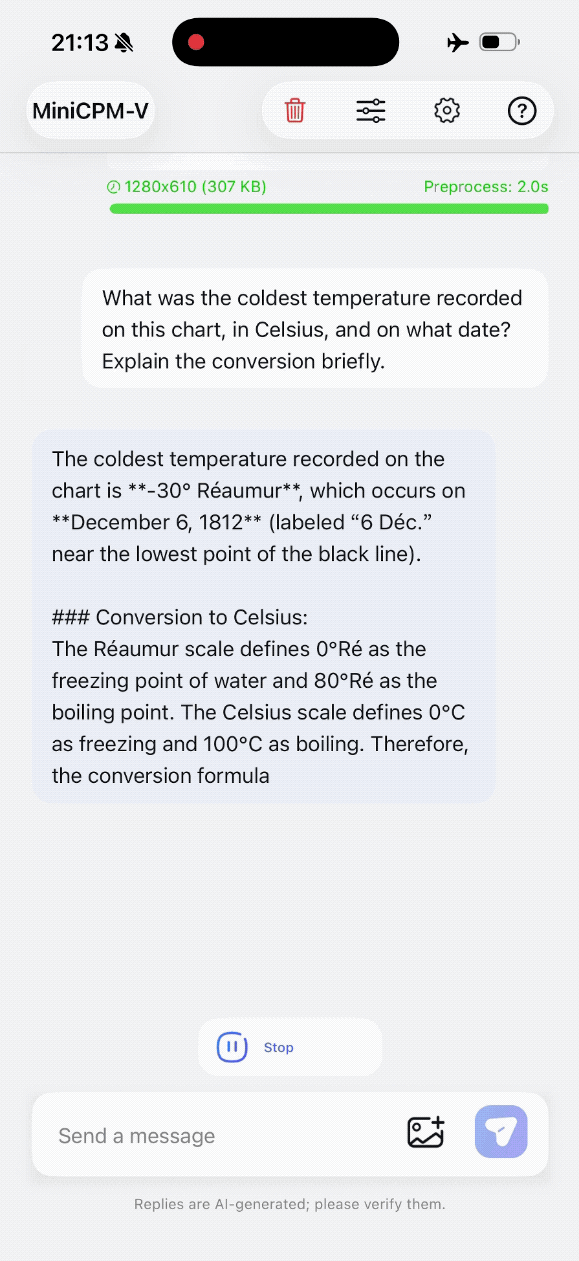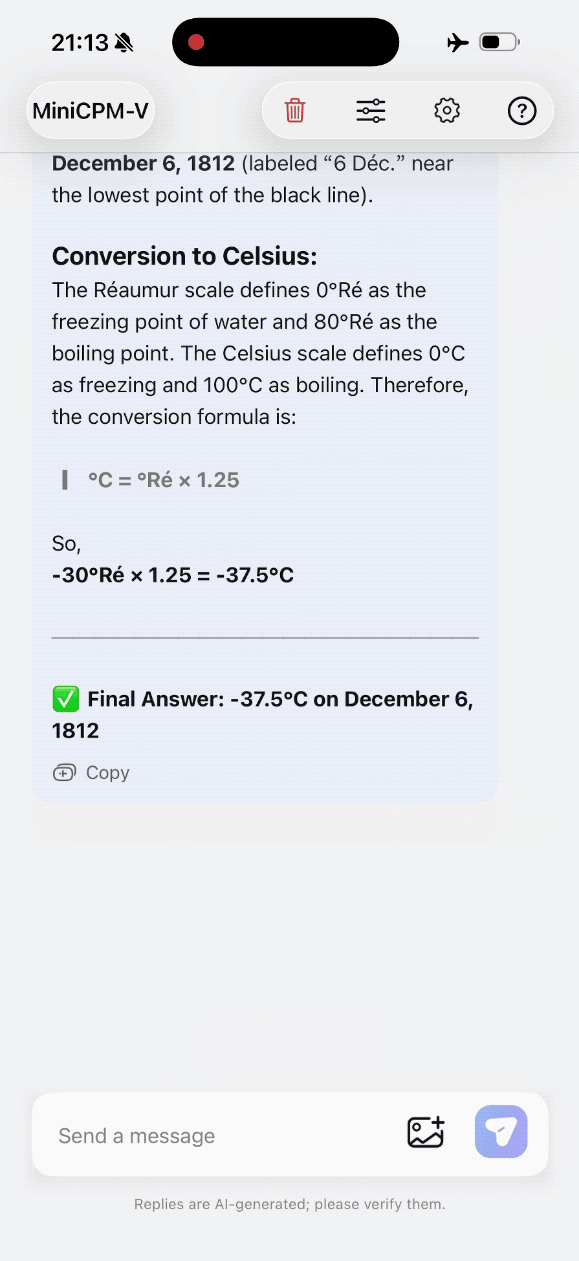
Fuente: QbitAI vía BAAI; grabación animada de pantalla de teléfono. La fuente también informa de la misma respuesta en un iPad M4.
Este ejemplo prueba más que el reconocimiento de texto. El modelo debe leer el gráfico, asociar una fecha con el punto relevante, reconocer la escala de temperatura y aplicar una conversión.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Otro ejemplo combina las potencias y tiempos de uso de electrodomésticos con una factura mensual de 420 kWh por ¥126. La salida mostrada estima 213,63 kWh para los electrodomésticos enumerados, o alrededor del 50,9 % de la factura, e identifica la reducción del uso del aire acondicionado como el mejor de los tres planes de ahorro propuestos.
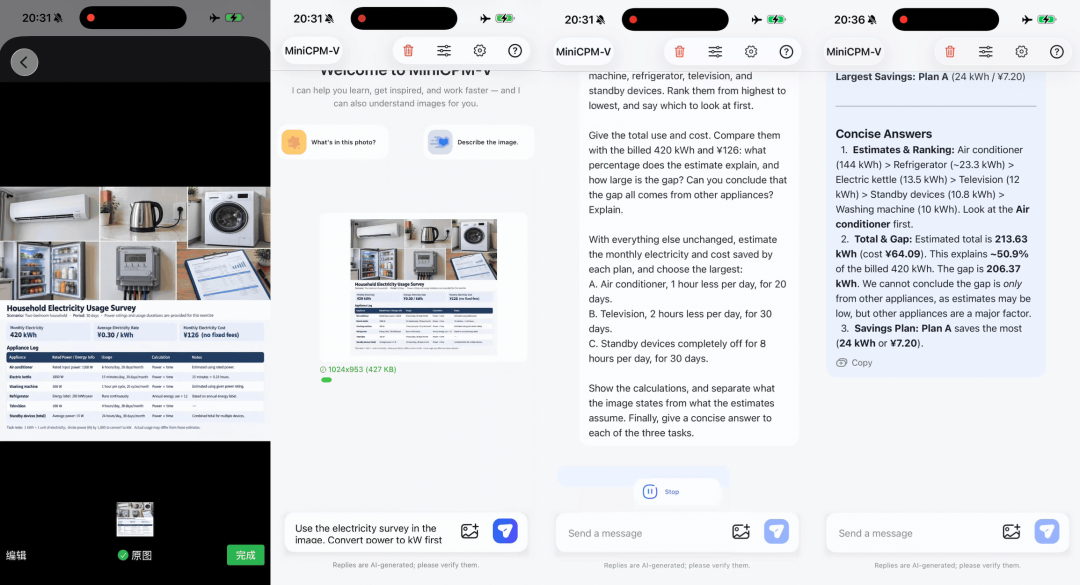
Fuente: QbitAI vía BAAI. La respuesta mostrada trata el consumo no explicado como incierto en lugar de asignarlo automáticamente a otros electrodomésticos.
Esta precisión es útil: las horas estimadas, el consumo de potencia real y los dispositivos omitidos pueden afectar a una comparación con la factura. Un total aritmético correcto por sí solo no establece por qué se produjo el consumo restante.
Se muestra que el modelo más pequeño convierte una página de un artículo académico en Markdown, incluidos encabezados, una tabla y notación matemática. QbitAI informa que la demostración tardó menos de medio minuto.
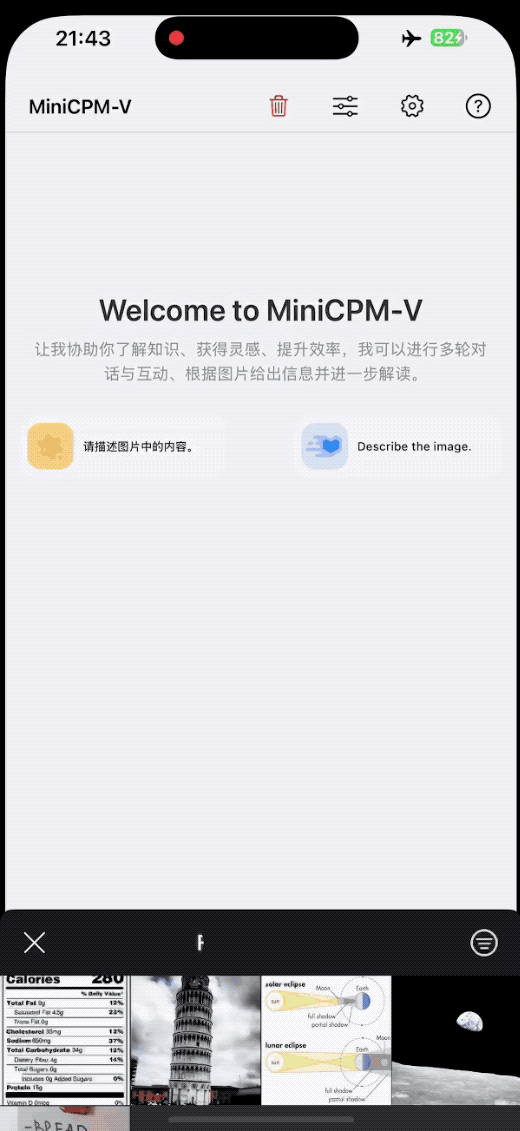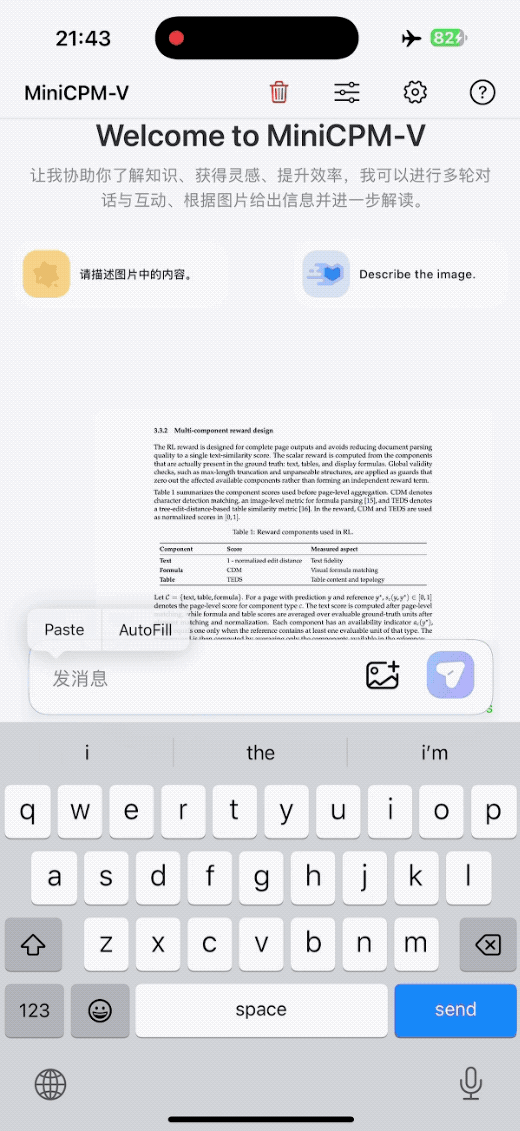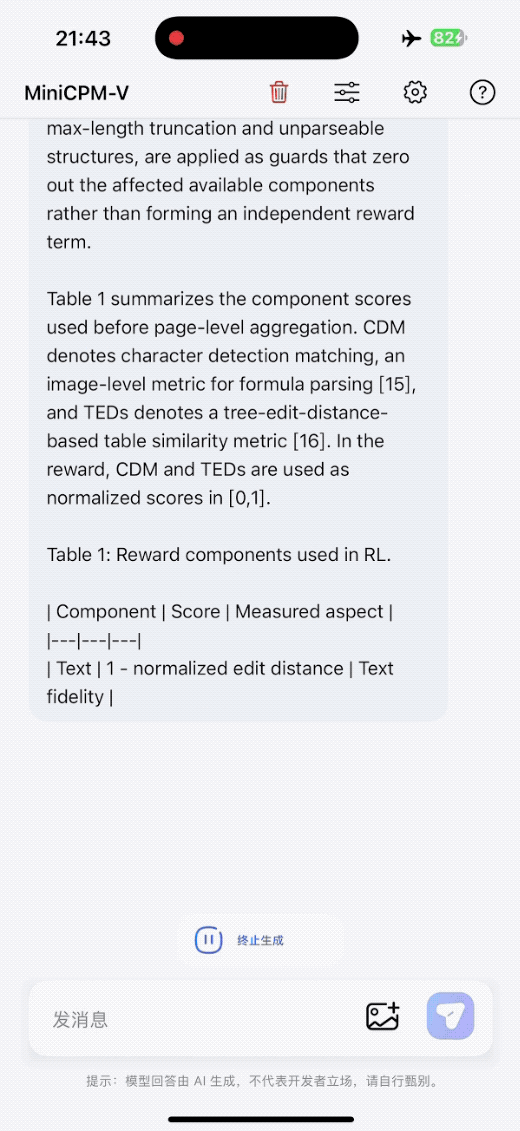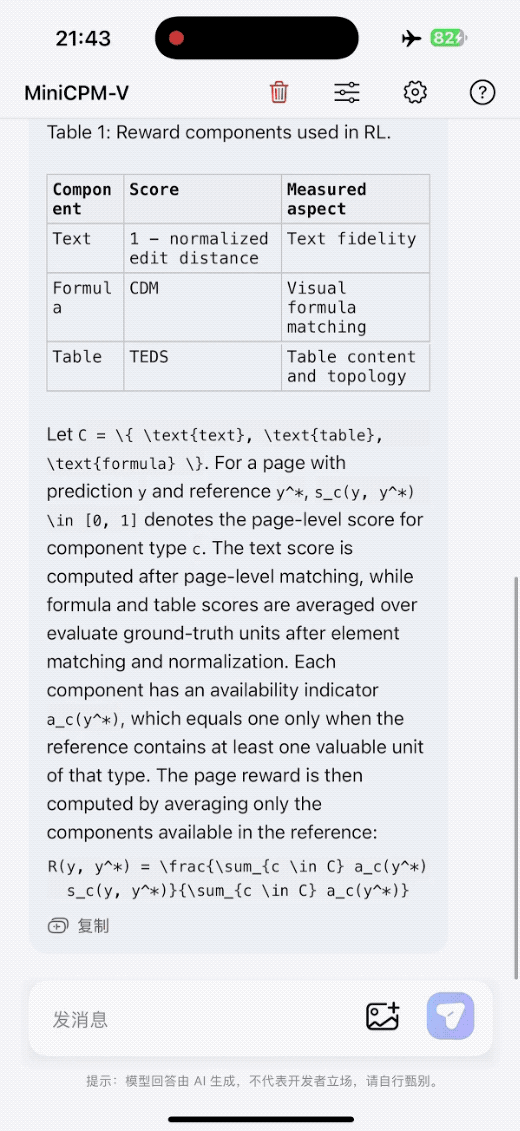
Fuente: QbitAI vía BAAI; demostración animada de documento local.
En sus pruebas de API independientes, el artículo informa de un cálculo de recibo de ¥86,40 menos ¥8 en descuentos, coincidente con un pago de ¥78,40. También describe una tarea de normas de estacionamiento que comprueba una estancia de 90 minutos frente a restricciones de limpieza, un límite de dos horas, exenciones para residentes y condiciones de reingreso. Se trata de pruebas ilustrativas, no de un estudio sistemático de precisión.
Una versión relacionada aborda el olvido durante la personalización. Self-Replay Fine-Tuning genera respuestas de dominio general a partir del modelo original, las filtra por calidad y mezcla los ejemplos conservados con los nuevos datos de tarea durante el ajuste fino supervisado estándar.
El método modifica los datos de entrenamiento en lugar de la arquitectura del modelo o la función de pérdida. Los ejemplos de repetición pueden generarse antes del entrenamiento y reutilizarse, lo que reduce la necesidad de nuevas ejecuciones en línea durante cada sesión.
La publicación de OpenBMB informa resultados alentadores de retención en experimentos de conteo y OCR de documentos, incluidas pruebas en modelos MiniCPM anteriores y otras familias de modelos. Esos resultados no deben presentarse como una garantía general para cada ajuste fino de la versión 4.7. La cobertura de prompts, la calidad del filtrado y la proporción entre tarea y repetición siguen siendo elecciones experimentales.
El repositorio de aplicaciones móviles proporciona demostraciones para iOS, Android y HarmonyOS. Para la ruta MoE en teléfonos, el gestor de modelos integrado en la aplicación descarga el archivo principal correspondiente, el proyector visual y los fragmentos de expertos; el repositorio advierte que los archivos GGUF de escritorio ordinarios y no divididos no son intercambiables con este paquete móvil.
Para otros despliegues, la guía 4.7 enumera SGLang, vLLM, llama.cpp y Ollama, además de SWIFT y LLaMA-Factory para ajuste fino. Incluye enlaces a opciones de cuantización como GGUF, BNB, AWQ, GPTQ y FP8. Elija el artefacto para el entorno de ejecución previsto, en lugar de tratar cada formato compatible como un modelo móvil intercambiable.
La inferencia sin conexión comienza una vez que la aplicación y los archivos del modelo necesarios están presentes localmente. Esto elimina la necesidad de enviar cada solicitud de inferencia a un modelo en la nube, aunque los permisos de la aplicación, el manejo local de datos, el almacenamiento y el rendimiento del hardware siguen siendo consideraciones prácticas de despliegue.
Es una versión de modelo multimodal de ModelBest y OpenBMB con variantes MoE 35B-A3B y pequeñas de 1B. Admite tareas que implican imágenes, documentos, múltiples imágenes y vídeo.
El proyecto demuestra un despliegue optimizado de 35B-A3B en un iPhone 17 Pro Max. Mantiene un conjunto de trabajo más pequeño en memoria mientras transmite expertos desde el almacenamiento local, en lugar de cargar los 35B de parámetros en la RAM de una sola vez.
No. La demostración móvil oficial indica una descarga total de aproximadamente 16,6 GB para el paquete 35B-A3B y recomienda alrededor de 17 GB de almacenamiento libre. El iPhone validado tiene 12 GB de RAM de dispositivo.
No. LES predice expertos para realizar una precarga y programa primero los que ya están disponibles. El enrutador real del modelo sigue seleccionando los expertos que se deben calcular, incluidos los que la predicción no detectó.
Sí, las demostraciones locales realizan inferencia en el dispositivo una vez descargados o instalados los archivos necesarios. Los ejemplos de API de la fuente son pruebas independientes y no deben confundirse con el funcionamiento sin conexión.
No, la demostración requiere un paquete dividido correspondiente con su archivo principal -les, proyector visual y fragmentos de expertos. La documentación de la aplicación explica por qué los archivos GGUF estándar de modelo completo no proporcionan el mismo comportamiento de despliegue en teléfonos.
MiniCPM-V 4.7 combina cómputo disperso con transmisión de expertos, programación anticipada, cuantización y compresión visual para hacer práctico un modelo multimodal más grande en determinados dispositivos locales. Las demostraciones cubren interpretación de gráficos, conversión de documentos y cálculos cotidianos, mientras que los benchmarks publicados proporcionan puntos de partida para la evaluación.
La principal limitación de despliegue es la diferencia entre la memoria de trabajo, la RAM total del dispositivo y los pesos almacenados. El resultado en teléfono es creíble como una configuración optimizada específica, no como una promesa de que un modelo completo de 35B quepa en 3 GB o funcione igual de bien en todos los dispositivos.
Empieza con una sola frase y obtén un sitio completo en minutos.