For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/minimax-m3-1-flash-api-pricing-benchmarks-c8e3fe1c.md.
MiniMax ha lanzado M3.1 Flash con precios por token más bajos y mejores resultados reportados en razonamiento y tareas de agentes. La cobert...
MiniMax ha lanzado M3.1 Flash con precios por token más bajos y mejores resultados reportados en razonamiento y tareas de agentes. La cobertura de THE DECODER del 19 de octubre lo sitúa en 42 puntos en el Artificial Analysis Intelligence Index, frente a los 29 puntos de M3.
La distinción importante está entre el precio de un token y el coste de completar una tarea. Un modelo puede ser más barato en ambas métricas, pero el coste de una tarea también depende de cuánto genera, con qué frecuencia vuelve a intentarlo y de si el resultado es utilizable.
La comparación del periodo de lanzamiento incluida en el informe sitúa a M3.1 Flash junto a GLM-5.3-Flash en el índice compuesto, ligeramente por delante de Gemini 3.8 Flash y por detrás de DeepSeek V4.1 Flash 1017.
| Evaluación reportada | M3.1 Flash | Comparación destacada en el informe |
|---|---|---|
| Artificial Analysis Intelligence Index | 42 | M3: 29; GLM-5.3-Flash: 42; Gemini 3.8 Flash: 41; DeepSeek: 45. |
| Humanity's Last Exam | 48 % | DeepSeek: 43 %. |
| CritPt | 22 % | GLM: 15 %; Gemini: 18 %; DeepSeek: 24 %. |
| Precisión de AA-Omniscience | 56 % | GLM: 28 %; DeepSeek: 43 %. |
| Coste medio de evaluación por tarea | Aproximadamente $0.22 | DeepSeek: aproximadamente $0.26. |
Estas son las cifras reportadas en el momento de la publicación. Las configuraciones de los benchmarks, las versiones y las revisiones de los modelos son importantes; la tabla no constituye una clasificación universal para todas las cargas de trabajo.

Crédito del gráfico: Artificial Analysis, reproducido por THE DECODER.
El informe relaciona el menor coste por tarea, en parte, con una reducción del consumo de tokens de salida. Su comparación de aproximadamente 189 millones frente a 224 millones de tokens de salida se refiere a los totales del benchmark, no a la cantidad generada por una solicitud ordinaria.
Por separado, MiniMax afirma que la inferencia en línea es casi tres veces más rápida y que los costes generales de uso en tareas de agentes se reducen un 70 % frente a su predecesor. Estas mediciones de la empresa no son equivalentes a la comparación de costes de Artificial Analysis. No deben combinarse en un único resultado de eficiencia verificado de forma independiente.
El informe también cita una tasa de alucinación de AA-Omniscience del 93 %. Esto no significa que el 93 % de todas las respuestas fueran incorrectas, ni predice la tasa de errores de un asistente implementado en tareas arbitrarias.
Artificial Analysis define esta tasa sobre las respuestas no correctas: respuestas incorrectas divididas entre el conjunto formado por respuestas incorrectas, parciales y no intentadas. Mide la tendencia a dar una respuesta equivocada cuando sería preferible admitir incertidumbre. La precisión, en cambio, contabiliza las respuestas correctas entre todas las preguntas.
Esta distinción permite que un modelo tenga una precisión factual comparativamente sólida y, al mismo tiempo, una gestión deficiente de la incertidumbre. En trabajos sensibles al conocimiento, hay que comprobar las evidencias y verificar si el modelo puede abstenerse, en lugar de confiar únicamente en una puntuación compuesta.
THE DECODER informa de una ventana de contexto de hasta un millón de tokens y compatibilidad con entradas de texto e imágenes. La compatibilidad con imágenes no debe confundirse con la generación de imágenes: aceptar una imagen no implica producir una.
El anuncio oficial de lanzamiento de MiniMax confirma precios fijos por millón de tokens:
| Categoría de tokens | Precio por un millón de tokens |
|---|---|
| Entrada | $0.15 |
| Salida | $0.60 |
| Entrada en caché | $0.015 |
El precio de caché se aplica a las coincidencias de caché que cumplen los requisitos, no a todos los tokens de entrada. Por ejemplo, un millón de tokens de entrada sin caché más un millón de tokens de salida costarían $0.75 con estas tarifas indicadas, antes de cualquier otro cargo aplicable. Se trata de una ilustración del coste de los tokens, no de una estimación típica por tarea.
La API, M Plan y MiniMax Code son vías de acceso que aparecen en el anuncio oficial. THE DECODER indica el 23 de octubre como fecha prevista para el lanzamiento de los pesos abiertos; la publicación de la empresa revisada afirma que los pesos llegarán más adelante sin especificar esa fecha. En el momento de preparar este artículo, el 20 de octubre, un lanzamiento futuro no debe describirse como pesos que ya están disponibles para descargar.
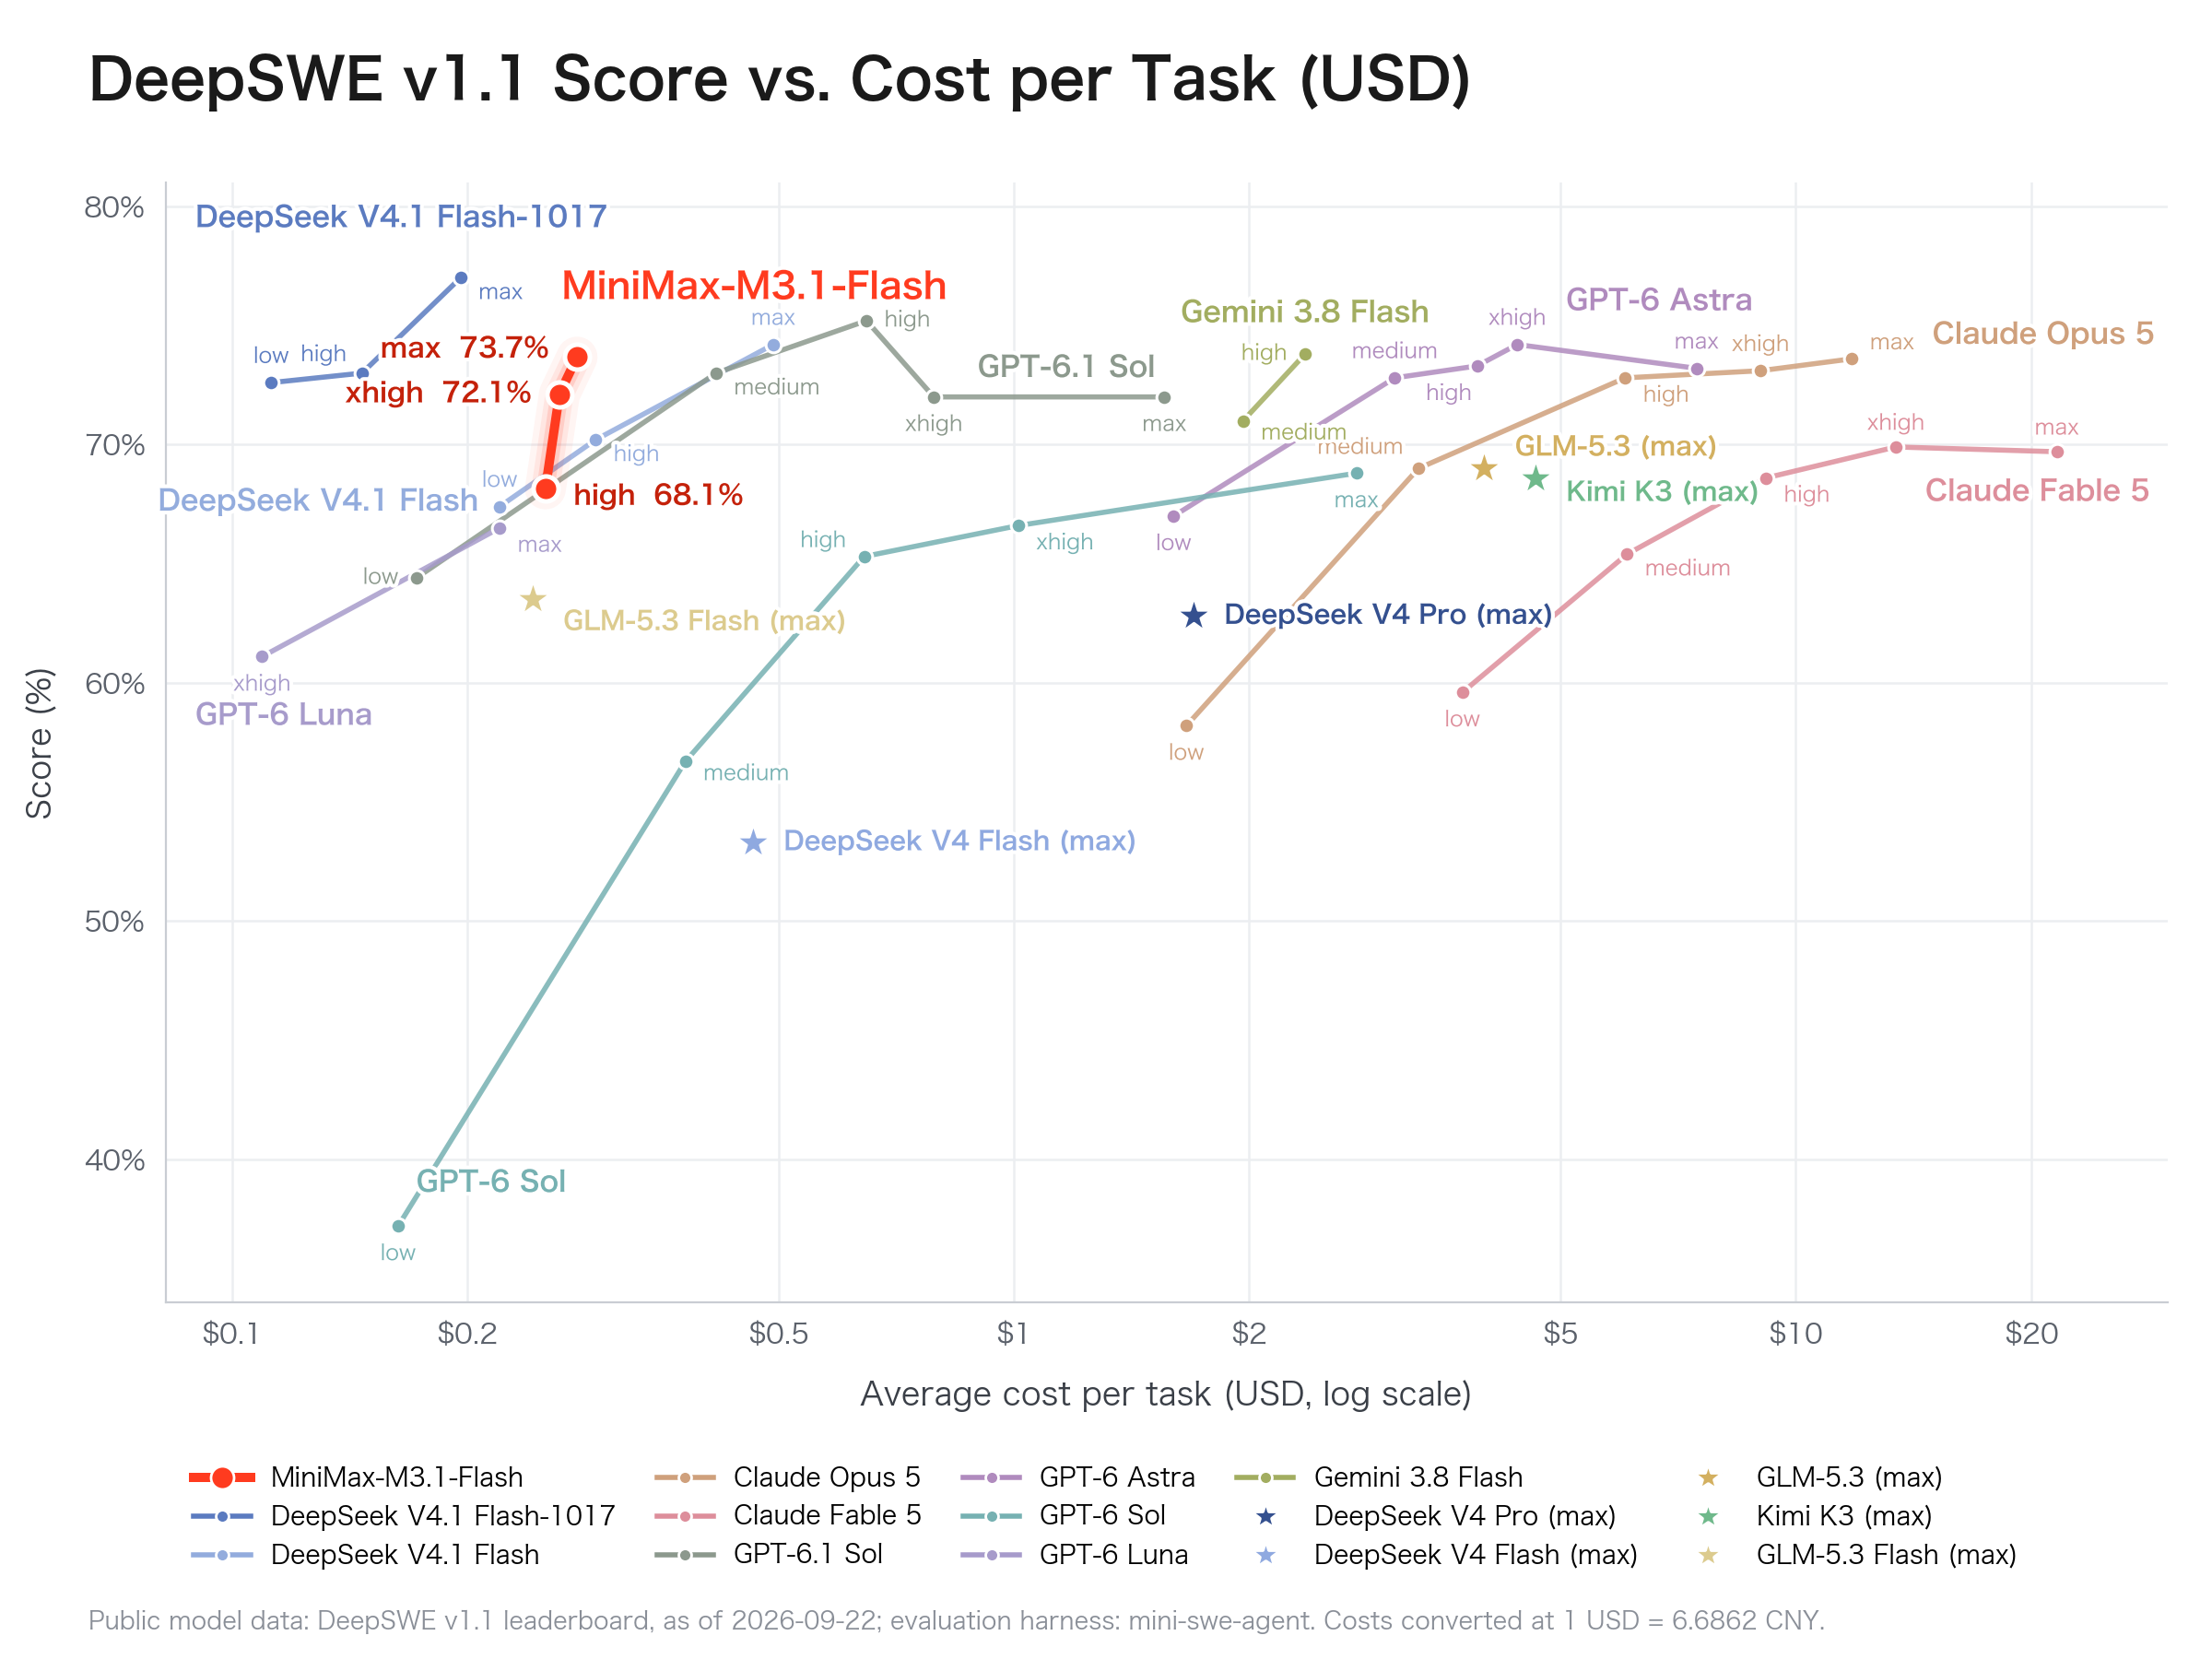
MiniMax informa de hasta un 73,7 % en DeepSWE v1.1 con un coste por tarea inferior a $0.30 en su gráfico. Las configuraciones de menor esfuerzo que aparecen en la misma figura intercambian parte de la puntuación por un coste inferior.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Gráfico publicado por la empresa; la figura identifica mini-swe-agent como el sistema de evaluación e indica la fecha de los datos de comparación.
Una puntuación de programación refleja conjuntamente el modelo, las herramientas, el nivel de esfuerzo y el entorno de prueba. No implica que el 73,7 % de los tickets de una organización se resuelvan sin revisión ni que todas las tareas cuesten la media representada en el gráfico.
La comparación final de la fuente no señala un ganador único. DeepSeek lidera en el índice compuesto y en la puntuación de física citada, mientras que MiniMax lidera en el resultado reportado de Humanity's Last Exam y en la precisión de AA-Omniscience.
El menor coste medio por tarea de MiniMax en esa instantánea constituye una evidencia útil para la evaluación, no una razón para asumir que será la opción más barata con todas las instrucciones. Una carga de trabajo con salidas más largas, llamadas fallidas a herramientas o más reintentos puede cambiar la clasificación.
El informe también distingue el estado de lanzamiento: enlaza un repositorio existente de pesos de DeepSeek y describe los pesos de MiniMax como próximos. Los pesos abiertos, una suscripción a una API y una aplicación de escritorio para programación son opciones de distribución independientes, con requisitos operativos diferentes.
Es el nuevo modelo Flash de MiniMax, disponible a través de sus productos alojados y su API. El lanzamiento hace hincapié en el razonamiento, las tareas de agentes, la programación y la eficiencia de inferencia.
El anuncio oficial indica $0.15 para la entrada, $0.60 para la salida y $0.015 para la entrada en caché por cada millón de tokens. Confirma los precios actuales de la cuenta y las reglas de caché antes de estimar una factura de producción.
No: esa es una media reportada del benchmark. Los costes reales dependen del tamaño de la instrucción, la salida generada, el comportamiento de la caché, los ciclos de uso de herramientas y los reintentos.
No: el denominador de la métrica contiene respuestas no correctas, no todas las respuestas. Se refiere a las respuestas incorrectas frente a las respuestas parciales o la abstención en esa evaluación.
Las fuentes revisadas los describen como próximos. THE DECODER cita el 23 de octubre, mientras que el anuncio de MiniMax no proporciona una fecha exacta; verifica el repositorio y la licencia reales cuando se publiquen.
Los resultados reportados se dividen entre distintos benchmarks. La elección debe basarse en las tareas específicas, los requisitos de fiabilidad y el coste total medido en tu propia evaluación.
M3.1 Flash combina precios por token bajos con resultados reportados competitivos en razonamiento y programación. Su ventaja de coste es más significativa cuando se mide por tarea completada correctamente bajo configuraciones comparables.
Lee las definiciones de los benchmarks, separa las afirmaciones de la empresa de las mediciones externas y verifica la disponibilidad real de los pesos antes de planificar la implementación.
Empieza con una sola frase y obtén un sitio completo en minutos.