
MiniMax lanzó M3.1 Flash el 19 de octubre, poco después de DeepSeek V4.1 Flash-1017. El artículo compara ambos modelos mediante gráficos de puntuación frente a coste en tareas de programación y agentes, donde modelos relativamente económicos se acercan a sistemas más costosos en determinadas evaluaciones.
Su enfoque de «primero DeepSeek, después MiniMax» se refiere a una comparación concreta de coste y rendimiento en programación. No debe interpretarse como una clasificación válida para todas las tareas, versiones de modelos o configuraciones de despliegue. La pregunta más útil es qué configuración completa el trabajo de forma fiable con un coste total aceptable.
Resultados de programación y flujos de trabajo empresariales con agentes
Los materiales de lanzamiento de MiniMax informan de un 73,7 % en DeepSWE v1.1, una evaluación que incluye comprensión de repositorios, desarrollo, correcciones y pruebas. La tabla de la fuente sitúa a DeepSeek V4.1 Flash-1017 en 77,0, a GPT-5.6 Sol en 73,0 y a Opus 5 en 74,0 para esa comparación.
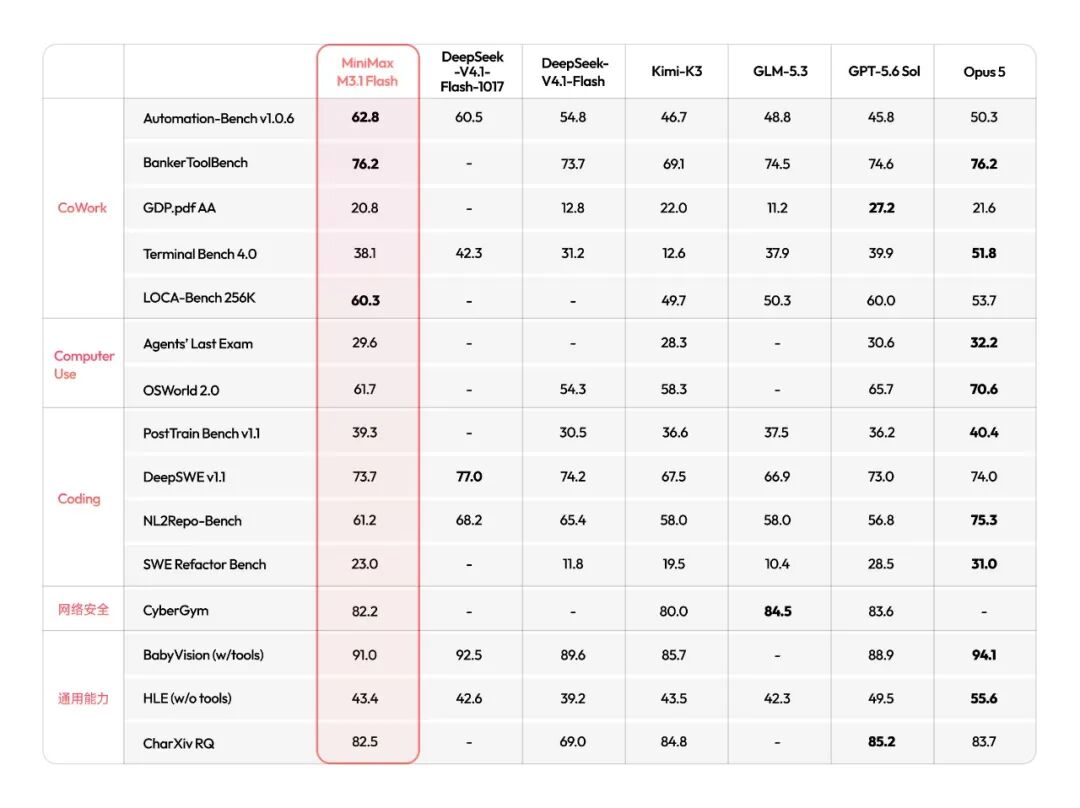
Comparación de la empresa reproducida por Xinzhiyuan; las versiones de los modelos y las condiciones de evaluación son importantes.
El gráfico de costes muestra a M3.1 Flash cerca del extremo de bajo coste con su puntuación declarada, mientras que DeepSeek Flash-1017 aparece por delante en esa comparación representada. Los distintos niveles de esfuerzo aparecen como puntos separados, por lo que seleccionar una configuración puede cambiar tanto el coste como el resultado.
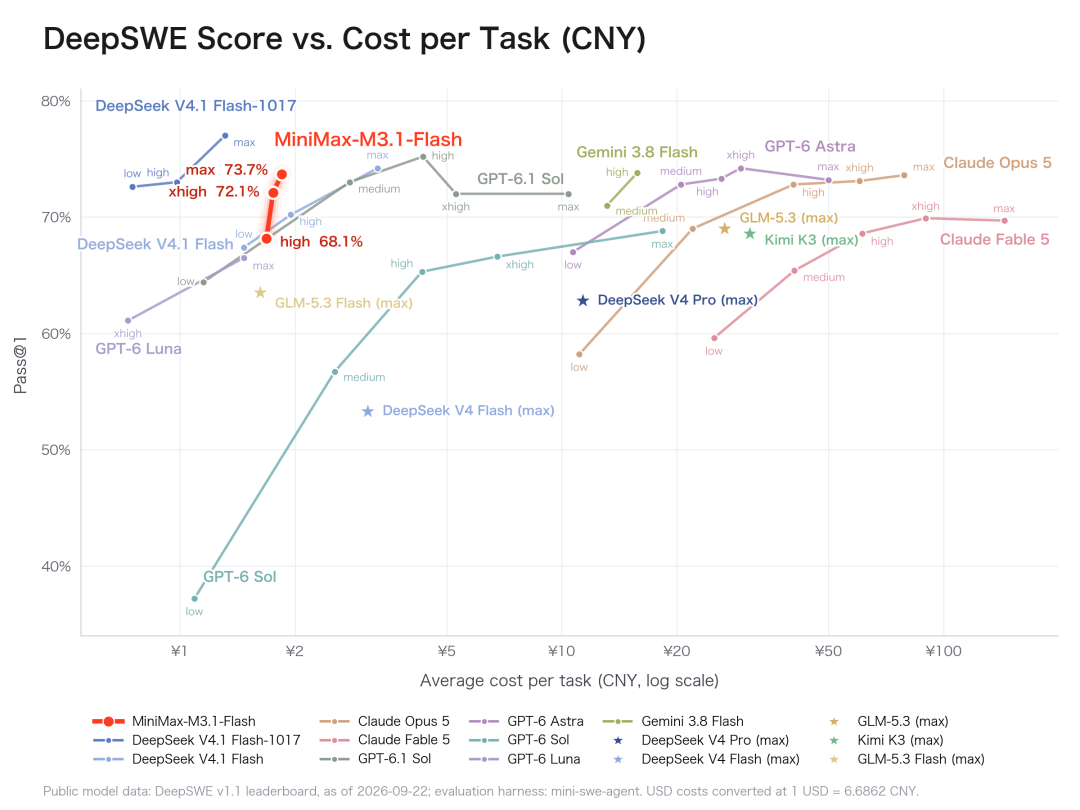
Un promedio inferior a 2 CNY en esta evaluación no es una tarifa fija para cada corrección de errores. El consumo de tokens, los intentos fallidos, el tamaño del repositorio y el uso de herramientas pueden cambiar el coste real de una tarea.
Automatización y uso de herramientas
En Automation-Bench, el gráfico proporcionado informa de un 62,8 % con el nivel máximo de esfuerzo. Sitúa a M3.1 Flash por encima de las demás configuraciones mostradas, incluido un punto de MiniMax con menor esfuerzo que intercambia parte de la puntuación por un coste más bajo.
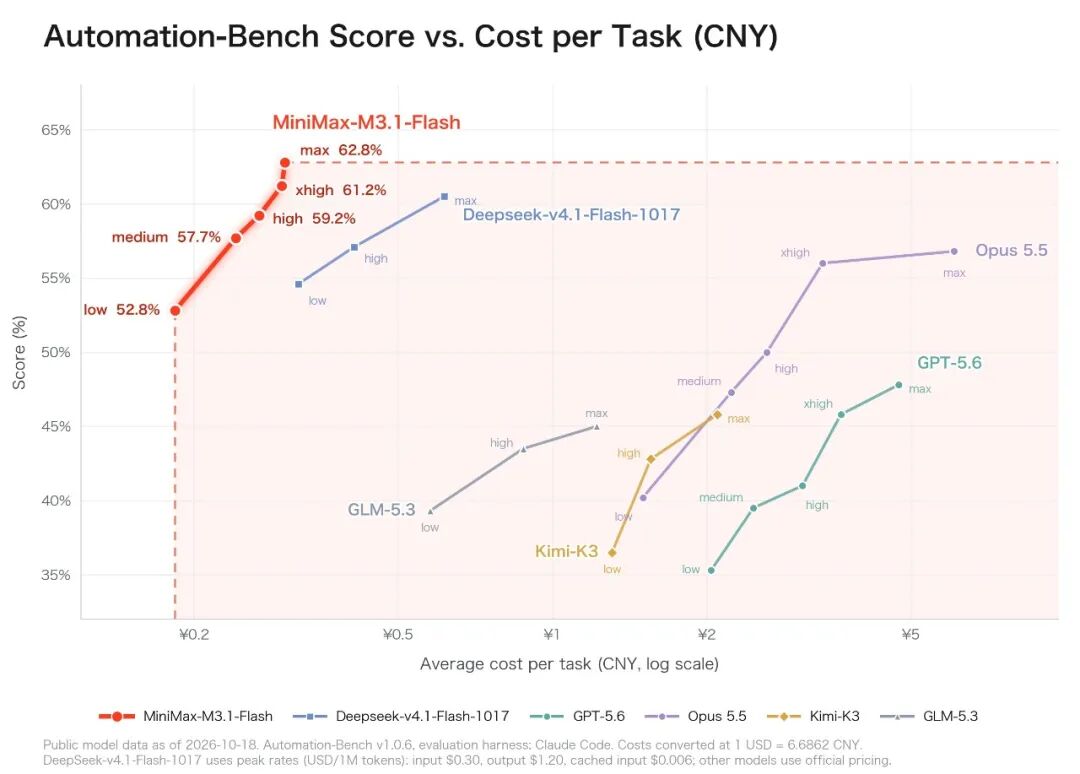
La fuente describe flujos de trabajo empresariales que abarcan herramientas SaaS y funciones de negocio. Un benchmark aproxima partes de ese trabajo; no demuestra que un modelo vaya a tener éxito en todos los procesos reales de ventas, finanzas o atención al cliente.
Otros resultados de MiniMax comunicados incluyen:
| Evaluación | Puntuación de M3.1 Flash en la fuente | Límite de comparación |
|---|---|---|
| LOCA-Bench 256K | 60,3. | Ligeramente por encima de la cifra de 60,0 de GPT-5.6 Sol que se muestra. |
| BankerToolBench | 76,2. | Empatado con la cifra de Opus 5 en esta tabla. |
| CyberGym | 82,2. | Por debajo de las puntuaciones mostradas de GLM-5.3 y GPT-5.6 Sol; sigue siendo competitivo en esa instantánea. |
| OSWorld 2.0 | 61,7. | Por encima del 54,3 mostrado para DeepSeek V4.1 Flash; no es la puntuación más alta de todos los modelos incluidos. |
| Agents' Last Exam | 29,6. | Por debajo del 30,6 de GPT-5.6 Sol y del 32,2 de Opus 5. |
Estas son pruebas independientes, no cifras que puedan promediarse para obtener una tasa de éxito universal significativa sin una metodología explícita.
Uso del ordenador y estimación de 739 CNY para ALE
El anuncio oficial de MiniMax confirma las puntuaciones comunicadas de 61,7 en OSWorld V2 y 29,6 en Agents' Last Exam. Su afirmación de liderar a los modelos chinos en esas pruebas está limitada por la comparación y las condiciones de evaluación utilizadas para el lanzamiento.
El gráfico de ALE de la fuente estima 739 CNY para ejecutar el conjunto completo de 152 tareas, con una tasa de aprobación del 29,6 %. No afirma que se haya superado cada tarea ni que el coste corresponda a cada tarea completada con éxito.
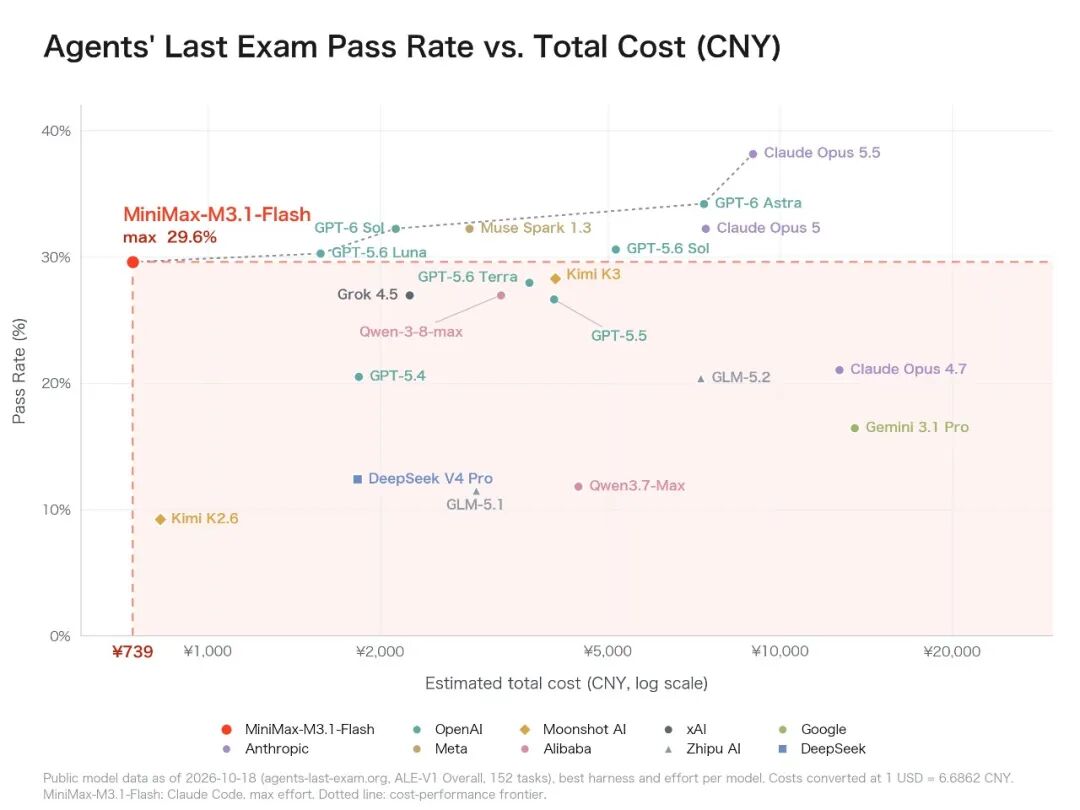
Dividir 739 CNY entre 152 da aproximadamente 4,86 CNY por tarea intentada. Ese cálculo explica la escala del gráfico; no incluye los costes de integración, infraestructura o revisión humana de una organización.
La frontera punteada conecta configuraciones seleccionadas con resultados favorables para sus costes representados. Su forma depende de los modelos incluidos, la fecha de evaluación y las hipótesis de coste. Un punto situado en esa frontera es una evidencia comparativa útil, no una prueba de que la misma configuración sea la más barata para todas las cargas de trabajo.
Precios de tokens y cálculo de la caché
El anuncio oficial en inglés de MiniMax enumera tarifas planas por millón de tokens de 0,15 $ por entrada, 0,60 $ por salida y 0,015 $ por entrada almacenada en caché. El artículo proporcionado presenta una tarifa en CNY de 1 CNY por entrada, 4 CNY por salida y 0,10 CNY por lecturas de caché.
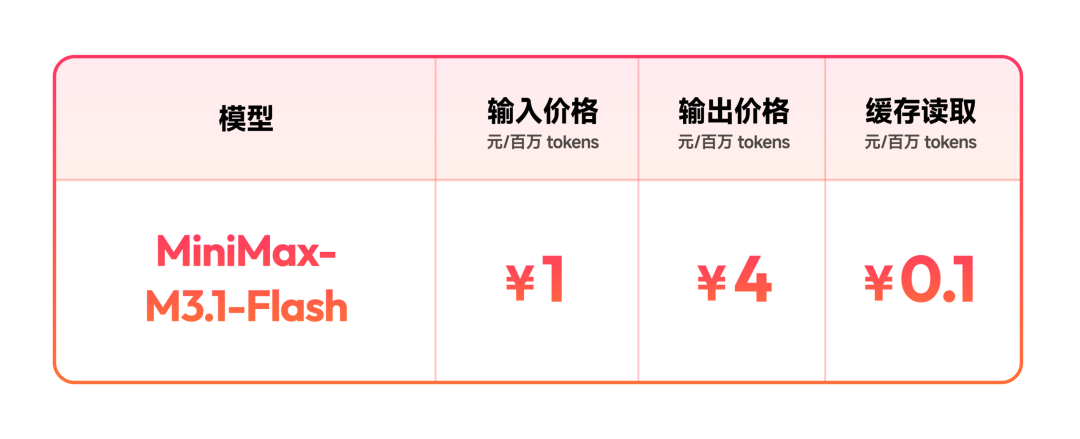
Los dos esquemas monetarios no deben tratarse como equivalentes exactos según el tipo de cambio vigente. Utiliza la tarifa de la plataforma de facturación y la cuenta reales.
La fuente compara el esquema de MiniMax en CNY con las tarifas máximas y valle comunicadas para DeepSeek. Sus ejemplos con mil millones de tokens de entrada pueden comprobarse con las hipótesis indicadas:
| Tasa de aciertos de caché | Coste de entrada de MiniMax | Coste de entrada máximo de DeepSeek en la fuente | Importe menor en este ejemplo |
|---|---|---|---|
| 90 % | 190 CNY. | 236 CNY. | MiniMax por 46 CNY. |
| 95 % | 145 CNY. | 138 CNY. | DeepSeek por 7 CNY. |
| 99 % | 109 CNY. | 59,60 CNY. | DeepSeek por 49,40 CNY. |
Para MiniMax con un 90 % de aciertos, mil millones de tokens de entrada equivalen a 1.000 unidades de un millón de tokens: 100 × 1 + 900 × 0,10 = 190. Los tokens de salida se excluyen de estos ejemplos centrados únicamente en la entrada, al igual que cualquier cargo no representado por las tarifas citadas.
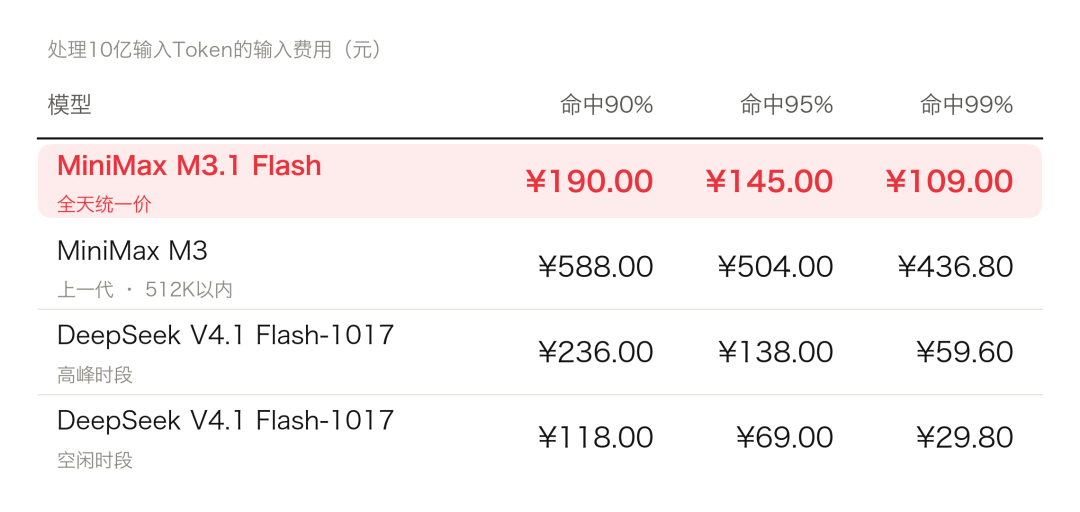
Esto también muestra por qué un precio de entrada sin caché más bajo no garantiza la factura más reducida cuando la caché domina el coste. La extrapolación del artículo desde un promedio de benchmark hasta 1.000 tareas empresariales es una ilustración presupuestaria, no un presupuesto para ejecutar esas tareas en producción.
MiniMax también afirma una reducción del 70 % en el coste total de uso de tareas con agentes frente a su predecesor. Esa afirmación sobre la carga de trabajo es distinta de una simple reducción del precio por token.
Velocidad de inferencia, Space Bunny y ajustes de la API
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
La empresa identifica el Space Bunny probado de forma anónima como una versión inicial de M3.1 Flash y afirma que procesó más de 200 billones de tokens. Informa de una velocidad de salida de más de 200 tokens por segundo, con velocidades medianas superiores a 170 tokens por segundo, junto con una inferencia en línea casi tres veces más rápida.
Estas son mediciones de la empresa. Los tokens por segundo miden el rendimiento de salida, mientras que el tiempo necesario para completar una tarea con agentes también incluye razonamiento, llamadas a herramientas, esperas, reintentos y pruebas.
La guía de invocación del modelo de MiniMax confirma una ventana de contexto de 1.000.000 de tokens y entradas de texto, imagen y vídeo. Admitir esas entradas no significa que el modelo genere imágenes o vídeos.
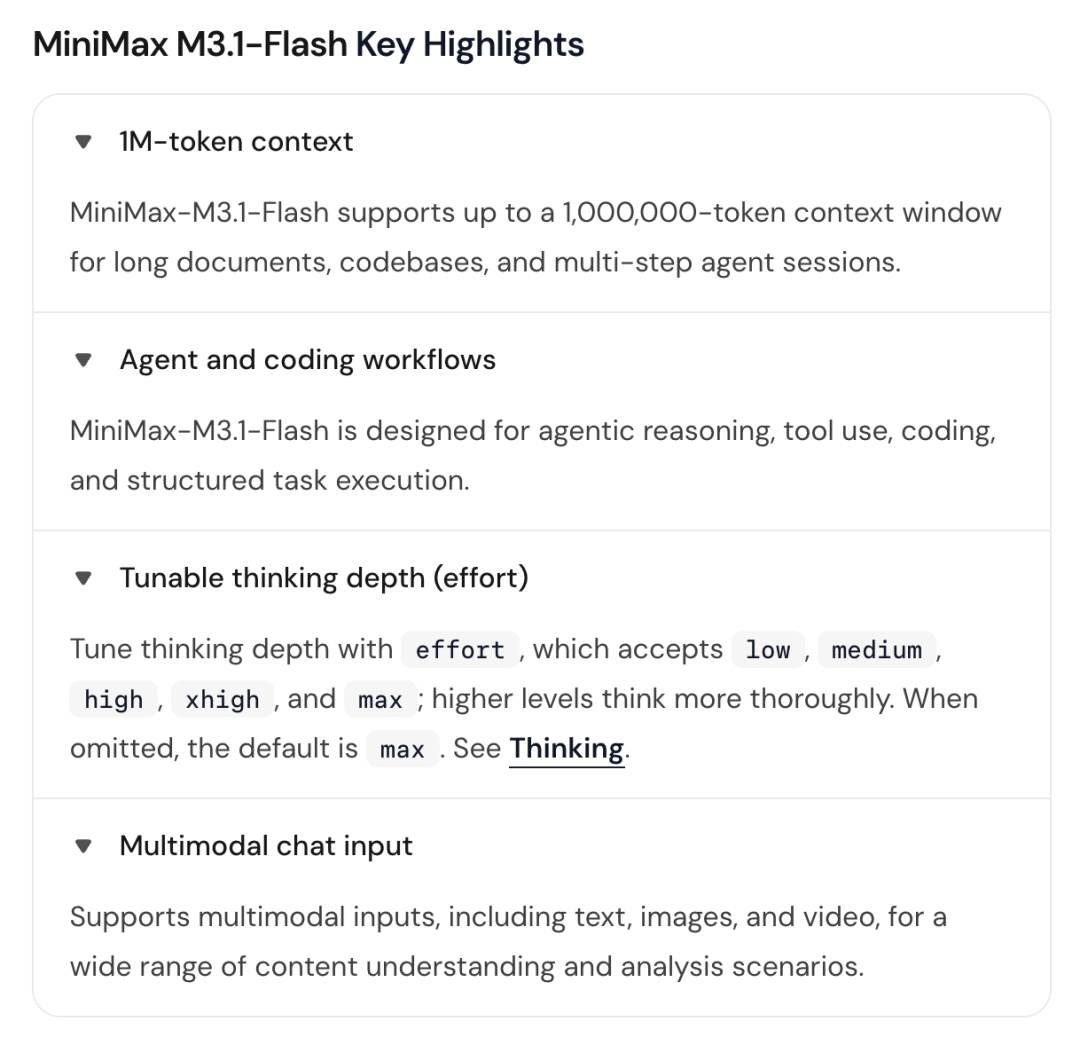
La guía confirma cinco niveles de razonamiento: low, medium, high, xhigh y max. Si se omite el ajuste, el valor predeterminado es max; el razonamiento no se puede desactivar. El campo de la solicitud depende del protocolo:
| Protocolo | Campo de profundidad de razonamiento |
|---|---|
| Compatible con Anthropic | output_config.effort. |
| Chat Completions compatible con OpenAI | reasoning_effort. |
| OpenAI Responses | reasoning.effort. |
Esos nombres de campo no deben combinarse en un único parámetro de nivel superior effort. La guía oficial indica que los niveles superiores generalmente generan más tokens de razonamiento y aumentan la latencia; reducir el esfuerzo disminuye ese trabajo, pero no lo desactiva.
El acceso durante el lanzamiento incluye la API de MiniMax, M Plan y MiniMax Code. El anuncio indica que los pesos del modelo llegarán más adelante, por lo que este artículo no implica que en el momento del lanzamiento ya estuviera disponible una versión autoalojable ni su licencia definitiva.
Los ejemplos de la ciudad plegable y la pagoda de la fuente
Xinzhiyuan describe la conexión del modelo con Codex y la solicitud de una ciudad plegable interactiva. Su relato incluye un control deslizante de plegado, iluminación nocturna y una vista que puede rotarse para inspeccionar la escena.
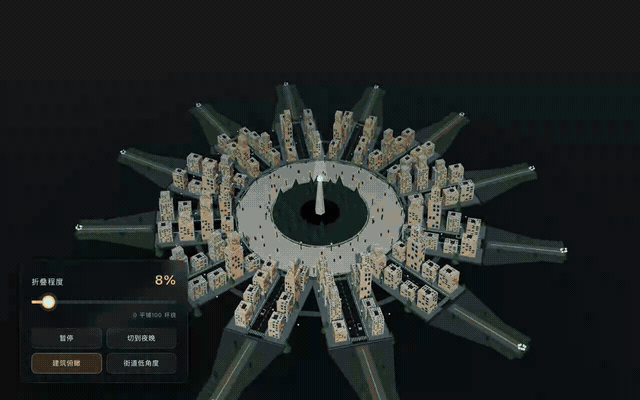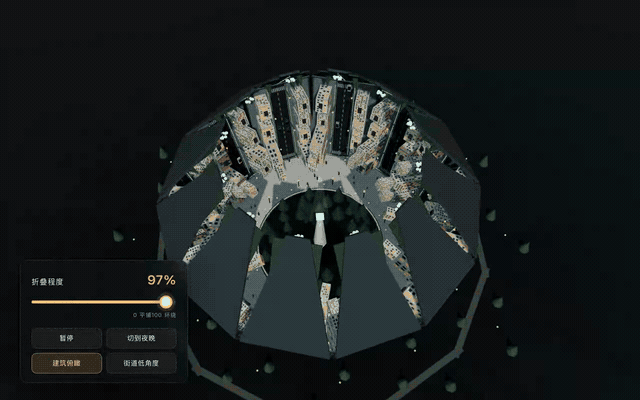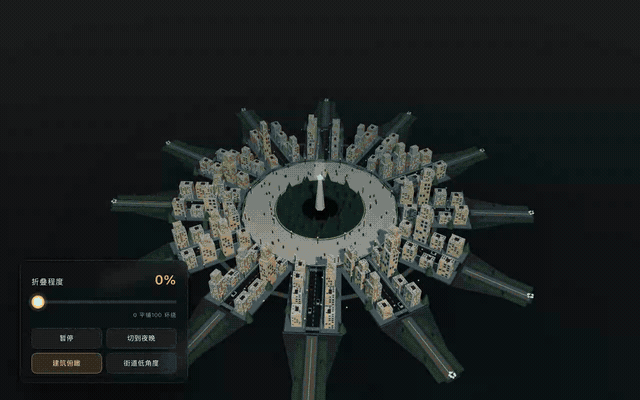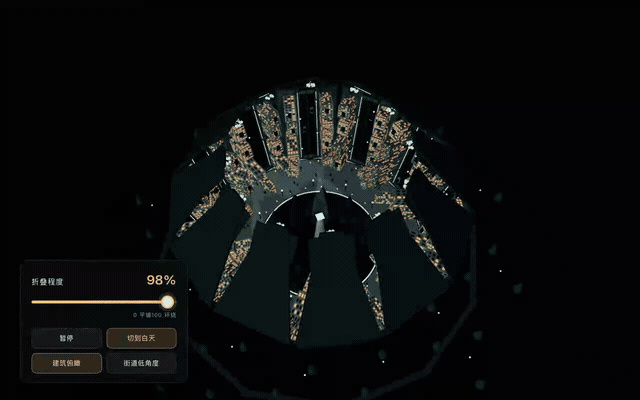
Esta es la demostración del editor, no una prueba nueva realizada para este documento. La imagen ilustra un resultado seleccionado sin establecer la velocidad de fotogramas, la calidad del código ni el comportamiento entre navegadores.
El artículo también reproduce el ejemplo de una pagoda creado por el desarrollador AJ, que según se informa fue generado en una sola llamada a la API con el máximo nivel de razonamiento y aproximadamente 50.000 tokens. La afirmación de que ofrece un mayor impacto visual es el juicio de ese desarrollador, no una comparación estandarizada con DeepSeek.
Cómo adaptar un modelo Flash al trabajo
La comparación de la fuente sugiere fortalezas diferentes: la posición de DeepSeek en el gráfico de programación basado en puntuación y coste, y los sólidos resultados de MiniMax en flujos de trabajo empresariales. Estas diferencias respaldan la prueba de ambos modelos con trabajo representativo, en lugar de depender de una única clasificación destacada.
Realiza un seguimiento del éxito después de la revisión, el tiempo transcurrido, los reintentos y el gasto total. Una tarifa de tokens más baja es más importante cuando el modelo puede completar la tarea requerida sin añadir suficiente retrabajo como para eliminar el ahorro.
MiniMax también afirma que una variante Pro llegará más adelante. Ese producto futuro debe mantenerse separado del comportamiento documentado de lanzamiento de M3.1 Flash.
Preguntas frecuentes
¿Es MiniMax M3.1 Flash el segundo mejor modelo en términos generales?
La clasificación de la fuente se refiere a una comparación concreta de puntuación frente a coste en programación. Otras evaluaciones del artículo muestran clasificaciones y empates diferentes.
¿Cuáles son los precios oficiales de los tokens en USD?
El anuncio de MiniMax indica 0,15 $ por la entrada, 0,60 $ por la salida y 0,015 $ por la entrada almacenada en caché por cada millón de tokens. Comprueba la plataforma de facturación aplicable antes de elaborar un presupuesto a partir de un esquema monetario diferente.
¿La cifra de 739 CNY de ALE significa que se superaron todas las tareas?
No: es un coste estimado para una ejecución completa de 152 tareas intentadas. La tasa de aprobación comunicada es del 29,6 %, y el importe excluye los costes que quedan fuera de las hipótesis del gráfico.
¿Qué entradas y qué longitud de contexto admite la guía?
La guía oficial enumera entradas de texto, imagen y vídeo, así como un contexto de hasta un millón de tokens. Comprender entradas no implica generar imágenes o vídeos.
¿Qué ocurre si se omite el ajuste de razonamiento?
La documentación indica que el valor predeterminado es max. Utiliza el campo específico del protocolo correspondiente para elegir un nivel inferior; el razonamiento no se puede desactivar.
¿Los pesos del modelo ya estaban disponibles en el lanzamiento?
El anuncio de lanzamiento indica que se publicarían más adelante. El acceso a la API alojada y la promesa de publicar los pesos son afirmaciones independientes sobre disponibilidad.
Herramientas relacionadas
- Plataforma API de MiniMax: Acceso alojado a los modelos de MiniMax y servicios para desarrolladores.
- MiniMax Code: La aplicación de escritorio para programación ofrecida en el anuncio de lanzamiento.
- M Plan: La modalidad de suscripción mencionada para acceder a MiniMax.
- Repositorio de DeepSeek Flash-1017: El repositorio publicado del modelo utilizado en la comparación.
Enlaces relacionados
- Artículo proporcionado en BAAI Hub: La fuente de las comparaciones en CNY y de los ejemplos ilustrados.
- Anuncio de M3.1 Flash de MiniMax: Precios oficiales de lanzamiento, vías de acceso y afirmaciones de la empresa sobre benchmarks.
- Guía de invocación de modelos de MiniMax: Contexto, formatos de entrada y controles de razonamiento específicos de cada protocolo verificados.
- Plataforma API de MiniMax: El punto de entrada oficial para desarrolladores.
- Descarga de MiniMax Code: El producto de escritorio enlazado por el anuncio oficial.
- DeepSeek V4.1 Flash-1017: El repositorio del modelo relevante para la comparación.
Resumen
M3.1 Flash combina precios de tokens económicos con resultados competitivos comunicados por la empresa en programación, automatización y uso del ordenador. Su valor depende de los ajustes de esfuerzo, el comportamiento de la caché y de si completa el flujo de trabajo real con un retrabajo aceptable.
Utiliza los gráficos de benchmarks para decidir qué probar y deja que los resultados satisfactorios, el tiempo transcurrido y la factura completa determinen el modelo.


