For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
El lanzamiento de Muse Wonder de Meta produjo dos tipos de evidencia muy distintos: sólidos resultados en benchmarks y demostraciones de des...
El lanzamiento de Muse Wonder de Meta produjo dos tipos de evidencia muy distintos: sólidos resultados en benchmarks y demostraciones de desarrolladores que en ocasiones fueron mucho menos convincentes. Un informe chino de Xinzhiyuan, republicado en BAAI Hub, convierte esta brecha en una crítica contundente a la optimización centrada en benchmarks.
El desacuerdo merece un análisis cuidadoso, pero una demostración deficiente no prueba que haya habido trampa. Una lectura justa requiere conocer la variante exacta del modelo, la tarea evaluada, el software de agentes que rodea al modelo y el origen de cada resultado.
La fuente describe a desarrolladores que comparaban resultados de juegos de navegador o 3D y consideraban que Wonder era decepcionante frente a modelos competidores. Estas demostraciones son fáciles de inspeccionar: los espectadores pueden ver si el movimiento funciona, si la cámara se comporta de forma razonable y si la escena se parece al resultado solicitado.
La fuente también cita a Alexandr Wang, de Meta, afirmando que el equipo no había entrenado explícitamente para juegos de demostración en 3D e instando a los desarrolladores a probar trabajo de programación real. Esa respuesta es reportada por Xinzhiyuan; no debe convertirse en una explicación general para todas las tareas de programación fallidas.
Las demostraciones de juegos siguen siendo evidencia relevante. Evalúan una combinación real de generación de código, juicio visual, interacción y depuración. Su limitación es el alcance: una indicación y una ejecución no pueden establecer el rendimiento en mantenimiento de repositorios, trabajo de terminal o proyectos de software extensos.
El anuncio principal de Meta presenta Muse Wonder y Muse Wonder Full como modelos para agentes personales y profesionales. Wonder se ofrece mediante la Meta Model API y Muse Code; Full se ofrece a los suscriptores de Muse Code.
El anuncio define la Memoria activa como la capacidad de conservar contexto importante entre conversaciones y recuperarlo cuando sea relevante. El Enfoque activo describe el progreso sostenido hacia un objetivo, incluido probar alternativas, adaptarse a información nueva, pedir aclaraciones y verificar antes de acciones importantes.
Estas descripciones ayudan a explicar lo que Meta intenta mejorar. Son afirmaciones de producto y de evaluación, no garantías de que un agente completará todas las tareas asignadas.
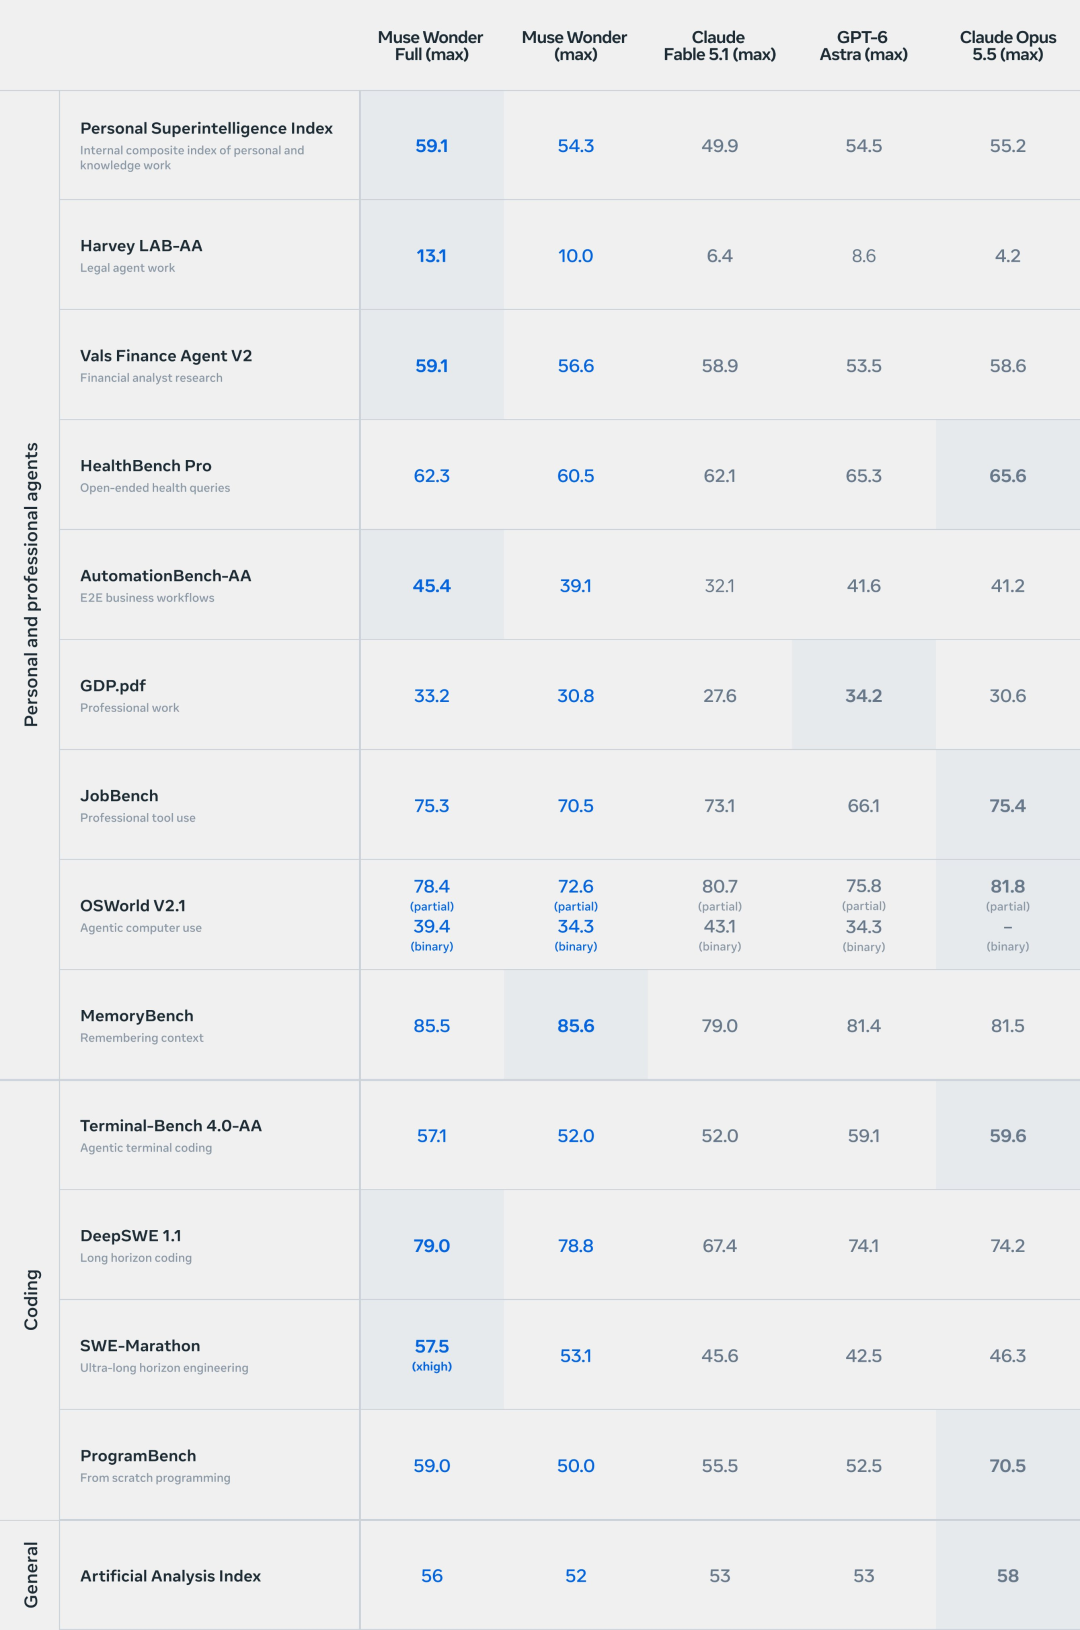
Tabla comparativa publicada por Meta y reproducida por Xinzhiyuan en BAAI Hub. Los valores corresponden a las configuraciones y condiciones de evaluación mostradas en los materiales de lanzamiento.
La tabla no muestra un ganador universal. Sus resultados de programación varían considerablemente según la tarea:
| Evaluación | Muse Wonder Full | Claude Opus 5.5 | Dirección de la comparación |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full obtiene una puntuación superior |
| SWE-Marathon | 57.5 | 46.3 | Full obtiene una puntuación superior con la configuración reportada |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus obtiene una puntuación superior |
| ProgramBench | 59.0 | 70.5 | Opus obtiene una puntuación superior |
El material complementario de Meta también informa de fortalezas en memoria y flujos de trabajo con agentes, junto con áreas en las que otros modelos lideran. La existencia de un resultado sólido en trabajo de software de larga duración no implica el mejor rendimiento al generar una aplicación desde cero.
Las condiciones de evaluación son especialmente importantes para SWE-Marathon. La tarjeta de modelo de Meta describe a los competidores ejecutándose mediante Codex y Claude Code, mientras que el resultado destacado de Wonder Full utiliza una configuración xhigh. Se trata de resultados significativos a nivel de producto, pero no constituyen un único experimento controlado con un entorno de agentes idéntico para todos los modelos.
El blog de lanzamiento de Meta analiza explícitamente la brecha entre benchmarks conocidos y tareas desconocidas. Su análisis compara el rendimiento dentro y fuera de distribución a medida que aumenta el cómputo en tiempo de prueba, y sostiene que un modelo base más sólido de Wonder Full mejora la transferencia de las ganancias del postentrenamiento a otras tareas.
Esta es evidencia técnica relevante para la posición de Meta. Sigue siendo una evaluación elegida y presentada por el desarrollador del modelo, y no resuelve todas las críticas sobre el resultado de un desarrollador.
Del mismo modo, los informes sobre una demostración de juego decepcionante no prueban contaminación de benchmarks ni fabricación de resultados. Establecer esas afirmaciones requeriría evidencia más directa sobre datos, métodos o resultados manipulados que la que aporta el artículo fuente.
La cobertura independiente de Artificial Analysis informa puntuaciones de Intelligence Index v4.3 de 56 para Wonder Full y 52 para Wonder, con el máximo nivel de esfuerzo de razonamiento. Por tanto, un usuario de API que pruebe Wonder normal estará evaluando una oferta de lanzamiento distinta del modelo Full que encabeza varios gráficos.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Artificial Analysis indica una ventana de contexto de un millón de tokens para cada variante. Para Wonder, informa de 4 USD por millón de tokens de entrada, 0,20 USD por entrada en caché y 20 USD por salida. Su estimación de 4,52 USD por tarea de Intelligence Index es un coste específico de evaluación, no un precio fijo para cualquier solicitud de usuario.
La fuente también critica la ausencia de un lanzamiento público de pesos abiertos. Ni el anuncio de lanzamiento revisado ni la descripción de acceso proporcionan una versión descargable de los pesos de Wonder, por lo que los desarrolladores no deben asumir que el alojamiento local autónomo esté disponible.
Meta afirma que Wonder fue entrenado en su centro de datos Prometheus a escala de gigavatios. El artículo de BAAI vincula el lanzamiento con declaraciones de Mark Zuckerberg y Wang sobre la magnitud de la inversión en infraestructura de IA y el papel de los agentes personales en el comercio.
Estas declaraciones describen una estrategia más amplia. No deben convertirse en una cifra verificada del coste de entrenamiento de este modelo concreto. Del mismo modo, un ejemplo de agentes que negocian o compran servicios es una visión sobre el comportamiento del producto, no evidencia de que todos esos flujos de trabajo se hayan desplegado.
El siguiente paso útil es realizar pruebas repetibles: mantener estables los requisitos, identificar la variante y el ajuste de razonamiento, documentar el entorno y medir el trabajo completado. Esto puede revelar fortalezas y debilidades de forma más fiable que una única puntuación destacada o un único fallo llamativo.
No. Pueden mostrar un rendimiento deficiente en las tareas demostradas, pero probar que hubo trampa en benchmarks exige evidencia independiente sobre métodos de evaluación, datos o resultados manipulados.
Son ofertas distintas dentro de la familia de modelos, con diferentes vías de acceso en el lanzamiento. Artificial Analysis informa 52 para Wonder y 56 para Full, con el máximo esfuerzo de razonamiento, en su Intelligence Index v4.3.
La tabla citada ofrece respuestas diferentes según la evaluación de programación. Full lidera en DeepSWE 1.1 y en la configuración reportada de SWE-Marathon, mientras que Opus lidera en Terminal-Bench 4.0-AA y ProgramBench.
Solo con una aclaración sobre la configuración. La tarjeta de modelo de Meta describe a los competidores usando sus productos de programación, por lo que las diferencias en el comportamiento de los agentes y las herramientas pueden influir en el resultado junto con los modelos subyacentes.
La cobertura de lanzamiento de Artificial Analysis informa de 4 USD por millón de tokens de entrada, 0,20 USD por millón de tokens de entrada en caché y 20 USD por millón de tokens de salida. Verifique las condiciones de facturación vigentes del proveedor antes de comprometerse con el uso en producción.
No se estableció ninguna descarga pública de pesos a partir de los materiales de lanzamiento revisados. Las vías de acceso documentadas son la API y Muse Code para Wonder, y el acceso por suscripción a Muse Code para Full.
Los resultados del lanzamiento de Muse Wonder muestran una familia de modelos con sólidas puntuaciones en agentes e ingeniería de software, resultados desiguales entre categorías de programación y distintas vías de acceso para las variantes normal y Full.
La conclusión útil depende de la tarea: verifique el modelo exacto y pruebe el trabajo completado antes de aceptar una afirmación de victoria universal o una acusación de trampa.
Empieza con una sola frase y obtén un sitio completo en minutos.